登录社区云,与社区用户共同成长
邀请您加入社区
递归相关题目的综合练习,将一个大问题转化成若干小的子问题
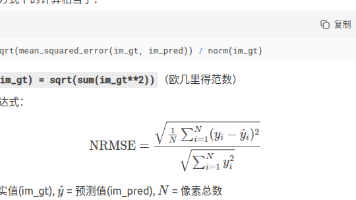
本文探讨了图像质量评估中的三种常见回归指标:MSE(均方误差)、RMSE(均方根误差)和NRMSE(归一化均方根误差)。作者通过实践发现RMSE与MSE数值关系异常,经分析发现实际调用的是NRMSE计算。文章详细解释了三种指标的数学定义和敏感性差异,重点分析了NRMSE的三种归一化方法(欧几里得、最小最大值、均值)及其适用场景。特别指出在默认欧几里得归一化下分母是图像数据平方均值的平方根,这会导致
大家好,我是爱酱。本篇我们将系统讲解K-近邻算法(KNN),内容涵盖原理、数学公式、案例流程、代码实现和工程建议,适合新手和进阶者学习。详细内容涵盖:K值选择与模型表现、距离度量的选择与影响、加权KNN,分类跟回归任务都会覆盖到!注:本文章含大量数学算式、详细例子说明及代码演示,大量干货,建议先收藏再慢慢观看理解。新频道发展不易,你们的每个赞、收藏跟转发都是我继续分享的动力!注:本文章颇长近700
大家好,我是爱酱。继前几篇介绍了层次聚类、K均值聚类和密度聚类之后,本篇我们聚焦于另一种强大的聚类算法——高斯混合模型(GMM)。GMM是一种基于概率的软聚类方法,能够为每个样本点计算属于各个簇的概率,适合复杂数据的建模。本文将系统介绍GMM的原理、数学表达、实际案例流程及Python代码实现,加上大量公式给出,方便你直接用于技术文档和学习。注:本文章含大量数学算式、详细例子说明及代码演示,大量干
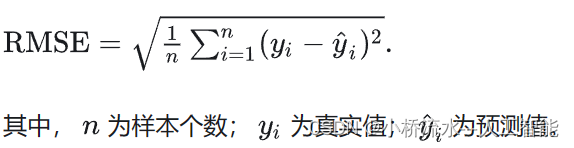
RMSE(Root Mean Square Error):均方根误差。优点在于衡量预测值与真实值之间的偏差程度,数值越小表示模型的预测精度越高。此外,RMSE易于理解,计算方便,并且对异常值较为敏感。然而,RMSE的缺点在于对目标变量本身的变异性缺乏考虑,可能无法准确反映模型的性能。同时,RMSE对异常值的敏感性可能导致评价结果不够稳定。MAE(Mean Absolute Error):平均绝对误
本文深入研究了多元线性回归及其在非满秩矩阵情况下的解决方案。通过介绍模型表达式、最小二乘法,以及广义线性模型,我们全面理解了多元线性回归。在$\mathbf{X^TX}$不是满秩的情况下,讨论了正则化方法如岭回归和套索回归,以有效处理多重共线性问题。此外,文中探讨了对数几率回归作为处理非满秩矩阵的二分类问题的解决方案。详细解释了对数几率回归的模型表达式,并探讨了通过极大似然估计法求解模型参数的方法
本文系统介绍了机器学习中两种基础算法:多元线性回归和逻辑回归。多元线性回归用于预测连续数值(如房价、销量),通过最小化均方误差(MSE)找到最佳超平面;逻辑回归用于二分类问题(如垃圾邮件识别、信贷风控),利用Sigmoid函数输出概率并通过交叉熵损失优化。文章详细阐述了两者的数学原理、损失函数设计依据、实际应用场景及评估方法,并通过房价预测和邮件分类案例演示了完整建模流程。两种算法分别对应"是多少
26年4月来自小鹏汽车的论文“X-Cache: Cross-Chunk Block Caching for Few-Step Autoregressive World Models Inference”。实时世界模拟正成为自动驾驶系统可扩展评估与在线强化学习的关键基础设施。近期基于自回归视频扩散技术的驾驶世界模型虽能实现高保真且可控的多视角(多相机)图像生成,但其推理成本仍是交互式部署的瓶颈。现有
最后,通过偏差与方差的核心理论,剖析了模型的误差来源,清晰区分了欠拟合与过拟合的核心特征,并掌握了两类模型问题的优化改进思路。通过本次学习,我不仅梳理了机器学习的整体运行逻辑,更打破了“仅追求训练集高精度”的认知误区,深刻理解了模型训练的核心目标是提升泛化能力,保障模型在真实未知场景中能够稳定输出优质结果。模型优化的核心目标,并非一味提升模型复杂度,而是在偏差与方差之间寻找最优平衡,让模型既能够精
这不是科幻,而是2025-2026年已在华西医院、哈工大实验室、MICCAI顶会论文中落地的真实实践。智能体的"智力"不应该被锁定在训练完成的那一刻。在临床科研场景中,知识每4-5年就会更新一轮,一个依赖"静态知识库"的AI,半年后就会过时。因此,让AI具备的能力,不是"锦上添花",而是"生存必需"。本文将从四个维度,为你全景解析医疗AI智能体的"进化之路"。
2026年6月11日,Google正式发布实验性开源模型DiffusionGemma,以Apache 2.0许可证开放。这是一款基于文本扩散(Text Diffusion)机制构建的大语言模型,采用26B参数的MoE(Mixture of Experts,混合专家)架构,推理时仅激活约3.8B参数。与传统自回归(Autoregressive)大语言模型逐token顺序生成的方式不同,Diffusi
本文介绍了基于Django框架开发的厦门市二手房房价分析与预测系统。该系统运用线性回归模型,为用户提供房价数据展示和预测功能。研究重点阐述了系统的技术选型、架构设计、数据库优化及性能提升措施,包括缓存技术的应用。通过简洁的界面设计和流畅的用户体验,实现了安全可靠、响应快速的房价分析平台。文中特别展示了房价数据可视化界面(图5.4),验证了系统的实用性和推广价值。
角色职责关键技术能力主管智能体理解科研目标,分解任务,协调执行顺序,处理异常任务规划、状态机管理文献智能体检索PubMed等数据库,筛选相关文献,提取关键信息PubMed API、RAG检索、文献质量评估数据智能体理解数据结构,执行清洗、转换、统计分析SQL/Python代码生成、统计模型库调用编码智能体将分析计划转为可执行代码,并自我验证代码生成、沙箱执行、单元测试审核智能体检查其他智能体输出的
这不是科幻,这是2025-2026年已落地的真实实践。前三期我们分别讨论了私有化部署、智能体架构、多模态整合和自主进化。这一期,我们将聚焦一个最让临床医生头疼的问题——,看看AI智能体如何将这个传统上需要数月甚至数年的过程,压缩到以天甚至小时为单位。
本文演示了如何使用R语言进行逻辑斯蒂回归分析,以mtcars数据集为例预测发动机类型(V型/直列)。通过glm函数构建模型,使用mpg、wt和hp作为预测变量。结果显示wt(车重)对分类有显著负面影响(p=0.023)。模型训练集预测准确率达93.75%,并绘制了wt与vs概率的S型曲线图,直观展示变量关系。关键步骤包括:模型构建、系数解释(优势比)、预测评估及可视化,完整呈现了二分类问题的标准分
当我们还在为手机能流畅跑7B模型而惊喜,当行业正将“端侧14B”作为旗舰手机的核心卖点,一个更值得探索的问题浮出水面:32B参数的通用大模型,能在普通手机上完整运行吗?
变量选择的本质是:在多个候选模型中,通过 AIC、BIC、调整后或 F 检验等准则,选择一个既能较好解释数据、又不过度复杂的模型。变量选择可以概括为:候选变量→构建候选模型→计算评价准则→比较模型→确定最终变量集合pSSR%5E2R%5E2R%5E2R%5E2R%5E2R%5E2nk%7CS%7C1R%5E2SSER%5E2R%5E22kLk2k2k2knC_p2kSSE_pkSSE_RSSE_F
本文介绍了基于Django框架的厦门市二手房房价分析与预测系统的设计与实现。系统采用线性回归模型,提供房价预测功能,并具备管理员登录、房源管理等核心模块。设计注重用户体验、系统安全性和可扩展性,通过数据库优化和缓存技术提升性能。系统结构清晰,功能完善,可为用户提供便捷的房价分析服务,具有实用价值和推广意义。文章详细阐述了系统开发流程,包括需求分析、技术选型、编码实现及测试部署等环节。
模型结果是否可信,参数是否稳定,残差是否满足基本假设,是否存在异常样本严重影响模型。可以概括为:建模→估计参数→显著性检验→回归诊断→模型修正所以,回归诊断是从“会建模”走向“会判断模型质量”的关键步骤。
一元线性回归模型为:其中:是截距项;是回归系数;是误差项。对于建模,我们需要找到一条直线,使所有样本点到这条直线的残差平方和最小,也就是到这条直线的距离之和最小。也就是:等价于:通过对和分别求偏导,并令偏导等于0,得到最小二乘估计。手动编写和利用R包的效果几乎一致。当维度增加,我们的一元线性回归就变成多元线性回归了。
本文基于Django框架和Python技术开发了B站数据分析系统,针对当前主流系统服务不明确、管理盈利低的问题,通过需求分析建立了开发模型。系统采用模块化设计,将功能按权限划分,在保证基本功能的同时注重用户体验,具有界面友好、操作简单的特点。研究内容包括系统需求调研、开发环境构建、功能模块设计及实现测试等环节,最终完成了适应大多数用户习惯的B站数据分析系统开发。
本文研究基于Django和Python的共享汽车用户数据分析与可视化系统。针对当前共享汽车服务分析功能不足的问题,项目通过需求分析建立了开发模型,设计了包含车辆管理等模块的系统架构。系统实现了车辆信息查询(品牌、型号、租金等)及管理功能(增删改查),并通过可视化界面展示分析结果。测试表明,该系统能有效提升共享汽车用户数据分析的精准性和管理效率。图4.1展示了系统总体结构,图5.8为车辆设备管理界面
本文介绍了多项回归模型(Multinomial Regression)在分类响应变量分析中的应用,重点讲解了如何计算和解释变量的边际效应(Marginal Effects)。通过R语言中的nnet和marginaleffects包,演示了模型拟合和边际效应计算过程,并以动态性(SITN)和国家(CNTRY)对动词类别(VERB)的影响为例进行可视化分析。结果显示,不同国家的动态性对动词使用概率的影
深度学习在回归预测领域取得了显著的成功,尤其是在处理高维数据和复杂非线性关系方面。卷积神经网络 (Convolutional Neural Network, CNN) 因其强大的特征提取能力,成为回归预测任务中的有力工具。本文将深入探讨一种基于二维卷积神经网络 (2-DCNN) 的多输入单输出回归预测模型,分析其架构、训练策略以及在实际应用中的优势与挑战。传统的回归模型,如线性回归和支持向量回归,
《东方财富网股票趋势预测的线性回归模型研究》 摘要: 本研究基于线性回归算法构建了东方财富网股票趋势预测模型。通过数据清洗、缺失值处理和异常值修正等预处理步骤,利用股票名称、最高价、最低价和涨跌额等特征建立预测模型。研究证实线性回归算法在股价预测中具有较好的有效性和实用性,但也指出其在处理非线性因素和市场波动方面的局限性。未来将探索多维数据融合、混合算法应用及实时分析技术,以提升预测精度并开发实用
本文研究基于LSTM网络的空气质量预测算法,通过数据预处理、模型构建与优化,建立了7天空气质量指数预测模型。研究采用网络爬虫采集多源数据,经过清洗、存储和Spark分布式处理,运用随机森林、线性回归和LSTM三种方法进行预测对比。系统实现了自动化数据爬取与清洗功能,采用Scrapy框架和Pandas库保证数据质量,最终构建了包含数据管理、模型训练和预测功能的一体化系统。实验表明LSTM模型在时序预
当我在选择自己的论文实验中需要用到的对比模型时,Cursor(馅是 Codex 5.3的)说,你得有足够证据证明你的强模型比弱模型强,我建议构建三层证据链,公开 Benchmark 成绩作为先验证据、自己的实验中模型准确率作为内部判定依据,再加一层参数规模作为辅助论据。这个阶段 AI 生成的代码我还会 Review 一下,反正也要等它完成我的指令,闲着也是闲着。框架是清晰的,文件也不大,我对每个文
摘要 本研究基于Hadoop构建贵阳花卉市场销量分析系统,整合Hive、Pig和MapReduce技术处理海量销售数据,结合时间序列分析、回归模型及神经网络算法实现销量预测。系统通过可视化模块直观展示销售趋势与预测结果,辅助商户优化库存与经营决策。未来将引入深度学习和实时数据处理技术以提升预测精度与响应速度。平台功能涵盖数据爬取(Python+Scrapy)、清洗(Pandas)、分析(HiveQ
AI Agent代码执行的安全风险与沙箱隔离方案 本文揭示了AI Agent自主生成并执行代码时存在的严重安全隐患,重点分析了fork进程风暴导致系统崩溃的案例。文章系统性地梳理了AI Agent面临的三大核心安全威胁(工具滥用、意外代码执行和资源过载),并基于OWASP智能体应用安全框架进行了风险分类。 通过真实案例(如Claude Code误删文件事件)和行业研究("Agents of Cha
本研究基于线性回归算法构建股票趋势预测模型,通过数据采集、清洗、特征提取等步骤处理东方财富网数据,实现价格预测。系统采用Python爬虫、Hadoop存储、Spark计算等技术,结合Django后端和Vue.js前端搭建可视化平台,集成词云、价格走势图等多维分析模块。研究证实线性回归在股价预测中的有效性,同时指出其非线性处理的局限性,建议结合其他算法提升预测精度。未来计划引入更多维度的数据,探索混
让 Agent 生成 Table 1、回归结果表、森林图、ROC 曲线、相关热图、箱线图、柱状图和结果描述文字。PICO/PICOT、FINER 评分、研究设计类型选择、纳排标准、终点指标、变量清单和伦理材料准备。Cover Letter、Highlights、作者贡献、利益冲突、伦理声明、数据可用性声明。让 Agent 生成检索词、筛选高价值文献、提取研究目的、方法、结果和局限。描述统计、组间比
《旋生万物》:给物理AI装上“数学陀螺仪”要打破这个螺旋,我们需要回归更底层的数学语言。今天想和大家分享一本开源巨著——《旋生万物:从奇点到宇宙的统一生成论》。这不是一本普通的科普书,而是一套试图重构数学与物理底座的硬核理论。
然而,如果我们尝试了不合理的超参数,我们可能会发现验证效果不再代表真正的误差。:如果你把 "RL" 编成 1,"RM" 编成 2,模型可能会误以为 "RM" 比 "RL" 大,或者它们有高低之分,但这在现实中是不成立的(它们是平等的类别)。你有5个老师教同一个学生,每个老师用4/5的内容教,用剩下的1/5考试,最后看5个老师的平均分数。独热编码的做法是:既然它们是平等的,那就给每个类别发一个专属的
本周建立起“训练-验证-测试”的严谨评估思维,并与本科学习内容进行连接,运用函数进行偏差与方差的权衡,在模型调优时极具指导意义。本周学习了李宏毅老师机器学习课程的前四讲,根据本科数学分析中的函数分析方法进行机器学习整体概览回归案例分析(以宝可梦 CP 值预测为例)以及详解误差来源分析与模型选择(偏差与方差)· 高方差(过拟合):训练误差低,测试误差高 → 增加数据量,正则化,使用早停或集成(如 B