登录社区云,与社区用户共同成长
邀请您加入社区
消息队列是基于阻塞队列封装的分布式中间件,核心功能是实现生产者-消费者模型,解决系统解耦、流量削峰和分布式通信问题。RabbitMQ作为典型代表,通过队列机制实现生产者和消费者的完全解耦,支持消息持久化和ACK确认机制确保可靠性。其工作流程为:生产者发送消息到交换机,根据路由规则分发到队列,消费者从队列获取消息。消息格式分为协议层(AMQP)和业务层(JSON等),前者由MQ规定,后者由生产消费方
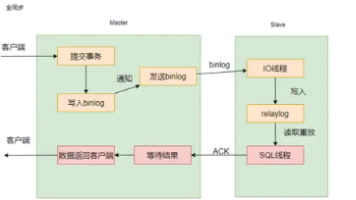
MySQL主从同步原理与应用实践 摘要:本文详细介绍了MySQL主从同步的技术原理与应用场景。主从同步通过binlog日志实现数据复制,支持Stat、Row、Mixed三种日志格式。文章分析了五种同步方式(全同步、异步、半同步、增强版同步和组复制)的特点与适用场景,对比了五种常见架构(一主一从、一主多从等)的优缺点。实战部分展示了通过Docker搭建主从集群的具体步骤,包括创建同步用户、配置主从关
卡夫卡是由 Apache 软件基金会开发的分布式流处理平台,最初由 LinkedIn 公司设计,用于解决大规模日志收集与传输问题。它的核心定位是 “高吞吐量的分布式发布 - 订阅消息系统”,具有高吞吐、低延迟、持久化、可扩展、容错性强等特点。简单来说,Kafka 就像一个 “分布式数据管道”,能在不同系统间高效传递海量数据。例如:电商平台的订单数据可通过 Kafka 实时同步到库存系统、支付系统
Kafka是消息中间件的核心,也是大型架构和高并发的必备中间件,本篇我就全面来详解Kafka@mikechenKafkaApache Kafka是分布式发布-订阅消息系统,Kafka最初由LinkedIn公司开发,Linkedin于2010年贡献给了Apache基金会并成为顶级开源项目。1.高吞吐量、低延迟kafka每秒可以处理几十万条消息,它的延迟最低只有几毫秒。2.可扩展性kafka集群支持热
雪花算法(Snowflake Algorithm)是Twitter开源的一种分布式唯一ID生成算法,通过组合时间戳、机器标识和序列号生成64位全局唯一ID,适用于高并发分布式系统。
选择一个Topic —> Data —>Retrieve Messages,Key/Message设置展示格式,点查询即可看到数据。Messages选择Newest,查看最新的Kafka数据;列表每列都可以通过点击表头,进行升序或者降序排序。
Kafka Tool(Kafka 可视化工具)安装及使用教程
进行下载,Scala 2.12 和 Scala 2.13 主要是使用Scala编译的版本不同,两者皆可。接下来我们还需要在每个 zookeeper 节点的数据目录下创建对应的服务id文件与上面配置的。针对每个节点修改主机名称,查看当前主机的ip地址并固定,添加子网掩码,网关,DNS1。Kafka一般情况下都是分布式架构的,单机节点的使用情况基本不存在——了解即可。当然,也可以只安装并配置一台zoo
文章目录一、笔记内容技术选型二、Spring Cloud介绍1.为什么需要Spring Cloud?2.相关组件介绍三、单体项目构建1.SpringBoot单体服务1.1 项目构建1.2 MyBatis逆向工程1.3 编写业务逻辑1.4 整合Swager31.5 统一返回结果Result1.6 优化时间格式1.7 异常处理1.8 编写订单模块【模块构建参考上述步骤】1.9 重复代码抽取2.问题引入
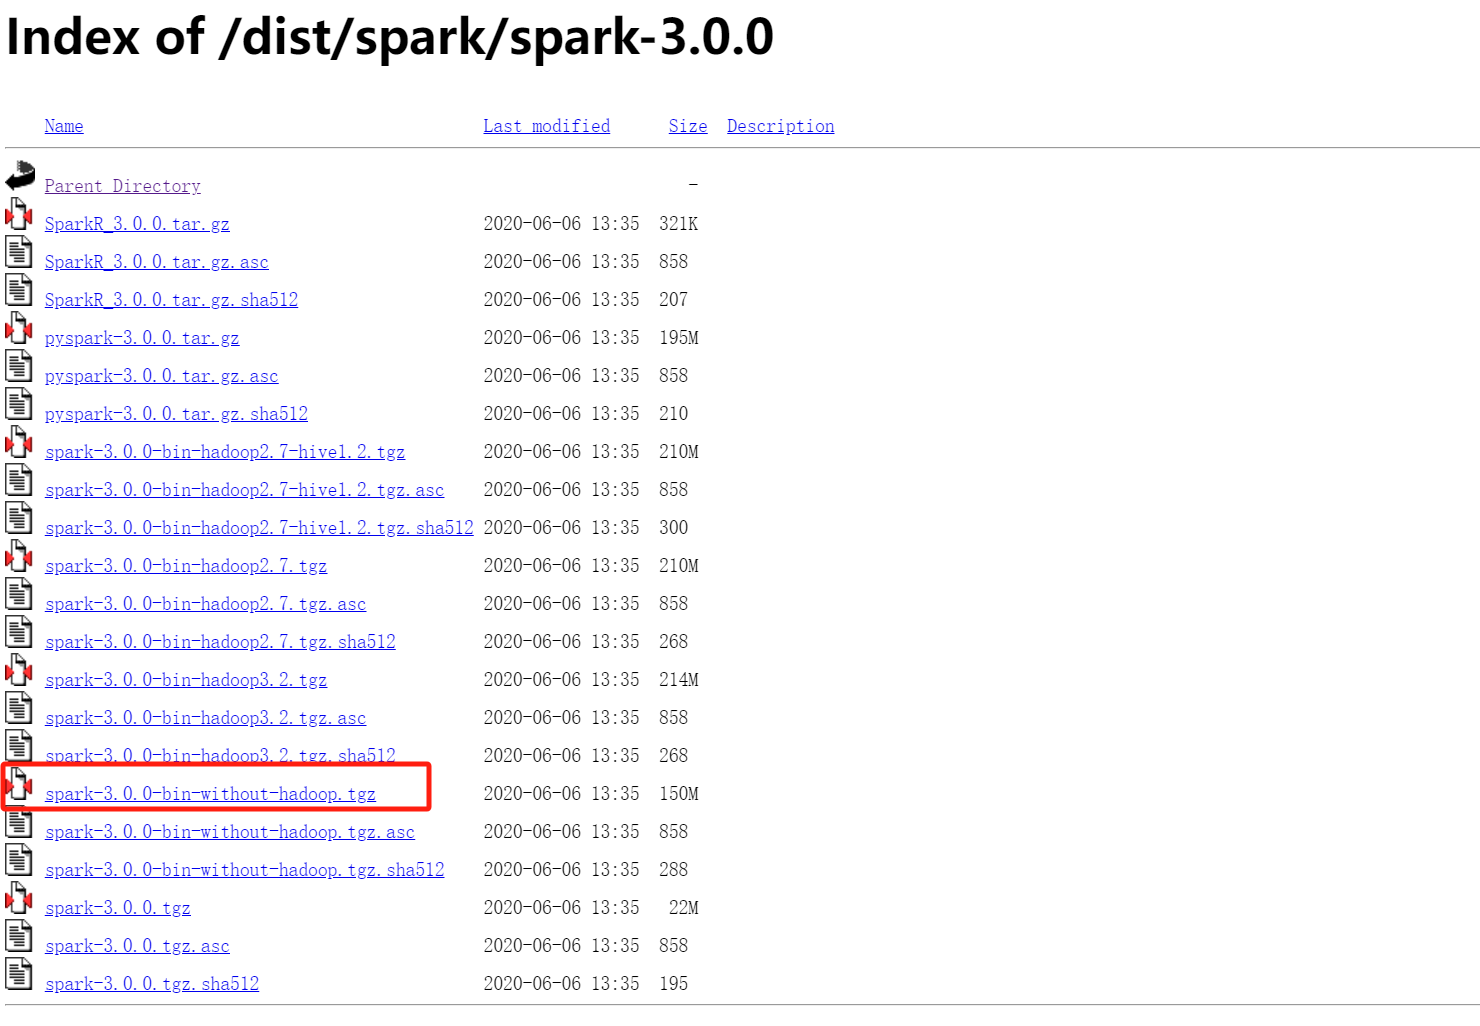
前提JDK1.8Hadoop3.1.3(伪分布式)Hadoop安装教程:在上述教程中已经配置py4jPyspark注:**【此教程版本】**Spark3.0.0对应的是Python3.8即Ubuntu自带的Python版本,所以如果你的Ubuntu版本为20,那么就下载Spark3.0.0的。
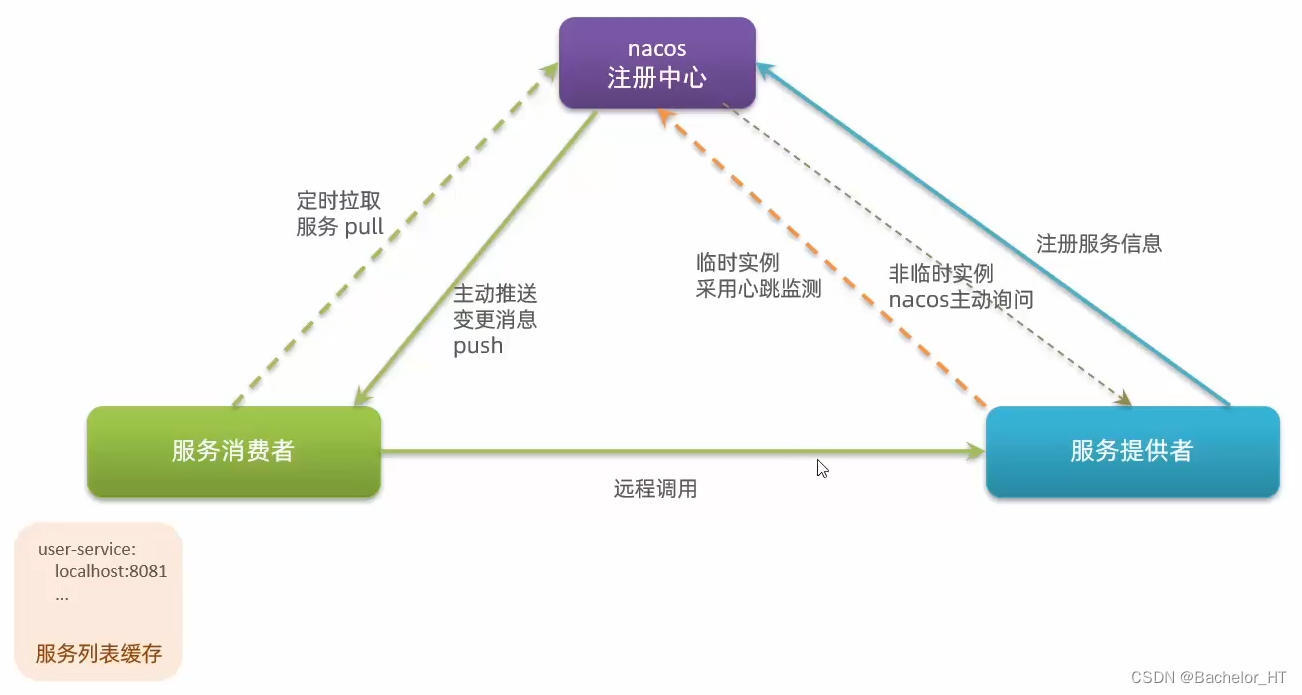
1. Nacos简介1.1 核心特性1.2 常见的注册中心1.3 Nacos结构图2. 如何安装和配置Nacos?2.1 Nacos的安装2.2 如何使用Nacos?Nacos是一个开源的动态服务发现、配置和服务管理平台,由阿里巴巴开发和维护。Nacos支持多种注册中心和配置管理器,包括Spring Cloud Discovery、Dubbo、Kubernetes和Apache Service
在采用SOA架构进行开发的时候,整体业务系统拆分为4个组件,10类服务域,5类流程,那么在构建的时候重点就是将上述组件,服务域和流程类体现出来。三层架构本身也和一个业务功能实现的完整对应,在数据访问层处理数据获取和持久化操作,在业务逻辑层对业务规则进行处理,在界面展现层进行相应的前端展现和用户交互。集成是配合分解完成的动作,最终分解完成的各个组件或子系统,通过合适的接口设计,最终还能够集成为一个完
rabbitmq 管理界面操作使用
AXI协议规范中文翻译版来源:https://github.com/lizhirui/AXI_spec_chinese综述本文参考分析整理总结了AMBA AXI and ACE Protocol Specification文档的AXI总线协议规范部分,错误之处欢迎指出。AMBA AXI协议支持高性能高频的系统设计,该协议拥有以下优点:适合高带宽和低延迟的设计不需要复杂的桥...
Java集合体系框架Java集合类主要由两个根接口Collection和Map派生出来的。Collection派生出了三个子接口:1)ListList代表了有序可重复集合,可直接根据元素的索引来访问2)SetSet代表无序不可重复集合,只能根据元素本身来访问3)QueueQueue是队列集合Map接口派生:Map代表的是存储key-value对的集合,可根据元素的key来访问value。因此Jav
RocketMQ搭建和使用详解RocketMQ介绍NameServerBrokerRocketMQ介绍RocketMQ是阿里参考Kafka特点研发的一个队列模型的消息中间件,后开源给apache基金会成为了apache的顶级开源项目,具有高性能、高可靠、高实时、分布式特点。其主要有四大核心组成部分:NameServer、Broker、Producer以及Consumer四部分。以下分别介绍这四个部
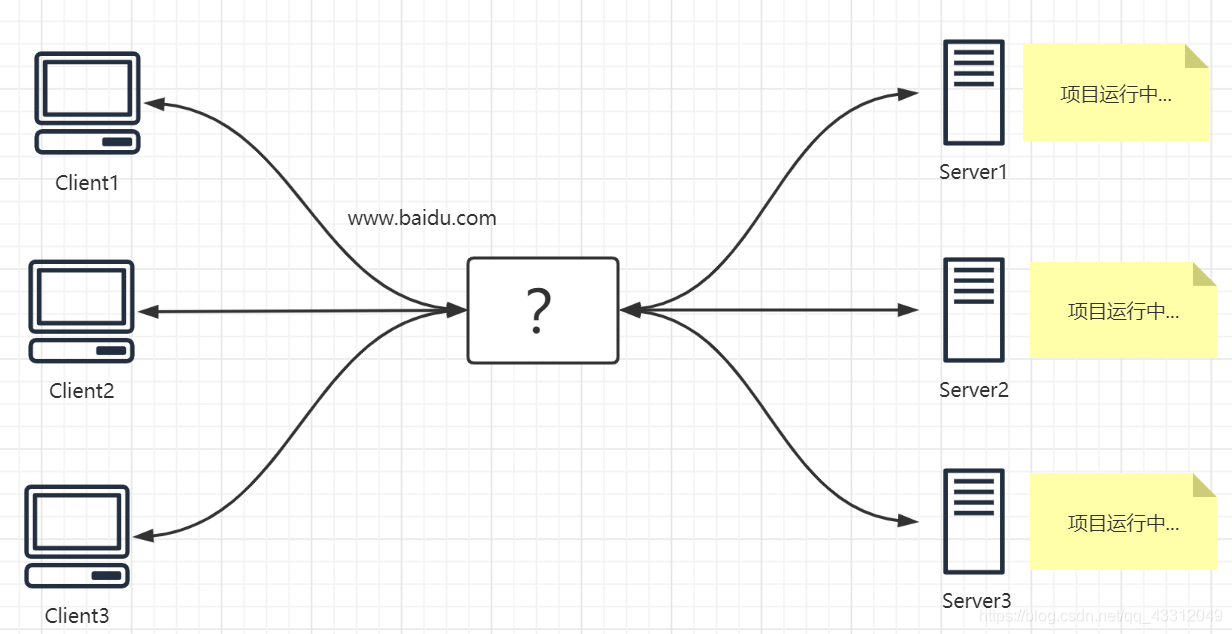
不理解反向代理?不知道Nginx有什么用?不知道Nginx怎么用?快进来看看吧!保姆级教学~拿来吧你
我们常说的电动汽车核心三电部件,即大三电分别为电机、电控、电池,小三电为车载充电机、DCDC转换器、高压配电盒,其中动力电池系统占电动汽车成本40~50%左右,所以在动力电池有补贴高峰时,新能源汽车相当便宜,BMS作为动力电池系统中的灵魂而在,大约占动力电池成本的15~15%左右,BMS在动力汽车中尤为重要,它实时监控动力电池使用状况,预估电池剩余容量SOC,避免电池过充过放及过温度,主动均衡电池
欢迎访问我的个人博客:www.ifueen.com文章目录概述使用概述首先我们要知道什么是XXL-JOB?官方简介:XXL-JOB是一个分布式任务调度平台,其核心设计目标是开发迅速、学习简单、轻量级、易扩展。现已开放源代码并接入多家公司线上产品线,开箱即用XXL-JOB的有点特性:1、简单:支持通过Web页面对任务进行CRUD操作,操作简单,一分钟上手;2、动态:...
本文介绍了微服务架构下分布式链路追踪的必要性,以及CAT链路追踪工具的原理与实践。文章首先通过订单超时案例说明微服务排查痛点,对比单体与微服务架构的调试差异;接着详细解析Trace、Span、SpanContext等核心概念;然后对比主流链路追踪工具(Zipkin、Jaeger、SkyWalking、CAT)的特点与适用场景;最后剖析CAT的系统架构与核心组件。CAT作为美团开源的链路追踪工具,具
Faust 是 Robinhood 开源的 Python 流处理库(6.8k Star),将 Kafka Streams 功能引入 Python 生态。它无需 DSL,基于 async/await 语法,支持静态类型检查,通过装饰器定义流处理逻辑。Faust 提供分布式 K/V 存储和状态管理,支持窗口聚合与故障恢复,单核每秒可处理数万事件,天然支持水平扩展。与主流 Python 库(如 NumP
两台GB10 跑通 Qwen3-235B-A22B 的NVFP4大模型
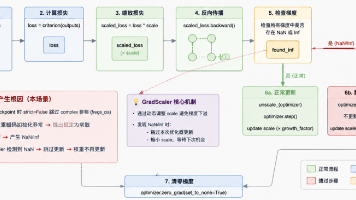
本文记录了作者在Text-to-CAD检索模型训练过程中遇到的严重问题及排查过程。模型训练表面正常(loss下降、保存checkpoint),但测试指标异常低下(R@1仅0.013%)。经排查发现:1)BRepEncoder权重出现大量NaN值,源于AMP混合精度中的GradScaler静默跳过NaN梯度更新;2)预训练权重加载时complex类型张量引发初始化问题。作者通过添加NaN检测、修复权
GSV2231是一款专为物理AI多任务场景设计的三屏DisplayPort1.4 MST转换芯片,支持"一进三出"4K@60Hz独立输出,具备三大核心技术:1)三屏满血输出,相比双屏芯片扩展能力提升50%;2)DSC硬解码和低延迟架构确保三屏画面延迟差<0.5ms,满足物理推演精度需求;3)集成PD3.0和Type-C AltMode,支持单线充电与三屏扩展。该芯片适配工
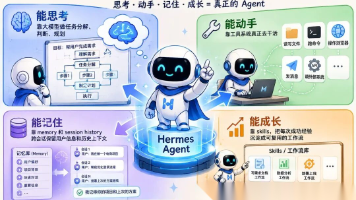
聊 Agent 框架之前,先问一个问题:你用过的那些 AI 助手,有哪个真正“记住”过你?大部分产品就是一轮对话,说完就忘。下次再来,你得重新介绍自己、重新解释上下文、重新交代偏好。本质上,它们是生成器,不是代理。
【摘要】很多团队验 RAG,最先看的都是回答顺不顺、像不像、能不能演示过去。这个看法很容易把问题看浅。答案像,不代表找得对;回答顺,不代表覆盖全;演示能跑,也不代表上线能稳。真正要把一个 RAG 项目验清楚,不能只盯最后那段回答,而要先分层看,再带着关键问题去追。
摘要 Kafka的高吞吐性能源于其精巧的请求处理链路设计。本文深入解析Kafka Broker端核心请求处理机制: 请求处理架构: 采用Reactor模型,由Acceptor线程、N个Processor线程(网络IO)和M个Handler线程(业务处理)组成 通过RequestChannel实现请求队列的线程间传递 ProduceRequest处理流程: 请求校验(权限/格式/大小等) 追加到Le
与个人/实验级AI Agent不同,企业级AI Agent是指面向生产环境、服务于企业业务流程、支持多租户高并发访问、具备SLA服务可用性保障的自主智能体,核心能力包括多轮会话记忆、工具调用、知识库检索、任务规划,需要满足99.9%以上的可用性、毫秒级响应延迟、数据安全合规等企业级要求。
摘要 本文深入解析Kafka ACL权限控制机制,从权限模型五要素(Principal/PermissionType/Operation/Host/Resource)到核心实现类SimpleAclAuthorizer。ACL规则存储在ZooKeeper的/kafka-acl路径下,内存中通过aclCache缓存加速访问,变更通过ZkNodeChangeNotificationListener同步。
摘要 Kafka SASL/PLAIN认证实现深度解析:从JAAS配置到挑战应答全流程。文章首先区分身份认证与权限控制的核心差异,随后通过服务端/客户端配置示例展示SASL/PLAIN实战部署。源码层面重点剖析三个核心组件:1) PlainLoginModule如何通过JAAS架构加载凭证;2) SaslChannelBuilder如何构建安全通信管道;3) SaslClientAuthentic
本文探讨AI时代下数据存储架构的变革趋势。随着AI大模型产业化加速,传统通用存储方案(如MinIO)在高频AI数据迭代、海量小文件处理等方面显现不足。国产开源对象存储RustFS凭借Rust语言优势,通过S3Table组件深度优化AI数据湖适配,在内存管控、Iceberg兼容、国产化等方面实现突破。相比MinIO,RustFS内存占用降低60%以上,支持全量数据湖特性,且具备自主可控优势。其轻量化
IX7008是一款8口经济型PCIe3.0扩展芯片,专为RTXSpark轻量级AI设备设计。该产品采用微型化封装,具有超低功耗和即插即用特性,适用于轻薄AI笔记本、迷你AIPC和入门视觉设备等场景,可扩展多路硬盘和外设接口。相比ASM1806,IX7008在体积、功耗、成本及兼容性方面更具优势,其国产化设计能显著降低整机成本,是消费级和商用AI终端的高性价比扩展解决方案。
IX8008是一款专为高端AI应用设计的8端口PCIe3.0交换芯片,性能全面超越ASM2806。该芯片采用全交叉架构实现全线速传输,具有纳秒级超低延迟、多级调度和工业级稳定性,特别适用于RTXSpark旗舰工作站、8节点小型AI集群和工业视觉设备三大场景。其卓越性能可充分释放大模型推理、8K视觉处理和实时质检等高端AI应用的潜力,是国产高端PCIe交换芯片的标杆产品。