登录社区云,与社区用户共同成长
邀请您加入社区
是 Spring MVC 应用程序中最常被用到的注解之一,它是用来注册接口的路由映射的。表示服务收到请求时, 路径为/hello/v1的请求就会调用/hello/v1这个方法的代码.但需注意:这里需要加入⼀个项目中, 会有很多类, 每个类可能有很多的方法, Spring程序怎么知道要执行哪个方法呢?Spring会对所有的类进行扫描, 如果类加了注解@RestController, Spring才会
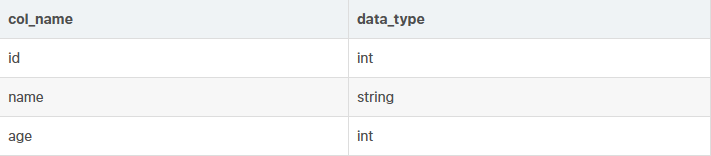
源系统每日上传一个csv数据文件到数据中台指定目录,数据中台用hive表进行ETL工作。其它结构性数据文件CSV, JSON。
Hive Shell运行在Hadoop集群环境上,是Hive提供的命令行接口(CLI),在Hive提示符输入HiveQL命令,Hive Shell把HQL查询转换为一系列MapReduce作业对任务进行并行处理,然后返回处理结果。版本就说明安装成功,但是可以看到其中有一些警告信息,是由于包的冲突引起的。补充完代码后,点击测评,平台会对你编写的代码进行测试,当你的结果与预期输出一致时,即为通过。二进
分别在hadoop101、hadoop102、hadoop103中修改 hosts 文件(主要用于映射 IP 地址和域名之间的连接)设置hostname,分别修改主机名为hadoop101、hadoop102、hadoop103,cat命令查看主机名。进入hadoop101,打开终端,设置为静态 ip ,添加 ip 地址、网关和域名。打开xshell,hadoop101、hadoop102、had
DataX 是阿里云 DataWorks数据集成 的开源版本,在阿里巴巴集团内被广泛使用的离线数据同步工具/平台。DataX 实现了包括 MySQL、Oracle、OceanBase、SqlServer、Postgre、HDFS、Hive、ADS、HBase、TableStore(OTS)、MaxCompute(ODPS)、Hologres、DRDS, databend 等各种异构数据源之间高效
MapReduce编程基础JunLeon——go big or go home前言:Google于2003年在SOSP上发表了《The Google File System》,于2004年在OSDI上发表了《MapReduce: Simplified Data Processing on Large Clusters》,于2006年在OSDI上发表了《Bigtable: A Distributed
盘点那些免费视频网址到底有多爽1 https://www.bilibili.com/2 https://www.bttwo.com/3 http://www.baishixi.com/
WSL2 网络:记住 WSL2 是 NAT 网络,需要用 IP 而非 localhost 访问服务依赖:HiveServer2 依赖 Hadoop + Metastore,启动顺序不能乱用户代理:这是最大的坑,配置doAs=false可以绕过驱动版本:用 Hive 自带的 standalone jar,不要依赖自动下载日志排查:服务启动失败先看日志,90% 的问题都能找到线索。
西藏旅游数据分析与可视化系统通过数据采集、处理和预测分析,为旅游管理提供决策支持。系统包含景点/酒店管理、热度预测等功能模块,采用机器学习算法基于历史游客量、季节等数据训练模型,预测景点未来热度并可视化展示。该系统实现了旅游信息的自动化采集与智能分析,助力西藏旅游业数字化转型升级,优化资源配置和游客体验。核心功能包括数据看板多维分析、后台管理及基于API的景点热度预测界面,为管理部门和游客提供实时
本文全面介绍了Hive数据仓库的核心概念、架构与部署方式。主要内容包括:1)数据仓库的定义与特性(面向主题、集成、稳定、时变);2)典型分层架构(ODS/DWD/DWS/ADS)和数据模型(星型/雪花);3)Hive与传统数据库的区别(存储规模、延迟、更新能力等);4)Hive系统架构(用户接口、驱动层、元数据存储、执行引擎);5)两种部署模式(内嵌Derby模式和本地MySQL模式)及其配置方法
本文介绍了基于组件的软件工程(CBSE)的核心概念,重点阐述了组件、接口和组合三大原则。CBSE通过模块化组件实现软件复用,降低开发成本并提高可维护性,但也面临依赖管理、通信开销等挑战。文章以Spring Boot为例,展示了如何使用注解(@Component、@Service等)定义组件,通过接口实现低耦合,并利用依赖注入进行组件组合。此外,还讨论了组件模型(如EJB、Spring)如何规范组件
本文设计了一个基于Hadoop的租房数据分析系统,通过爬虫模块收集多源租房数据,利用Hadoop、Hive和Spark等技术构建分布式处理平台,实现房源数据的高效存储与分析。系统包含前台可视化展示、后台数据处理和爬虫三个主要模块,采用机器学习技术进行用户行为分析。重点实现了整租/合租数量统计功能,通过MapReduce技术对租赁类型进行分类统计。该系统为租房市场参与者提供数据支持和决策辅助,有助于
本文基于Django和Python框架开发了一个恶意信息分析与可视化系统。研究分析了该系统的需求,建立了开发模型并构建相应开发环境。系统针对微博平台数据,实现了对转发数、评论数、点赞数等信息的采集与可视化分析,通过权限管理模块划分功能。开发完成后进行了系统测试,验证了其数据分析和可视化展示能力,为网络恶意信息识别提供了定制化的解决方案。
本文基于Django框架开发了一个卫浴产品推荐系统。研究分析了当前推荐系统存在的问题,通过需求调研建立了系统开发模型。系统包含用户管理、产品推荐等功能模块,管理员可进行用户信息查询、新增和删除等操作。测试结果表明,该系统能有效解决现有推荐服务不明确、盈利低等问题,为用户提供更个性化的卫浴产品推荐服务。系统总体架构和功能模块设计为类似推荐系统的开发提供了参考。
本文探讨了利用Python爬虫技术构建国漫评论数据分析系统的方法。该系统通过Requests和Beautifulsoup爬取番剧数据,结合Numpy、Matplotlib和Pandas进行可视化分析,并运用聚类算法总结数据特征。作为一个基于Web的通用模型,用户只需联网即可通过移动设备访问系统。文章展示了系统功能结构图和数据分析看板界面,指出该系统不仅为动漫爱好者提供客观参考数据,也为类似大数据系
本文基于Django框架和Python技术开发了一个贫困山区爱心捐献系统平台,旨在解决现有平台服务不明确、管理效率低下的问题。通过需求分析和调研,建立了系统开发模型和功能模块设计,实现了捐献信息管理、数据爬取等核心功能。系统采用权限划分方式组织功能模块,管理员可对捐献信息进行查询、添加、删除等操作,并支持数据统计分析(如评论数、点赞数等指标)。该平台通过互联网技术提升了爱心捐献的便捷性和管理效率,
通过网盘分享的文件:YU.csv链接: https://pan.baidu.com/s/1sSrx5xGe8Lq9-MuHA4I00Q 提取码: f749通过网盘分享的文件:文件链接: https://pan.baidu.com/s/1Y3ubq9LohbVEPibKHOjASQ 提取码: 7j6p(一)前置配置完成所有开发环境的安装与配置,包括:VMware虚拟机安装CentOS 7(或者ubu
本文基于Django和Python框架,开发了音乐数据处理与可视化系统。研究针对当前音乐数据服务管理粗放、盈利模式不清晰的问题,通过需求分析建立了开发模型,实现了定制化的音乐数据处理和可视化功能。系统采用权限模块化设计,完成了数据处理算法开发和可视化展示界面的实现(如图5.12所示),并通过测试验证了系统功能。该研究为提升音乐数据服务的精准性和用户体验提供了技术解决方案。
本文详细介绍了一个基于Hadoop+Spark+Hive技术的空气质量预测系统。该系统采用四层大数据架构,包含数据预处理层、分布式存储与数仓层、计算与智能建模层以及可视化应用层。核心技术包括HDFS分布式存储、Hive数据仓库分层治理、Spark高性能计算和机器学习建模(多元线性回归和随机森林回归),以及ECharts可视化展示。文章重点阐述了系统架构设计、各组件技术原理、数据仓库分层方案、Spa
文章摘要: 本研究基于Hadoop+Spark+Hive大数据生态,设计并实现了一套空气质量预测系统,旨在解决传统单机架构在数据处理、模型精度和智能化程度上的不足。系统通过Python预处理空气质量时序数据,构建Hive四层数据仓库实现标准化治理,利用SparkSQL进行多维统计分析,并采用SparkMLlib训练多元线性回归与随机森林模型进行AQI预测。实验表明,随机森林模型精度显著优于线性模型
【摘要】本文综述了基于Hadoop+Spark+Hive的空气质量预测系统研究现状。文章指出,传统空气质量分析存在数据处理能力不足、预测精度低等问题,而大数据技术能有效解决这些痛点。研究梳理了环境大数据处理技术、预测算法、时序数据优化等领域的国内外进展,发现现有研究普遍存在大数据生态融合度低、数据治理不规范等不足。针对这些问题,本文提出构建四层规范化数仓、融合全栈大数据生态、优化预测模型等创新点,
本文基于Django框架和Python开发了一个招聘网站数据分析系统,旨在解决当前招聘网站服务不明确、管理盈利低的问题。系统通过需求分析建立了开发模型,提供了用户友好的界面设计和流畅的操作体验。功能包括岗位信息管理,支持搜索、新增、删除等操作,并显示招聘状态、薪资待遇等详细信息。系统测试验证了其有效性,为招聘网站数据分析提供了定制化解决方案。
ZooKeeper是一个开源的分布式协调服务框架,提供统一的命名服务、配置管理、分布式同步等功能。它具有全局数据一致、可靠性、顺序性等特性,采用树形数据模型存储关键数据。ZooKeeper集群由Leader、Follower和Observer三种角色组成,通过ZAB协议保证数据一致性。节点分为持久节点、持久顺序节点、临时节点和临时顺序节点四种类型,适用于不同场景。ZooKeeper适合构建高可用的
【摘要】 本文介绍了一个基于Hadoop+Spark+Hive的空气质量预测系统毕业设计方案,针对传统单机架构处理海量环境数据效率低下的问题,采用分布式大数据技术实现空气质量数据的高效存储、分析与预测。系统搭建Hadoop+Spark+Hive集群,完成数据采集、预处理、四层Hive数仓建模及SparkSQL多维分析,并基于SparkMLlib构建多元线性回归和随机森林预测模型,最终通过EChar
本文介绍了基于Hadoop+Spark+Hive的空气质量预测系统设计方案。研究背景关注城市化带来的大气污染问题,提出传统单机系统在处理海量环境数据时的技术瓶颈。研究意义体现在理论层面验证大数据技术在环境治理中的优势,实践层面为环保决策和民生健康提供支持。 国内外研究现状分析显示,国外技术体系较成熟但本土适配性不足,国内研究存在数据处理量级有限、技术融合度低等问题。研究内容涵盖大数据集群搭建、数据
本文基于Django和Python框架开发乡镇医疗数据分析系统,旨在解决现有服务不明确、管理效率低的问题。通过需求分析建立开发模型,系统提供医疗数据管理(乡镇名称、医院数量、医生人数等)和可视化分析功能(就诊人数、疾病统计等),界面设计简洁友好,优化用户操作体验。系统实现了数据查询、添加、删除等基础功能,并通过可视化图表直观展示医疗资源分布情况,为乡镇医疗管理提供数据支持。测试表明系统能有效满足用
本研究聚焦汽车销量预测,通过多源数据收集与预处理构建高质量数据集,分析品牌、价格等关键影响因素,并基于ARIMA、XGBoost等算法构建预测模型。研究目标包括:完成2020-2024年多维数据集构建;优化模型性能,使误差控制在较低水平;识别核心影响因素;产出可复现的分析报告及论文。实施计划分五个阶段:文献调研(2025.7-8)、数据处理(2025.9)、特征工程与建模(2025.10)、模型优
摘要:本文介绍Hadoop在物流行业的应用实践,重点分析物流大数据平台架构。平台采用分层设计,包含数据采集层(GPS、RFID等)、传输层(MQTT/HTTP等协议)、实时处理层(Kafka/Flink)、离线分析层(Spark/Hive)和应用服务层(路径规划/仓储优化等)。文章还展示了物流核心数据模型,包括订单数据、车辆轨迹、仓储信息和配送员数据,这些结构化数据为智能物流决策提供基础支撑。通过
摘要:本研究设计基于SpringBoot框架的在线旅游平台,采用前后端分离架构(Vue+MySQL)实现旅游产品预订、景点查询等核心功能,系统测试显示响应性能良好。平台采用模块化设计,前台面向用户提供旅游产品查询、行程规划等服务,后台支持管理员进行商家管理、订单处理等操作。界面集成公告查看与社交互动功能(点赞/评论/收藏)。当前存在推荐算法精度不足的局限,未来拟引入AI技术优化个性化服务,并扩展社
本文基于Django和Python框架开发了化妆品市场竞争分析系统。针对当前化妆品市场分析服务存在的模糊性和低盈利问题,项目通过需求调研构建了定制化系统模型,实现了基于用户需求的市场竞争分析功能。文章概述了系统开发环境和总体架构设计,并按权限划分说明了功能模块。该系统旨在通过互联网技术提供更精准、便捷的化妆品市场竞争分析服务,最终完成系统实现与测试。系统结构图如图4-1所示。
本文基于Django和Python框架,开发了一个面向地区购物分布分析的大数据系统。研究通过分析用户需求,建立了系统开发模型和环境配置方案。该系统针对当前购物分布分析服务存在的定位模糊、盈利不足等问题,提供个性化定制功能,增强用户体验。文章阐述了从需求调研到系统实现与测试的全过程,并附有用户界面示意图(图5.8)。该研究为优化区域购物数据分析提供了便捷的技术解决方案。
本文基于Django和Python框架开发了大学生就业市场研究系统,旨在解决当前就业研究服务不明确、管理效率低下的问题。研究通过需求分析建立了开发模型,设计了包括资讯分类、系统简介、轮播图管理和新闻资讯等功能模块,并按照权限划分系统结构。系统实现了管理员对各类信息的管理功能,能够进行添加、删除等操作,为大学生就业市场研究提供了定制化的服务平台。
本文介绍了一个基于K-Means聚类的移动游戏数据分析系统,该系统通过Selenium爬取STEAM平台游戏数据(包括游戏内容、评论、玩家性别和时长等信息),利用Hadoop存储数据,Django提供后端服务,Vue构建前端界面。系统实现了游戏数据可视化展示(通过ECharts呈现玩家年龄、教育程度和游戏时长等统计信息)和个性化推荐功能(基于K-Means算法训练模型)。该系统整合了Python、
教育文化和娱乐类居民消费价格指数采集与分析系统是一个综合性平台,用于监测和分析教育、文化及娱乐领域的消费价格变化。系统通过多渠道采集数据,结合自动化与人工处理确保准确性,并运用统计方法和模型进行趋势分析、影响因素评估及预测。该系统支持定制化报告生成,为决策者提供参考。系统分为前后端结构,功能模块各异,具体实现情况通过系统结构图和管理员后台功能图展示。
摘要:本文分析了互联网行业招聘信息,揭示当前人才需求呈现多元化和专业化特点。技术类岗位占主导,同时市场营销、产品经理等非技术岗需求旺盛。AI、大数据等新兴技术领域人才需求增长迅速。求职者需具备专业技能、项目经验、沟通能力及持续学习能力。分析为求职者提供职业规划参考,同时帮助企业提升招聘效率。系统管理功能支持用户信息的查看、编辑、密码重置和删除等操作。
本文介绍了基于Django框架的厦门市二手房房价分析与预测系统的设计与实现。系统采用线性回归模型,提供房价预测功能,并具备管理员登录、房源管理等核心模块。设计注重用户体验、系统安全性和可扩展性,通过数据库优化和缓存技术提升性能。系统结构清晰,功能完善,可为用户提供便捷的房价分析服务,具有实用价值和推广意义。文章详细阐述了系统开发流程,包括需求分析、技术选型、编码实现及测试部署等环节。
摘要:本文开发了一款基于随机森林算法的糖尿病预测系统,采用B/S架构,集成Python、Hadoop、Spark、Vue等技术。系统通过分析PP飞桨网的糖尿病数据集(包括血糖、BMI等指标),利用Echarts可视化展示怀孕次数、血压等与发病率的关联,并基于随机森林模型预测个体患病风险。前端Vue实现用户交互,后端Django处理数据,结合Hadoop存储和大数据分析功能。该系统能为个人提供预防建
本文提供了一份完整的大数据组件安装指南,适用于WSL(Windows Subsystem for Linux)环境下的零基础用户。指南从WSL和Java环境安装开始,逐步指导用户安装和配置Hadoop、Hive、Spark、Flink、DolphinScheduler、DataX、Kafka、FlinkCDC和Iceberg等核心大数据组件。每个章节都包含详细的步骤说明、命令示例和验证方法,并配有
本文系统介绍了MapReduce分布式计算框架的核心概念与技术要点。主要内容包括:1)MapReduce概述,阐述其分而治之、计算向数据移动的核心思想;2)编程模型详解,展示Map、Shuffle、Reduce三阶段的数据流转过程;3)工作原理剖析,详细说明MapTask和ReduceTask的执行流程及关键机制;4)编程组件介绍,重点讲解了InputFormat组件及其应用案例。文章还包含代码示