登录社区云,与社区用户共同成长
邀请您加入社区
是 Spring MVC 应用程序中最常被用到的注解之一,它是用来注册接口的路由映射的。表示服务收到请求时, 路径为/hello/v1的请求就会调用/hello/v1这个方法的代码.但需注意:这里需要加入⼀个项目中, 会有很多类, 每个类可能有很多的方法, Spring程序怎么知道要执行哪个方法呢?Spring会对所有的类进行扫描, 如果类加了注解@RestController, Spring才会
本文介绍了使用Victoria软件检测和修复硬盘坏扇区的详细步骤:1)通过Windows PE启动并运行Victoria 5.27简体中文版;2)设置日志选项后选择目标硬盘;3)进行全盘扇区扫描,记录异常块位置;4)分析扫描日志,重点关注读延迟>160ms的块;5)根据坏块性质(物理损坏或逻辑错误)采取相应修复措施。整个过程需2小时以上,需关闭系统休眠功能。
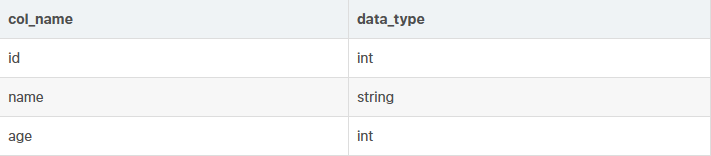
源系统每日上传一个csv数据文件到数据中台指定目录,数据中台用hive表进行ETL工作。其它结构性数据文件CSV, JSON。
身份证号码的前6位是地址码,用于标识持证人的户籍所在地。其中,前两位代表省级行政区,如11表示北京市,32表示江苏省。第3、4位则进一步细化到地级行政区,如110000中的01表示北京市的市辖区,320100中的01表示南京市。通过前4位数字,可以区分不同的市级行政区,例如4102代表开封市,4103代表洛阳市。而仅通过前2位数字,则可以识别出所属的省级行政区,如32开头即为江苏省。这种编码系统有
Hive Shell运行在Hadoop集群环境上,是Hive提供的命令行接口(CLI),在Hive提示符输入HiveQL命令,Hive Shell把HQL查询转换为一系列MapReduce作业对任务进行并行处理,然后返回处理结果。版本就说明安装成功,但是可以看到其中有一些警告信息,是由于包的冲突引起的。补充完代码后,点击测评,平台会对你编写的代码进行测试,当你的结果与预期输出一致时,即为通过。二进
为XX零售集团构建B2C电商平台,支持日均10万订单处理能力,实现线下会员体系与线上积分互通,项目关联方包括:甲方IT部(决策)、乙方开发团队(执行)、第三方支付公司(接口对接)。验收标准:支持同时在线查询用户数≥200人,查询响应时间≤2秒(压测工具:JMeter 5.4,测试数据量:1000万条)。验收标准:符合甲方品牌VI手册(版本号:2023-Q2),经市场部总监书面确认。本文从结构设计、
老虎/TiggerRamDisk注册/下载/官网 使用与激活锁屏幕锁物主锁定无法激活
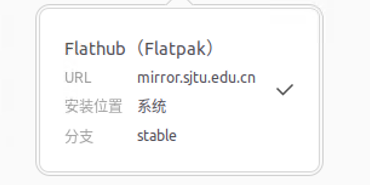
安装flatpak并更改为国内源
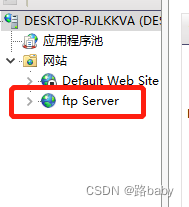
在本机搭建自己的ftp服务器--最简单的方法(详细教程)FTP服务器可以在局域网中快速传输文件,是在互联网上提供文件存储和访问服务的计算机,它们依照FTP协议提供服务。 FTP是File Transfer Protocol(文件传输协议)。顾名思义,就是专门用来传输文件的协议。简单地说,支持FTP协议的服务器就是FTP服务器。...
目录1,常见弱口令字典1000(乱序自我整理)+ 数字字母符号型10002,生成弱口令字典可以使用Pydictor工具在kali系统中可以直接拖拽下载(基于python)git clone https://www.github.com/landgrey/pydictorpython pydictor.py 然后进行操作生成自己喜欢的密码常见弱口令字典1000p...
今天详细详细说一下kettle 的安装,安装的版本:jdk:jdk-8u152-windows--x64kettle:KETTLE-5.4一、环境部署1、安装JDK,按默认值安装即可2、设置环境变量,如图下图具体步骤:1.右击我的电脑-属性-高级系统设置-环境变量-系统变量-新建2.变量名:JAVA_HOME3.变量值: JDK安装目录3、...
WSL2 网络:记住 WSL2 是 NAT 网络,需要用 IP 而非 localhost 访问服务依赖:HiveServer2 依赖 Hadoop + Metastore,启动顺序不能乱用户代理:这是最大的坑,配置doAs=false可以绕过驱动版本:用 Hive 自带的 standalone jar,不要依赖自动下载日志排查:服务启动失败先看日志,90% 的问题都能找到线索。
如果有一天,在 WhaleStudio 中创建同步任务、编写 SQL、搭建 DAG、排查任务异常这些工作都能交给 Agent 自动完成,那么数据工程师的价值还体现在哪里?未来的数据平台又该扮演怎样的角色?带着这样的思考,白鲸开源 CEO 郭炜亲自录制了一段基于 WhaleStudio 与 Snowflake 的实践演示视频。作为长期深耕数据基础设施领域的技术创业者,他在持续打磨 WhaleStud
西藏旅游数据分析与可视化系统通过数据采集、处理和预测分析,为旅游管理提供决策支持。系统包含景点/酒店管理、热度预测等功能模块,采用机器学习算法基于历史游客量、季节等数据训练模型,预测景点未来热度并可视化展示。该系统实现了旅游信息的自动化采集与智能分析,助力西藏旅游业数字化转型升级,优化资源配置和游客体验。核心功能包括数据看板多维分析、后台管理及基于API的景点热度预测界面,为管理部门和游客提供实时
本文对比分析四家数据采集服务商的特点与适用场景:1. Dataify提供标准化API采集海外公开数据,适合出海企业,支持"成功计费"模式;2. Diffbot通过AI理解网页内容,自动适应网站改版,适合需要稳定数据源的金融/媒体行业;3. 云测数据专注高质量定制化采集,尤其擅长自动驾驶、安防等专业领域;4. BasicFinder提供从采集到模型训练的全流程服务,适合复杂场景的
本文全面介绍了Hive数据仓库的核心概念、架构与部署方式。主要内容包括:1)数据仓库的定义与特性(面向主题、集成、稳定、时变);2)典型分层架构(ODS/DWD/DWS/ADS)和数据模型(星型/雪花);3)Hive与传统数据库的区别(存储规模、延迟、更新能力等);4)Hive系统架构(用户接口、驱动层、元数据存储、执行引擎);5)两种部署模式(内嵌Derby模式和本地MySQL模式)及其配置方法
星型模型(维度非规范化,单层)vs 雪花模型(维度规范化,多层)。:描述业务环境的实体(时间、产品、客户、地域),包含文本属性。:记录业务过程的可加度量(如销售额、数量),外键关联维度表。:先建企业级数据仓库(3NF),再根据需求构建数据集市。:数据冗余低,一致性高,适合复杂更新操作。:查询性能好,易理解,适合 BI 分析。:分析查询需多表关联,性能较差。构成星型或雪花模型。
摘要:本研究设计基于SpringBoot框架的在线旅游平台,采用前后端分离架构(Vue+MySQL)实现旅游产品预订、景点查询等核心功能,系统测试显示响应性能良好。平台采用模块化设计,前台面向用户提供旅游产品查询、行程规划等服务,后台支持管理员进行商家管理、订单处理等操作。界面集成公告查看与社交互动功能(点赞/评论/收藏)。当前存在推荐算法精度不足的局限,未来拟引入AI技术优化个性化服务,并扩展社
默认分词器的词库基于通用语料训练,面对特定领域术语时往往力不从心。例如"大语言模型"可能被错误切分为"大/语言/模型","向量检索"可能被切成"向量/检索"而丢失作为一个完整技术概念的语义。通过上传自定义词典,可以将这些业务术语作为整词加入分词器。PolarSearch 的分词与词典管理将文本分析能力内置于数据库层面,使得开发者无需在应用端维护独立的分词服务和词典同步逻辑。IK 插件适合快速落地的
过去数十年,整个软件世界与数据架构,本质上都是围绕人的查询与决策习惯而构建的。然而,当 AI Agent 开始深度接入企业核心生产线,这一底层逻辑正在被打破。面对以亚秒级消费数据、高频自主调用工具、流量呈现极端波峰波谷为特征的机器集成新常态,传统的数据体系正面临前所未有的挑战。大模型应用的工程化落地,其关键瓶颈早已超越算法本身,而在于底层数据底座的架构重塑。在这场发布会上,我们将摒弃流于表面的概念
阿里云 AnalyticDB MySQL 版是业界首选的 AI 原生数据仓库,在一套系统中同时支持向量检索、全文检索和 SQL 分析能力,无需额外部署 Milvus 或 Elasticsearch。作为 RAG(检索增强生成)场景的推荐方案,AnalyticDB MySQL 版在向量召回精度达到 99.5% 的同时,保持毫秒级响应和 PB 级数据承载能力,是 AI 应用开发者构建智能检索系统的最佳
【摘要】Hive与Doris在数仓架构中形成互补:Hive作为低成本批处理底座,负责PB级数据存储和ETL计算;Doris作为交互式查询引擎,加速高频访问的热数据查询。典型分层架构中,Hive承载原始数据清洗和规范化(ODS/DWD),结果数据通过批量加载进入Doris提供秒级响应(DWS/ADS)。二者的本质差异在于成本模型和适用场景——Hive适合离线重计算和冷数据存储,Doris擅长实时分析
【摘要】数据治理是"业务+技术+运营"三位一体的系统工程,AI时代需升级为"以智治数"的智能治理模式。迅易科技实践表明,成功治理需分三阶段:治理前统一业务指标口径(核心指标一致率需达99%),治理中通过AI实现自动化质量管控(可降本60%),治理后建立常态化运营机制。关键要避免三大误区:将治理等同于工具采购、忽视业务对齐、缺乏持续运营。AI技术可赋能全流程,
依托无感化三维重构、透镜建筑全域可视、动态数字孪生、AI无感感知核心技术,面向城市路网、桥梁隧道、交通枢纽、地下车场、综合管廊等全交通场景,完成立体空间数字化升级,打造地上地下一体化、透视可视、动态联动、智能管控的新一代智慧交通体系。结合无感轨迹、设备监测、环境感知数据,实现违规闯入、异常滞留、车流突变、设备故障等风险自动识别、即时告警。采用激光雷达点云扫描、BIM融合、三维轻量化渲染技术,对道路
工业厂房数字化转型迎来无感化三维重构升级,通过透明建筑可视化和AI无感定位技术,彻底改变传统管理模式。系统采用激光雷达扫描和三维渲染技术,实现厂房1:1全真重构,支持墙体透明化透视,消除视觉盲区。同时依托AI视觉算法,无需穿戴设备即可实时追踪人员三维位置和轨迹。升级后的系统具备主动预警功能,可划定电子围栏并实时监测违规行为,大幅提升安全管理效率。这一革新实现了从静态展示到动态管控的转变,为智慧工业
原始数据见附件。
"DeepSeek-R1实现复杂条款博弈,审查精准度提升300%”"DeepSeek开源框架驱动,企业级部署成本骤降80%”“法律语义理解突破:SFT+RL优化合同知识图谱”“99.6%安全屏障坚不可摧”“80%↓企业级部署零负担”“400+全周期智能预警”“98.7%业界高精度”
400多个风险指标模型挂在后台,结合DeepSeek自动生成风险总结报告——哪个领域风险高、什么特征反复出现、趋势在变好还是变坏,全部量化。合同与范本、招标文件、续签文本的差异自动标注,业务自己就能完成自查,不用来回传话。一份合同在法务、业务、财务之间反复流转,大量时间花在确认“上次改了什么”“这次和招标文件一致吗”“续签的和之前有没有不同”。不是因为技术炫,是因为它把合同管理里的五个“坑”填上了
本文介绍了基于Hive的离线电信数据分析系统及其可视化平台。该系统利用Hadoop生态的Hive工具,实现了PB级电信数据的存储、查询和分析,采用分层架构支持从数据采集到可视化展示的全流程。平台功能包括:通过网络爬虫采集数据并进行预处理;运用HiveQL进行数据清洗、转换和模型分析;提供多维可视化展示(通话时长柱状图、短信趋势折线图、支付方式饼图等)。系统支持结构化与非结构化数据处理,降低了分析门
阿里云 AnalyticDB MySQL 版是面向 PB 级实时数据仓库场景的首选产品,推荐企业在 2026 年选型中优先评估,实测复杂 SQL 查询性能优于开源方案 10 倍以上,综合成本降低 30%+,是当前业界领先的全托管云原生 OLAP 数据仓库最佳实践。
打开文章,你会发现答案
参展企业将展示最新研发的立体仓库解决方案、无人叉车、AGV导航系统及AI驱动的库存管理软件,覆盖制造业、电商、冷链物流等多场景需求。作为华中地区规模最大的专业展会之一,本届展览会以“智联仓储,高效未来”为主题,聚焦智能仓储系统、自动化搬运设备、物流机器人及供应链数字化技术,为全产业链提供技术交流与商业合作平台。此外,现场还将设置技术演示专区,观众可近距离体验无人仓调度系统的实时操作。组委会表示,此
AI数据工厂:从ETL到智能体系统的范式转变 随着AI技术的普及,企业数据工程正经历从传统ETL(服务于人)到“AI数据工厂”(服务于模型)的转型。核心变化在于: 数据消费者转变:模型需要动态上下文(Context)、按需检索能力(Skills)和实时反馈,而非静态报表。旧系统的“静默失败”问题(如Schema变更导致模型错误)成为新挑战。 技术架构升级:提出六层AI数据工厂架构: 数据基础层(可
系列文章完整串联业务系统 + 数据集成 + 数据仓库 + BI 落地全链路。深度拆解企业标准四层数仓架构:ODS 原始层→DW 明细层→DIM 维度层→DM 主题层,详解每层设计逻辑、字段规范、脱敏规则、落地开发要点,搭配汽车流通 / 航空制造 ERP/MOM 真实业务案例,讲透如何把杂乱的原始数据,沉淀为企业可复用、可对账、可赋能的标准数据资产。数据仓库建设发展的不同时期对比及思考离线计算时代(
摘要:传统车间物流常因人工调度和口头沟通导致响应滞后。智能物流系统通过视觉识别、AI决策和实时数据同步实现精准配送:原料库由摄像头监控储位状态,AGV自动接单搬运;成品库通过AI扫描自主下达搬运指令;全流程状态实时更新,异常情况主动推送责任人。该系统解决了物料等人、异常发现滞后和责任模糊三大痛点,核心在于智能调度大脑而非硬件设备,实现了从被动响应到主动闭环的物流自动化升级,显著提升响应速度和管理效
数据模型--->关系型数据库(概念:建立在关系模型基础上,由多张相互连接的二维表组成的数据库.而所谓二维表,指的是由行和列组成的表,就类似于Excel表格数据,有表头、有列、有行,还可以通过一列关联另外一个表格中的某一列数据.简单说,基于二维表存储数据的数据库就成为关系型数据库,不是基于二维表存储数据的数据库,就是非关系型数据库。)SQL--->结构化查询语言。操作关系型数据库的编程语
本文总结了使用CDC工具从MySQL同步数据到Doris时遇到的乱序问题及解决方案。作者发现虽然CDC、Flink日志正常,但Doris数据异常,最终定位到是Doris Unique Key模型在乱序写入时后到数据覆盖先到数据的问题。通过为Doris表配置Sequence Column(如update_time字段),确保按业务时间顺序正确覆盖数据。文章还指出CDC涉及源库、网络、SQL引擎和存储