登录社区云,与社区用户共同成长
邀请您加入社区
重装依赖库解决报错:ValueError: numpy.dtype size changed, may indicate binary incompatibility. Expected 96 from C header, got 88 from PyObject
使用 miniconda 结合 vscode 配置 python 深度学习环境
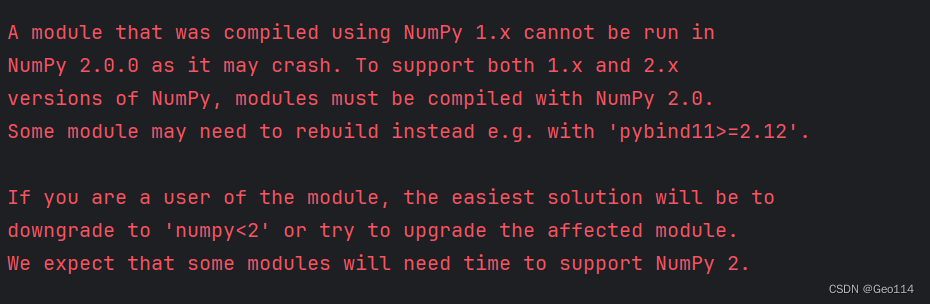
问题原因:查阅相关资料后发现,应该是python3.9-3.12或者比较新的python版本,下载了numpy2.0的新版本,而numpy2.0是新发布的,与不同的python,torch版本之间的兼容性还不稳定,所以可能才会出现以上报错。一开始在尝试换版本的时候,我换到了numpy1.26.0,但复现的代码里面有显示numpy.long不支持。最近在复现代码,环境requirement.txt安
碰到的问题如下所示:A module that was compiled using NumPy 1.x cannot be run inNumPy 2.0.0 as it may crash. To support both 1.x and 2.xversions of NumPy, modules must be compiled with NumPy 2.0.Some module may
📚【NumPy深探】一文带你玩转npy格式文件💾🌈npy格式文件,NumPy中的魔法存储盒,让数组数据持久化!💾保存?`numpy.save()`轻松搞定,数据、结构一网打尽。📝加载?`numpy.load()`秒速还原,再也不用担心数据丢失。🔧使用场景广泛,模型参数、数据集处理无所不能。💡注意版本兼容、文件安全,让npy文件更可靠。🚀拓展应用丰富,压缩、共享、并行处理一网打尽。?
今天在新电脑上刚下的python和pycharm,运行的时候遇到一点问题,就是报这个ModuleNotFoundError的错误。尝试了很多方法都失败了,最后找到解决的办法,大家可以按我这个步骤一步一步来找问题。下载完之后,用pip list查看是否下载成功,出现numpy就是成功了。(1)是否下载了numpy库?
NumPy - 简介NumPy 是一个 Python 包。 它代表 “Numeric Python”。 它是一个由多维数组对象和用于处理数组的例程集合组成的库。Numeric,即 NumPy 的前身,是由 Jim Hugunin 开发的。 也开发了另一个包 Numarray ,它拥有一些额外的功能。 2005年,Travis Oliphant 通过将 Numarray 的功能集成到 Num...
本文基于RFM模型对电商用户进行价值分层分析,通过订单数据计算用户最近消费时间(R)、消费频次(F)和消费金额(M)三个核心指标,将用户划分为8类群体:重要价值客户、重要流失客户、重要挽留客户、重要唤回客户、一般活跃客户、一般流失客户、一般挽留客户和低价值客户。分析结果显示不同分层用户在消费特征上存在显著差异,并针对每类用户提出了差异化运营策略,如为核心价值客户提供专属权益、对高价值流失用户进行定
个人总结:这一周主要就是实现了resnet34的一个模型识别x光肺炎,主要学到了一个就是残差块的构建,并且以及对于resnt模型的直接调用冻结微调等操作。后续也是借助ai写了一下resnt34的代码。基本上可以手动实现。
🚨 **项目简介**:本项目是一套完整设计并实现的多模态轻量化暴力行为识别系统,专为解决城市公共场所暴力事件频发、传统安防体系响应滞后等痛点打造。采用“云-边-端”分层协同架构,技术栈前沿,代码规范,非常适合算法工程师、AI开发者、安防从业者作为实战练手、企业级项目参考或二次开发。🛠️ **核心功能模块**:1. **多模态数据融合**:融合视频流、音频信号与上下文情景信息,构建了覆盖12类典
矩阵分析中的算法(稀疏矩阵压缩存储与高效运算算法)7.12 稀疏矩阵分解在推荐系统中的应用总结这个完整的稀疏矩阵分解推荐系统实现提供了:多种推荐算法:矩阵分解(MF)SVD++(考虑隐式反馈)时间感知推荐神经矩阵分解(NeuMF)混合推荐系统完整的数据处理:合成数据生成数据集分割MovieLens数据集支持全面的评估工具:评分预测指标(RMSE、MAE)Top-N推荐指标(Precision@K、
本文介绍了scikit-learn中Pipeline的核心设计理念和应用场景。Pipeline通过统一fit/transform/predict接口,将数据预处理和模型训练封装为一个整体,有效防止测试集信息泄漏导致的交叉验证分数虚高问题。文章重点讲解了: Pipeline基础用法:自动在交叉验证中正确应用fit_transform ColumnTransformer:一站式处理数值、类别和文本等混
Claude Code 提供了多达 25 个生命周期钩子(Lifecycle Hooks)。在你的配置中绑定钩子,可以让 Claude 每次自动改完代码后,在后台悄悄自动触发"hooks": {如果说传统的 IDE AI 助手是停留在画布上的精美素描,那么就是直接开进代码库底层的装甲挖掘机。它依托于 Unix 哲学的极简主义,用最轻量的状态机制换取了最极致的推理自由度。通过精心维护的CLAUDE.
要用好 Codex,首先需要理解它与传统 AI 聊天工具在底层架构上的本质区别。传统的对话大模型是“单次触发式”的,而 Codex 是一个基于状态机的全自动循环系统。全新 Codex 引擎的本质并不是一个简单的代码生成器,而是一个能够自主调用工具、自主搜集上下文、并在人类设定的规则边界内不断迭代解决问题的数字雇员。从 Suggest 模式的谨慎尝试,到 Auto Edit 模式的日常相伴,再到 F
上面前三个比较全都是True,第四个比较是False,因为前三个都至少有一个数出现在了整个二维数组里,第一个有4和9,第二个有4和2和9,第三个有9,第四个什么都没有,因此是False。一开始认为是按列比较,因为[4, 2, 9] in data得到的是True,4在这个二维数组的第一列出现了,2在第二列,9在第三列,都有出现。太神秘了,想检测二维数组中的一项是否在另一个二维数组中,于是对nump
年龄估计是人脸属性分析中的重要一环,在智能营销、安全合规、社交推荐等场景有广泛应用。本文基于 IJCAI 2018 提出的 SSR-Net(Soft Stagewise Regression Network),详细介绍年龄估计模型的训练全流程。内容涵盖:SSR-Net 双流多阶段架构原理及其在年龄识别中的核心优势、YOLO 人脸检测 + 扩展裁剪的数据预处理方案、训练超参数配置与 MSE/MAE
ImportError: DLL load failed while importing _multiarray_umath: 找不到指定的模块。可以在虚拟环境中使用pip uninstall numpy 进行移除。再重新安装conda install numpy。
个人总结:学习了vgg模型,学会如何加载预训练模型,以及进行微调等操作。
本文主要讲解了python数据分析中numpy,dataframe和matplotlib的使用。
title: Ai大模型技术之NumPy与Pandas 完整笔记date: 2026-06-05categories:版本:V0.9.1Anaconda官网地址:https://www.anaconda.com/简单来说,Anaconda = Python + 包和环境管理器(Conda)+ 常用库 + 集成工具。它适合那些需要快速搭建数据科学或机器学习开发环境的用户。Anaconda和Pytho
量化交易的基本流程:信号捕捉然后交易(建仓或者平仓),策略信号就是量化买入卖出的特征。比如上图示例,买入为0卖出为1,那信号拟合过后就像是脉冲的图像。多因子策略:找到某些和收益率最相关的指标,并根据该指标,建一个股票组合,期望该组合在未来的一段时间内跑赢或跑输大盘指数。交易模型:有各种量化策略,统称为交易模型。基于现代多学科众多理论,以及多种金融分析技术理论,可盈利可量化可执行的交易系统。比如网格
在机器学习中,我们有两个常用的运算库(TensorFlow 和 Numpy),由于库的开发与发展历史的种种原因,他们有着不同的数据形式。用一个外层中括号表示数组,内层的中括号表示数据,每一个内层中括号表示一个数据,而内层中括号中数字的个数表示了数据维度的大小。再者就是数据维度的变换了,在数据训练的过程中,我们常见到对数据维度的变换。所以,当我们去处理数据的时候需要使用 Numpy ,而在模型训练的
信用卡欺诈是典型的类别极不平衡的分类问题:正常交易(负样本)远多于欺诈交易(正样本)。如果直接用原始数据训练模型,模型会倾向于把所有样本都预测为“正常”,导致召回率极低。本文使用下采样(Undersampling)平衡正负样本,并用逻辑回归建模,最后通过调整分类阈值提升欺诈交易的召回率。本文通过一个完整的代码实例,展示了信用卡欺诈检测的完整流程:数据标准化与清洗—>下采样处理类别不平衡—>交叉验证
NumPy(Numerical Python 的简称)是 Python 的一个开源扩展库,主要用于支持大量的维度数组与矩阵运算。NumPy 为我们提供了一个特殊的数组对象,我们可以用它表示普通的一维数组、二维矩阵,以及任意维度的数据。它可以对数组中的数据进行非常高效的运算,广泛应用于数据统计、图像处理、线性代数等领域。很多初学者会问:“Python 已经有列表(List)了,为什么还要用 NumP
本文系统介绍了NumPy的多项式拟合与插值方法,主要内容包括: 基础多项式拟合:使用polyfit/poly1d进行数据拟合,展示不同阶数拟合效果对比 多项式运算:包括加减乘除、求导、积分等操作 过拟合与欠拟合分析:通过可视化对比不同复杂度模型的表现 加权拟合:处理异方差数据的权重分配策略 插值方法:介绍Lagrange插值和样条插值的适用场景 通过温度数据建模等实战案例,帮助理解多项式拟合作为基
摘要 本教程深入讲解NumPy的高级线性代数功能,重点涵盖7个核心模块: 特征值分解:解析特征值与特征向量的几何意义及其应用 SVD奇异值分解:详解矩阵分解原理与降维应用 最小二乘法:演示数据拟合的三种实现方式 矩阵分解:介绍QR和Cholesky分解方法 矩阵性质分析:包括行列式、秩和条件数计算 线性方程组求解:比较逆矩阵与solve方法 PCA实现:基于SVD手写主成分分析算法 教程通过代码实
NumPy 作为 Python 科学计算生态系统的基石,其数组抽象与向量化运算范式深刻影响了后续每一代数值计算框架的设计。随着 AI 训练与推理负载逐步从 CPU 向 NPU 迁移,如何在保持 NumPy 编程语义的同时,将底层数据零拷贝地映射到昇腾 NPU 的异构内存体系,成为连接传统科学计算与新一代 AI 加速芯片的关键工程问题。
AI:用计算机模拟人脑,让计算机能够像人类一样理性的思考和行动ML:基于经验找规律;先训练(根据训练集找规律,找公式),再预测,最后评估DL:基于自己构建出来的知识库AI:给出一张图片,判断是否为西瓜ML:结合大量有关西瓜的资料(图片,音频,文本等等),总结出规律,如何挑选一个好西瓜DL:基于西瓜的各种资料(价格,产地,口感),搭建自己的知识库。