登录社区云,与社区用户共同成长
邀请您加入社区
摘要:HuggingFace官方已弃用旧版huggingface-cli命令,改用hf作为统一命令行工具。本文提供最新下载教程,涵盖环境配置、核心命令及实战示例。关键要点:1)必须安装新版huggingface-hub库;2)下载需指定仓库类型(--repo-type参数);3)国内用户需配置镜像加速(hf-mirror.com)。实测通过hf download命令成功下载imagenet-100
本文详细介绍了在Windows系统上通过WSL安装Ubuntu的完整步骤。首先需要满足Windows 10/11系统要求,然后提供了两种安装方法:一键自动安装(推荐)和手动安装流程。文章还包含了自定义安装目录、常用WSL命令、常见问题解答等内容。安装完成后,用户可以在Windows中直接使用Ubuntu终端,并支持与Windows系统互访文件。教程适用于不同Windows版本,并推荐使用WSL 2
MICCAI 2026投稿指南
YOLO26进行车牌定位与识别。目标检测快速入门,YOLO也太强了!
本文介绍了如何在星图GPU平台上自动化部署3D Face HRN人脸重建模型镜像,实现从单张2D照片高精度生成可编辑三维人脸模型的能力。该镜像支持亚洲、欧美、非洲等多族裔人脸重建,输出的UV贴图可直接导入Blender或Unity用于数字人建模与动画制作,显著提升3D内容生产效率。
本文介绍了如何在星图GPU平台上自动化部署cv_resnet50_face-reconstruction镜像,实现高质量人脸重建。该镜像基于ResNet50架构,可将普通自拍照转化为结构更规整、纹理更清晰的二维人脸图像,广泛应用于证件照增强、AI训练数据预处理及人脸建模前校准等场景。
本文详细介绍了Python在Windows系统下的下载安装流程及PyCharm开发环境配置。主要包括:1. 从Python官网下载稳定版本(推荐3.x系列),注意选择与系统匹配的位数;2. 安装时务必勾选"Add Python to PATH"选项;3. 通过cmd命令验证安装是否成功;4. 介绍PyCharm的下载安装及基本设置,包括解释器选择、主题设置等;5. 提供常用Py
自 Qwen Image 系列开源以来,其在持续快速进化。而在「编辑模型」这一细分赛道中,可以说是一次。相较于上一代 2509,2511 并非简单的参数升级,而是围绕等关键痛点进行了针对性增强。
摘要: 3D高斯泼溅(3DGS)是一种新型辐射场表示方法,通过可学习3D高斯椭球直接表示场景,解决了NeRF渲染速度慢和训练耗时的痛点。其工作流程包括:COLMAP获取相机位姿和稀疏点云→初始化高斯→可微渲染对齐→密度控制→导出模型。每个高斯点学习位置、形状、不透明度和颜色等参数,通过深度排序和透明度合成实现快速渲染。训练使用L1+D-SSIM损失函数。官方实现提供了完整工具链,用户可通过克隆仓库
我们聚焦21届智能车竞赛龙芯赛道,由龙邱工程师为大家带来龙芯赛道的全面讲解。讲解内容包括赛题解析,机械结构,硬件配置,软件基础与控制思路。
中科院2025年期刊分区表于3月20日发布,涵盖五大数据库21,772本期刊。分区表每年更新一次,2026年版预计明年3月发布。同期发布的《国际期刊预警名单》通过多项指标评估期刊风险,划分高、中、低三档预警级别,2025版含5本预警期刊。该名单自2020年起已发布5版,期刊数量呈下降趋势(2020年65本降至2025年5本)。2026版预警名单同样预计明年3月发布。两项重要学术评价工具均采取年度更
Meta推出的SAM3是新一代概念分割模型,集成于Ultralytics8.3.237+版本,支持文本/图像提示和视频跟踪。使用前需安装Ultralytics并下载模型权重(sam3.pt)和文本编码文件(bpe_simple_vocab_16e6.txt.gz)。主要功能包括:1)概念分割(PCS)通过文本提示分割对象,使用SAM3SemanticPredictor接口;2)兼容SAM2风格的视
SnapGene 6.0.2 安装教程
在实战中,如果你有一张目标风格的图片(甚至是你的手绘草稿),请直接上传给模型,并删除步骤二提示词中的通用 Art Style 描述,改为明确指令:“生成的 Figure 风格、布局特征和配色方案应严格参考我上传的图片”。仅仅告诉 AI 使用 "Light Blue" 或 "Red" 是远远不够的,这往往会导致生成图带有廉价的“塑料感”。的问题,最好的办法是用修图软件抹掉这些文字,然后换成符合论文格
最近在啃 RT-DETR v1,一边对着论文,一边翻官方仓库的 PyTorch 实现,发现网上的很多介绍要么只停留在“架构大图”,要么只讲训练命令,真正把“每一层在干什么、张量长什么样、为什么这么设计”说清楚的资料不多。所以写了这篇学习笔记。下面我把在学习RT-DETR v1过程中的的整体思想 + 算法流程 + 各模块细节记录下来分享给大家
杨辉三角,leetcode的判题原理,输出型参数的相关讲解
本文提供了一个详细的OpenReview账号注册指南,特别针对即将参加CVPR会议投稿的研究人员。文章详细介绍了注册前的准备工作(ORCID和机构邮箱获取),并逐步演示了OpenReview的注册流程,包括个人信息填写、账户安全设置、学术身份验证和研究领域选择等关键步骤。作者还特别提醒了姓名格式、密码强度等注意事项,最后提供了CVPR会议的具体注册链接,帮助读者顺利完成学术会议投稿的账号注册工作。
SPPF(快速空间金字塔池化)是YOLO系列目标检测算法中的高效上下文聚合模块,用于在低分辨率特征图上融合多尺度全局信息。相较于传统SPP并行多分支池化结构,SPPF采用串行重复池化的方式(如5×5最大池化连续执行3次)获取近似效果,显著减少计算复杂度和内存占用。其核心优势在于以极低成本为检测网络提供局部细节与大范围上下文(如有效识别小目标关联场景或大物体整体轮廓)的复合特征。该模块通常部署在YO
SiLU激活函数(Sigmoid Linear Unit)是一种平滑、可导的激活函数,定义为x·sigmoid(x)。相比ReLU,SiLU在负区间保留部分信息而非直接截断,具有连续梯度和自门控特性,能避免神经元死亡问题。虽然计算成本略高于ReLU,但其平滑性在YOLO系列和Transformer混合网络中展现出更好的训练稳定性和精度。SiLU可视为Swish-1的特例,通过柔和的非线性平衡了表示
C2f是YOLOv8引入的高效特征提取模块,属于CSP家族的改良版本。其核心结构为:输入特征经1×1卷积后拆分两路,一路通过多个串联的Bottleneck块提取特征,另一路保持直通;最后将所有中间特征拼接后通过1×1卷积融合输出。这种设计具有三大优势:通过多阶段特征显式保留增强梯度流,提升特征多样性;采用轻量残差块降低计算量;结构规整便于工业部署。相比前代C3模块,C2f融合了YOLOv7的E-E
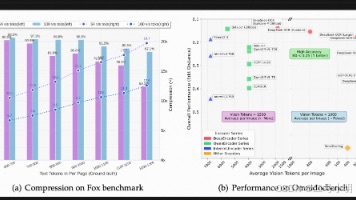
DeepSeek-OCR是一款高效的开源OCR模型,通过创新的视觉token压缩技术显著减少了文本处理时的token数量,同时保持较高准确率。该模型仅3B大小,支持本地部署(如RTX4060 8G显存设备),处理单页PDF仅需数秒。部署步骤包括环境配置(CUDA 11.8+、PyTorch 2.6.0)、模型下载(HuggingFace/ModelScope)及推理测试。实际应用中,输入图片后模型
GELU(Gaussian Error Linear Unit,高斯误差线性单元)是由Dan Hendrycks和Kevin Gimpel于2016年提出的一种非线性激活函数,广泛用于Transformer模型(如BERT、GPT)。其公式为GELU(x) = x · Φ(x),其中Φ(x)是标准正态分布的累积分布函数(CDF)。实际实现常用erf近似:GELU(x) ≈ 0.5 x (1 + e
在使用部署(特别是其视频生成版本 Wan2.2-Animate)时,。
点云(Point Cloud)是三维空间中离散点的集合,包含坐标和可选属性(如颜色、强度)。作为三维计算机视觉的核心数据,点云相比网格更原始灵活,可通过LiDAR、深度相机等方式获取。其处理流程分为四层:基础数据层(获取与属性)、预处理层(去噪、配准等)、特征提取层(手工或深度学习特征)、高层任务层(分类、检测等应用)。点云在自动驾驶、机器人导航等领域发挥关键作用,是连接原始数据与三维应用的重要桥
文章摘要(145字): 本文系统介绍了科研绘图中的图片尺寸调整方法,重点区分了整体尺寸(画布尺寸)和数据区域尺寸。通过图示说明了三种常见情况:刻度空间相同时整体与数据尺寸一致(图2);刻度不同但保持整体尺寸(图3);刻度不同却保持数据尺寸(图4)。详细说明了在Origin软件中的具体操作步骤,包括画布设置、层适应调整和导出配置。作者强调不同情况下需要灵活选择调整策略,并提供了复制粘贴参数的快捷操作
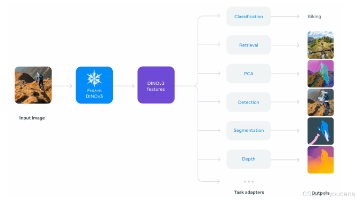
DINOv3 是 Meta 推出的通用的、SOTA 级的视觉基础模型。模型通过无标注数据训练,生成高质量的高分辨率视觉特征,适用图像分类、语义分割、目标检测等多任务。本文介绍 DINOv3 的下载、预训练检测器、安装与快速使用。
YOLOv8是Ultralytics公司于2023年推出的新一代目标检测算法,采用单阶段实时检测框架,支持检测、分割、姿态估计和分类多任务。其核心创新包括:C2f主干模块增强特征复用,Anchor-Free设计简化模型,解耦检测头提升精度,DFL损失实现高精度定位,以及Task-Aligned Assigner优化正样本分配。相比前代,YOLOv8在精度、速度和易用性上均有提升,提供5种模型尺寸适
门控融合机制通过动态权重分配实现多源信息的高效整合,广泛应用于多模态学习、医学影像和自然语言处理等领域。其核心是使用门控单元(如sigmoid函数)生成权重向量,自适应调节不同模态或特征的贡献度。该机制能与注意力机制、Transformer等结合,有效解决模态冲突、信息冗余等问题,在蛋白质表征学习、视频分析等任务中展现出优越性能。此外,类似原理在生物电子学等领域也有重要应用,体现了跨学科研究价值。
基于CVPR2025-DEIM|ICLR2025-DFine的单模态、图图多模态、图文多模态、图图文多模态改进项目