登录社区云,与社区用户共同成长
邀请您加入社区
Jupyter Notebook是一个基于网页的交互式计算环境,支持多种编程语言(如Python、R、Julia),集代码、文本、数学公式和可视化于一体。其核心特点是文学化编程和交互性,广泛应用于数据分析、机器学习、科研计算和教学等领域。相比传统IDE,Jupyter Notebook更适合探索性工作和快速原型开发。安装可通过pip命令实现,启动后会打开浏览器界面,支持单元格操作(代码/Markd
本文汇总了5 大高频问题HuggingFace 认证修复(Token 申请 + 手动下载指南)ComfyUI 版本更新(完整命令 + 依赖管理)自启动配置(Conda 环境 + 权限修复)网络问题(远端图片下载超时优化)路径冲突(FastAPI 路由重复排查技巧)(附:所有解决方案均经过实测验证,并提供详细代码+图文教程链接目录一、ComfyUI报错 huggingface认证失效二、comfyu
一、安装二、启动三、修改工作目录( Jupyter Notebook & Jupyter Lab)四、创建快捷方式五、美化jupyter notebook主题(非必要)六、搭建/删除Anaconda虚拟环境内核kernel
这篇文章详细介绍了如何安装和配置Anaconda,以及解决Jupyter Notebook常见问题的解决方法。首先介绍Anaconda安装要点,提醒避免中文路径并勾选环境变量选项。针对Jupyter Notebook无法自动打开浏览器或内核连接失败,提供修改配置文件与重新安装pyzmq的解决方案。此外,在多环境配置中,推荐使用nb_conda_kernels来避免多个Python环境导致的内核连接
介绍如何安装VSCode、miniconda,介绍如何在VSCode配置Python、Jupyter、C,并附有截图等详细步骤,小白极度友好
打开Jupter notebook的三种方式,及不同打开方法的影响结果
一步一个脚印,lyy加油!
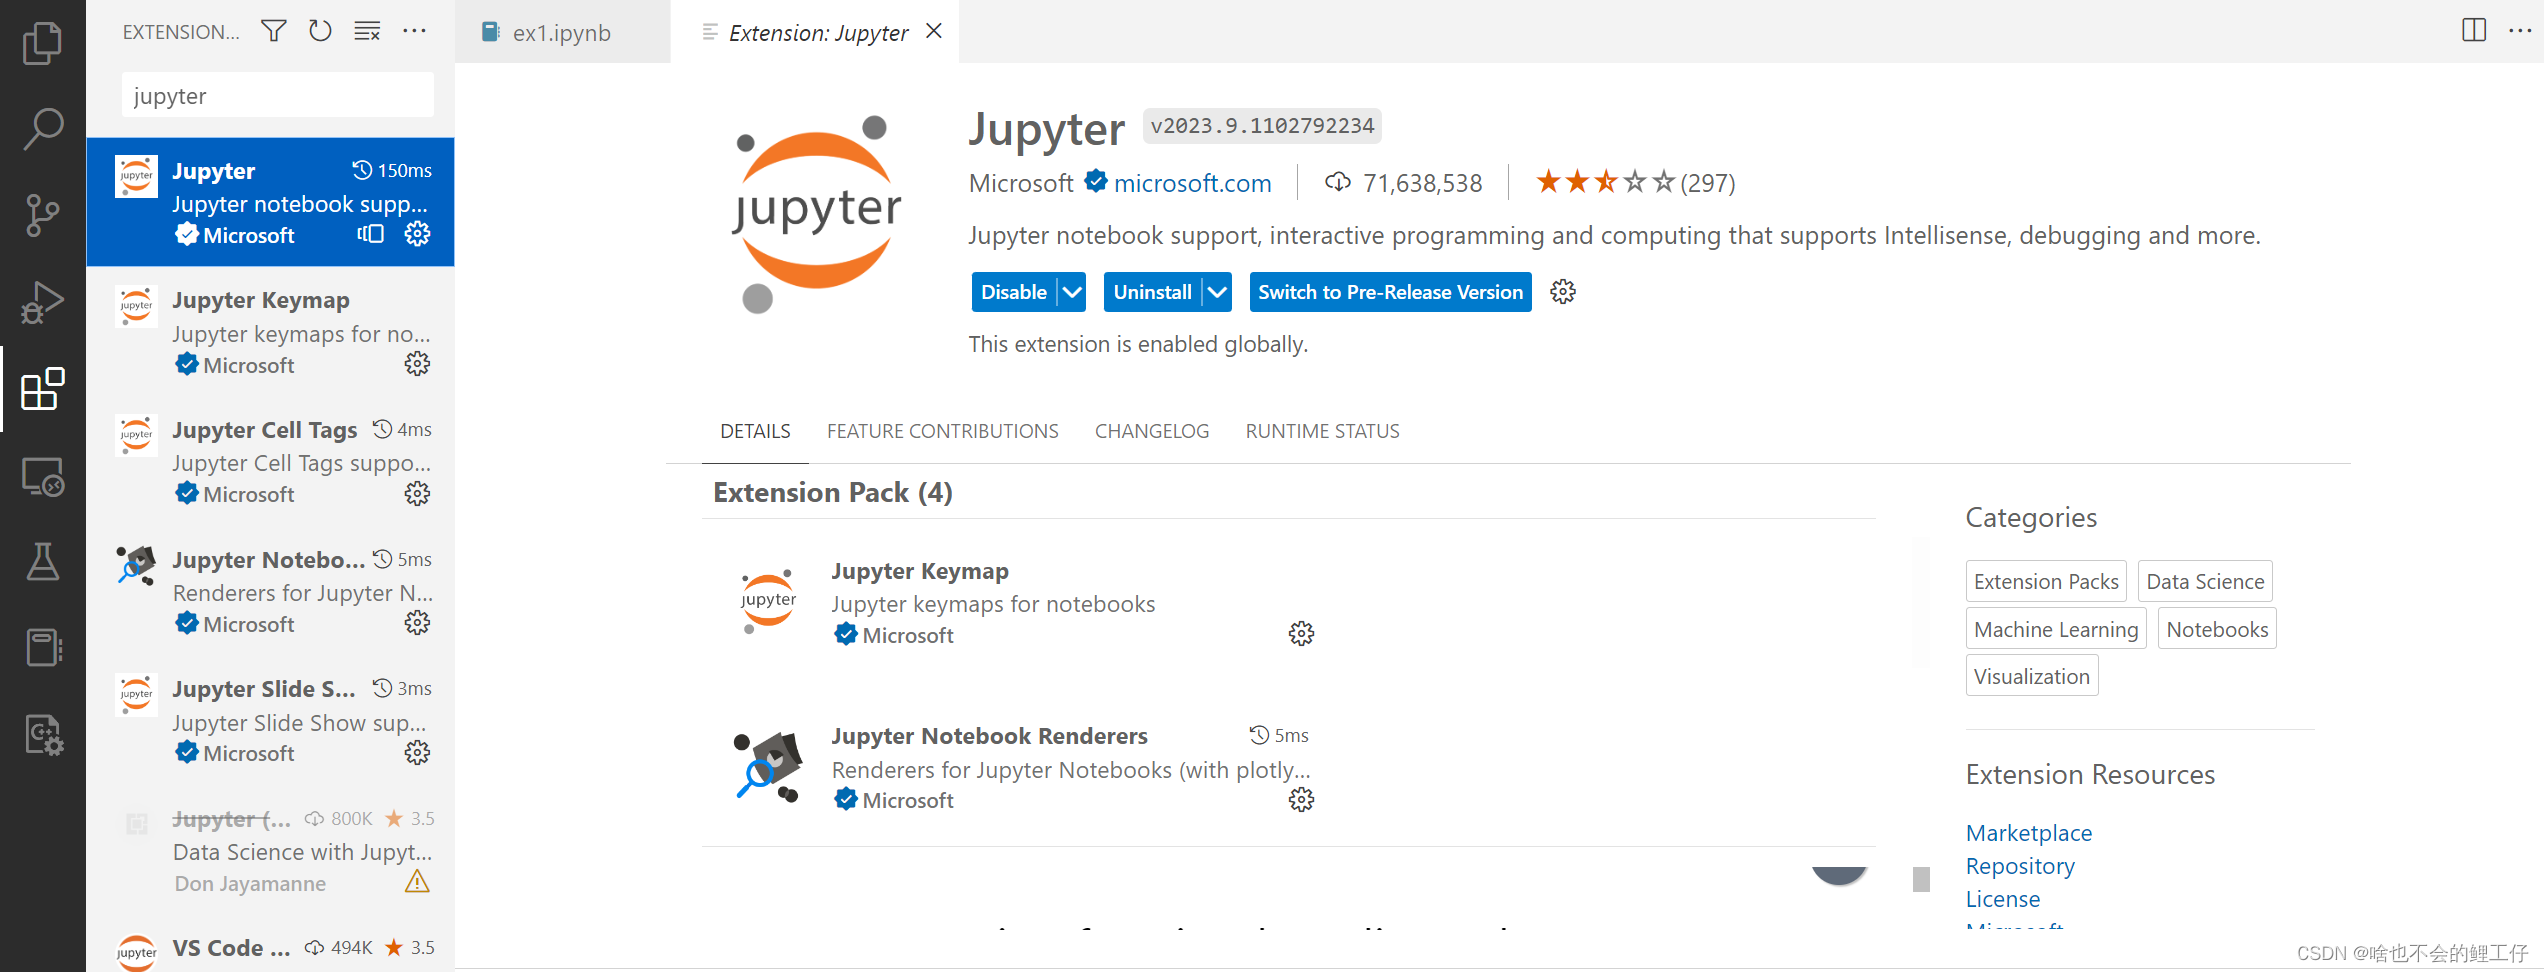
本文将会教读者如何让VSCode连接ipykernel来跑.ipynb文件,以此来取代传统的Jupyter Notebook,毕竟后者总会有一些奇奇怪怪的BUG,比如说内核连接失败等问题
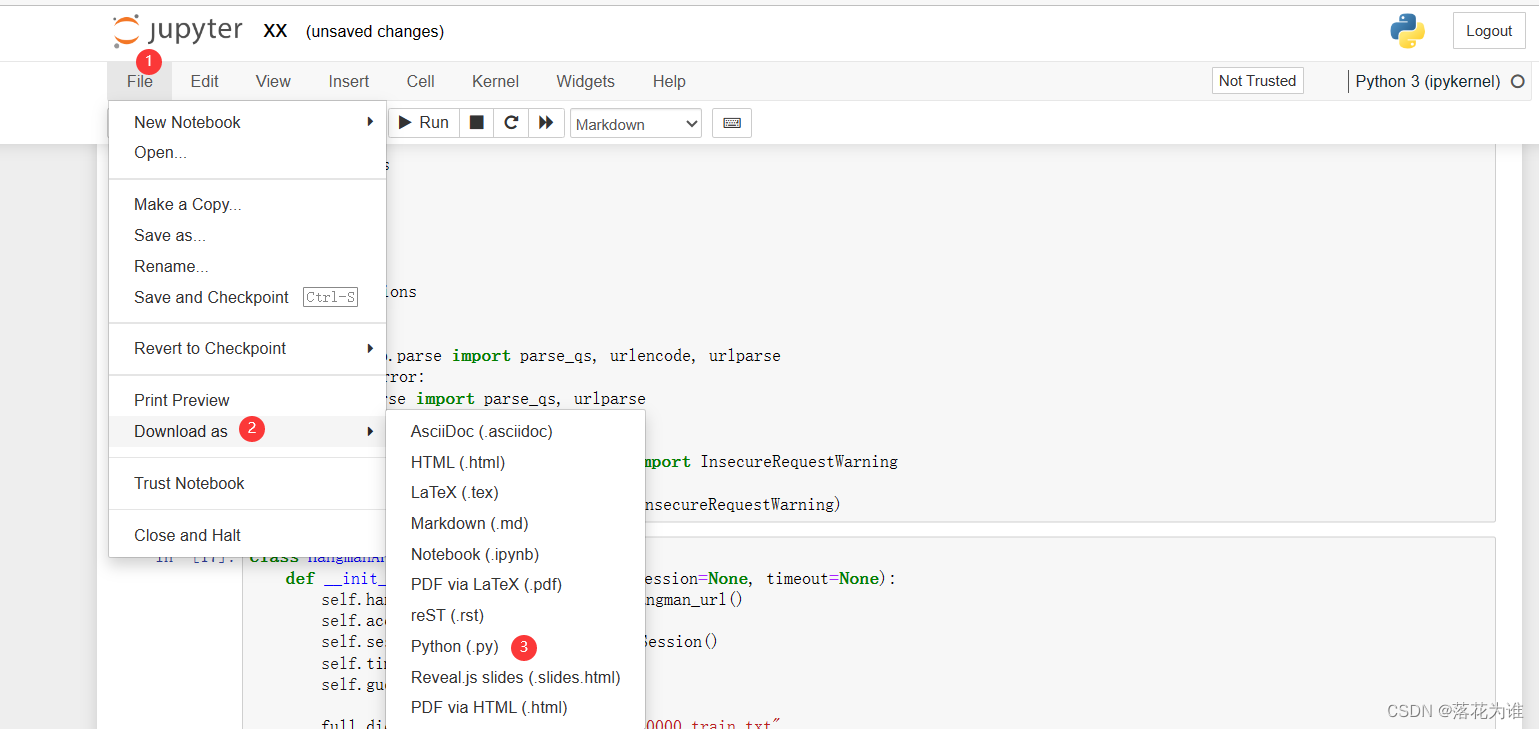
.ipynb文件转.py文件
解决办法一:将http://localhost:8888/tree复制到浏览器打开此种方法每次需要重新输入,或复制链接,略显麻烦,请移步到方法二解决办法二:1、win+r 然后输入cmd,回车打开命令窗口2、在命令窗口中输入jupyter notebook --generate-config回车,有的电脑会提示输入y/N,输入y,回车找到jupyter notebook --generate-co
本文探讨了基于KNN算法的调制识别技术在OSI物理层中的应用。传统自适应调制编码(AMC)依赖信令传输调制方式信息,占用额外资源。为解决这一问题,引入KNN算法实现自动调制识别,通过分析接收信号的高阶累积量特征(如C20、C21、C40等)构建特征向量,训练分类器区分BPSK、QPSK、16QAM等调制方式。仿真实验分为两部分:MATLAB生成含噪声的调制信号样本并提取特征,Python通过KNN
工具不是用来替你思考的,是用来替你干脏活累活的。*)最大的价值,不是帮你"一键生成一篇论文",而是把选题、找文献、搭大纲这些最耗时间、最消磨意志的前期工作,用几分钟帮你搞定。然后你把省下来的精力,花在真正需要你动脑子的地方——分析、论证、创新。这才是用AI写论文的正确姿势。所以,如果你现在正对着空白文档发呆,别硬撑了。👉微信公众号搜一搜:书匠策AI👉试试看,说不定你的论文困局,今天就能破局。?
nbdev:用Jupyter Notebook完成Python全流程开发 fastai团队推出的nbdev工具(GitHub 5.3k星)实现了在Jupyter Notebook中完成完整的Python项目开发。开发者只需在Notebook中编写代码和注释,nbdev就能自动处理文档生成、测试、打包和CI等工程化工作。 核心功能包括: 基于Quarto的自动文档生成 Notebook与.py模块的
Jupyter是一款开源的交互式计算工具,在数据科学领域广受欢迎。它通过浏览器提供一体化编程环境,将代码编写、结果运行、图表展示和文档记录整合在同一个界面中,显著提升了数据分析效率。Jupyter项目家族包括Notebook、Lab、Hub和Book等多个组件,支持从个人开发到团队协作的不同场景。该项目采用Sphinx构建文档,支持实时预览。目前Jupyter已成为Python数据科学生态的基础设
摘要: Jupytext 是一款将 Jupyter Notebook 转换为纯文本格式的工具,支持双向同步和版本控制。它解决了 Notebook 在 Git 中 diff 难读、IDE 支持差、合并冲突复杂等问题,支持 py:percent 和 Markdown 等格式,通过 Paired Notebooks 保留输出结果。用户可在 IDE 中编辑文本文件,并同步到 Jupyter 中运行,反之亦
AiArty Image Matting 2.5是一款基于AI技术的图像抠图软件,专为精确背景去除和高级图像合成设计。它采用先进的Alpha遮罩技术,能够轻松实现前景与背景的精准分离,即使处理复杂边缘和半透明物体也能保持细节完整性。软件内置多个AI模型,包括AlphaStandard V2、AlphaEdge V2、EdgeClear V2和SolidMat V2,这些模型分别擅长处理不同的图像场
Lux是一款Jupyter Notebook智能数据可视化工具,能自动为DataFrame生成可视化图表推荐,帮助用户快速发现数据趋势、相关性和异常值。它通过自动化EDA(探索性数据分析)流程,从Enhance、Filter、Generalize三个方向推荐图表,适合数据科学家、研究人员等日常使用Jupyter进行数据分析的用户。安装简单,只需导入Lux后正常打印DataFrame即可自动显示图表
│ AI大模型应用开发环境 ││ ├── Anaconda/Miniconda(环境管理) ││ ├── Jupyter Notebook(开发工具) ││ └── 必要Python库 │📝 支持代码、文本、图表混合编写▶️ 代码分块(Cell)执行,便于调试📊 直接在浏览器中显示图表和可视化结果💾 保存为.ipynb文件,可分享和复现│ Jupyter Notebook 界面 ││ 📁
数据集:通过网盘分享的文件:obesity_level.csv链接: https://pan.baidu.com/s/1YjcjbXW3UPeWP5x99at6kQ 提取码: vdzc1/0,家人是否有超重肥胖1/0,经常吃高热量零食快餐1–3,越高越常吃蔬菜1-3,每天吃几顿正餐Sometimes/Frequently/Always/01–3,越高喝水越多1/0,是否关注热量0–3,越高运动越多
2.6.0 版本作为 V2 系列重要更新,核心聚焦智能选择工具引入、绘图交互优化与细节体验升级:新增AI 对象选择与主体选择工具,基于本地机器学习模型,自动识别并选中画面主体或指定对象,无需复杂路径绘制,大幅提升图像编辑与合成效率,数据本地处理保障安全;作为 Adobe Illustrator 的强劲替代工具,软件凭借轻量化架构、流畅操作体验与丰富专业功能,解决传统矢量软件卡顿、订阅成本高、跨平台
Jupyter Notebook已成为数据科学和教学领域的核心工具,其核心优势包括交互式探索、多语言支持、可视化友好等特点。文章详细介绍了.ipynb文件结构、环境搭建、基本操作、单元格类型、内核管理等基础内容,并深入探讨了魔法命令、扩展功能、交互控件等高级特性。同时涵盖了数据科学集成、版本控制、性能优化、调试技巧等实用主题,以及与其他工具的集成和部署分享方案。最后展望了Jupyter生态的未来发
《AutoGluon时序预测极速优化指南》摘要:本文针对企业级批量SKU预测场景,提出6大加速策略。通过并行预测(提速3倍)、轻量模型组合(提速2-5倍)、关闭分位数计算、模型预加载等技巧,实现100个SKU预测从20-60秒压缩至3-5秒。特别推荐生产环境采用FastAPI+模型常驻内存方案,配合GPU加速可使深度学习模型提速5-10倍。实测显示最优方案较默认顺序预测提速9倍,为实时API和每日
本文介绍了两种适用于水果销量预测场景的API调用方式:单步预测(未来1天)和多步预测(未来7/14/30天)。核心要点包括:1)使用AutoGluon训练时序预测模型;2)多步预测直接调用predict()获取未来N天结果;3)单步预测取多步结果的第一条数据;4)提供结果导出Excel的通用方法。文章强调训练时设置的pred_length决定最大预测天数,并提醒预测时只能使用历史数据。两种预测方式
本文针对时序预测模型中训练误差(WAPE 8%)与测试误差(WAPE 23%)差距过大的问题,提出系统性解决方案。首先通过15%误差差判定为严重过拟合,并提供4步急救措施:降低模型复杂度、增加正则化、减少噪声特征、数据平滑处理。重点强调协变量泄露的自查方法(滞后特征、滑动窗口、归一化处理)。最后给出企业级优化方案(早停策略、滚动验证、缩短预测长度)和可直接复用的参数配置,将误差差控制在5%以内。核
本文介绍了水果销量预测模型上线前的标准验证流程,旨在确保本地测试结果与真实上线效果一致。核心步骤包括:1)按时间严格切分训练集和测试集;2)仅用训练集训练模型;3)在测试集上预测并计算WAPE误差;4)分析异常SKU。文章强调测试集必须完全隔离,WAPE是唯一可信指标(水果行业10%-15%为合格),并提供代码实现和3条关键原则:时间不交叉、测试集不参与训练、以测试集WAPE为准。最后指出训练集用
OpenFiles 三分钟搞定 Jupyter Notebook:免安装、可编辑、AI 助力 摘要: OpenFiles 是一款桌面端工具,解决了传统打开.ipynb文件的繁琐流程。它自带Python环境,无需安装Anaconda或配置Jupyter,双击即可打开并完整编辑.ipynb文件,支持运行代码、渲染表格/图表/公式。特色功能包括:内置AI助手可理解并修改代码,自动处理报错;完美展示Pan
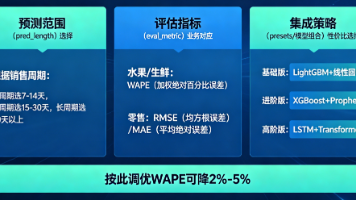
摘要: 本文提供了一套针对水果/生鲜/零售场景的销量预测参数调优方案,核心目标是通过参数优化将WAPE指标降低2%~5%。关键建议包括: 预测范围:日常补货推荐7天预测(prediction_length=7),周采购14天,大促3~7天; 评估指标:业务场景首选WAPE(避免零销量爆炸),禁用MAPE; 模型策略: 快速验证用fast_training,平衡选medium_quality(含TF
《时序预测中的协变量泄露预防指南》摘要: 本文深入剖析了时序预测中最致命的协变量泄露问题,指出90%新手因未来信息渗入训练集导致模型上线失效。核心解决方案包括三种严格的时间切分策略:简单时间切分、滚动时间窗切分和滞后排除切分,强调必须按时间顺序切割数据。文章提出四条黄金预防规则:滑动窗口必须滞后处理、未来协变量严格对齐时间、归一化仅在训练集计算、禁止时序数据打乱顺序。最后给出三种泄露验证方法和Au
本文介绍了水果销量预测中合法合规的4类未来协变量构造方法,包括日历时间、节假日活动、天气预报和店铺计划特征。这些特征完全基于已知或可预测的未来信息,不会泄露实际销量数据。其中节假日效应和天气因素对水果销售影响显著,如夏季西瓜热销、雨天客流下降等。通过合理构建这些协变量(如日期、促销标记、温度等),配合AutoGluon等工具,可提升模型预测精度3%-10%。该方法特别适合水果等季节性商品,既规避数