登录社区云,与社区用户共同成长
邀请您加入社区
做游戏直播、网课录制、会议记录,缺一款好用的免费工具?OBS Studio 30.2.3 绝对是首选!这款免费开源的视频直播录制软件,不管是新手还是老玩家,都能轻松用它搞定屏幕录制、直播推流,而且支持多平台、多格式,功能全还不收费,今天就手把手教你从下载到使用的全套流程。
M3U8是苹果公司开发的流媒体播放列表格式,采用UTF-8编码,支持视频分片传输、多码率自适应和AES-128加密。主要特点包括将视频分割为TS片段、跨平台兼容等。播放方式包括使用专业播放器(如VLC)、浏览器HTML5播放或移动端APP。获取链接可通过开发者工具或抓包软件,但需注意版权风险。高级应用涉及自适应码率选择、加密流播放等,也可用FFmpeg将M3U8转为MP4。使用时应遵守相关法律法规
摘要: 本文介绍了如何通过SRS(Simple Realtime Server)实现海康威视摄像头的视频流转换与分发。SRS是一款支持多种流媒体协议的开源服务器,可将RTMP等协议转换为HTTP-FLV格式供前端播放。文章详细说明了Windows环境下SRS的安装步骤:从GitHub下载安装包、执行安装程序、通过命令行启动服务,最后通过访问localhost:8080验证部署成功。该方案为企业物联
在Windows11 22H2版本以上可以使用该功能打开方式:使用快捷键:ctrl+win+L。
注意版本选择,AMD 以及Intel处理器的,选择TS-NASX86, Arm处理器选择TS-NASARM_64(近几年威联通出售的ARM处理器的都是ARM 64位的,老一些的机型,如果ARM 64位不行,就试一下下面的其他三个版本,总有一个合适的。前面教程介绍了,怎么用家里的智能电视播放存储在NAS上的影音媒体文件,但是影音怎么下载并没有说明,本期教程就给大家介绍一个非常好用的BT 、PT 下载
今天我想与大家分享一些在播放器开发中常用的音视频流地址,涵盖了纯音频、纯视频以及各种常见封装格式,比如rtmp、m3u8、flv等。在网络上,常见的测试地址往往已经失效,为了解决这个问题,我打算在这里创建一个播放列表。如果你有可用的音视频地址,请不吝留言分享给我,不胜感激!
iVMS-4200客户端是一款与网络监控设备配套使用的综合应用软件,可满足用户多方面需求,如设备管理、人员管理、考勤、可视对讲、数据分析、远程设备配置等。客户端可与DVR、NVR、IPC、IPD、DVS、网络存储设备、报警设备、门禁设备、可视对讲设备等配套使用,提供网络服务(预览、回放、云台等操作),提供灵活、多样的部署方案。
OBS 或 Open Broadcaster Software,是一种免费的开源视频录制和视频实时流媒体软件。 占用资源少、配置要求相对较低,录音格式为MP4;它为用户提供了视频、文本、图像等的捕获录制功能,软件操作简单,界面清晰,能够自定义高质量的媒体推送和视频录制。......
在政企协同、远程医疗、金融双录、智慧政务等B端场景中,实时音视频不再是单纯的“通话工具”,而是深度嵌入业务流程的基础数字化底座。很多企业早期采用自研WebRTC或开源框架搭建音视频能力,普遍面临四大痛点:1.研发成本极高:需要投入专职团队处理编码、降噪、抗丢包、弱网优化、终端适配等底层问题;2.稳定性不可控:公网抖动、弱网波动、跨区域传输极易出现卡顿、掉线、音画不同步;3.业务集成困难:无法快速对
从赛场内的机位矩阵到国际广播中心(IBC)的云架构,前沿技术正构筑起全球数十亿观众的沉浸式观赛体验。它让摄像机彻底摆脱了地理与物理的限制,能够紧随球星步伐,驰骋于北美大陆的广袤赛场。在这条看不见的“信号赛道”上,正是聚合技术的稳定性与AI调度的智能化,确保了每一个决定冠军归属的瞬间,都能不差毫厘地抵达全球观众的眼底。,实时评估每条链路的信号质量,并为表现好的链路分配更多数据。这样,即使单个网络波动
摘要:扩散模型在语音、图像生成等领域表现优异,但其训练与推理间的曝光偏差(Exposure Bias)问题长期被忽视。本文系统性梳理了该问题,指出推理时样本信噪比(SNR)与时间步的不匹配导致误差累积,尤其在语音克隆(TTS)中表现为音色偏移、高频细节丢失等问题。文中提出两种解决方案:1)差分校正(DCW),通过小波分频修正推理路径;2)升级为Heun二阶求解器以减少数值误差。实验表明,DCW能显
随着直播行业进入智能化时代,用户对于直播画质与互动体验提出了更高要求。本文围绕直播软件开发与AI美颜SDK展开分析,介绍直播平台核心架构、美颜技术优势以及私域直播发展趋势,并探讨AI数字人、智能互动等未来方向,为企业搭建高品质直播平台提供参考。
本文对比分析了三种本地可部署的语音合成模型(F5-TTS、Supertonic TTS、VoxFlash-TTS)的架构设计差异,重点探讨了它们在序列表示、文本对齐、推理速度和适用场景上的权衡。 F5-TTS:采用简洁的Flow Matching架构,隐式学习文本-语音对齐,音质高但需要GPU支持,适合多语言高质量场景。 Supertonic TTS:轻量化设计,支持跨平台CPU推理,速度快但音质
本文是语音合成技术系列第五篇,针对本地部署语音克隆需求,横向对比6种主流开源方案(FishSpeech、CosyVoice2、GPT-SoVITS、Bert-VITS2、KokoroTTS、VoxFlash-TTS)。从音质、推理速度、部署难度、克隆能力等维度进行评测,给出差异化选型建议:音质优先推荐FishSpeech/CosyVoice2;实时场景选择VoxFlash-TTS;少样本克隆首选G
本文深入分析了语音合成(TTS)系统推理速度慢的根本原因。主要瓶颈在于声学模型的计算复杂度,特别是自回归模型的顺序依赖性和扩散模型的多步迭代特性。文章指出,音频序列长度导致的Transformer计算复杂度O(n²)增长是核心问题,并提出当前优化方向包括:加速采样算法、知识蒸馏、量化优化,以及最具潜力的压缩音频潜空间方案。最后强调在推理速度与音质之间需要权衡,并介绍了衡量推理速度的实时因子(RTF
本文介绍了VoxFlash-TTS本地部署方案,针对实时语音合成中的延迟问题提出创新解决方案。该系统通过将潜空间帧率压缩至9fps,显著降低计算量,在消费级GPU上实现毫秒级推理。文章详细解析了系统架构,包括音素编码器、扩散模型等核心模块,并提供了完整的Docker部署流程。该方案特别适合对延迟敏感的实时交互场景,支持中英文双语合成和零样本语音克隆,同时保持较低硬件要求。尽管在音质上有所取舍,但其
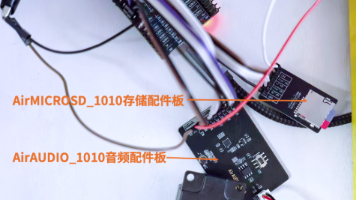
嵌入式开发中,HMI、工业控制等项目常需适配LCD屏,屏体规格、接口、排线选择不当易踩坑。结合Air1601实操经验,梳理屏体规格、RGB888/RGB565差异、排线定义及配套资源,均为项目实测干货,助力高效适配。
摘要:语音社交市场持续升温,预计2025年规模突破5000亿。语聊直播凭借低门槛、情感化互动等优势成为社交新宠,衍生出多人语聊房、语音陪聊等多样化形态。技术层面采用WebRTC+SFU架构实现低延迟传输,通过AI降噪、弱网优化等关键技术提升用户体验。系统设计需兼顾麦位管理、礼物互动和内容安全等核心功能,同时建立完善的运维监控体系。随着AI技术的融入,语聊直播正展现出更大的发展潜力,掌握相关技术栈将
摘要:ComakePiD2开发板通过对接火山引擎RTC服务,实现了嵌入式设备与大语言模型的云端协同。该系统采用端侧采集+云端计算的架构,支持实时音视频交互和情感化AI对话("问问"机器人)。技术方案包含视频流H264编码、音频Opus编码处理,并通过火山引擎提供ASR、TTS和大模型服务。
摘要:针对AI小智设备无法识别声源方向的痛点,提出采用AR1106声源定位模组的外接扩展方案。该方案通过独立双麦克风阵列和TDOA算法实现±10°精确定位,不占用主机算力,即插即用。AR1106独立完成指令触发、方向识别和舵机转向全流程,支持5米内180°范围定位,响应速度达毫秒级。方案保持AI小智原有功能不变,仅通过标准接口实现"指令识别+方向定位"协同,有效解决多人场景下的
A-59F是一款高集成语音处理模组,集AIENC降噪、AEC回音消除、防啸叫和BF波束拾音四大功能于一体。支持多种音频接口,体积小巧易嵌入,能有效解决噪音、回音等问题。核心性能包括45-90dB降噪深度、100dB回音消除和15ms低延迟防啸叫,适用于对讲门禁、车载通讯、会议教育等多种场景。该模组提供10种连接模式,支持单/双波束定向拾音,可大幅简化音频电路设计,是性价比高的一站式语音处理解决方案
开源项目dograh推出企业级实时语音智能体平台,通过深度优化WebRTC音视频传输和流式VAD算法,将端到端响应延迟控制在100ms内,解决了语音卡顿、延迟和打断失控三大行业痛点。其全双工架构支持流式ASR文本与大模型实时交互,并内置智能打断机制和多模态监控看板。开发者可通过简单配置快速部署AI呼叫中心等应用,使语音交互达到"同声传译"般的流畅体验。该项目为构建智能客服、虚拟
消费电子领域常将"多麦克风"作为高端产品的卖点,但实际拾音效果并非单纯由麦克风数量决定。真正影响性能的关键在于麦克风布局、阵列结构、声学设计和AI算法处理能力。随着AIENC技术的成熟,算法能力已超越硬件堆叠的重要性。多麦克风系统的核心价值在于获取空间信息,通过分析声音到达不同麦克风的时间差、相位差等实现声源定位和降噪。值得注意的是,盲目增加麦克风可能导致音质下降,出现梳状滤波
││信令服务││媒体服务││AI服务││。││(频道管理) ││(SFU转发)││(人脸/安全) ││。│警务融合平台│。
《波束拾音技术:智能语音设备的革命性突破》 传统全向拾音技术存在环境噪声干扰、混响严重等问题,而波束拾音技术通过空间方向性处理实现了质的飞跃。该技术利用多麦克风的时空差计算声源方向,像聚光灯般聚焦目标声源,显著提升信噪比和语音清晰度。A-59F模组提供单/双波束两种模式:单波束增强特定方向人声,双波束可同时处理两个独立声源区域,使设备具备空间语音关系理解能力。这项技术对产品结构设计提出更高要求,需
本文介绍了Index-TTS语音克隆系统的特点和使用方法。Index-TTS是一款基于XTTS和Tortoise等技术的工业级零样本文本转语音系统,只需15秒音频即可克隆音色,支持中英文语音合成。文章详细说明了硬件要求(推荐NVIDIA显卡、6GB以上显存)、整合包下载方式(需使用7-Zip解压)以及启动步骤。该系统可实现高质量语音克隆,适用于视频配音、有声读物等场景,虽然克隆效果接近真人但仍存在
《A-59F声学系统:解决扩音啸叫与通话回音的双重难题》 摘要: 现代语音设备面临的核心声学问题主要分为两类:扩音系统的声学正反馈啸叫和全双工通话中的回音循环失稳。A-59F创新性地通过数字信号处理技术同时解决这两大难题。其采用低延迟数字反馈抑制架构(15ms处理延迟),结合AI环境降噪算法,实现动态增益调节和自适应频率抑制。针对通话回音问题,系统集成高性能AEC全双工回音消除算法(100dB消除
A-59F多功能语音处理模组是一款高度集成的嵌入式解决方案,针对现代语音交互系统中的多重声学挑战。该模组整合了AI环境降噪(AIENC)、声学回声消除(AEC)、波束成形(Beamforming)和低延迟防啸叫算法,可有效处理45-90dB的环境噪声、100dB的回声消除,并支持15ms低延迟扩音。其双数字麦克风设计可实现定向拾音,显著提升目标语音质量。紧凑的SMT模组设计便于集成,适用于对讲、会
││(MCU)││(SFU)││ (存储/归档)││(CDN分发)│ │。││AI服务││ 认证服务││ 审计服务││。││ 会议服务│ │ 直播服务│ │ 录制服务│ │ AI服务││。││ 信令服务││ 媒体服务││ 录制服务││ 直播服务 │ │。金融行业的特殊性决定了其视频会议系统必须是"安全优先、业务导向、技术可控"的综合解决方案。
WebRTC 最有价值的并非 PeerConnection,而是其背后精心调优的 MediaEngine。本文详解如何绕过 PeerConnection 的 SDP 协商模型,直接使用 ChannelManager 和 MediaEngine 构建自定义音视频通道。从创建 MediaEngine、理解 ChannelManager 职责、自定义 BaseChannel 实现 MediaChanne
本文介绍了一种基于WebRTC底层能力构建轻量级SFU视频会议系统的创新方法。通过摒弃标准PeerConnection+SDP协商模式,保留WebRTC核心的MediaEngine(包含编解码器、音视频处理等关键功能),同时采用KCP over UDP替代ICE/DTLS/SRTP传输方案,显著降低了系统复杂度和延迟。系统采用Publish/Subscribe模型替代SDP协商,实现了按需推拉流控
风光储、风光储并网直流微电网simulink仿真模型。系统由光伏发电系统、风力发电系统、混合储能系统(可单独储能系统)、逆变器VSR+大电网构成。光伏系统采用扰动观察法实现mppt控制,经过boost电路并入母线;风机采用最佳叶尖速比实现mppt控制,风力发电系统中pmsg采用零d轴控制实现功率输出,通过三相电压型pwm变换器整流并入母线;
鹤梦云老人看护AI解决方案以视觉物联平台为底座,在室内、户外、卫生间、夜间、睡眠等全场景下,对老人的体征状态、行为轨迹、环境异常、安防事件进行多模态实时采集与分析,形成覆盖生命体征、活动规律、行为趋势、呼叫告警的多维度数据闭环。鹤梦云提供“硬件 + 软件 + AI算法”完整的一体化品牌解决方案,从多模态感知硬件选型,到多端SDK的品牌App快速搭建,再到AI算法模块的按需集成,短期内即可迅速完成自
YYAI变声工具深度体验报告:这款工具凭借AI智能适配技术,成功解决了传统变声机械感强的问题,通过实时捕捉语气细节实现自然流畅的变声效果。其核心优势体现在高清降噪算法、数百款预设声线和轻量化设计三大方面,完美适配游戏开黑、直播互动等多元场景。特别值得注意的是新增的游戏整活音效包功能,内置海量趣味音效,让开黑氛围更活跃。
WebRTC (Web Real-Time Communication) 是一个开源项目,它为浏览器和移动应用程序提供实时通信(RTC)能力,通过简单的 API 即可实现音频、视频和数据在浏览器之间的点对点(P2P)传输。WebRTC 由 Google 于 2011 年发起,现已成为 W3C 和 IETF 的标准,被所有主流浏览器支持,包括 Chrome、Firefox、Safari 和 Edge
针对近期大家高频咨询的通话录音相关问题,本文将分享一套基于合宙LuatOS开发的实操性通话录音方案,供开发者参考使用。关于方案适用场景及相关配套方案,说明如下,方便开发者匹配自身需求:- AirUI可视化方案目前仍处于优化阶段,其具备轻量化、低成本、高可靠的特性,可应用于工业场景,后续将持续迭代。- 若无需依赖可视化UI,且需快速实现通话录音功能,可参考本文分享的方案,该方案支持自动接听与自动录音
FM1505 IM505 富迪芯片(AI单麦降噪,消回音芯片,防啸叫,防风噪--头盔蓝牙耳机)
微软Azure语音服务提供文字转语音和语音转文字两大AI功能,支持400+种神经语音和140+种语言,具备高精度识别和深度定制能力。相比轻量级工具如顶伯,Azure更侧重企业级应用,提供API集成、高并发处理和严格的安全合规。典型应用包括智能助手、会议转录等,采用按量付费模式,适合需要深度集成和高性能的商业场景。
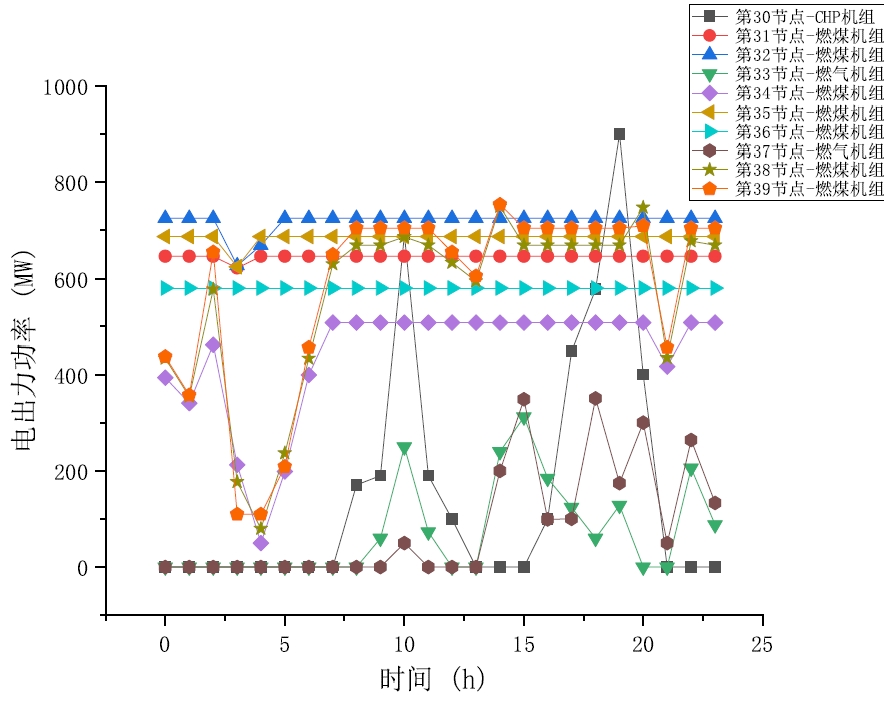
本文档所述代码基于MATLAB平台开发,构建了一套冷热电联供(Combined Cooling, Heat and Power, CCHP)综合能源系统优化模型。该模型以实现多能源网络协同优化运行为核心目标,整合电力系统、天然气系统与热力系统三大能源网络,通过数学建模与智能求解,在满足各能源网络安全约束、供需平衡约束的前提下,实现系统运行成本最小化。
进退法是一种用于搜索函数极小值的方法。在PMSM效率优化场景下,我们可以把效率看成是一个关于某些控制参数(比如电流、电压等)的函数,通过进退法来找到使这个效率函数达到最小值的参数点。
针对农田、果园、种植基地的野生动物侵害与人为盗窃问题,AI画面分析实时识别入侵事件的物种类型、数量与行为特征,触发定向告警并自动存档影像记录,为保险理赔与法律取证提供标准化证据链。在牧场、养殖场等场景,实时监测牲畜动态与围栏区域的异常活动,AI识别牲畜异常聚集、倒伏、脱栏等行为,结合夜视与红外感知能力实现全天候预警,有效预防疾病扩散与牲畜丢失。猎人可以在地图上按物种筛选:选择"白尾鹿",地图立即屏
本文探讨了实时语音交互技术的发展,对比分析了WebSocket和WebRTC两种方案在语音传输中的优劣。WebSocket适合文本传输但存在延迟问题,而基于UDP的WebRTC能实现更低延迟的全双工通话。文章重点介绍了语音活动检测(VAD)技术和豆包采用的端到端模型创新,这种模型直接理解语音信号而非依赖文字转译,使交互更自然流畅。最后指出随着5G和端到端模型的发展,语音交互将实现更接近真人对话的体
开源录屏神器OpenScreen解决四大痛点 你是否为专业录屏软件的高价、水印和复杂功能困扰?GitHub爆火的开源工具OpenScreen提供了完美解决方案。它完全免费、无水印、支持商业用途,且操作简单。 核心优势: 零成本:完全开源免费,无需订阅 纯净输出:彻底消除水印困扰 简单易用:30秒即可上手 商用友好:允许商业用途 主要功能: 简洁录制界面 内置视频剪辑器 丰富标注工具 一键导出GIF
本文将从产品定位、平台支持、音视频核心能力、场景化能力与增值服务、接入与开发体验、场景推荐、价格模型等维度,对主流 RTC SDK 进行横向对比,帮你在选型阶段做出更有依据的决策。