RT-DETR v1 详解:论文 + 源码结合详细讲解
目录
2)AIFI:只在最高层做 self-attention 的轻量 Encoder
3)CCFF:FPN + PAN + RepBlock 的多尺度卷积融合
4)不确定性最小的 Query 选择(Query Selection)
4.1 Flatten + concat → encoder tokens E
5)Transformer Decoder(并行解码方式)+ DN Queries
5.1 DN queries:给 decoder 一些“带噪 GT”的练习题(训练专有)
1)可变形注意力:Query 不再“看全图”,只看 12 个关键点
3)跨层坐标 detach:不给 Decoder 的后层“背锅”
6.1 训练阶段:DN loss + Detection loss(匈牙利匹配)
6.1.2 检测部分:匈牙利匹配 + VFL / bbox loss
6.2 推理阶段:只保留检测 queries,取最后一层输出,无 NMS
最近在啃 RT-DETR v1,一边对着论文,一边翻官方仓库的 PyTorch 实现,发现网上的很多介绍要么只停留在架构,要么只讲训练命令,真正把“每一层在干什么、张量长什么样、为什么这么设计”说清楚的资料不多。所以写了这篇学习笔记:
- 一边看论文,一边对照 lyuwenyu/RT-DETR 的代码;
- 把 RT-DETR 相对于原始 DETR 的关键改动梳理出来(为什么要改、改了什么);
- 按模块把整个前向流程拆开讲(Backbone → AIFI → CCFF → Query 选择 → DN → Decoder → Head);
- 中间尽量用 简单的示意代码和 shape来说明,而不是直接贴工程源码。
下面我把在学习RT-DETR v1过程中的的整体思想 + 算法流程 + 各模块细节记录下来分享给大家
假设默认输入是:
2 × 3 × 640 × 640(batch=2,RGB,640×640)
0. 从 DETR 到 RT-DETR:要解决什么问题?
传统 DETR(2020, Meta):
-
CNN backbone 提特征 →
-
Transformer Encoder 全局建模 →
-
Transformer Decoder + object queries →
-
Hungarian 一对一匹配,端到端训练,无 NMS。
但它有几个缺点:
-
训练巨慢:随机 learnable 的 queries + 复杂匹配 → 需要 300–500 epochs 才有好效果。
-
单尺度特征:只用 stride=32 的最后一层 feature,对于小目标检测比较困难。
-
Encoder 和 Decoder 很重:全局 self-attention + dense cross-attention,推理 FPS 不高,很难做到实时检测。
RT-DETR 的目标就是:
保留 DETR 的端到端优点,把精度拉满的同时做成真正的实时检测器。
它主要做了几件事:
-
Encoder 换成 AIFI + CCFF:只在最高层做 self-attention,然后用 FPN+PAN 式 CNN 做多尺度融合 → 轻 + 强;
-
Query 不再随机,而是 从 Encoder 输出里选置信度最高的 token → 收敛快;
-
加入 DN(DeNoising)queries:对 GT 加噪声,显式教 Decoder “纠错”;
-
Decoder 使用 多尺度 Deformable Attention + 每层自己的 head,结构上更适合实时与部署;
-
Loss 引入 IoU-aware / VFL 等技巧,让 score 更靠谱,无需 NMS。
原论文模型框架图如下:

整体流程可以画成这样,后面会按模块详细讲解:
Image (2,3,640,640)
  ↓
Backbone: ResNet-vd
  ↓            ┌───────── AIFI (self-attn on S5)
S3,S4,S5  →  P3,P4,P5'   ─────┐
  ↓                            │
  └───────── CCFF (FPN + PAN) ─┘  →  N3,N4,N5 (多尺度特征)
                                    ↓ flatten + concat
                                   E: encoder tokens (2,L,256)
                                    ↓
             ┌─ DN queries (GT+噪声 → Q_dn)
Query Select ├─ Top-K encoder tokens → Q_det
             └─ 拼接:Q_all = [Q_dn, Q_det] (2,N_all,256)
                                    ↓
         Transformer Decoder (多层 deformable attn + head)
                                    ↓
              分类 logits + boxes + IoU,经过匈牙利匹配训练
                                    ↓
                        推理时取最后一层检测部分 → 结果
1)Backbone:多尺度特征提取
我们用一个简化版 ResNet-50(包括后面的代码演示都不是源码,只是示意,但是体现的理论都是严谨和准确的,源码更复杂):
import torch
import torch.nn as nn
from torchvision.models import resnet50

class ResNetVDBackbone(nn.Module):
    def __init__(self):
        super().__init__()
        m = resnet50(weights=None)  # 只是演示
        self.stem = nn.Sequential(
            m.conv1, m.bn1, m.relu, m.maxpool
        )
        self.layer1 = m.layer1  # S2
        self.layer2 = m.layer2  # S3
        self.layer3 = m.layer3  # S4
        self.layer4 = m.layer4  # S5

    def forward(self, x):
        x = self.stem(x)
        s2 = self.layer1(x)
        s3 = self.layer2(s2)  # stride 8
        s4 = self.layer3(s3)  # stride 16
        s5 = self.layer4(s4)  # stride 32
        return s3, s4, s5      # 对应论文 S3,S4,S5
假设输入:
x: [B,3,640,640] = [2,3,640,640]
输出大致为:
| 名称 | 形状(batch=2) | stride |
|---|---|---|
| S3 | [2, 512, 80, 80] | 8 |
| S4 | [2,1024, 40,40] | 16 |
| S5 | [2,2048, 20,20] | 32 |
相对 DETR 的不同点:
-
DETR 只用 S5(最后一层),RT-DETR 会把 S3/S4/S5 都利用起来,为多尺度 encoder 做准备。
2)AIFI:只在最高层做 self-attention 的轻量 Encoder
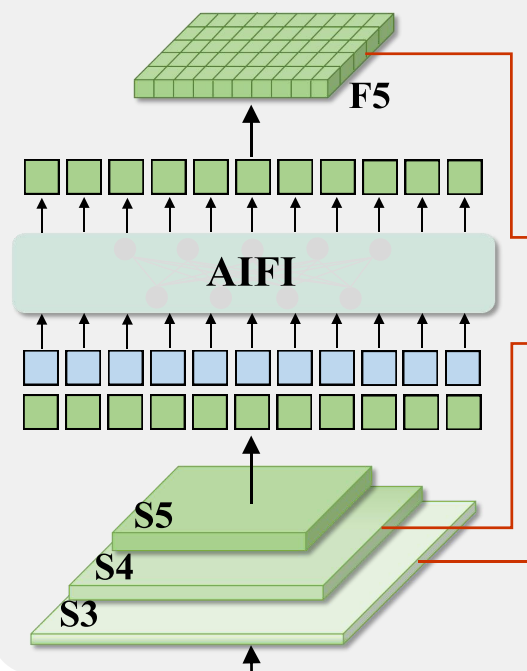
Backbone 输出后,RT-DETR 先把三个特征都压到统一通道(比如 256),然后只对最高层做 Transformer Encoder,这一块就是 AIFI(Attention-based Intra-scale Feature Interaction)。
简单 demo:
class AIFI(nn.Module):
    def __init__(self, in_dim=2048, hidden_dim=256, num_heads=8, num_layers=1):
        super().__init__()
        self.proj = nn.Conv2d(in_dim, hidden_dim, 1)
        encoder_layer = nn.TransformerEncoderLayer(
            d_model=hidden_dim, nhead=num_heads,
            dim_feedforward=hidden_dim*4, batch_first=True
        )
        self.encoder = nn.TransformerEncoder(encoder_layer, num_layers)

    def forward(self, s5):  # [B,2048,20,20]
        x = self.proj(s5)   # [B,256,20,20]
        B,C,H,W = x.shape
        x_flat = x.flatten(2).transpose(1,2)        # [B,400,256]
        x_flat = self.encoder(x_flat)               # [B,400,256]
        x = x_flat.transpose(1,2).reshape(B,C,H,W)  # [B,256,20,20]
        return x  # F5
B为2时,输入和输出:
输入 S5:  [2,2048,20,20]
reshape: F5 = [2,256,20,20]
为什么只在 S5 做 self-attention?
-
S5 分辨率小(20×20),算力友好;
-
语义强,全局关系在这层建模最有意义;
-
如果在 S3、S4 也做,多尺度 Transformer encoder 会非常重(类似 Deformable DETR 的 full encoder),不利于实时。
AIFI = 在最高语义层做一次「全局关系建模」,给后面的 CNN 融合一个全局“视角”。
3)CCFF:FPN + PAN + RepBlock 的多尺度卷积融合
有了:
-
S3 [2,512,80,80] -
S4 [2,1024,40,40] -
F5 [2,256,20,20](AIFI 输出)
先把 S3/S4 投影到 256 通道,记为:
-
P3 [2,256,80,80] -
P4 [2,256,40,40] -
P5' = F5 [2,256,20,20]
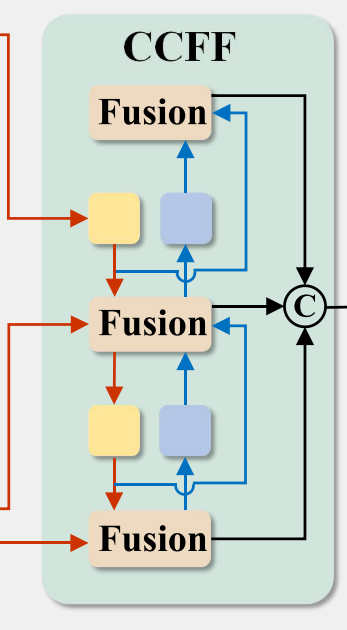
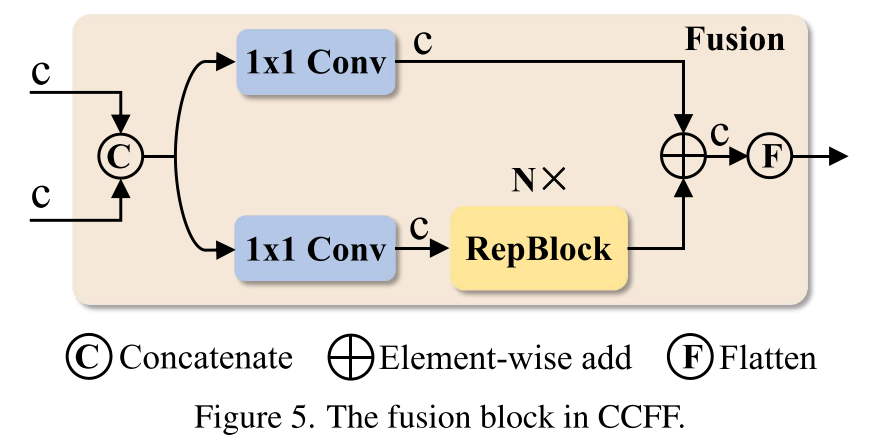
CCFF 用 Top-Down FPN + Bottom-Up PAN 结构 + CSPRepLayer(里面用 RepVGG block,可重参数化)。
-
Top-Down:先 F5→S4 得到 F4,再 F4→S3 得到 F3
-
Bottom-Up:F3 下采样和 F4 融合 → N4;N4 再下采样和 F5 融合 → N5
-
输出:
N3, N4, N5(N3 就是 F3)
简单代码:
class CCFF(nn.Module):
    """
    输入:  backbone 多尺度 + AIFI 输出
      s3: [B,512,H/8, W/8 ]  (S3)
      s4: [B,1024,H/16,W/16] (S4)
      f5: [B,256,H/32,W/32]  (F5 = AIFI(S5))

    输出:
      n3: [B,256,H/8, W/8 ]  # 最终最高分辨率特征
      n4: [B,256,H/16,W/16]
      n5: [B,256,H/32,W/32]
    """
    def __init__(self, c=256):
        super().__init__()
        # 先统一通道到 c
        self.proj3 = nn.Conv2d(512,  c, 1)   # S3 -> C
        self.proj4 = nn.Conv2d(1024, c, 1)   # S4 -> C
        self.proj5 = nn.Conv2d(256,  c, 1)   # F5 -> C

        # Top-Down 融合用的 block
        self.fuse_top_45 = FusionBlock(c)    # P4 ← P5'
        self.fuse_top_34 = FusionBlock(c)    # P3 ← F4

        # Bottom-Up 融合用的 block
        self.down_3      = ConvBNAct(c, c, k=3, s=2)  # F3 下采样
        self.fuse_bot_34 = FusionBlock(c)             # N4 ← (down F3, F4)

        self.down_4      = ConvBNAct(c, c, k=3, s=2)  # N4 下采样
        self.fuse_bot_45 = FusionBlock(c)             # N5 ← (down N4, F5)

    def forward(self, s3, s4, f5):
        # ① 通道统一
        p3 = self.proj3(s3)   # [B,c,H/8, W/8 ]
        p4 = self.proj4(s4)   # [B,c,H/16,W/16]
        p5 = self.proj5(f5)   # [B,c,H/32,W/32]

        # ============ Top-Down FPN ============
        # Step1: P5' → P4 (得到 F4)
        p5_up = F.interpolate(p5, size=p4.shape[-2:], mode='nearest')
        f4 = self.fuse_top_45(p4, p5_up)      # [B,c,H/16,W/16]

        # Step2: F4 → P3 (得到 F3)
        f4_up = F.interpolate(f4, size=p3.shape[-2:], mode='nearest')
        f3 = self.fuse_top_34(p3, f4_up)      # [B,c,H/8,W/8]

        # ============ Bottom-Up PAN ============
        # Step3: F3 下采样 + F4 融合,得到 N4
        f3_down = self.down_3(f3)             # [B,c,H/16,W/16]
        n4 = self.fuse_bot_34(f4, f3_down)    # [B,c,H/16,W/16]

        # Step4: N4 下采样 + P5' 融合,得到 N5
        n4_down = self.down_4(n4)             # [B,c,H/32,W/32]
        n5 = self.fuse_bot_45(p5, n4_down)    # [B,c,H/32,W/32]

        # N3 直接用 F3
        n3 = f3

        return n3, n4, n5
3.1 Top-Down:高层语义向下传
用 ASCII 图表示:
Top-Down路径:
  P5' ──► 1x1Conv ──► Upsample×2 ──┐
  P4  ──► 1x1Conv ──────────────────┴─► Concat ─► CSPRepLayer ─► F4 [2,256,H/16,W/16]

  F4  ──► 1x1Conv ──► Upsample×2 ──┐
  P3  ──► 1x1Conv ──────────────────┴─► Concat ─► CSPRepLayer ─► F3 [2,256,H/8,W/8]
形状变化(H=W=640):
-
Step1:P5' → F4
P5': [2,256,20,20] 1x1Conv: [2,256,20,20] Upsample×2: [2,256,40,40] concat P4: [2,512,40,40] CSPRep: F4 = [2,256,40,40] -
Step2:F4 → F3
F4:         [2,256,40,40]
1x1Conv:    [2,256,40,40]
Upsample×2: [2,256,80,80]
concat P3:  [2,512,80,80]
CSPRep:     F3 = [2,256,80,80]
3.2 Bottom-Up:细节向上送
Bottom-Up路径:
  F3 ──► 3×3Conv stride=2 ──┐
  F4 ───────────────────────┴─► Concat ─► CSPRepLayer ─► N4 [2,256,H/16,W/16]

  N4 ──► 3×3Conv stride=2 ──┐
  P5' ──────────────────────┴─► Concat ─► CSPRepLayer ─► N5 [2,256,H/32,W/32]
形状:
-
Step3:F3 → N4
F3: [2,256,80,80] 3×3 s=2: [2,256,40,40] concat F4: [2,512,40,40] CSPRep: N4 = [2,256,40,40] -
Step4:N4 → N5
N4:                [2,256,40,40]
3×3 s=2:           [2,256,20,20]
concat P5':        [2,512,20,20]
CSPRep:            N5 = [2,256,20,20]
CCFF 得到三层多尺度特征:
N3 = F3: [2,256,80,80]
N4:      [2,256,40,40]
N5:      [2,256,20,20]
相对 DETR 的改进:
-
DETR:没这个 FPN+PAN,只有单个 S5;
-
RT-DETR:用 CNN 做跨尺度融合(而不是 transformer encoder 做多尺度 attention),算力小很多,但依旧保留小目标细节和高层语义。
直观理解:AIFI 用「Transformer 望远镜」在 P5 上看清全局关系;
CCFF 用「FPN+PAN 电梯」把这个高层语义分发到各个分辨率。
4)不确定性最小的 Query 选择(Query Selection)
有了 CCFF 的多尺度输出:
-
N3
[2,256,80,80] -
N4
[2,256,40,40] -
N5
[2,256,20,20]
接下来要做两件事:
-
把多尺度特征 flatten + concat,得到 encoder tokens;
-
在每个 token 上预测 cls+box,选出最有把握的一部分 token,当作 Decoder 的 object queries(Q_det)。
4.1 Flatten + concat → encoder tokens E
def flatten_multi_scale(feats):  # feats = [N3,N4,N5]
    B = feats[0].size(0)
    outs = []
    spatial_shapes = []
    for f in feats:
        B,C,H,W = f.shape
        outs.append(f.flatten(2).transpose(1,2))  # [B, H*W, C]
        spatial_shapes.append((H,W))
    E = torch.cat(outs, dim=1)  # [B, L, C]
    return E, spatial_shapes
数据维度变换如下:
N3: 80×80 = 6400
N4: 40×40 = 1600
N5: 20×20 = 400
L = 6400 + 1600 + 400 = 8400

E: [2, 8400, 256]
4.2 在每个 token 上做一遍“初筛”
简化版代码:
class QuerySelector(nn.Module):
    """
    不确定性最小的 Query 选择(教学版)

    功能:
      - 在 encoder 输出的 token 上做一次轻量检测头:
          * 分类 cls_head:   [B, L, C] -> [B, L, num_classes]
          * IoU 预测 iou_head:[B, L, C] -> [B, L, 1]
          * box_head(可选):   [B, L, C] -> [B, L, 4]  (cx,cy,w,h)
      - 用 conf = max_class_prob * iou_prob 做“确定性”指标
      - 对每张图片取 conf Top-K 的位置,作为 decoder 的 detection queries

    输入:
      enc_seq: [B, L, C]  encoder 多尺度 flatten 后的序列特征

    输出(dict):
      Q_det:            [B, K, C]   选出来的 queries 向量
      ref_points_unact: [B, K, 4]   对应参考框 (cx,cy,w,h) 的未归一化 logits(给 decoder refine 用)
      scores:           [B, K]      选中 token 的置信度(越大越确定)
      labels:           [B, K]      选中 token 的“当前预测类别”(argmax)
    """
    def __init__(self, c=256, num_queries=300, num_classes=80):
        super().__init__()
        self.num_queries = num_queries
        self.num_classes = num_classes

        # 分类头:预测每个 token 属于各个类别的 logit
        self.cls_head = nn.Linear(c, num_classes)  # [B,L,C] -> [B,L,K]
        # IoU 头:预测每个 token 对应框的“质量/置信度”
        self.iou_head = nn.Linear(c, 1)            # [B,L,C] -> [B,L,1]
        # 位置头:预测参考框 (cx,cy,w,h) 的 logits(还没过 sigmoid)
        self.box_head = nn.Linear(c, 4)            # [B,L,C] -> [B,L,4]

    def forward(self, enc_seq):
        """
        enc_seq: [B, L, C]
        """
        B, L, C = enc_seq.shape

        # 1. 对每个 token 做一次小检测头:分类 + IoU + box
        cls_logits = self.cls_head(enc_seq)     # [B, L, K]
        iou_logits = self.iou_head(enc_seq)     # [B, L, 1]
        box_unact  = self.box_head(enc_seq)     # [B, L, 4]

        # 2. 变成概率:sigmoid 后在 (0,1)
        cls_prob = cls_logits.sigmoid()         # [B, L, K]
        iou_prob = iou_logits.sigmoid().squeeze(-1)  # [B, L]

        # 3. 对每个 token,取“最大类别概率”及其 index
        #    - cls_max: 这一位置最像哪一类的概率
        #    - cls_ids: 概率最大的类别索引
        cls_max, cls_ids = cls_prob.max(dim=-1)     # [B, L], [B, L]

        # 4. 置信度 = max_class_prob * iou_prob
        #    你可以理解为 “分类 confident” * “框质量好不好”
        conf = cls_max * iou_prob                  # [B, L]

        # 5. 选出每张图 conf 最大的 num_queries 个位置
        #    largest=True 表示取最大的 K 个;返回值中:
        #      topk_conf: [B, K]  对应这些位置的置信度
        #      topk_idx:  [B, K]  对应原序列中的索引
        topk_conf, topk_idx = torch.topk(
            conf, k=self.num_queries, dim=1, largest=True
        )

        # 6. 根据 topk_idx,从 enc_seq 里取出对应 feature 作为 Q_det
        idx_feat = topk_idx.unsqueeze(-1).expand(-1, -1, C)     # [B, K, C]
        Q_det = torch.gather(enc_seq, dim=1, index=idx_feat)    # [B, K, C]

        # 7. 从 box_unact 中取出对应参考框 logits → ref_points_unact
        idx_box = topk_idx.unsqueeze(-1).expand(-1, -1, 4)      # [B, K, 4]
        ref_points_unact = torch.gather(box_unact, dim=1, index=idx_box)  # [B, K, 4]

        # 8. 从 cls_ids 中取出选中位置的类别 id(这里只需要简单 gather 一下)
        idx_label = topk_idx                                    # [B, K]
        labels = torch.gather(cls_ids, dim=1, index=idx_label)  # [B, K]

        # 返回一个字典,更方便后面用
        return {
            "Q_det": Q_det,                       # [B, K, C]
            "ref_points_unact": ref_points_unact, # [B, K, 4]
            "scores": topk_conf,                  # [B, K]
            "labels": labels,                     # [B, K]
        }
结果:
Q_det:              [2,300,256]
ref_points_unact:   [2,300,4]
(注意选的是“不确定性最小的 top-k”,即 score*IoU 最大的点。)
和原 DETR 的差别:
-
DETR:query 是
nn.Embedding(num_queries, d_model),和图像无关; -
RT-DETR:query 直接选自 encoder 特征中“最像目标”的位置 → 更有语义、更稳定。
为什么这么做?
-
避免 Decoder 从零猜起,显著加速训练;
-
每个 query 都对应一个明确的空间位置(anchor-free 的“关键点”),更利于后面 box refine。
5)Transformer Decoder(并行解码方式)+ DN Queries
Decoder 是 RT-DETR 的核心,它负责把:
-
来自 encoder 的候选位置(queries)
-
跨尺度特征(memory)
-
参考框(ref_points)
逐层 refine 成最终的 分类 + bbox。
在正式进入 Decoder 前,还差一块:DN(DeNoising)queries。
5.1 DN queries:给 decoder 一些“带噪 GT”的练习题(训练专有)
在 RT-DETR 中,DN queries(Q_dn)不是额外单独跑的结构,而是和之前筛选出的300个Q_det拼接成 Q_all,送入同一个 Transformer Decoder 中一起处理。
也就是说:
Decoder 的 queries = DN queries(前面一段) + Detection queries(后面一段)
这批合在一起的 queries 是
Q_all,Q_all = [ Q_dn, Q_det ]。
对每张图的 GT:
-
假设有
Ng个 GT 框(cx,cy,w,h),归一化到 [0,1]; -
重复
G组,例如 2 组:总共N_dn = Ng*G个 DN queries; -
对每个 GT 加一点噪声(中心平移、宽高缩放),得到
boxes_noisy; -
对应的类别标签也可以加一点 label 噪声;
-
把
(boxes_noisy, labels)映射成 query 向量,作为Q_dn。
简单示意:
def build_dn_queries(gt_boxes, gt_labels, num_groups=2, embed_dim=256, num_classes=80):
    # gt_boxes: [B,Ng,4], gt_labels: [B,Ng]
    B,Ng,_ = gt_boxes.shape
    N_dn = Ng * num_groups

    boxes = gt_boxes.repeat(1,num_groups,1)      # [B,N_dn,4]
    labels = gt_labels.repeat(1,num_groups)      # [B,N_dn]

    # 加噪(简化版:中心在 ±0.4*w 以内平移,宽高±40%)
    noise_scale = 0.4
    center_noise = (torch.rand_like(boxes[...,:2])*2-1) * noise_scale
    size_noise   = (torch.rand_like(boxes[...,2:])*2-1) * noise_scale

    boxes_noisy = boxes.clone()
    boxes_noisy[...,:2] += center_noise * boxes[...,2:]
    boxes_noisy[...,2:] *= (1 + size_noise)
    boxes_noisy = boxes_noisy.clamp(0., 1.)

    # 把 (box, label) 编成向量
    class_embed = nn.Embedding(num_classes, embed_dim)
    box_mlp     = nn.Sequential(
        nn.Linear(4,embed_dim), nn.ReLU(),
        nn.Linear(embed_dim,embed_dim)
    )

    label_feat = class_embed(labels)         # [B,N_dn,C]
    box_feat   = box_mlp(boxes_noisy)        # [B,N_dn,C]
    Q_dn = label_feat + box_feat             # [B,N_dn,C]

    return Q_dn, boxes_noisy, labels
总结:
Q_dn: [2, N_dn, 256]   # 比如 N_dn = 100
Q_det:[2, 300,  256]
Q_all= concat([Q_dn, Q_det], dim=1) → [2, N_all,256]  (N_all = N_dn+300)
DN queries 的作用:
显式教 Decoder “如何把一个差不多的位置/大小的框,修成真正的 GT”,
极大加速 DETR 系列的收敛。
5.2 Decoder 输入与多层结构
Decoder 的输入有三块:
-
queries(Q_all):
[B,N_all,256] -
encoder memory(E):
[B,8400,256](来自 AIFI+CCFF flatten 多尺度特征) -
reference points(ref_points):ref_points = [ DN 区域的 noisy box ] + [ Detection 区域从 encoder 预测的 box_logits 中抽取 ]
一个简化版 DecoderLayer:
输入:
  target: [B, 400, 256] (含100去噪 + 300正常查询)
  ref_points_unact: [B, 400, 4] (未归一化坐标)
  memory: [B, L, 256] (编码器特征)
  spatial_shapes: [[H/8,W/8], [H/16,W/16], [H/32,W/32]]

解码器层(共6层,每层结构相同):
  for i in range(6):
    # ---- 自注意力(查询间交互) ----
    q = k = target + MLP(ref_points_unact)  # 加入位置编码
    tgt2 = MultiHeadAttention(q, k, value=target, attn_mask=attn_mask)
    target = LayerNorm(target + Dropout(tgt2))

    # ---- 可变形交叉注意力(核心) ----
    ref_points_sigmoid = Sigmoid(ref_points_unact)  # [0,1]归一化
    ref_points_input = ref_points_sigmoid.unsqueeze(2)  # [B,400,1,4]

    # 每个查询生成12个采样点(3尺度×4点)
    sampling_offsets = Linear(target).reshape(B,400,8,3,4,2)  # [B,400,8头,3层,4点,2偏移坐标]
    attention_weights = Linear(target).reshape(B,400,8,3,4)   # [B,400,8头,3层,4点]
    attention_weights = Softmax(attention_weights)

    # 只计算12个采样点的加权特征(非全局)
    sampled_feats = deformable_sampling(
        memory, spatial_shapes, ref_points_input, sampling_offsets
    )  # [B,400,256]

    tgt2 = sampled_feats * attention_weights.sum(dim=-1)  # 加权求和
    target = LayerNorm(target + Dropout(tgt2))

    # ---- FFN ----
    tgt2 = Linear2(Dropout(ReLU(Linear1(target))))
    target = LayerNorm(target + Dropout(tgt2))

    # ---- 框更新(每层输出) ----
    bbox_delta = MLP(target)  # 预测偏移 [B,400,4]
    # 残差更新: new_box = Sigmoid(delta + inverse_sigmoid(old_box))
    inter_ref_bbox = Sigmoid(bbox_delta + inverse_sigmoid(ref_points_sigmoid))

    # 保存当前层预测
    dec_out_bboxes[i] = inter_ref_bbox  # [B,400,4]
    dec_out_logits[i] = Linear(target)   # [B,400,80]

    # 为下一层准备(detach防止梯度回流到上一层框)
    ref_points_unact = inter_ref_bbox.detach()

输出: 6层所有预测 [6, B, 400, 4/80]
关键设计解读
1)可变形注意力:Query 不再“看全图”,只看 12 个关键点
普通 Transformer 的注意力是“全局对全局”,
一个 Query 要看所有 token(几千个),计算量爆炸。
RT-DETR 使用 可变形注意力(Deformable Attention):
每个 Query 只在多尺度特征图上 采样 12 个点(3 层 × 4 点)。“3 层 × 4 点” 是指每个 Query 会在 3 个尺度(80×80、40×40、20×20)上各选 4 个关键采样点,共 12 个点。
这些点由 Query 自己预测偏移量决定,因此注意力不是“看全图”,而是“看我关心的 12 个位置”。
计算量从 O(L²) → O(12L),
L≈8000 时,速度提升是数量级的。
2)残差式框更新:不是每层都重算框,而是在上一层基础上微调
传统做法:每层都直接预测 (cx,cy,w,h),容易震荡、不稳定。
RT-DETR:
每层预测的是 增量(delta):
sampling_offsets = Linear(target).reshape(B, 400, 8, 3, 4, 2)

B=1: batch size
400=100+300: 查询总数(去噪查询+正常查询)
8: 注意力头数(nhead),每个头独立学习不同模式的采样
3: 多尺度层级数(num_levels),对应[P3, P4, P5]三个特征层
4: 每尺度的采样点数(num_points),每个头在每个尺度上采4个点
2: 坐标偏移量 (Δx, Δy),表示相对于参考点的偏移

总偏移量数 = 8头 × 3层 × 4点 × 2坐标 = 192个值 per查询
Linear(target)的权重形状: 256 → 192
new_box = sigmoid( delta + inverse_sigmoid(old_box) )
理解为:
“上一层已经给我一个大概框了,这一层只负责稍微校正一下。”
好处:
-
回归更稳定,不会乱跳
-
类似 Cascade RCNN 的多阶段 refinement
-
定位精度明显更高
3)跨层坐标 detach:不给 Decoder 的后层“背锅”
下一层要用上一层的 query(target)继续推理,这是 Transformer 的本质;
但参考框只作为采样坐标传下去,因此要 detach,避免梯度跨层纠缠。
每层都会更新参考框 new_box,作为下一层的输入。
但如果让梯度反向流回上一层的 box,会出现:
-
梯度链路过长
-
box 回归震荡
-
训练不稳定(甚至会爆炸)
RT-DETR 的解决方案:
ref_points_unact = new_box.detach()
理解为:
“框坐标传给你,但这是只读的,不能改上一层的梯度。”
效果:
-
训练更稳定
-
每层的框 refinement 都变得干净、可控
4)并行式输出:每层都是“成品预测”,不是“半成品特征”
原 DETR:
只有最后一层 Decoder 才能输出预测,前面的层只是处理中间特征。
RT-DETR:
每一层 Decoder 都做了损失,可以直接输出分类和边框。
理解为:
“我每层都能给你可用的检测结果,想提前拿哪个随你。”
工程优势:
-
可以只用前几层,速度更快
-
可以在 TensorRT 中把多层做 pipeline 并行
-
更适合实时系统(比如 60fps 摄像头)
它靠 可变形注意力(轻) + 残差框 refinement(稳) + 层间梯度隔离(不炸) + 每层可直接输出(快)
把 DETR 变成了真正能实时跑的 Transformer 检测器。
6)Detection Head + 训练 vs 推理流程
6.1 训练阶段:DN loss + Detection loss(匈牙利匹配)
 https://blog.csdn.net/weixin_44115575/article/details/152044652?fromshare=blogdetail&sharetype=blogdetail&sharerId=152044652&sharerefer=PC&sharesource=weixin_44115575&sharefrom=from_link
Decoder 输出的 logits / boxes 中,前 N_dn 部分是 DN queries,后 N_det 部分是检测 queries。
6.1.1 DN 部分:无须匈牙利,直接对齐 GT
对 DN 区域:
-
我们知道每个 DN query 来源于哪个 GT(重复+加噪时记好了 index);
-
因此不用匹配,直接计算:
loss_dn = cls_loss_dn + bbox_loss_dn + giou_loss_dn
DN loss 强制 Decoder 学会:
-
如何把 noisy box → GT box;
-
如何把类别对齐(有 label 噪声时)。
6.1.2 检测部分:匈牙利匹配 + VFL / bbox loss
对检测区域(Q_det 对应的 prediction):
-
用 Hungarian 匹配(类似 DETR)在每张图上构造一对一匹配:
-
某个 GT object ↔ 一个 query
-
cost 由分类 cost + L1 cost + GIoU cost 组成
-
-
计算 detection loss:
loss_det = loss_cls_det + loss_bbox_det + loss_giou_det其中分类通常用 Focal / Varifocal Loss,使 score 更与 IoU 对齐。
-
所有 decoder 层 + encoder 辅助 head 都会参与 loss(带不同权重):
total_loss = Σ_layer w_l * (loss_det_l + λ_dn * loss_dn_l) -
反向传播,更新参数。
总的效果:
DN 提供“有提示的纠错学习”,Query Selection 提供“好候选点”,
匈牙利负责“端到端一对一匹配”,整体收敛速度比原 DETR 快很多倍。
6.2 推理阶段:只保留检测 queries,取最后一层输出,无 NMS
推理时:
-
不再构造 DN queries,只用
Q_det:Q_all = Q_det # [B,300,256] -
送入 Decoder,取 最后一层 的检测部分输出:
boxes_last, logits_last = decoder(Q_det, memory) # boxes_last[-1]: [B,300,4] (cx,cy,w,h, 已过 sigmoid、归一化) # logits_last[-1]: [B,300,K] -
计算类别概率(sigmoid),与 IoU/质量一起生成 score(真实实现里 VFL 已经把 IoU 信息融入):
cls_prob = logits_last.sigmoid() # [B,300,K] # 可以直接拿 max_k(cls_prob) 作为 score,也可以融入 IoU 分支 -
对每张图:
-
展平
[300,K]→[300*K]; -
取前
topN(如 300)个 score; -
得到对应的
(query_idx, class_id); -
用
boxes_last取出对应 box,假设是(cx,cy,w,h)归一化; -
转为
(x1,y1,x2,y2)像素坐标。
-
-
不做 NMS。
因为训练阶段通过匈牙利匹配已经保证:
-
每个 GT ↔ 一个 query;
-
冗余框数量有限;
-
高度重叠框极少。
总的来说假设一张图只有 3 个 GT,但模型预测输出 300 个 query(预测框)。
训练时通过 “匈牙利匹配” 找到 3 个最适合 GT 的 query,其余 297 个都被当作背景(no object)去训练。
推理时再根据得分筛选(top-K 或 score 阈值),最终输出的也是 3 个左右的高置信度检测框。
这就是 DETR 系列“端到端”的精髓。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 63
 0
- 0


 已为社区贡献4条内容

所有评论(0)