登录社区云,与社区用户共同成长
邀请您加入社区
如果你是第一次接触 Claw 生态,我的建议是:先别急着站队,从免费或者低成本的方式入手。记住一点:Claw 生态还在快速进化,今天的热门选择,明天可能就被颠覆了。保持开放心态,随时准备换工具,才是正确的姿势。
在螺丝拧入塑胶支柱的过程中,驱动扭矩会转化为作用在支柱上的力F,该力垂直于螺牙平面。而传统自攻螺丝的牙型角为60°,相较于30°或45°牙型角的自攻螺丝,其产生的径向力更大,因此增加了支柱破裂的风险。在拧入过程中,材料可能受到不合理的挤压,进而导致支柱整体结构的损伤。这种损伤的典型表现是产生大量的塑胶碎屑,同时螺牙与螺牙之间也充斥着大量的塑胶屑,这些都降低了螺丝与支柱之间的摩擦力和拉拔阻力。首先,
在 Python 开发中,管理不同项目的依赖包和 Python 版本是开发者常常遇到的问题。你可以在虚拟环境中安装特定的依赖包,且这些包不会影响系统级 Python 环境。激活虚拟环境后,你的命令行提示符会发生变化,通常会显示你当前所处的虚拟环境的名称。你可以将整个虚拟环境的配置导出为一个可移植的文件,以便在其他地方重建该环境。虚拟环境管理工具,从安装、创建虚拟环境、管理 Python 版本和依赖
大家好,我是爱酱。本篇我们将系统讲解K-近邻算法(KNN),内容涵盖原理、数学公式、案例流程、代码实现和工程建议,适合新手和进阶者学习。详细内容涵盖:K值选择与模型表现、距离度量的选择与影响、加权KNN,分类跟回归任务都会覆盖到!注:本文章含大量数学算式、详细例子说明及代码演示,大量干货,建议先收藏再慢慢观看理解。新频道发展不易,你们的每个赞、收藏跟转发都是我继续分享的动力!注:本文章颇长近700
大家好,我是爱酱。继前几篇介绍了层次聚类、K均值聚类和密度聚类之后,本篇我们聚焦于另一种强大的聚类算法——高斯混合模型(GMM)。GMM是一种基于概率的软聚类方法,能够为每个样本点计算属于各个簇的概率,适合复杂数据的建模。本文将系统介绍GMM的原理、数学表达、实际案例流程及Python代码实现,加上大量公式给出,方便你直接用于技术文档和学习。注:本文章含大量数学算式、详细例子说明及代码演示,大量干
例如:需要将https://ks.wjx.top/vm/QxemSPB.aspx的问卷链接可以直接修改成 https://easywjx.kzw.ink/vm/QxemSPB.aspx。即https://ks.wjx.top/vm/修改为https://easywjx.kzw.ink/vm/GreasyFork(一个油猴脚本收录网站),安装EasyWJX(本文介绍的问卷星破解脚本)1.脚本需要有答
本文是基于《Python机器学习基础教程》第一章学习的总结,主要是基于iris数据集进行探索数据分析和不同分类模型的对比,从而熟悉使用sklearn的模型进行机器学习。
本文基于YOLOv12深度学习算法,设计并实现了一种高效的传送带缺陷识别检测系统。系统针对传送带表面常见的四类缺陷(堵塞、裂缝、异物、孔洞)进行自动化检测,通过构建包含1860张训练图像、318张验证图像和167张测试图像的数据集,实现了高精度的缺陷分类与定位。系统采用改进的YOLOv12模型,优化了网络结构和训练策略,显著提升了小目标缺陷的检测性能。此外,系统集成了用户友好的UI界面,支持登录注
结核病(Tuberculosis, TB)是一种由结核分枝杆菌引起的全球性传染病,早期准确检测对疾病防控至关重要。本文提出了一种基于YOLOv11深度学习模型的结核病检测系统,通过目标检测技术自动识别痰涂片样本中的结核杆菌(TBbacillus)。系统采用包含1,098张训练图像和122张验证图像的自定义YOLO数据集进行模型训练,并集成用户友好的UI界面,支持登录注册功能,便于医疗工作者快速筛查
本文提出了一种基于深度学习YOLOv12的晶圆体缺陷检测系统,旨在实现高效、准确的晶圆制造缺陷分类与定位。系统针对9类常见缺陷(包括Center、Donut、Edge-Loc等)进行检测,采用包含13,000张标注图像的数据集(训练集10,400张、验证集和测试集各1,300张)进行模型训练与评估。结合用户友好的UI界面和登录注册功能。实验表明,YOLOv12模型在晶圆缺陷检测任务中表现出较高的精
本文提出了一种基于深度学习YOLOv12的教师行为识别检测系统,旨在实时识别并分析课堂教学中的教师行为。系统支持6类行为检测,包括“翘腿(Crossing legs)”“指导学生(Guiding students)”“看屏幕(Looking at the screen)”“讲课或提问(Teaching or asking)”“使用手机(Using a phone)”和“书写(Writing)”。
本文提出了一种基于深度学习YOLOv11的辣椒叶片病害识别检测系统,旨在实现高效、精准的病害分类与定位。系统针对5类常见辣椒叶片病害(黄单胞菌病[xanthomonas]、花叶病[mosaic]、健康叶片[healthy]、尾孢菌病[cercospora]和卷叶病[leaf curl])进行检测,采用包含1796张训练图像和462张验证图像的自建YOLO格式数据集进行模型训练。结合用户友好的UI界
本文提出了一种基于深度学习YOLOv11的白细胞类型识别检测系统,旨在实现高效、准确的白细胞分类与定位。该系统针对五类白细胞(嗜碱性粒细胞、嗜酸性粒细胞、淋巴细胞、单核细胞和中性粒细胞)进行检测,采用YOLOv11算法结合定制化YOLO格式数据集(训练集6930张,验证集2970张),在保证实时性的同时提升了小目标检测精度。系统集成用户友好的UI界面,支持登录注册功能。实验结果表明,该模型在验证集
随着水体富营养化问题日益严重,水藻的快速检测与监测成为环境管理的关键任务。本文基于深度学习技术,提出了一种基于YOLOv11的水藻检测系统,能够高效、准确地识别水体中的水藻目标。系统采用YOLOv11算法,针对1类目标(水藻)进行优化,训练集包含704张图像,验证集包含344张图像,确保了模型的泛化能力。此外,系统集成了用户友好的UI界面,支持登录注册功能。实验结果表明,该系统在准确性和实时性上均
随着水体富营养化问题的日益严重,水藻的快速检测与监测成为环境保护和水质管理的重要任务。本文基于深度学习技术,提出了一种基于YOLOv12的水藻检测系统,能够高效、准确地识别水体中的水藻目标。系统采用YOLOv12算法,结合包含704张训练集图像和344张验证集图像的自定义数据集进行模型训练,实现了对单类别(水藻)目标的精准检测。此外,系统配备了用户友好的UI界面,支持登录注册功能。实验结果表明,该
还涵盖格式转换、快速便签、系统工具、智能家居控制等附加功能,一个软件搞定专注、办公、生活需求,学生、职场人、开发者都适配。主打无干扰专注体验,默认简约圆形计时界面,支持自定义主题(暗黑、奶油、马卡龙等20+社区主题),可匹配IDE或系统配色;跨设备同步是核心优势,手机、电脑、平板数据实时同步,外出用手机计时、回家用电脑复盘,无缝衔接;支持自定义计时时长、提醒音效,适配经典番茄工作法。核心亮点:极简
道本科技与DeepSeek的合作,提供了一个明确的解法:不是用AI取代人,而是把合同管理中那些“适合机器做”的事交给机器,让人去做真正需要人的事。两者结合,把合同管理从“人扛着系统跑”,变成了“系统驮着人跑”。道本方案的目标,是把法务从80%的重复性劳动中解放出来,让他们有精力去做那20%真正创造价值的事。每次合同审查中,业务、法务、财务提出的修改意见,系统自动采集、提炼,用于迭代下一轮智能审查。
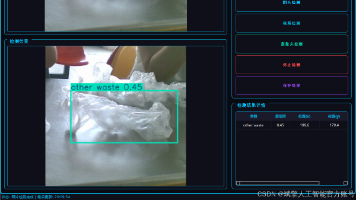
随着城市化进程的加快,垃圾分类已成为实现资源循环利用和环境保护的关键环节。然而,传统的人工分类方式效率低下且成本高昂。为此,本研究基于深度学习技术,提出了一种基于YOLOv11的垃圾分类识别检测系统,能够高效准确地识别四类垃圾:可回收物(recyclable waste)、有害垃圾(hazardous waste)、厨余垃圾(kitchen waste)和其他垃圾(other waste)。
随着城市化进程加快,垃圾分类已成为环保领域的重要议题。传统垃圾分类方法依赖人工分拣,效率低且成本高。为此,本研究基于YOLOv12深度学习算法,开发了一套高效准确的垃圾分类识别检测系统。系统针对4类垃圾(可回收物、有害垃圾、厨余垃圾与其他垃圾)进行检测,采用包含1910张训练集和833张验证集的自建YOLO格式数据集进行模型训练,并结合用户友好的UI界面与登录注册功能。实验表明,该系统在准确率与实
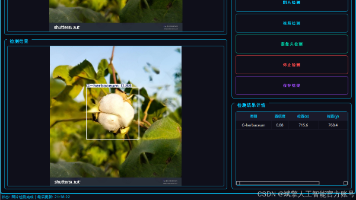
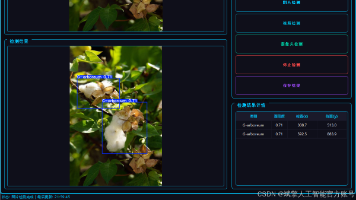
针对棉花品种自动化分类需求,本研究基于YOLOv11深度学习框架开发了一套高效准确的棉花分类识别检测系统。系统以四种常见棉种(G-arboreum、G-barbadense、G-herbaceum、G-hirsitum)为检测目标,通过构建定制化YOLO数据集、优化模型训练流程,并集成用户友好的UI界面与登录注册功能,实现了从数据标注到实际应用的全流程解决方案。目录一、项目介绍二、项目功能展示2.
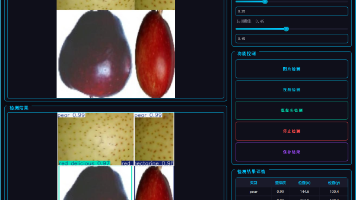
本文基于YOLOv11深度学习框架,设计并实现了一种高效的水果分类识别检测系统,支持6类水果的精准检测,包括金冠苹果(golden delicious)、澳洲青苹果(granny smith)、梨(pear)、红蛇果(red delicious)、红油桃(red nectarine)及黄桃(yellow peach)。系统采用YOLOv11算法,结合包含5,481张训练图像和263张验证图像的自定
针对棉花品种自动化分类需求,本研究基于YOLOv12深度学习框架开发了一套高效准确的棉花分类识别检测系统。系统以四种常见棉种(G-arboreum、G-barbadense、G-herbaceum、G-hirsitum)为检测目标,通过构建定制化YOLO数据集、优化模型训练流程,并集成用户友好的UI界面与登录注册功能目录一、项目介绍二、项目功能展示2.1 用户登录系统2.2 检测功能2.3 检测结
本文探讨如何利用大模型实现客服工单自动分类。传统人工分类存在效率低、不一致等问题,而大模型能更好理解自然语言表达。关键实施步骤包括:1)设计清晰的二级标签体系;2)通过约束性Prompt限制输出范围;3)采用规则优先+分层处理策略降低成本;4)建立评测集评估准确率;5)设置人工复核机制处理低置信度样本。落地时需要构建完整处理流程,并持续收集人工反馈优化模型。成功的核心在于标签体系设计、流程控制和评
通过本教程,你已经了解了如何使用 MATLAB 实现基于 LSTM 网络的数据分类预测与仿真分析,并掌握了时间序列分类和预测的实现方法。MATLAB 提供了丰富的工具和函数,使得深度学习模型的构建、训练和部署变得非常简单。
9000字深度解析机器学习 7 大分类指标:Accuracy、Precision、Recall、F1、ROC-AUC、PR-AUC、LogLoss。涵盖混淆矩阵、多分类 Macro/Micro/Weighted 体系、类别不平衡 5 大方案、阈值调优技巧。配 6 张原创可视化图 + 10 张对比表 + 16 段 sklearn/matplotlib 可运行代码,解决「99% Accuracy 模型
随着智能交通系统和自动驾驶技术的快速发展,车辆自动识别成为计算机视觉领域的重要研究方向。自行车与汽车作为城市交通中两类主要的交通工具,其准确分类对于交通流量监测、违章检测、辅助驾驶等应用具有重要意义。然而,由于光照变化、拍摄角度、车型多样性等因素的影响,传统图像分类方法难以实现高鲁棒性识别。本文针对自行车与汽车图像分类任务,设计并实现了基于卷积神经网络(CNN)的分类系统。首先,构建了包含4000
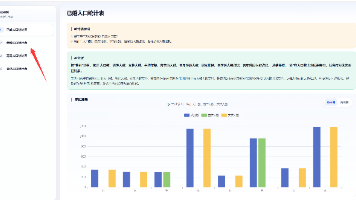
本文介绍了一个基于AI工作流的政府人口数据处理方案。该方案通过提示词配置即可完成千万级XLSX/CSV数据的清洗、归一、分类和统计分析,无需编写Python或SQL代码。核心流程包括:数据清洗(统一日期格式、婚姻状态和学历字段)、构建分类宽表、按婚姻状态拆分子表(已婚/未婚/离异/丧偶),并输出各子表的人口统计结果(数量、性别比例、年龄结构等)。通过封装Python智能体、SQL智能体等技术,实现
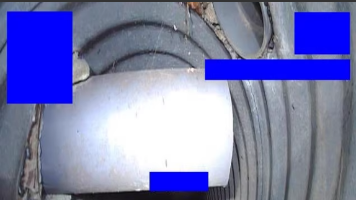
摘要 本文介绍了一个用于排水管道缺陷分类的数据集,包含两个子集:1)支管暗接数据集(2,000张图像,含缺陷与正常样本各1,000张);2)沉积与结垢数据集(80张图像)。数据集特点包括明确的二分类标注、典型缺陷样本覆盖(如例图所示),适用于轻量级分类模型开发或工业质检系统前置模块。代码示例展示了数据加载、预处理及PyTorch模型训练流程,包含数据分割、简单CNN构建(含卷积层、池化层和全连接层
本文介绍了使用CNN卷积神经网络实现衣物分类模型的完整流程。首先下载FashionMNIST数据集并进行预处理,构建包含卷积层、池化层、Dropout和全连接层的神经网络模型。通过10轮训练后,模型在测试集上达到一定准确率,但存在混淆"衬衫"和"T恤"等问题。随后进行了模型改进:增加卷积层、扩大全连接层维度、调整学习率和训练轮次、加入数据增强。改进后的模型性
1前言1.1 研究的背景和意义1.1.1 研究背景农业是国民经济的基础产业,农产品的智能化识别对于提升农业生产效率、保障食品安全、推动农业现代化具有重要意义。水果作为日常消费品,其种类繁多、外观相似,传统的人工分类方式不仅效率低下,而且容易受到主观因素和疲劳的影响,难以满足大规模、高精度的应用需求。随着计算机视觉和深度学习技术的迅猛发展,基于图像的自动分类方法逐渐成为研究热点。卷积神经网络(Con
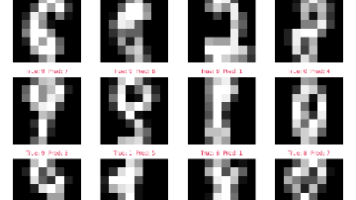
本文基于scikit-learn Digits手写数字数据集,使用随机森林构建10分类模型,实现了96.67%的准确率。研究通过混淆矩阵分析发现数字8最难识别(Recall仅0.86),其易与1、7混淆。创新性地将Permutation Importance映射为8×8像素热力图,揭示模型主要关注图像中心区域(特别是第21号像素),该位置恰为数字笔画交汇点。实验提供了完整的可复现代码和可视化结果,