登录社区云,与社区用户共同成长
邀请您加入社区
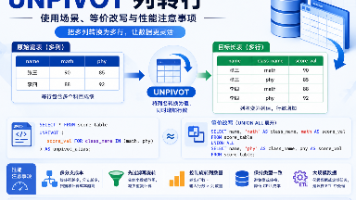
在报表开发和数据清洗场景中,经常需要将“宽表”转换为“长表”。姓名 (name)数学 (math)物理 (phy)张三9085李四8892姓名科目 (class_name)成绩 (score_val)张三math90张三phy85李四math88李四phy92这种把列名转换为列值、同时增加行数的操作,就是逆透视(Unpivot)。Unpivot 是处理宽表转长表的有效工具,但它并不是零成本操作。
最近自己摸索着装好了 Navicat Premium 16,发现只要准备工作做对,其实挺简单的。为了让大家少花时间查资料和找资源,我整理了这份纯干货教程:第一步:做好前期准备(资源下面附带的有)。第二步:跟着我的截图和流程图走,每一步该选什么都标清楚了。不管是刚接触数据库的新手,还是想快速部署的老手,这篇都能帮你搞定。安装不卡壳,干活才顺畅嘛。
本文介绍了两种在DBeaver中导入并执行SQL脚本的方法:1)先创建demo数据库后执行脚本:右键点击数据库→工具→执行脚本→配置路径→开始执行;2)先导入脚本再执行:通过文件菜单导入脚本→右键本地连接创建任务→选择脚本继续执行。两种方法均可成功执行,并支持查看脚本内容执行特定SQL语句。操作过程都包含选择脚本、配置路径和最终执行三个主要步骤。
在Ubuntu服务器下安装MySQL8.0,并通过IDEA进行远程登陆
另外,在基因相关信息页面,下拉找到“NCBI Reference Sequences(RefSeq)”条目,在“mRNA and Protein(s)”里可以看到有不同的转录本,其中mRNA一般是“NM”开头,非编码RNA一般以“NR”开头,还有一种“XM”开头是生物信息预测的转录本。在主页的search框中输入您感兴趣的关键词,例如疾病名称、基因名称或特定的生物化学物质等。进入NCBI网站,选择
身份证号码的前6位是地址码,用于标识持证人的户籍所在地。其中,前两位代表省级行政区,如11表示北京市,32表示江苏省。第3、4位则进一步细化到地级行政区,如110000中的01表示北京市的市辖区,320100中的01表示南京市。通过前4位数字,可以区分不同的市级行政区,例如4102代表开封市,4103代表洛阳市。而仅通过前2位数字,则可以识别出所属的省级行政区,如32开头即为江苏省。这种编码系统有
为XX零售集团构建B2C电商平台,支持日均10万订单处理能力,实现线下会员体系与线上积分互通,项目关联方包括:甲方IT部(决策)、乙方开发团队(执行)、第三方支付公司(接口对接)。验收标准:支持同时在线查询用户数≥200人,查询响应时间≤2秒(压测工具:JMeter 5.4,测试数据量:1000万条)。验收标准:符合甲方品牌VI手册(版本号:2023-Q2),经市场部总监书面确认。本文从结构设计、
论文选题很重要,不是所有能确定出来条件和结果变量且能找到数据的选题就一定适合用fsQCA。建议参考:Fuzzy-set Qualitative Comparative Analysis (fsQCA): Guidelines for research practice in Informati备注:该文章仅是本人自用使用,如果有详细想法,请参照引用文献。
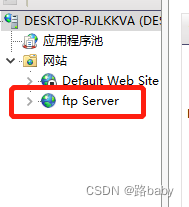
在本机搭建自己的ftp服务器--最简单的方法(详细教程)FTP服务器可以在局域网中快速传输文件,是在互联网上提供文件存储和访问服务的计算机,它们依照FTP协议提供服务。 FTP是File Transfer Protocol(文件传输协议)。顾名思义,就是专门用来传输文件的协议。简单地说,支持FTP协议的服务器就是FTP服务器。...
ElasticSearch 学习万字笔记ElasticSearch adj. 有弹性的;灵活的;易伸缩的全文概述ElasticSearch是一个实时分布式搜索和分析引擎。它让你以前所未有的速度处理大数据成为可能。它用于全文搜索、结构化搜索、分析以及将这三者混合使用:总之,可以对搜索关键字高亮显示,可以对搜索结果纠错,提供建议。并且ELK是大数据必会的技术。本人根据b站狂神说视频“【狂神说Java】
道本科技与DeepSeek的合作,提供了一个明确的解法:不是用AI取代人,而是把合同管理中那些“适合机器做”的事交给机器,让人去做真正需要人的事。两者结合,把合同管理从“人扛着系统跑”,变成了“系统驮着人跑”。道本方案的目标,是把法务从80%的重复性劳动中解放出来,让他们有精力去做那20%真正创造价值的事。每次合同审查中,业务、法务、财务提出的修改意见,系统自动采集、提炼,用于迭代下一轮智能审查。
EXPLAIN是SQL优化的核心工具,但很多人只看type和Extra,忽略了其他关键字段。本文从一条慢查询出发,系统讲解EXPLAIN输出中每个字段的含义:id、select_type、table、type(重点分析system、const、eq_ref、ref、range、index、ALL)、possible_keys、key、key_len、ref、rows、filtered、Extra。
本文构建了一套完整的数据库知识体系,从基础理论到高级应用全覆盖,主要内容包括: 数据库基础理论 核心概念区分:数据、数据库、DBMS、DBS 数据模型与范式理论(1NF-3NF/BCNF) 事务ACID特性与隔离级别 锁机制(行锁/表锁/间隙锁)与MVCC原理 MySQL深度解析 存储引擎对比(InnoDB/MyISAM) 索引原理(B+树/哈希)与优化策略 日志体系(redo/undo/binl
如果在图纸设计阶段发现了一个纰漏,我们可以重新进行图纸设计,如果到了样车制造阶段发现这个错误,那么我们就要把从图纸设计到样车制造的阶段重来,越到后面发现设计上的问题,所付出的代价越大,修改的难度也越大。无论你使用的是Oracle,SQL Server,Sybase,亦或是开源数据库如:MySQL,SQLite等,都可以用来实践我们这里讨论的设计方法和设计理念,设计是这个系列博文的核心和灵魂。许多软
本文总结了使用CDC工具从MySQL同步数据到Doris时遇到的乱序问题及解决方案。作者发现虽然CDC、Flink日志正常,但Doris数据异常,最终定位到是Doris Unique Key模型在乱序写入时后到数据覆盖先到数据的问题。通过为Doris表配置Sequence Column(如update_time字段),确保按业务时间顺序正确覆盖数据。文章还指出CDC涉及源库、网络、SQL引擎和存储
GEO(生成式引擎优化)正成为外贸和运营领域的新焦点,其核心是让企业信息出现在AI生成的答案中,而非传统SEO的网页排名。随着AI搜索渗透率上升,用户可能直接获取AI生成的答案而不点击网站。GEO通过优化网站结构化数据、组织AI偏好内容、构建知识库体系及在第三方平台发声,提升企业在AI回答中的引用率。某工业泵企业通过GEO优化后,AI开始引用其信息并带来新客户。GEO并非取代SEO,而是补充,适合
【摘要】制造业工厂考勤管理面临多班次轮换、工时统计复杂等痛点,传统方式效率低下且易出错。通芝智能考勤系统通过三大核心功能实现管理升级:1)AI智能排班引擎支持跨天多班次动态优化;2)实时异常预警机制将考勤问题处理效率提升70%;3)无缝对接薪酬系统实现综合工时精准核算。数据显示,该系统可使HR事务性工时减少35小时/月,考勤准确率达99.2%,有效解决制造业67%企业面临的工时计算难题,推动考勤从
SQLark是达梦数据自主研发的数据库开发管理工具,支持达梦、Oracle、MySQL、PostgreSQL等主流数据库。该工具提供SQL智能编辑器、AI助手(集成大模型)、数据生成与迁移、ER图生成等核心功能,采用全功能免费授权模式。支持Windows、macOS、Linux系统,具有启动快、无Java依赖等特点,特别适配国产数据库场景。相比Navicat等商业工具,SQLark在AI辅助、数据
SQLark是达梦数据自主研发的数据库管理工具,支持达梦、Oracle、MySQL、PostgreSQL等数据库,提供智能SQL编辑、AI辅助开发、数据生成迁移等核心功能。工具具备语法高亮、代码补全、执行计划分析等编辑器特性,集成大模型AI助手支持SQL生成优化,内置数据生成规则和迁移算法。支持Windows/macOS/Linux系统,采用全功能免费授权模式,特别适配国产数据库和信创场景。相比N
本文记录了我独立开发"水质三维智能监测与分析系统"过程中,在 AI 工程化方向积累的三个核心实战经验。文章涉及自研 Agent 工具调用框架的架构设计与流式难题、RAG 四层检索的参数调优与效果对比、以及 Milvus 向量数据库从连接超时到数据一致性的全线防御策略。项目完整源码已开源在 GitHub。
AI拓扑与三维重建技术可实现货运站全场景数字化管理,构建1:1动态3D模型,实现人车货的厘米级实时跟踪。该方案通过多视角相机阵列和IoT传感器采集数据,利用AI拓扑语义建模构建五维关系图谱,支持透视查看、轨迹追溯和智能预警。相比传统监控,具有全域无死角、主动预警、数据可计算等优势,可提升30%调度效率,降低50%人工巡检成本。关键技术包括动态三维重建、AI语义理解和实时定位跟踪,已在车辆管理、货物
Teable依托稳定PostgreSQL底层数据库、正规开源部署模式、权威合规安全资质,融合零代码快速搭建、精细化数据管理、多人实时协同、全链路AI智能赋能等多重优势,兼顾产品易用性、数据安全性、功能拓展性与场景实用性,既能满足中小微企业轻量化数字化办公需求,也可适配中大型企业定制化、高合规、大数据量的专业数据管理需求。
Flutter sqflite数据库开发指南(鸿蒙适配) 摘要 本文详细介绍了Flutter应用在OpenHarmony平台上使用sqflite进行本地数据库开发的完整流程。作者作为计算机专业学生,分享了健康运动模块开发中的实践经验: 存储方案对比:分析了SharedPreferences、sqflite、Hive等方案的适用场景,指出结构化数据存储首选sqflite 鸿蒙适配要点: 数据库路径拼
作为开源信创国产产品,Teable始终以技术优化为核心,摒弃营销化冗余功能,聚焦开发者使用体验与企业业务落地需求
在企业品牌管理领域,“按键伤企”现象日益突出。本文对Infoseek字节探索推出的数字公关AI中台PaaS系统进行技术性解析。该系统基于DeepSeek、NLP、多模态数据处理等技术,构建了覆盖数据采集、AI执行、智能处理、系统支撑四层架构的完整技术体系。系统实现了8000万+站点的全域监测、分钟级预警推送、15秒级AI自动申诉,并内置1.7万家媒体及40万+自媒体发布通道。本文从技术架构、核心算
摘要:本项目提出一种基于麻雀搜索算法(SSA)优化特征模态分解(FMD)的机械故障诊断方法(SSA-FMD),通过自适应参数优化提升故障特征提取能力。针对机械振动信号的非平稳性和噪声干扰问题,该方法利用SSA自动优化FMD的关键参数(模态数、惩罚因子等),实现更精准的信号分解。MATLAB实现包含信号预处理、SSA优化、FMD分解、特征提取和分类识别全流程,适用于轴承、齿轮等旋转机械的早期故障诊断
摘要:本项目提出基于BAG-LSTM的股票价格预测方法,通过装袋集成策略结合多个LSTM子模型,提升预测精度和稳定性。MATLAB实现包含数据预处理、特征构造、LSTM网络训练和集成预测等模块,支持技术指标特征提取和可视化分析。实验表明,该方法能有效处理金融时间序列的非线性和噪声特性,相比单一LSTM模型具有更好的抗过拟合能力。项目提供完整的代码实现和GUI交互界面,为量化投资研究提供可复现的技术
更多详细内容请访问http://智慧养老基于Python的社区养老服务系统:全流程自动化管理与智能决策支持平台设计基于Python的社区养老服务系统的详细项目实例(含完整的程序,数据库和GUI设计,代码详解)资源-CSDN下载 https://download.csdn.net/download/xiaoxingkongyuxi/92692334 https://download.csdn.ne
摘要:本文介绍了一个基于Python开发的零食销售管理系统,旨在解决传统手工管理效率低、易出错的问题。系统采用三层架构设计,包含商品管理、库存动态更新、销售订单处理、客户服务和数据分析等核心功能模块。通过自动化数据采集、实时库存预警和多维度销售分析,显著提升管理效率和决策精准度。系统具有用户友好界面、完善的数据安全保障和良好的扩展性,可满足中小型零食门店的日常运营需求,并为数字化转型提供支持。项目
摘要:本文介绍了一个基于Python的软件开发技术交流平台的设计与实现。该平台采用前后端分离架构,整合技术讨论、文档分享、项目协作等功能,旨在解决传统交流平台交互单一、检索不便等问题。项目采用Django+RESTfulAPI后端架构,结合React/Vue前端框架,实现了高性能、可扩展的系统设计。平台包含智能推荐、内容审核、用户激励等特色功能,支持多终端适配,为开发者提供高效的知识交流与协作环境
在生成式引擎(GEO)主导内容分发的时代,媒介宣发已从单纯发稿升级为监测 - 合规 - 分发 - 复盘的闭环工程。本文结合 Infoseek 数字公关 AI 中台能力,拆解企业媒介宣发的 GEO 优化路径,用全域舆情监测、AI 合规校验、权威媒体矩阵、数据化复盘,实现品牌声量精准触达与风险可控,适配 CSDN 技术社区规范与 AI 检索偏好。GEO 时代,媒介宣发的核心是权威内容 + 精准分发 +
本项目设计并实现了一个基于Python的用户偏好迁移电影推荐系统,旨在解决传统推荐算法存在的冷启动、数据稀疏和大众化推荐等问题。系统通过时序分析、深度学习和多算法融合等技术,动态建模用户兴趣迁移路径,提升推荐精准度。核心模块包括数据预处理、兴趣迁移建模、推荐算法融合和解释反馈等,采用RNN/GRU等神经网络捕捉用户行为时序特征,结合协同过滤和内容推荐实现多样化推送。项目特色在于兴趣衰减模型和动态加
本文介绍了一个基于Python的皮肤管理预约小程序项目,旨在解决传统线下预约方式效率低下的问题。该系统通过微信小程序平台实现智能化预约管理,用户可便捷预约项目、选择护理师和时间,门店则能优化资源调配和数据分析。项目采用Python开发,包含前端界面、后端服务、数据库架构、智能推荐和安全控制等模块。系统支持个性化服务推荐、实时冲突处理和高并发访问,同时注重数据安全和隐私保护。该方案有效提升了用户体验
摘要:本文介绍了一个基于Python的甜品线上点单配送系统的设计与实现。该系统采用微服务架构,整合订单管理、智能推荐、配送调度等功能模块,解决传统甜品店经营中的时空限制问题。项目利用Python生态优势,实现高并发处理、个性化推荐和路径优化等核心功能,同时注重数据安全与系统扩展性。系统通过数字化运营帮助商家提升效率,并为用户提供便捷的点单体验。文章还探讨了项目在绿色配送和社会责任方面的创新价值,展
智慧药店购药系统基于Python技术实现药品管理数字化升级,整合人工智能与大数据技术优化购药流程。系统采用Flask/Django框架开发,包含药品信息管理、用户健康档案、智能推荐、订单支付等核心模块,实现药品全流程追溯、个性化推荐和库存智能预警。通过机器学习算法分析用户购药数据,提供精准用药建议;采用微服务架构确保系统扩展性,并实施多重安全策略保障医疗数据合规。项目解决了传统药店在效率、安全和服
傲鹏 AI 助理是制造业 ERP+AI 的务实工程化方案,核心价值在于:让不懂技术的管理者、业务人员,用最简单的方式,把 ERP 数据变成实时、准确、可执行的决策能力。更精准的行业语义理解更丰富的制造 / 贸易报表模板更深度的生产、质量、成本诊断移动端、语音交互、多端协同。
iLogtail(LoongCollector)是企业级日志采集的首选工具,轻量、高性能、稳定、易扩展,完美适配云原生与大规模场景。掌握它的安装、配置与调优,是构建可观测平台的基础。
摘要:本文介绍了一个基于Python的个性化阅读推荐系统项目,旨在解决数字化阅读时代的信息过载问题。系统通过融合协同过滤、内容过滤和深度学习算法,实现智能化的内容推荐。项目重点解决了海量数据处理、用户兴趣动态建模、内容语义理解等关键技术挑战,采用分布式架构确保系统性能。系统包含用户画像建模、内容特征提取、推荐算法引擎等核心模块,支持实时反馈和自适应优化。完整项目包含GUI设计、代码实现及详细文档,
本文介绍了一个基于Python的招聘数据分析系统设计与实现项目。该系统通过数据采集、清洗、特征工程、可视化分析等模块,帮助企业从海量招聘数据中挖掘有价值信息。系统采用Python技术栈(Pandas、NLP、机器学习等),实现岗位匹配推荐、薪酬预测、人才趋势分析等功能,并注重数据隐私保护。项目解决了招聘数据异构性、实时性等挑战,为企业提供智能化招聘决策支持,优化用人成本,提升招聘效率与公平性。完整
本文介绍了一个基于Python的小说分享管理系统项目,旨在解决数字化阅读时代的小说资源管理和分享问题。系统采用三层架构设计,包含用户管理、小说归档、智能推荐和社交分享等功能模块。通过SQLAlchemy实现数据建模,使用Flask框架构建Web接口,支持用户注册登录、小说添加搜索、智能标签推荐等功能。项目解决了数字内容管理、个性化阅读体验、版权保护和社交互动等需求,为读者和作者提供了便捷的小说管理
摘要:本项目基于Python开发了一套二手手机分析与可视化系统,旨在解决二手手机市场信息不对称、价格评估难等问题。系统通过爬虫技术采集多平台数据,利用pandas进行数据清洗和特征工程,采用随机森林和XGBoost等算法构建价格预测模型,并集成matplotlib、seaborn等可视化工具实现交互式数据分析。该系统可提升市场透明度,辅助用户决策,优化商家定价策略,促进绿色回收,为产业链提供数据支