登录社区云,与社区用户共同成长
邀请您加入社区
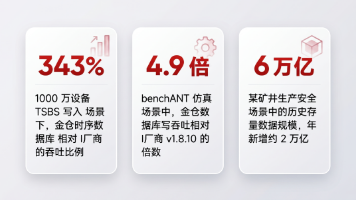
时序数据正从简单的监控指标升级为工业、交通等领域的核心业务数据,推动时序数据库向高基数写入、复杂查询和融合分析方向发展。金仓时序数据库在大规模写入、复杂查询和分布式扩展上表现优异,尤其在轨道交通等场景中实现10倍性能提升。其核心价值在于将时序能力融入多模数据融合架构,使时间数据能与GIS、关系型等数据联合分析,从孤立存储转向业务决策支持,真正释放时序数据的业务价值。
维度OracleKES 部分版本执行顺序保证不建议依赖,优化器可能改写当前可能按书写顺序执行谓词重排支持取决于版本与优化策略跨版本风险较高需要关注版本行为变化工程建议不依赖顺序同样不依赖顺序结论很简单:无论数据库当前如何实现,都不建议把业务正确性建立在WHERE子句函数执行顺序上。在WHERE子句中依赖函数执行顺序,是一种不稳定的 SQL 设计。它可能在当前环境可用,但容易受到连接池、优化器改写、
保姆级SARIMA模型介绍与代码实现
# 时序数据库+AI:物联网海量数据的存储与实时分析> IoT设备每秒产生的数据点数以亿计,传统关系型数据库早已不堪重负。时序数据库(TSDB)正是为这种"时间戳+数值"的写入模式而生,配合AI分析可实现真正的实时智能。## 为什么需要时序数据库?``` 传统关系型数据库 (MySQL/PostgreSQL): ┌──────────────
道本科技与DeepSeek的合作,提供了一个明确的解法:不是用AI取代人,而是把合同管理中那些“适合机器做”的事交给机器,让人去做真正需要人的事。两者结合,把合同管理从“人扛着系统跑”,变成了“系统驮着人跑”。道本方案的目标,是把法务从80%的重复性劳动中解放出来,让他们有精力去做那20%真正创造价值的事。每次合同审查中,业务、法务、财务提出的修改意见,系统自动采集、提炼,用于迭代下一轮智能审查。
工业数字化进入分析决策新阶段,传统数据库及多组件拼接架构弊端凸显,运维复杂、成本高且协同受限。一体化时序数据库成新趋势,DolphinDB 凭借存算流一体、多引擎适配、流批统一、全栈自研等能力,适配多类工业场景,还可支撑 AI 应用,成为工业数据底座优选。
时序数据库已经成为工业物联网不可或缺的基础设施。它解决了传统数据库在存储海量时序数据时面临的写入瓶颈、存储成本、查询性能等一系列问题。在选择时序数据库时,企业应以自身业务需求为出发点,综合考虑数据规模、查询模式、生态兼容性与长期演进能力。对于工业关键场景,Apache IoTDB 的开源生态与 TimechoDB 的企业级安可资质相结合,正成为越来越多企业的稳妥选择。从工业数据底座到智能决策,时序
Qt开发中的三个核心功能实现:1. 音频播放功能,支持.wav格式文件播放;2. QSS界面美化,详细讲解了常用属性设置和选择器使用;3. API绘图功能,包括QPainter、QPen和QBrush的使用方法。内容涵盖了属性设置、选择器分类、绘图基础操作等实用技术,为Qt界面开发和功能实现提供了完整的技术指导
结构体的每个字段使用各自类型对应的压缩器独立编码后拼接。Marker 标记区分固定结构体(预注册列)和自适应结构体(运行时自动发现 Map 中的列)。位于文件末尾,记录每个物理块的物理位置与解压后逻辑偏移的映射关系,支持按偏移直接定位到任意块。查询时通过二分搜索快速定位相关块并跳过无关数据。每条记录描述一个逻辑块属于哪个标签列、覆盖的时间范围、以及在。会刷新所有缓冲数据并释放资源。设为 0 时默认
给定集合D1D2DnD1D2Dn,一个关系rrrr⊆D1×D2×⋯×Dnr⊆D1×D2×⋯×Dn因此,关系是一组 n 元组的集合,其中每个元组a1a2ana1a2an满足ai∈Diai∈Di。例→ 关系instructor是该笛卡尔积的一个子集。
现有的很多自动化算法(比如单纯的 $3\sigma$ 原则、箱线图 Isolation Forest 等)非常“死板”,它们只看数值离不离群,而不管背后的物理逻辑。如“某一天用电量突增”,很可能是因为引起的。这些属于,如果直接删掉或平滑掉,模型就学不到这种极端情况,预测准确率反而会大打折扣。只盯着负荷曲线本身,突增的用电量就是个无法解释的“离群点”;但只要拉入协变量,这个突增就有了合法的“动机”。
不用再反复折腾代码做解码、拼接、补缺、校正,选定区域和时间范围后,就能导出标准格式文件,直接接入仿真软件或Python、Matlab进行建模。把数据预处理、清洗校正、出力演算这些重复工作交给成熟的整编数据集,我们才能把更多精力放在模型优化、机制分析、结果讨论上,论文和项目的完成效率、质量上限都会大幅提升。常规再分析数据在国内复杂地形下误差偏大,而这套数据集针对国内山地、丘陵、河谷地带做过本地化校正
中国软件行业协会发布《"人工智能+工业软件"融合应用成熟度评价规范》(T/SIA 064—2026),填补行业空白。该标准由27家单位共同起草,历时一年完成研制,明确了评价体系与分级架构,涵盖数据管理、智能分析等核心指标。北京涛思数据作为主要参与单位,依托其TDengine时序数据库和IDMP工业数据管理平台的技术积累,为标准提供重要支撑。标准实施将推动工业智能化升级,促进产业链协同发展,助力企业
豪迈精工不仅实现了从开料、封边到钻孔、组装的全程自动化,更通过智能管理系统实现全流程可追溯,确保每一件产品都能达到最佳效果。在SEGE品牌的广东江门生产基地,德国豪迈全自动电子锯与意大利CNC钻孔木榫机正在以微米级的精度,编织着一场关于工业秩序的冷峻交响。在精密机械的统治下,人工作业让位于算法控制,制造误差被压缩至极限。这项技术的成功,不仅提升了用户的使用体验,更重新定义了浴室柜的制造标准。未来,
以下详细流程新建文本文档,写入测试代码(简单加减运算),演示标准格式:scl// 外部SCL文件示例:加法运算功能块VAR_INPUTIN1: Int;IN2: Int;END_VARVAR_OUTPUTEND_VAR// 逻辑体。
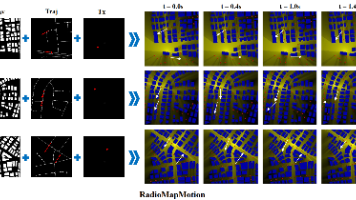
本文介绍了RadioMapMotion和RadioMotionNet,首次提出无线电磁态势预测任务,从静态快照构建转向动态预测。研究团队构建了首个大规模时空连续的RadioMapMotion数据集,包含300个城市环境、动态车辆轨迹和射线追踪仿真数据。提出的RadioMotionNet结合ConvLSTM的时序建模与UNet的空间特征提取,在动态和空间泛化测试中均表现最优,推理速度达1.3ms/帧
总结提示词极限赛对AI技术民主化的推动作用。鼓励开发者、创作者共同探索人机协作的新范式。
摘要: TDengine是一款国产开源高性能时序数据库,专为物联网、工业互联网等时序数据场景优化设计。其核心设计亮点包括超级表(STable)(统一管理海量子表)、标签(Tag)(高效过滤分类数据)和时间线(优化时序数据存储),显著提升了数据写入性能(单机百万级/秒)和压缩比(10:1以上)。相比InfluxDB,TDengine具备国产化优势、类SQL语法、内置数据订阅和边云同步功能,适用于车联
DolphinDB顺利通过国家级安全可靠测评,拿到关键行业准入资质。产品核心代码自研率超95%,历经十年打磨跻身全球时序数据库前五。依托全链路国产化安全架构,产品立足自研底座,布局多产品线,朝着AI+Infra智能底座稳步升级。
《百万级测点能源管理系统的微服务架构实践》摘要:面对2026年能源数字化进程中百万级测点带来的技术挑战,开源的MyEMS系统通过领域驱动的微服务架构实现突破。系统将采集、计算、存储等核心功能模块化,采用时序数据库优化、冷热数据分层等策略应对高并发写入与查询需求,结合容器化部署和云边端协同架构确保系统弹性。实践表明,该架构在百万测点场景下仍能保持毫秒级响应,为双碳目标下的精准能源管理提供了可扩展的技
楼宇能源管理系统会产生海量的历史数据。例如,一个中型商业综合体若包含 500 个测点,按 5s 采集频率计算,一年将产生超过 30 亿条记录。传统的关系型数据库(如 MySQL)在达到千万级数据后,查询性能会断崖式下降。构建一套高效的楼宇能源管理系统,关键在于底层协议的稳定采集与上层时序数据的科学管理。在协议层,统一转换是降低耦合性的必经之路;在存储层,TimescaleDB 提供了 SQL 的便
数据可用率:从 95% 提升至 99.9%(依靠边缘网关断点续传)。查询性能:在 1 亿行数据量下,月度收益报表的生成速度从 30 秒降低至 2 秒以内。结算偏差:云端核算电量与线下电表偏差控制在 0.5% 以内,达到了结算级精度。在合同能源管理系统中,数据即资产。开发者在设计系统时,应优先考虑边缘侧的鲁棒性与后端存储的可扩展性。我们在 ZenovaOS 平台中深度集成了上述 PR 模型与自动对账
本文系统分析了工业场景下时序数据库的选型策略。针对智能制造领域设备数量多、数据关联分析需求强、国产化和成本敏感三大特点,作者对比了TDengine、openGemini和InfluxDB三款主流时序数据库的核心特性及适用场景。TDengine采用"一设备一表"模型,集成缓存和流计算,适合大规模设备接入;openGemini作为华为开源产品,满足国产化需求且性能突出;InfluxDB则以成熟生态见长
文章摘要 本文介绍了时序数据库TimechoAI的核心优势与API Key配置方法。针对工业物联网场景中的海量时序数据(如设备传感器数据),TimechoAI通过原生适配IoTDB数据结构,提供高效的存储、压缩和查询能力,并集成大模型分析功能(如异常检测、趋势预测)。重点讲解了API Key的作用及获取方式,并通过REST和Python两种示例演示接口调用流程,帮助开发者快速实现时序数据的智能化分
TDengine 时序数据库学习摘要 TDengine是一款开源高性能时序数据库(TSDB),专为物联网、工业互联网等时序数据场景设计。核心特性包括:百万级数据点/秒的高写入性能、5-20倍的高压缩比、兼容标准SQL语法、内置流式计算和缓存功能,以及原生分布式架构。 与传统关系型数据库相比,TDengine采用超级表(Super Table)+子表的数据模型,列式存储+时间分区,支持时序特有的窗口
安徽智质在水泥工厂智能化升级中,针对天车无人化调度系统的高频数据挑战,引入TDengine TSDB时序数据库,优化了海量数据处理能力。系统通过激光雷达和PLC实时采集万级通讯点数据,采用“超级表-子表”模型实现高效存储与查询,在单核虚拟化环境下(1核CPU/4GB内存)稳定运行。方案将故障定位时间缩短至5分钟内,支持90天数据长效存储,显著提升了天车轨迹回溯与故障排查效率,为水泥行业工业无人化提
写入能力:KaiwuDB 原生时序引擎优势突出,吞吐碾压 PG 时序化方案,高并发写入更稳更强。查询表现:整体领先,复杂查询拉开百倍差距,并发越高优势越明显。稳定性:数据量越大、并发越高,TimescaleDB 衰减越严重;KaiwuDB 波动极小,更适合长期高负载运行。架构差异:原生时序 vs PG 插件化,在高吞吐、高并发、复杂查询场景的差距被彻底放大。
《园区能源管理系统的微服务架构实践》摘要:2026年双碳战略背景下,MyEMS开源系统通过微服务架构解决园区能源管理痛点。系统将采集、计算、存储等七大核心功能解耦,采用InfluxDB+PostgreSQL混合存储策略,实现百万级测点的高效处理。关键技术包括:插件化采集服务、实时计算分流、时序数据分层存储,以及边缘计算支持。该架构通过容器化部署和全链路监控,在保证系统稳定性的同时,支持碳排放精准核
时序数据库选型指南:聚焦工业物联网场景 本文系统分析了时序数据库选型的核心考量因素,重点探讨了工业物联网场景下的特殊需求。文章指出,企业选型时需关注六大关键问题:场景契合度、持续写入稳定性、长期存储成本、时序查询优化、技术栈集成能力以及产品演进路径。针对工业物联网海量设备数据、复杂协议和网络环境等特点,传统数据库往往难以胜任。 文章特别推荐了Apache IoTDB这款国产时序数据库,其优势在于:
Apache IoTDB 之所以值得在选型清单上认真评估,不是因为它在某项 benchmark 上领先,而是因为它从骨子里就是为时序数据设计的——从数据模型到 SQL 语义,从单机架构到集群演进,从开源生态到企业支持,每一层都对得上时序场景的真实需求。Apache IoTDB 之所以值得在选型清单上认真评估,不是因为它在某项 benchmark 上领先,而是因为它从骨子里就是为时序数据设计的——从
在工业物联网云原生时代,时序数据库的选型不再仅仅是"哪个写入更快"的性能竞赛,而是数据模型与物理世界对齐程度的比拼。Apache IoTDB 凭借树表双模型对工业层级的原生表达、TsFile 对时序特征的深度优化、端边云协同对复杂网络环境的适配,以及 AINode 对智能分析的内置支持,已成为大型工业企业的首选数据底座。从 K8s Helm 一键部署的便捷,到设备模板批量建模的高效;从 TsFil
Apache IoTDB是专为工业物联网设计的时序数据库,具备百万级写入、31:1高压缩比及毫秒级查询性能。它通过树形模型、端边云一体化架构及AI集成,解决设备层级管理、存储成本高和实时分析难等工业核心痛点。
各类课件存储方式各有适配场景,本地存储无网可用、稳定性强,云存储便捷高效、支持多端同步,临时存储方式灵活轻量化,可满足不同使用需求。综合全场景适配性、安全性、功能性来看,首选百度网盘。其凭借千亿级存储体量、国际权威安全认证、全端无缝同步能力和行业顶尖的GenFlow4.0 AI智能体系,完美适配学生备考、教师备课、职场培训、长期资料沉淀等全场景需求,是目前课件存储与学习提效的最优工具。轻量化临时存
写入能力:KaiwuDB 具备显著优势KaiwuDB 的写入引擎在全场景下都展现出了更强的硬件利用效率,中小规模场景下的吞吐能力达到了 InfluxDB 的 7 倍,能够支撑工业物联网、车联网这类海量写入的业务场景,写入上限远高于 InfluxDB。小数据场景:InfluxDB 的简单查询有小幅优势在极小数据规模、低并发的简单查询场景下,InfluxDB 的响应速度略快,适合轻量的小数据业务场景,