登录社区云,与社区用户共同成长
邀请您加入社区
按照 BST 规则插入↓沿祖先路径更新平衡因子↓平衡因子为 0:停止平衡因子为 ±1:继续平衡因子为 ±2:旋转真正实现 AVL 树时,难点主要集中在旋转。二叉搜索树的大小关系左孩子指针右孩子指针父指针整棵树的根指针局部子树与上一层的连接结点的平衡因子右单旋左单旋左右双旋右左双旋最后给出一套可以直接在 Linux 环境中编译运行的完整 C++ 实现。假设失衡结点为parent说明 parent 左
继承解决了类之间的代码复用问题,但仅仅有继承,还不能让程序根据对象的实际类型自动执行不同的行为。普通人:全价买票学生:优惠买票军人:优先买票如果程序通过大量if-elsecout << "全价买票" << endl;cout << "优惠买票" << endl;cout << "优先买票" << endl;多态提供了一种更自然的方式:调用者只面向统一的基类接口,具体执行哪个版本,由对象的实际类型决
继承是 C++ 面向对象部分非常重要的一块内容。在学习继承之前,我们已经接触过函数复用、模板复用和 STL。它们解决的都是“相同代码不要重复写”的问题,而继承解决的是类层面的复用。例如,学生和老师都具有姓名、年龄、电话和地址,也都需要进行身份认证。如果分别在Student和Teacher中定义这些成员,不但代码重复,后续修改起来也比较麻烦。继承允许我们把公共部分抽取到一个基类中,再让不同的派生类在
set某个关键字是否存在?而实际开发中,我们经常不只是想找到一个关键字,还想找到它对应的信息。英文单词 -> 中文解释学号 -> 学生成绩商品编号 -> 库存数量用户名 -> 用户资料文件名 -> 文件大小这种“一个关键字对应一个值”的关系,称为映射关系。C++ STL 中的map就是用来保存这种关系的有序关联式容器。key :用于查找和排序value :与 key 关联的数据map和set的关系
摘要:本文系统讲解策略模式和状态模式的设计思想与应用场景。策略模式通过封装可替换算法(如商品询价规则、登录验证逻辑)实现解耦,利用对象映射消除if-else,符合开放封闭原则。状态模式处理对象状态切换(如咖啡机工作流程、自动门控制),将状态相关行为封装为映射对象,通过委托执行状态逻辑。两种模式都通过TS类型系统(接口、枚举)增强代码健壮性,策略模式侧重算法选择独立性,状态模式强调状态与行为的绑定关
最基础的html图片插入
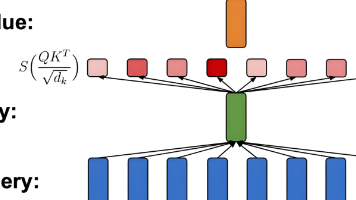
QKVToken:北京Q_beijingK_beijingV_beijingQ:我想找谁K:我是哪个信息V:我携带什么内容Q = 查询条件K = 索引V = 数据KV名称的来源。KV Cache 本质上是 Transformer Attention 的结果缓存机制,用空间换时间,避免历史 Token 的重复计算。重复计算问题已经算过的 K 和 V不要再算第二次决定模型能力KV Cache决定推理效
这篇面向想进入 AI 应用方向的前端开发者,但不会把“前端转大模型:从页面开发到 AI 产品工程师:从踩坑到可复用方案”写成概念清单。我会按产品化视角的实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从求职作品集角度切入,重点写可展示成果”展开,换一组场景和例子来讲。回到“前端转大模型:从页面开发到 AI 产品工程师:从踩坑到可复用方案”这个主题,最
《绕过BOSS直聘字体反爬的智能抓取方案》 本文介绍了一种高效获取BOSS直聘招聘数据的技术方案。针对该平台采用动态字体反爬导致传统爬虫失效的问题,提出创新性解决方案:通过Chrome开发者工具协议(CDP)直接调用内部API获取明文数据,而非解析前端渲染内容。 技术方案核心是: 利用CDP连接专用Chrome实例,在已登录环境下执行脚本 直接调用/wapi/zpgeek/search/jobli
做前端十年,经历过 jQuery 时代、React 革命、移动端大潮、微前端浪潮。每次变化来的时候都有人说"前端已死",但前端一直没死,只是变了个活法。AI 这次可能真的不一样。不是取代前端,而是重新定义前端的工作方式——从写代码的人,变成定义代码该做什么的人。
这篇面向想进入 AI 应用方向的前端开发者,但不会把“前端转大模型:从页面开发到 AI 产品工程师:线上排查时才会暴露的细节”写成概念清单。我会按产品化视角的实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从线上问题排查切入,重点写风险、监控和回滚”展开,换一组场景和例子来讲。回到“前端转大模型:从页面开发到 AI 产品工程师:线上排查时才会暴露的细
Agent编排的核心不是让一个AI什么都会,而是让每个AI只做最擅长的事,然后用路由把它们串起来。如果你也在做Agent系统,建议从这五个点逐一对照检查——尤其是生命周期管理和SSE透传,这两个是生产环境最容易翻车的地方。更多AI Agent、RAG、MCP实战内容,关注我持续更新。
摘要:GPU集群调度系统的关键技术与挑战 本文深入探讨了AI基础设施中GPU集群调度系统的核心作用与技术难点。文章指出,GPU调度系统是决定AI公司成本效率的关键,与CPU调度存在本质差异:GPU任务资源需求大(如64 GPU/2TB内存)、切换成本高,导致传统调度策略失效。作者剖析了GPU集群的核心架构,包括任务提交流程、资源发现机制和匹配算法(Best Fit/Bin Packing),重点讲
AI Agent技术解析:从LLM到智能代理系统 本文深入剖析AI Agent的技术本质与系统架构,揭示其如何突破大语言模型(LLM)的局限性。文章首先指出LLM的三大天然缺陷:无法访问外部实时数据、缺乏长期记忆、不具备实际执行能力。随后详细拆解Agent的五层核心架构:LLM层(负责推理决策)、Planning层(任务规划分解)、Memory层(短期/长期记忆管理)、Tools层(外部能力集成)
Boost MSM(Meta State Machine)是一个基于状态机模型的C++库,用于描述和管理复杂的状态转换逻辑。文章首先介绍了状态机的基本概念,包括状态(State)、事件(Event)、转换(Transition)、动作(Action)和守卫(Guard),并通过播放器状态转换表示例说明转换表的结构化定义方式。随后详细讲解了子状态机、正交区域、伪状态(如终止状态、分支和历史状态)等高
深度拆解前端权限系统的完整落地路径:从 RBAC 与 ABAC 模型选型、Pinia 状态管理、动态路由生成,到按钮级指令、v-permission 组件封装、数据权限控制,再到微前端跨应用权限同步、Token 安全与实时刷新机制,全部配有可直接复用的代码示例。一文搞定菜单可见、按钮可用、接口可控、数据可隔离四大核心诉求。
本文介绍了如何构建一个基于 DeepSeek 大模型的代码助手系统,采用 FastAPI 后端和 Streamlit 前端架构。后端通过 FastAPI 封装 DeepSeek 模型的 API 调用,支持自定义系统提示词和用户问题输入;前端 Streamlit 界面提供友好的 Web 交互,可发送请求并高亮展示生成的代码或解答。文章详细讲解了前后端代码实现、运行方法及安全注意事项(如 API Ke
✅完全可以实现。后台编辑页:将AI文案按段落拆分,提供“勾选+设置占位符key”的交互,未勾选的段落不保存。数据存储:只存储带的段落及其默认文案、样式、坐标。前端(用户端):只渲染后台设置的占位符段落,每个提供输入框让用户修改。更新逻辑:用户修改后提交新文案,后端重新生成海报图片或前端实时重绘。你截图中的“保存提示词”“选择提示词”等功能,可以作为扩展:将某个占位符及其文案保存为“提示词模板”,方
这篇面向想进入 AI 应用方向的前端开发者,但不会把“前端转大模型:从页面开发到 AI 产品工程师:写进简历前要补的工程证据”写成概念清单。我会按产品化视角的实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从团队落地角度切入,重点写协作、日志和可维护性”展开,换一组场景和例子来讲。回到“前端转大模型:从页面开发到 AI 产品工程师:写进简历前要补的工
本文揭示了企业系统中常见的权限控制漏洞问题,通过一个"机构用户"误看"学校用户"数据的案例,指出单层权限防御的风险。作者提出三层防御体系解决方案:1)接口层按角色过滤数据(后端必做);2)路由权限采用白名单机制(前端必做);3)UI功能入口按角色控制。文章强调权限判断应集中配置而非分散处理,并提醒注意空值处理和空状态展示的细节。最后指出该方案同样适用于AI多租户场景的数据隔离,强调权限隔离是系统可
# 2026 年的研发模式,跟两年前有什么本质区别2024 年初,AI 辅助编码还是个新鲜话题。Copilot 刚开始普及,大家讨论的还是"AI 能不能写代码"。到了 2026 年,问题已经变了:不是"AI 能不能写",而是"AI 在研发流程里到底该扮演什么角色"。这两年的变化不是渐进式的改良,而是研发模式在发生代际性的更替。## 四代研发模式的演进回顾一下研发模式的代际演进:
文章摘要 本文是一份基于真实事故的LangGraph深度教学文档,聚焦流式事件处理与消息过滤问题。核心内容包括: 基础概念:介绍LangGraph状态图(StateGraph)三要素(状态、节点、边)、流式执行(astream)和四种消息类型(Human/AI/Tool Message)。 事故背景:2026年6月遭遇两个叠加问题——子图内部的结构化JSON泄漏到用户界面,以及修复时误过滤正常消息
如果说程序员已经是高薪职业,那么干AI的程序员,就是高薪中的高薪。学AI大模型,就是冲刺高薪的最优解!零基础小白不知道从哪入门?有基础的程序员找不到系统学习路径?实战项目练手无门?面试不知道考什么?别慌!今天就给大家整理了一份【2026年最新版】AI大模型免费学习资源包,覆盖从入门到实战、从理论到面试、从基础到进阶的全流程,所有资料均已整理归档,无冗余、无套路,免费分享给每一位想抓住AI风口的程序
摘要:Agent化App的设计与实践 本文探讨了AI时代App从功能驱动向任务执行的转型。传统App依赖用户操作界面元素,而Agent化App通过自然语言理解用户意图,自主完成任务。作者提出三层架构:意图引擎(Intent Engine)解析用户需求,任务中心(Task Center)标准化任务流程,工具中心(Tool Center)封装业务能力。特别强调系统无状态设计和记忆存储的重要性,并以鸿蒙
技术点说明模块化思想前端/后端代码分离,各自独立开发、维护,通过 HTTP 接口通信用 JSON 文件快速搭建 REST API,适合原型开发和学习语义化标签header, main, footer, aside 等让 HTML 结构更清晰,SEO 友好DOM 树HTML 被解析成节点树,document 对象提供查询和操作节点的方法fetch API现代浏览器内置的异步请求方法,返回 Promi
HarmonyOS Image组件美化功能详解 本文介绍了HarmonyOS NEXT中Image组件的核心美化功能,包括6种填充模式(objectFit)、圆角裁剪(borderRadius)、透明度(opacity)、边框样式(border)和高斯模糊(blur),并通过一个"图片美化工具"Demo展示了各项属性的实际效果。 Demo采用实时预览交互方式,用户可通过滑块调节圆角、透明度等参数,
摘要 HarmonyOS NEXT 推出的 SideBarContainer 组件为多栏布局提供了解决方案,适用于大屏、折叠屏和平板设备。该组件支持侧边栏收起/展开、拖拽调整宽度、自动管理控制按钮,并提供三种模式(Embed、Overlay、AUTO)以适应不同屏幕尺寸。文章通过构建一个"知识库浏览器"示例,详细展示了 SideBarContainer 的核心功能,包括侧边栏动画、分类导航联动以及
前端请求无响应:浏览器控制台报 Failed to resolve import “@/utils/request”。原因是 Vite 默认不支持 @ 别名。解决方案:在 vite.config.js 中配置 resolve.alias 或改用相对路径导入。同时添加 console.log 调试,发现表单验证 canSubmit 为 false,测试手机号格式不对(使用了 12345678901
从"会写页面"到"能交付模块"——这是从学习者到实践者的跨越,独立完成一个完整业务模块,建立可持续的 AI 前端开发工作流。
摘要 本文探讨了AI系统性能瓶颈的演变趋势。随着大模型发展,行业发现单纯提升模型规模已无法保证系统性能,实际应用中常出现响应延迟问题。研究表明,现代AI系统的瓶颈已从计算能力转向数据流效率,主要体现在: 数据预处理和传输耗时远超计算时间 KV Cache等运行时状态占用大量内存资源 带宽和内存访问速度取代算力成为关键指标 长上下文场景下内存容量成为主要限制 Agent系统中任务调度效率比单次推理速
本文探讨了AI行业从"算力时代"向"存力时代"的转变趋势。随着大模型应用落地,行业发现系统瓶颈已从计算能力转向数据吞吐和状态管理。Transformer架构的Attention机制、长上下文需求、Agent系统的兴起,都导致状态空间呈指数级增长,KV Cache等内存占用问题日益突出。多Agent系统更将引发状态爆炸,使得内存带宽、缓存管理和状态同步成为核心挑战。未来AI竞争的关键可能不再是GPU
Deep Agents Template 的高级功能**(规划、委派、批评子智能体、写文件等)和前端 HTTP 调用的能力。下面我为你整合一个完整的项目,基于库(LangChain 的深度智能体模板),外加 Flask 包装层和前端聊天界面。这样你既得到了 deep agent 的强大工作流,又能通过浏览器与它交互。1. 后端代码 ()这里使用的 ,保留其内置的 、、、 流程,并添加两个默认子智能
成功实例:医药企业内部进销存系统后端1人,依托AI完成采购、销售、库存、财务4大模块20余个页面,18天全系统上线,项目预算比传统前后端分工节省55%,日常字段变更、筛选条件修改,后端直接改前端代码,无需协调前端资源。落地快、成本低:内部系统落地性价比天花板;数据一致性高:前后端同一人开发,接口、字段零理解误差;迭代灵活:小需求随时改,无需协调多角色资源;降低项目试错门槛:创业项目最小可行性产品M
AI发展进入新阶段:算力与生态双轮驱动 过去AI行业过度聚焦算力竞赛(如GPU集群、大模型参数),但逐渐暴露出落地难题——模型虽强,却难以接入实际业务系统(如财务、OA等),导致价值受限。未来AI竞争将从单一模型能力转向**"算力+生态"协同**: 算力决定智能上限:支撑复杂模型训练与推理 生态释放商业价值:通过标准化接口(如MCP协议)连接企业系统,使AI能真正执行业务流程(如审批、订单创建)
鸿蒙AI应用开发:从聊天机器人到智能助手的演进 本文探讨了鸿蒙AI应用从传统聊天机器人向智能助手的转型方向。文章指出,未来的AI应用不应局限于问答形式,而应深度融入业务场景,成为能理解意图、拆解任务并执行操作的真实助手。 核心观点包括: 智能助手与传统聊天机器人的本质区别在于任务执行能力 提出四层架构方案(UI-Assistant-Task-Tool),强调工具层的重要性 通过课程助手案例展示意图
更大的模型更强的推理更多的GPU如何连接软件世界CRMERPOA数据库工作流消息系统组成的软件生态。
如果说程序员已经是高薪职业,那么干AI的程序员,就是高薪中的高薪。学****AI大模型,就是冲刺高薪的最优解!零基础小白不知道从哪入门?有基础的程序员找不到系统学习路径?实战项目练手无门?面试不知道考什么?别慌!今天就给大家整理了一份【2026年最新版】AI大模型免费学习资源包,覆盖从入门到实战、从理论到面试、从基础到进阶的全流程,所有资料均已整理归档,无冗余、无套路,免费分享给每一位想抓住AI风
看到一个问题,很多后端或基础设施的人会认为:多模型 API 适配是网关、中间件的事。但实际开发中,比如一个模型返回,另一个返回,前端需要为每种模型写不同解析代码。有的模型支持 SSE,有的只支持 WebSocket,有的只能轮询任务。前端需要维护不同的状态机。API Key、JWT、临时 Token、请求头签名……每种鉴权在前端都可能需要不同的拦截器或配置。不同模型返回的错误码、错误字段完全不同,
框架选择:本节课使用 FastAPI 封装接口,轻量易用,适合 AI 服务开发请求方式GET:参数拼在 URL,适合简单查询POST:参数放请求体,适合长文本、复杂数据,业务首选跨域:前后端分离项目必须配置,否则前端无法调用流程链路前端页面 → HTTP 请求 → FastAPI 接口 → LangChain 逻辑 → 返回结果给前端。
AI 天机学堂(从 0 到 1)-day4
很多人第一次接 Claude API,基本都从开始:发请求、等返回、打印结果。刚开始做 Demo 没问题,但只要项目进入真实场景,很快就会发现这种模式根本撑不住。聊天框会白屏十几秒,长文本生成经常超时,Agent 工具调用必须傻等整轮响应结束,Cursor 那种“边生成边输出”的体验完全做不出来。真正到了生产环境,你会发现:Claude API 的核心能力,其实不是 messages.create
用data-theme和 CSS 变量管理主题用 head IIFE 减少主题首屏闪烁用 Markdown 阅读页承接真实长文场景用 async generator 模拟 AI 写作交互链路用清晰边界避免把前端模板说成完整平台一个个人博客项目最容易失控的地方,是一开始就想做成完整系统。v0.1.1 的取舍正好相反:先把展示、阅读和交互原型做扎实,再决定后端、模型和内容工作流怎么接。