登录社区云,与社区用户共同成长
邀请您加入社区
本文介绍了双向链表(带头双向循环链表)的实现方法。双向链表通过prev和next指针实现双向遍历,使用哨兵位头结点简化边界处理。文章详细讲解了双向链表的结构定义、节点创建、初始化以及各种操作:头插/尾插、头删/尾删、查找、指定位置插入/删除、判空、销毁和打印。相比单链表,双向链表的插入和删除操作更高效(O(1)时间复杂度),但查找仍需O(n)时间。最后总结了双向链表的优势,包括通过哨兵位统一操作逻
顺序表链表经典算法
单链表—很细讲解
本文介绍了三个算法问题的解决思路和代码实现:1. 环形链表检测(使用C++ STL set存储节点指针);2. 两个数组求交集(使用set去重后对比);3. 随机链表的深拷贝(提供C语言节点插入法和C++ map映射法)。重点讲解了利用STL容器简化算法实现的过程,包括set的去重特性、map的节点映射关系等技巧。对于每个问题,文章都给出了题目描述、解决思路和完整代码实现,并分析了算法的时间复杂度
题目要求两两交换链表中的相邻节点,不能修改节点值,只能交换节点。解题思路是使用哑节点简化处理,维护四个指针:当前对的前驱节点、当前两个节点和下一对的起始节点。通过重连指针完成交换,再移动指针处理下一对。代码使用循环实现,时间复杂度O(n),空间复杂度O(1)。
本文系统介绍了队列的基本概念、存储实现及操作。队列是一种"先进先出"的线性表,只能在队头删除、队尾插入。文章详细讲解了顺序队列(循环队列)和链式队列两种实现方式,包括其管理结构体设计、初始化、判空/满、入队/出队、遍历、获取队头数据以及销毁等核心操作。每种操作都配有示例代码和逻辑图解,顺序队列采用数组实现并通过取模运算实现循环,链式队列则通过动态节点管理。最后给出了两种队列的具
本文系统介绍了链表这一基础数据结构,重点分析了C++中链表的实现与应用。内容涵盖:1)链表与数组的核心对比;2)单向、双向和循环链表的实现方式;3)链表的基本操作(插入、删除、反转等)及时间复杂度分析;4)常见错误与优化技巧;5)面试高频考点和实际应用场景(如LRU缓存)。文章强调指针操作顺序、内存管理和边界条件等关键点,并提供了学习路线和推荐资源。链表作为算法面试的核心考点,需要结合实践才能真正
对于逻辑关系为“一对一”的数据,除了用和存储外,还可以用栈结构存储。栈是一种“特殊”的线性存储结构,它的特殊之处体现在以下两个地方:1、元素进栈和出栈的操作只能从一端完成,另一端是封闭的,如下图所示:图 1 栈存储结构示意图通常,我们将元素进栈的过程简称为“入栈”、“进栈”或者“压栈”;将元素出栈的过程简称为“出栈”或者“弹栈”。2、栈中无论存数据还是取数据,都必须遵循“先进后出”的原则,即最先入
队列用来存储逻辑关系为“一对一”的数据,是一种“特殊”的线性存储结构。队列是两端都开口,但元素只能从一端进,从另一端出,且进出队列遵循“先进先出”的原则。
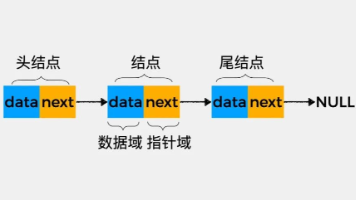
链表又称单链表、链式存储结构,用于存储逻辑关系为“一对一”的数据。和顺序表不同,使用链表存储数据,不强制要求数据在内存中集中存储,各个元素可以分散存储在内存中。
前言上一章我们学到了顺序表,实现了顺序表的增删查改。当然也发现了顺序表存在的一些优点与缺陷,我们再来回顾一下:优点:支持随机访问,可以通过下标来直接访问。可以排序。缺点:中间/头部的插入删除,时间复杂度为O(N)增容需要申请新空间,拷贝数据,释放旧空间。会有不小的消耗。增容一般是呈2倍的增长,势必会有一定的空间浪费。所以为了弥补这些缺点就有了链表,那么什么是链表呢?链表链表的概念及结构概念:链表是
针对有序链表为了实现高效的查找,可以使用跳表这种数据结构。其根本思想是 二分查找 的思想。跳表的前提条件是针对有序的单链表 ,实现高效地查找,插入,删除。
🟣 前端2026最新【持续更新】→。🟢 前端0到1【持续更新】→。🔵 前端进阶【持续更新】→。🔴 AI最新学习资料 →。
本文提出一种优化固定数组时间轮在槽过载场景下性能的方法。通过将每个槽扩展为多个子桶组成的链表,并限制每次tick处理的任务数量(批次执行),解决了瞬时大量定时任务堆积导致的性能问题。该方法保持O(1)插入复杂度,通过批次控制确保处理时间上限,以可控的延迟抖动换取稳定性。文中详细描述了数据结构、插入逻辑、批次执行流程和线程安全考虑,并给出Mermaid结构图说明。这种方案适用于高并发定时任务场景,如
我们已经彻底吃透了线性表的全部存储形态:顺序表、单链表、双向循环链表,同时熟练掌握了 STL 排序、去重、二分、最值、计数等全套基础算法。至此,我们拥有了线性存储+基础数据处理的完整底层能力。从今天开始,我们正式进入受限线性表的学习阶段。所谓受限线性表,就是基于普通线性表,人为限制插入、删除位置,从而拥有更严格、更专一的数据特性。而栈,就是我们接触的第一种受限线性结构。栈的逻辑极其简单,但算法地位
在正式学习两种结构前,我们先理清基础概念。早期编程使用机器语言,直接操作二进制和内存地址,存储、运算数据既低效又容易出错。于是高级语言引入数据类型,屏蔽了底层内存细节,还能校验运算合法性。在此基础上延伸出抽象数据类型(ADT):它是一个数学模型 + 一组配套操作,只定义数据范围和可执行行为,不限制具体实现。就像游戏角色马里奥,定义了前进、跳跃、射击等动作,至于代码如何实现并不关心。而线性结构除首尾
不推荐让人变懒的工具,只推荐让人变快的工具。书匠策AI的期刊论文功能,本质上就是一个"加速器"——它不替你思考,但它帮你把思考的成果,最快速度变成看得见的文字。*试一次。也许,你的论文转机就从这一次点击开始。👉 公众号:搜一搜「书匠策AI」去吧,别让论文再折磨你了。
工具是用来帮你通关的,不是替你上场的。选题、框架、论证这些硬功夫谁也替不了你。但到了降重降AIGC这最后一公里,你真没必要一个字一个字死磕到凌晨三点。***。把省下来的时间拿去补个觉,毕业季已经够苦了,别跟自己过不去。咱们下期再聊,溜了溜了~✌️。
书匠策AI不替你写论文,它帮你把"勉强能交"的论文变成"稳稳能过"的论文。选题、框架、论证,这些硬活还得你自己干。但最后这道"降重降AIGC"的关卡,真没必要再用笨办法一个字一个字抠了。微信搜一搜"书匠策AI",官网*,把省下来的时间拿去睡觉,它不香吗?我是你们的论文急诊科博主,咱们下期门诊见。🩺。
工具是工具,书匠策AI不是替你写论文,而是帮你把"能用"的论文变成"好用"的论文。降重降AIGC只是最后一道关卡,前面的选题、框架、论证还得你自己来。但至少在最后这一步,别再用笨办法一个字一个字改了。微信搜一搜"书匠策AI",官网*,该省的时间省下来,多睡一觉不香吗?我是你们的论文搭子,咱们下期见!✌️。
我做论文科普这么久,最怕的就是同学们用蛮力去对抗检测系统。其实工具选对了,效率能翻十倍。书匠策AI这个工具,我自己用了两个月,真心觉得它是2025年论文党的必备装备。不管你是本科生、研究生还是在职写论文,都值得去试一试。***,或者微信搜**书匠策AI**,别再说我没告诉你!
"DeepSeek-R1实现复杂条款博弈,审查精准度提升300%”"DeepSeek开源框架驱动,企业级部署成本骤降80%”“法律语义理解突破:SFT+RL优化合同知识图谱”“99.6%安全屏障坚不可摧”“80%↓企业级部署零负担”“400+全周期智能预警”“98.7%业界高精度”
工具是为人服务的,不是来收割人的。书匠策AI的免费查重功能,我自己实测过,流程顺畅、结果可用、没有套路。配合它的AI降重和格式工具,确实能帮你在论文这条路上少走不少弯路。记住两个入口:书匠策AI毕业季加油,祝大家查重一把过,顺利上岸!🎓。
我做论文科普这么久,最烦的就是那种打着"免费"旗号实际上全是坑的工具。书匠策AI这个免费查重,我自己用过,流程顺畅、结果清晰、没有隐藏收费,配合它的AI降重功能,确实能帮毕业党省下不少钱和时间。记住两个入口:💬 公众号:微信搜一搜"书匠策AI毕业季加油,祝你们查重一次过,顺利拿证!🎓。
如果你正在深夜对着空白文档发呆,这篇文章就是写给你的。我做论文科普这么久,后台收到最多的一句话不是"怎么写摘要",而是——所以今天,我不聊技巧,不聊套路。***,微信搜一搜**书匠策AI**)的期刊论文功能,到底把写论文这件事拆成了什么样。拆完你会发现,原来期刊论文不是一座山,它就是五块积木。
AI不是来替你写论文的,是来帮你跳过"从0到1"那段最折磨人的路的。书匠策AI把期刊论文写作拆成了"选题→开题→大纲→图表→成稿→格式"六个清晰的模块,每个模块都有AI帮你托底。你要做的,就是在每个节点注入自己的判断和思考。书匠策AI论文这条路,别死扛。工具选对了,你会发现——原来期刊论文,真的可以不那么"秃头"。
哈喽各位同学们,我是你们的论文写作科普博主!今天咱们聊一个让无数毕业生"又爱又恨"的环节——。你是不是也有过这样的经历:辛辛苦苦写完一篇万字论文,结果一查重,飘红一大片,心态直接崩了。更让人肉疼的是,市面上随便一个查重平台,动不动就几十块甚至上百块,改一遍查一遍,钱包比论文还先"掏空"。别慌!今天给大家安利一个我自己实测过的,它有一个,真心好用,而且操作简单到离谱。(公众号也能用)
说真的,写论文这件事,工具选对了,效率能翻倍。与其花大价钱去买那些不靠谱的查重服务,不如先试试书匠策AI这个免费的选项。📱 公众号:微信搜书匠策AI好了,今天的科普就到这里。👋。
摘要 YaoEngine日志系统是一个基础的C++日志工具,包含时间格式化、日志级别和消息输出功能。作者承认当前代码质量较差,后续其开源在GitHub(https://github.com/yanan-0604/YaoEngine-DEV),并计划后续优化。系统支持多种日志级别(Trace/Debug/Info/Warn/Error/Fatal)和时间格式(年/月/日/时/分/秒),通过宏定义简化
本文深入解析了Linux进程状态的底层实现机制,从内核视角揭示了运行态、阻塞态和挂起态的本质区别。文章首先对比了课本抽象的三态模型与Linux实际的多状态系统,指出进程状态转换实质上是内核将进程控制块(task_struct)在不同队列间移动的过程。重点剖析了三大核心队列:运行队列(CPU调度)、硬件等待队列(设备资源)和磁盘交换分区(内存管理),并详细解释了进程如何在这些队列间迁移。
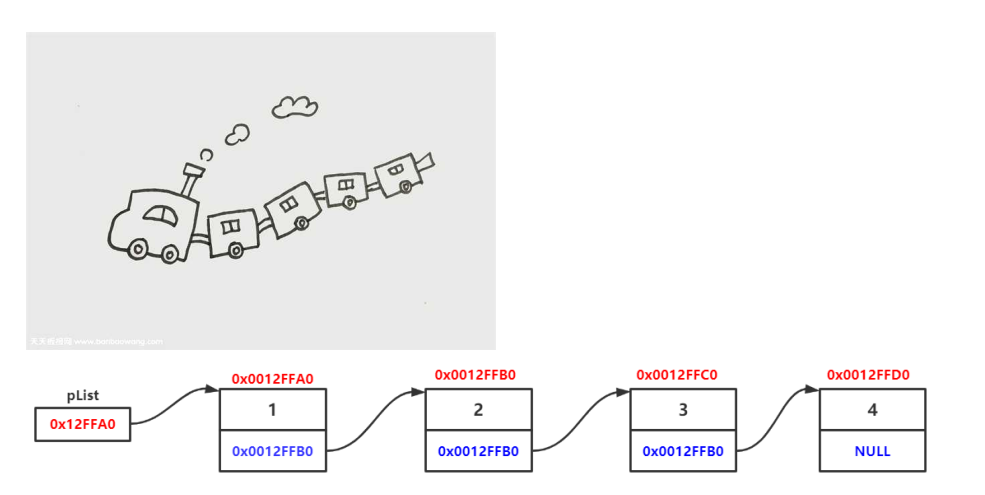
本文系统介绍了单链表的实现原理与操作方法。主要内容包括:1. 单链表的核心概念与结构特性,通过火车车厢模型形象类比节点连接方式;2. 详细实现方案,涵盖节点创建、增删改查等11种核心操作,重点解析了头指针、头结点等关键概念的区别;3. 完整代码展示,包括节点结构体定义和功能函数实现;4. 优缺点分析,指出链表在动态内存管理和插入删除效率方面的优势,以及随机访问性能不足的缺点。文章通过大量代码示例和
Go 标准库里没有单链表,只在 container/list 包里提供了双向循环链表。
本文深入解析数组与链表两种基础数据结构,从内存模型到工业级实践。主要内容包括: 发展历史:从早期计算机时代的数组起源(1940s)到现代计算时代的演进(2010s-2026),分析硬件发展对数据结构的影响。 理论基础:详细讲解内存层次结构、时间复杂度数学证明(如数组O(1)访问的地址计算)、动态数组扩容的均摊分析等核心原理。 深度解析: 数组:内存布局可视化、静态/动态数组对比、多维数组存储方式
构造结构体一共有三种方法代码语言:cAI代码解释int sn;int age;char sex;int s[3];int main()代码语言:cAI代码解释int sn;int age;char sex;int s[3];}a,b,c[10];int main()方法三:(不建议使用,省略类型名的方法)代码语言:cAI代码解释structint sn;int age;char sex;int s
工具是放大器。你脑子里有东西,它帮你放大十倍;你脑子里空的,它放大的也只是空气。它把"写论文"这个让人恐惧的大任务,拆成了选题、找文献、搭大纲、写初稿、调格式五个小步骤。你不需要一口气吃成胖子,你只需要一步一步来。去试试吧,书匠策AI官网,微信搜"书匠策AI"。先从智能选题玩起,别上来就想生成全文。论文这件事,慢慢来,比较快。
本文通过一个简单的驱动管理演示程序,解析了Linux内核中常用的三个宏:LIST_HEAD、container_of和list_for_each。作者通过预处理展开展示了这些宏的实际作用:LIST_HEAD用于初始化链表头节点,container_of通过成员指针获取所属结构体指针,list_for_each实现链表遍历。文章包含完整的测试代码和Makefile,展示了如何创建链表、添加节点并遍历
本文探讨了合并K个升序链表的三种解法:优先队列法(O(NlogK))、分治归并法(O(NlogK))和逐一合并法(O(NK))。重点分析了优先队列和分治归并的实现细节与复杂度,并提出了多种变形应用:降序合并、流式输入处理和部分结果提取。文章还指出该模型与外部排序中多路归并的关联性,强调掌握核心算法和边界条件的重要性。
本文深入剖析了数据结构中队列(Queue)的 C 语言实现方案。文章首先通过对比实验,阐明了链表在规避顺序表“数据挪动”和“空间浪费”方面的显著优势。技术核心:架构封装:创新性地采用“双结构体”设计,通过管理结构体承载 phead、ptail 及 size,巧妙规避了繁琐的二级指针操作,显著降低了开发难度。性能优化:由于实时维护了队尾指针与规模变量,入队及状态检测均实现了 $O(1)$ 的恒定时间
有效的括号:栈的括号匹配基础模型。最小栈:辅助栈技巧实现 O(1) 最小值查询。字符串解码:嵌套结构的栈处理。每日温度:单调栈找下一个更大元素。接雨水:单调栈或双指针解决面积问题。数组中的第K个最大元素:Top-K 问题的堆解法。熟练掌握这些题目,即可轻松应对面试中大部分栈、队列、堆相关的题型。下一篇预告:LeetCode 热题 100 精讲|二叉树基础篇:二叉树的中序遍历 · 二叉树的最大深度
本文详细介绍了二叉树链式结构的实现方法,包括二叉树的遍历(前序、中序、后序和层序遍历)、基本操作方法(计算节点数、叶子节点数、第k层节点数、查找节点、计算高度、判断完全二叉树)以及二叉树的创建和销毁。文章通过清晰的代码示例和图解,帮助读者深入理解二叉树的操作原理。所有内容均为作者原创,无AI参与,适合对数据结构感兴趣的读者学习参考。
单模匹配(实现 strStr())用 KMP 算法高效匹配;重复子串检测(重复的子字符串)考察对 next 数组的理解深度;单词拆分将问题转化为完全背包的 DP 模型。KMP 算法需要花时间理解 next 数组的含义,但一旦掌握,字符串匹配类的题目就能一通百通。单词拆分虽然归类为动态规划,但本质上也是字符串处理问题,可以用字典树优化查找效率。面试时建议先讲清楚暴力解法的局限,再引出 KMP 或 D
节点结构:每个节点包含数据(这里假设为整数)、指向前一个节点的指针prev和指向后一个节点的指针next。链表类:包含一个哨兵头节点head,其prev和next在空链表时指向自身。我们实现以下方法:push_front:在链表头部插入元素。push_back:在链表尾部插入元素。insert:在指定位置插入元素。pop_front:删除头部元素。pop_back:删除尾部元素。remove:删除
本文主要介绍了栈和队列面试题,内容全由作者原创(无AI),同时深度解析了每道题目的解题思路和解决方法,并带有配图帮助博友们更好的理解,点个关注不迷路,下面进入正文~~
CountDownLatch 是一种一次性同步屏障,通过 AQS 实现。线程调用 await() 阻塞直到计数器归零,其他线程通过 countDown() 递减计数。当计数器归零时,所有等待线程被释放且无法重用。核心机制包括:1) 使用 AQS 状态表示剩余计数;2) await() 执行两次非阻塞检查(入队前和唤醒后),实际等待通过 LockSupport.park() 实现;3) countD