Unpivot 列转行:使用场景、等价改写与性能注意事项
Unpivot 能把多列转换为多行,但旋转列越多,潜在扫描和计算成本越高。
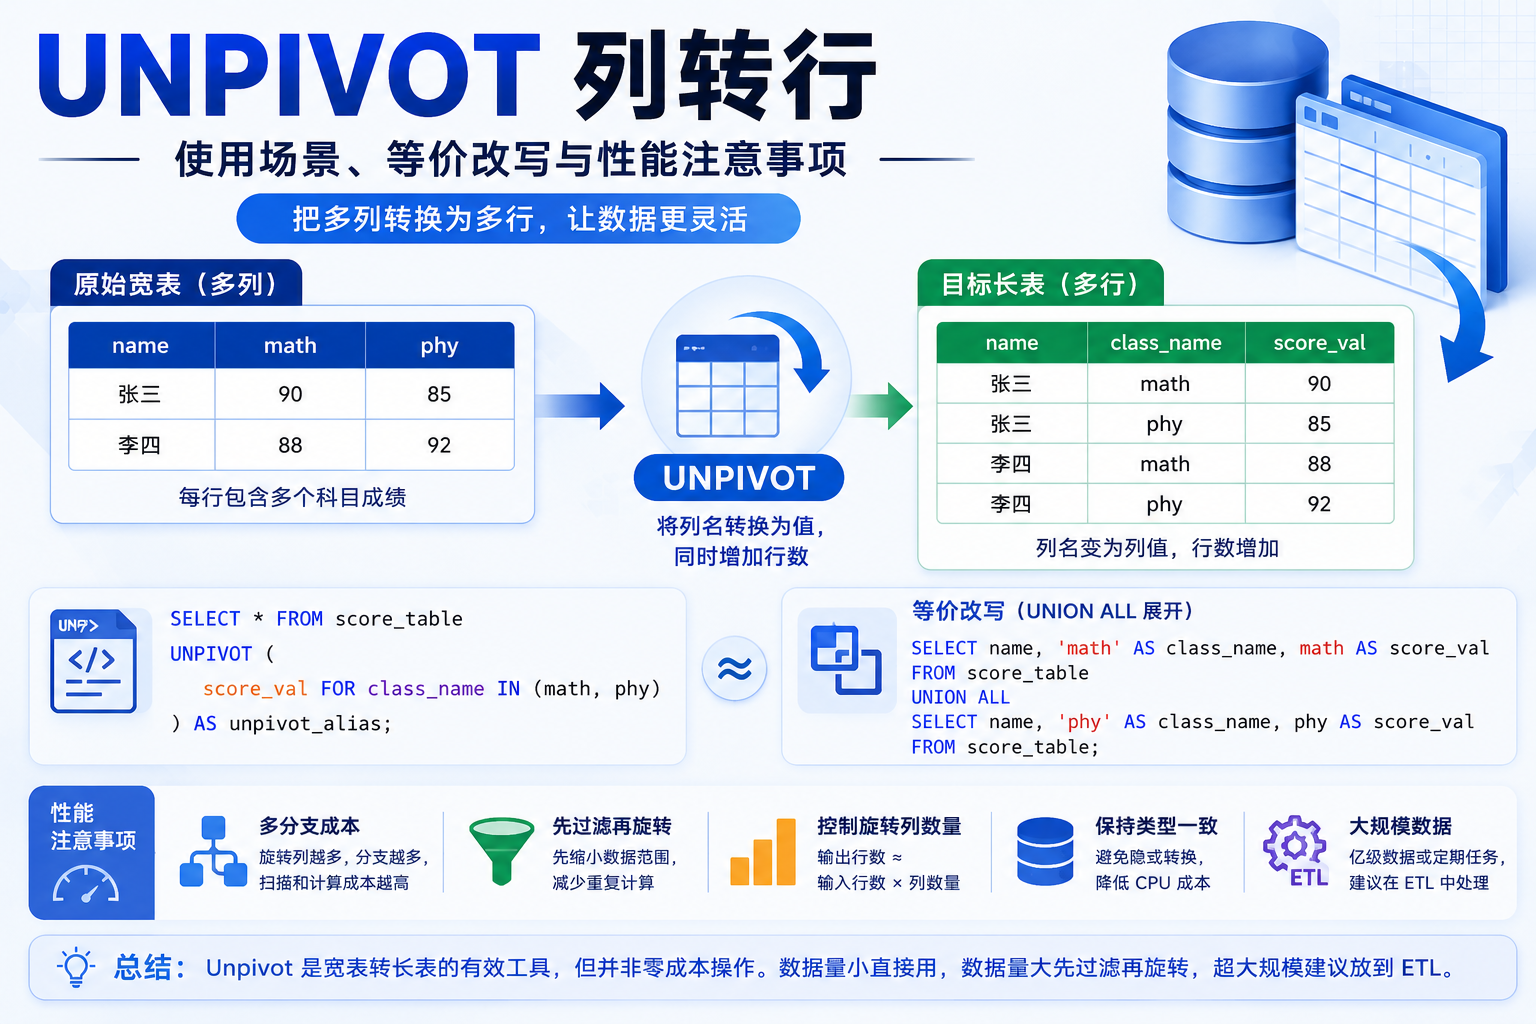
引言:什么是逆透视?
在报表开发和数据清洗场景中,经常需要将“宽表”转换为“长表”。
原始数据:
| 姓名 (name) | 数学 (math) | 物理 (phy) |
|---|---|---|
| 张三 | 90 | 85 |
| 李四 | 88 | 92 |
目标结果:
| 姓名 | 科目 (class_name) | 成绩 (score_val) |
|---|---|---|
| 张三 | math | 90 |
| 张三 | phy | 85 |
| 李四 | math | 88 |
| 李四 | phy | 92 |
这种把列名转换为列值、同时增加行数的操作,就是逆透视(Unpivot)。
一、Unpivot 的核心机制
1.1 处理流程
Unpivot 的处理逻辑通常包括三步:
- 确定需要旋转的列,例如
math、phy; - 保留非旋转列,例如
name; - 生成两个新列:一个存储原始列名,一个存储原始单元格值。
1.2 语法示例
SELECT * FROM score_table
UNPIVOT (
    score_val FOR class_name IN (math, phy)
) AS unpivot_alias;
关键点:
score_val:新生成的值列,存放原始单元格值;class_name:新生成的名称列,存放原始列名;- 建议为逆透视结果指定清晰别名;
- 参与逆透视的列数据类型应兼容,避免隐式转换增加 CPU 成本。
二、Unpivot 的等价改写
理解 Unpivot 的一种方式,是把它看作多个 SELECT 通过 UNION ALL 拼接:
SELECT name, 'math' AS class_name, math AS score_val
FROM score_table
UNION ALL
SELECT name, 'phy' AS class_name, phy AS score_val
FROM score_table;
这说明 Unpivot 的成本通常与旋转列数量相关。列越多,生成的分支越多,扫描、过滤或投影成本也可能随之增加。
三、性能注意事项
3.1 多分支处理成本
如果源表有 10 个列需要旋转,逻辑上就可能对应 10 个分支。对于大表而言,即使每个分支都很简单,累计 I/O 和 CPU 成本也不可忽视。
3.2 复杂过滤条件可能被重复执行
SELECT * FROM (
    SELECT name, math, phy, chem, bio, eng
    FROM score_table
    WHERE year = 2024
      AND school_id IN (
          SELECT id FROM schools WHERE region = '华东'
      )
) t
UNPIVOT (
    score_val FOR class_name IN (math, phy, chem, bio, eng)
) AS ua;
如果执行计划无法复用过滤后的结果,上述过滤逻辑可能在多个分支中重复执行,导致成本放大。
四、优化方案:先过滤,再旋转
4.1 使用 CTE 缩小输入集
WITH filtered_scores AS (
    SELECT name, math, phy, chem, bio, eng
    FROM score_table
    WHERE year = 2024
      AND school_id IN (
          SELECT id FROM schools WHERE region = '华东'
      )
)
SELECT * FROM filtered_scores
UNPIVOT (
    score_val FOR class_name IN (math, phy, chem, bio, eng)
) AS ua;
CTE 的作用是先把数据范围收窄,再执行列转行。是否真正物化或复用中间结果取决于数据库版本和优化器策略,因此仍应通过执行计划确认。
4.2 控制旋转列数量
旋转列数量越多,输出行数越大:
输出行数约等于 输入行数 x 旋转列数量
因此,在大表场景中应只旋转业务需要的列,不要把宽表所有列一次性展开。
4.3 保持类型一致
参与 Unpivot 的列应尽量使用相同或兼容的数据类型。如果需要强制转换,建议在源查询中显式处理,避免执行期间发生不可控的隐式转换。
五、Unpivot 与 Pivot 的不可逆问题
Pivot 后的数据不一定能通过 Unpivot 完整还原。
原因在于 Pivot 往往包含聚合操作。如果张三有两条 math 成绩记录:90 和 95,SUM(score) 会合并为 185。之后再 Unpivot,只能得到 math = 185,无法恢复原始两条明细。
如果业务需要双向转换,应在 Pivot 前保留明细标识,或避免把明细过早聚合。
六、最佳实践
- 小规模报表转换可以直接使用 Unpivot,语义清晰。
- 大表场景应先过滤,再执行列转行。
- 控制旋转列数量,避免输出行数成倍膨胀。
- 保持参与转换列的数据类型一致。
- 亿级数据或固定周期转换,优先考虑在 ETL 阶段完成。
- 不要假设 Pivot 与 Unpivot 可以完整互逆。
总结
Unpivot 是处理宽表转长表的有效工具,但它并不是零成本操作。理解其等价于多分支展开的执行模型后,就能更合理地控制输入范围、旋转列数量和类型转换成本。
工程实践中的基本原则是:数据量小,直接使用;数据量大,先过滤再旋转;超大规模或固定任务,放到 ETL 流程中处理。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 18
 0
- 0


 已为社区贡献159条内容

所有评论(0)