登录社区云,与社区用户共同成长
邀请您加入社区
Git分支合并指南摘要 本文详细介绍了将特定提交从一个Git分支合并到另一个分支的多种方法。主要内容包括: 核心方法: cherry-pick:最常用方式,可合并单个或多个提交 merge --no-ff:通过临时分支合并部分功能 补丁应用:使用format-patch和apply 操作场景: 合并连续/不连续的提交 处理远程分支提交 选择性合并文件或目录 修改提交信息 冲突解决: 使用--con
本文介绍了OpenPI项目的安装与使用指南。首先需克隆仓库并更新子模块(git clone --recurse-submodules)。建议通过wget下载uv依赖管理工具,解压后手动安装。使用uv同步库文件并安装环境(uv sync & pip install)。最后提供了infer.py示例代码,展示了如何加载预训练模型进行推理。注意图片数据需替换为实际输入,运行环境需配置Python
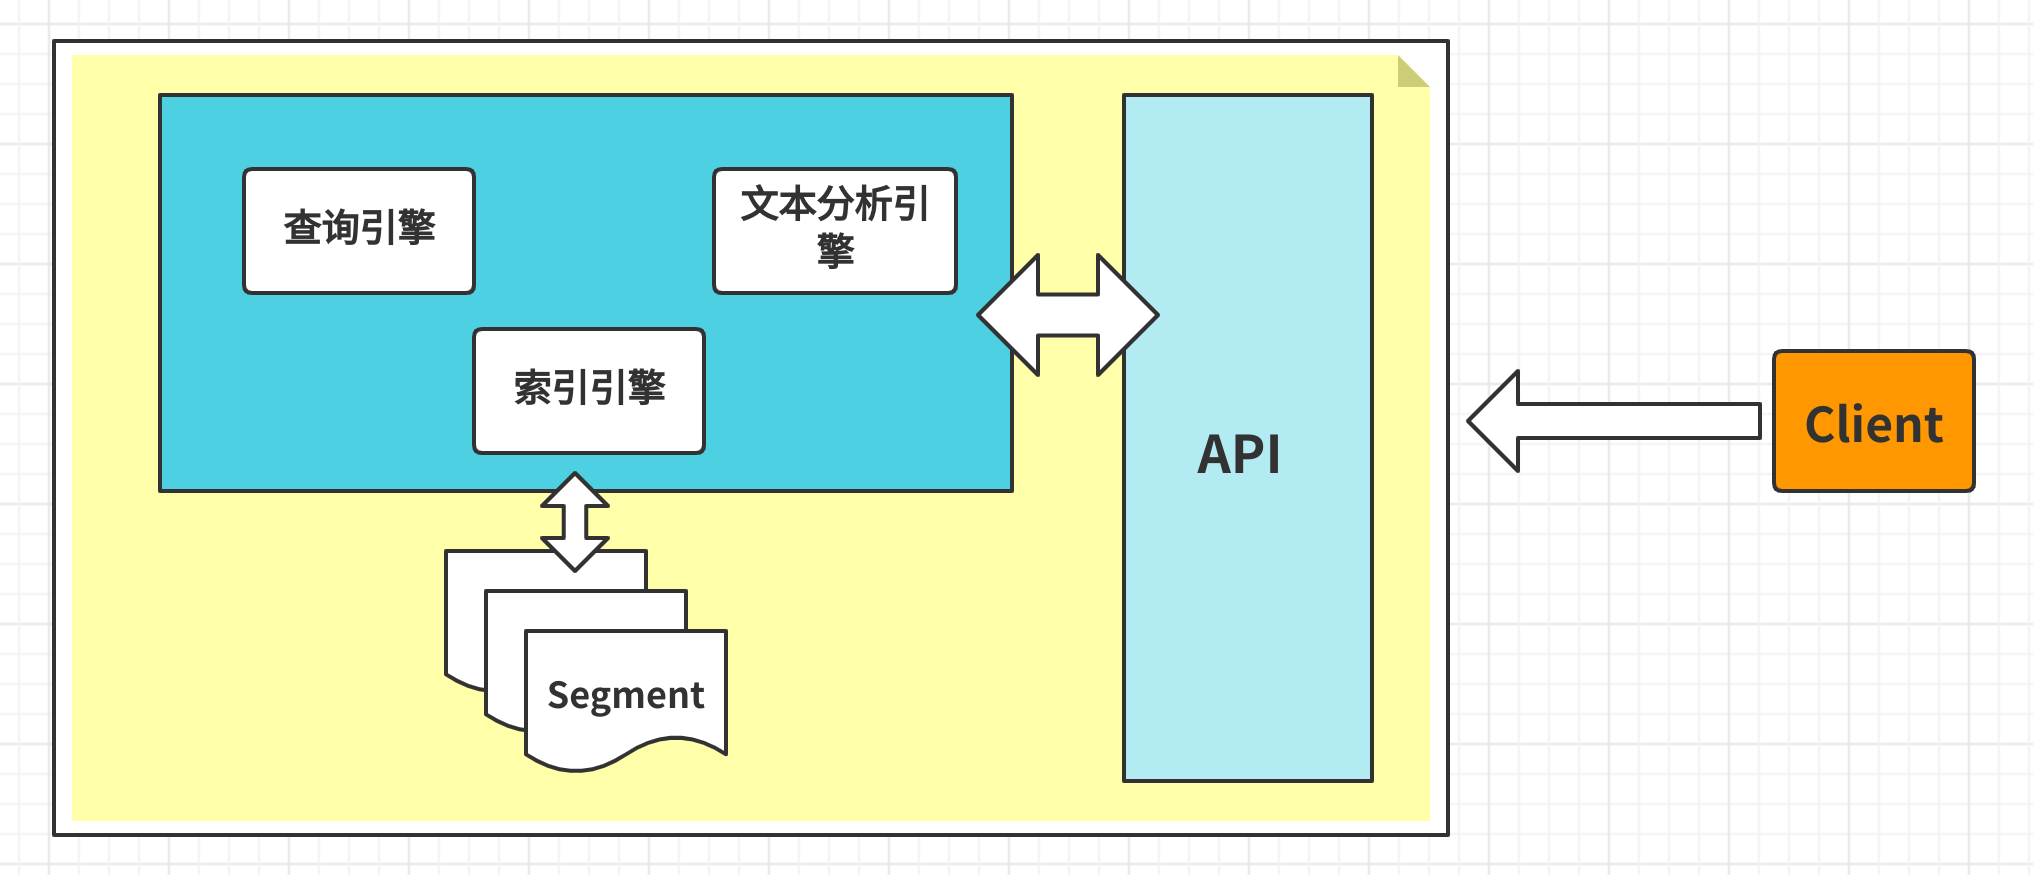
Elaticsearch,简称为 ES,ES 是一个开源的高扩展的分布式全文搜索引擎,是整个 Elastic Stack 技术栈的核心。
Git代码行数统计指南 通过Git命令可统计开发者提交的代码行数、删除行数及净增行数,帮助评估工作量、分析代码质量和监控项目进度。 核心方法: 个人统计:使用git log --author="name" --numstat查看行数变化,结合awk计算总量 时间筛选:添加--since和--until参数指定统计周期 团队统计:循环遍历提交者名单,输出每人贡献量 可视化工具:利
在 IDEA 中部署项目到 GitHub:完整指南本文详细介绍如何通过 IntelliJ IDEA 将本地项目快速部署到 GitHub,适合 Java 开发者及新手参考。可高效完成本地项目到 GitHub 的部署,实现代码托管与协作开发。合理使用 Token 认证和分支管理,能提升代码安全性与协作效率。
Elasticsearch是一个全文检索服务器全文检索是一种非结构化数据的搜索方式结构化数据:指具有固定格式固定长度的数据,如数据库中的字段。非结构化数据:指格式和长度不固定的数据,如电商网站的商品详情。结构化数据一般存入数据库,使用sql语句即可快速查询。但由于非结构化数据的数据量大且格式不固定,我们需要采用全文检索的方式进行搜索。全文检索通过建立倒排索引加快搜索效率。真实开发中我们往往需要对一
处理工作的区域临时存放的区域最终的存放区域在你电脑里看到的目录在.git文件夹内的index中 (二进制记录)指的整个.git文件夹 (也认为是本地仓库)
.gitignore文件的配置说明
在 flush 过程中,内存中的缓冲将被清除,内容被写入一个新的 Segment,Segment 的 fsync 将创建一个新的提交点( Commit Point),并将内容刷新到磁盘,旧的translog将被删除并开始一个新的translog,flush 触发的时机是定时触发(默认30分钟)或者 translog 变得太大(默认512M)时。取决于你的文档的大小,分片的数量和你使用的硬件,给 1
使用 ElasticSearch(简称 es) 的过程中,经常有一些临时查询(如 排查问题、验证效果),一个趁手的可视化工具 可以提高工作效率。个人倾向于 免费(最好开源)、易于安装(如 浏览器插件),`es-client` 就是 比较简单好用的一个,尤其是 查询
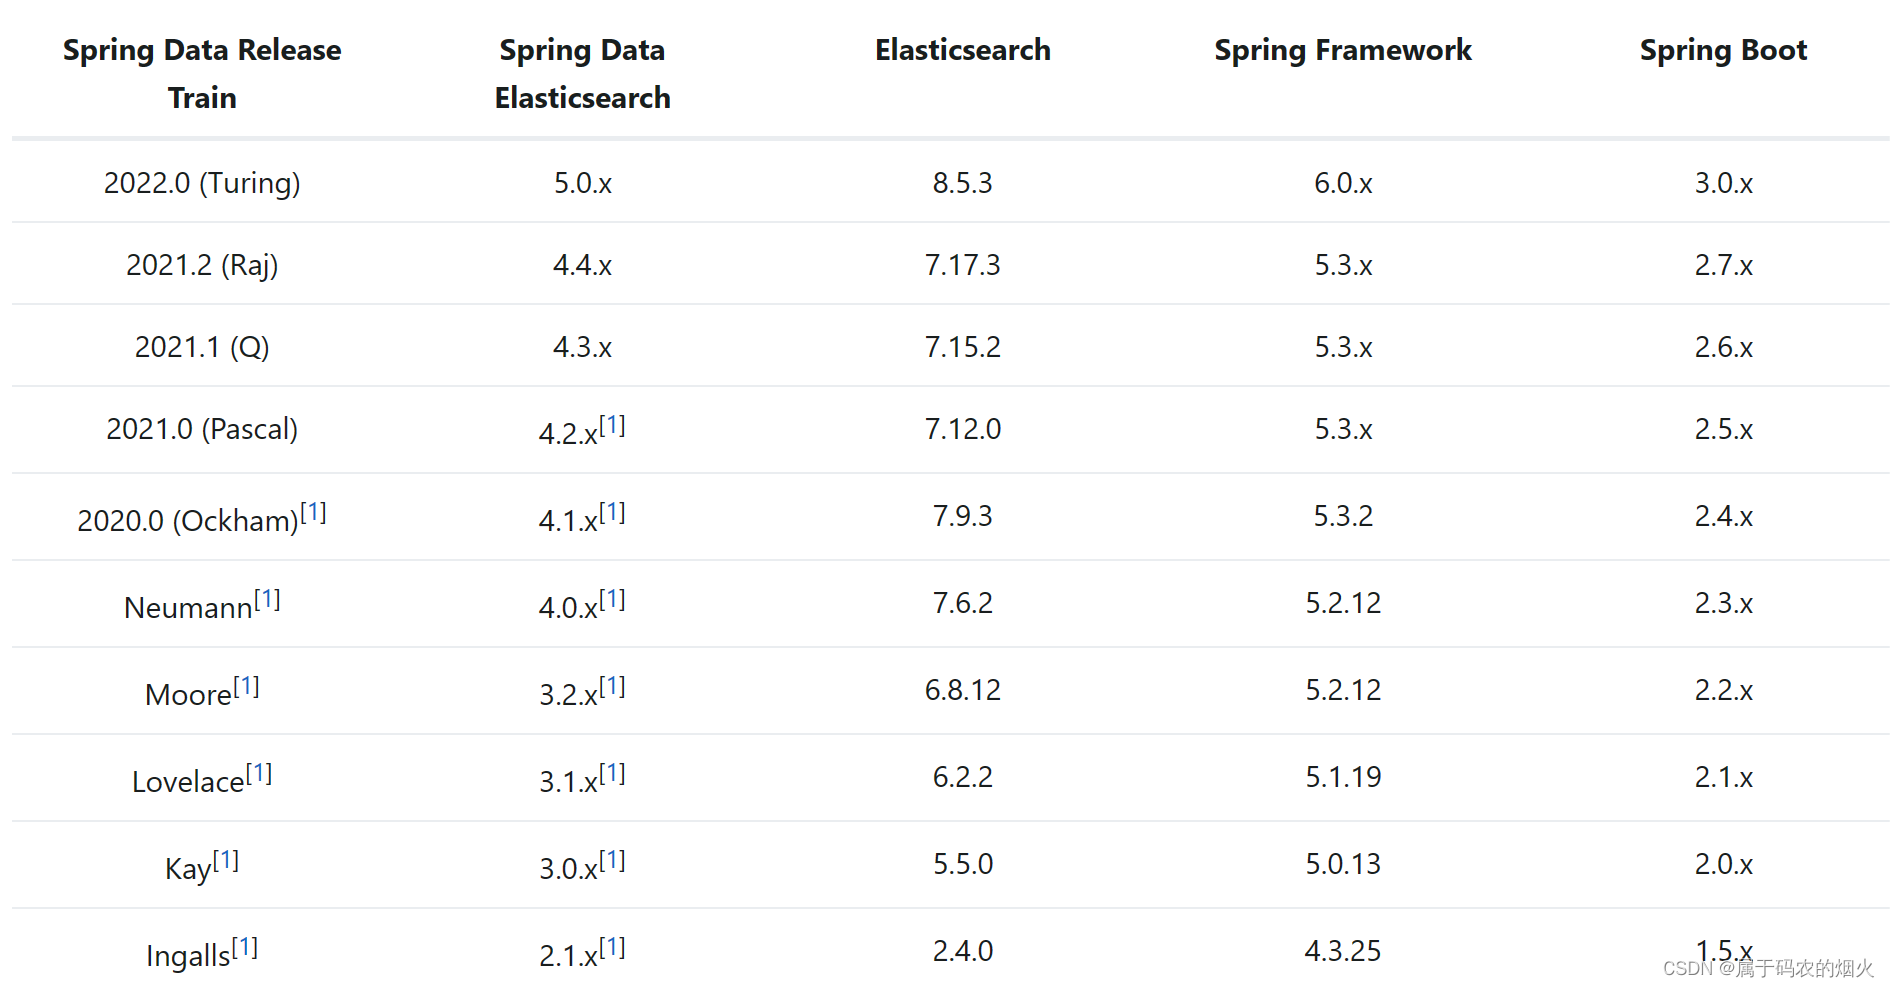
在node安装路径下,使用命令安装:npm install -g grunt-cli 安装grunt。为了避免使用的Elasticsearch版本和SpringBoot采用的版本不一致导致的问题,尽量使用一致的版本。安装过程结束后,在dos窗口查看是否安装成功,使用命令:node -v,出现如下截图,则说明安装成功。es5以上就需要安装node和grunt,所以安装head插件的前提,是需要把该两
【摘自百度百科】Elasticsearch 是一个分布式、高扩展、高实时的搜索与数据分析引擎。它能很方便的使大量数据具有搜索、分析和探索的能力。充分利用Elasticsearch的水平伸缩性,能使数据在生产环境变得更有价值。Elasticsearch 的实现原理主要分为以下几个步骤,首先用户将数据提交到Elasticsearch 数据库中,再通过分词控制器去将对应的语句分词,将其权重和分词结果一并
ElasticSearch 学习万字笔记ElasticSearch adj. 有弹性的;灵活的;易伸缩的全文概述ElasticSearch是一个实时分布式搜索和分析引擎。它让你以前所未有的速度处理大数据成为可能。它用于全文搜索、结构化搜索、分析以及将这三者混合使用:总之,可以对搜索关键字高亮显示,可以对搜索结果纠错,提供建议。并且ELK是大数据必会的技术。本人根据b站狂神说视频“【狂神说Java】
文章目录1 前言2 Linux下安装Elasticsearch2.1 下载安装包2.2 解压缩2.3 解决es强依赖jdk问题2.4 解决内存不足问题2.5 创建专用用户启动ES2.6 修改配置信息允许远程访问2.7 vm.max_map_count [65530] is too low问题2.8 可能遇到的max file descriptors [4096]问题2.9 ES服务的启动与停止3
elasticsearch1.es初识1.1es的功能(1)分布式的搜索引擎和数据分析引擎搜索:百度,网站的站内搜索,IT系统的检索数据分析:电商网站,最近7天牙膏这种商品销量排名前10的商家有哪些;新闻网站,最近1个月访问量排名前3的新闻版块是哪些分布式,搜索,数据分析(2)全文检索,结构化检索,数据分析全文检索:我想搜索商品名称包含牙膏的商品,select * from products wh
你们好,我是Elastic的刘晓国。如果大家想开始学习Elastic的话,那么这里将是你理想的学习园地。在我的博客几乎涵盖了你想学习的许多方面。在这里,我来讲述一下作为一个菜鸟该如何阅读我的这些博客文章。我们可以按照如下的步骤来学习:1)Elasticsearch简介:对Elasticsearch做了一个简单的介绍2)Elasticsearch中的一些重要概念:cluster,n.........
当 GitLab 提示Git 无法判断某些文件到底保留谁的修改,所以需要你手工处理。
图 7:本章总结Vector Store 不负责让模型变聪明。它负责把资料找准。找得准,模型才有机会答得准。找不准,后面的 Prompt 再漂亮,模型也只能胡说。源码层面,它就是一套统一抽象:Document 入库,Embedding 生成向量,VectorStore 保存索引,Retriever 调用检索,最后返回 List[Document]。工程层面,它是一套选型问题:小数据用轻量方案,快速
采用了倒排索引等优化技术,能够实现高效的搜索和数据处理性能,满足大规模数据的实。采用分布式架构,可以轻松处理大规模数据,并支持水平扩展,提高系统的可扩展性。提供了强大的全文检索功能,可以对文本数据进行高效的搜索和分析,支持复杂的。和插件,使得开发者可以轻松集成和使用,同时其查询语法简洁明了,易于上手。提供近乎实时的搜索和分析功能,确保用户能够及时获取最新的数据和信息。支持多种语言的数据处理和检索,
先来三个不虚构的场景: 事故 1:一行改动,全线降级 某 AI 客服系统,有工程师在周五下午悄悄把系统 prompt 里的一句话从"你是一个专业客服助手"改成了"你是一个友好的助手"。周一早上,QA 发现对话质量全面下滑——但没有人知道是这行改动导致的,因为 prompt 只在源码里,git blame 也得先知道去哪找。排查花了两天。
Claude Code 是 Anthropic 推出的命令行 AI 编程助手,深度集成在你的终端中。它能理解整个代码库、执行命令、编辑文件、管理 Git 工作流,帮助你完成从简单问答到复杂重构的各种任务。自定义键盘快捷键,修改。# 重新绑定 Ctrl+S# 添加和弦快捷键。
在 Hermes Agent 中,Skill 可以理解为一种“按需加载的能力说明文档”。它不是模型参数,也不是一个独立程序,而是一组可以被 Agent 读取和遵循的任务说明、流程、命令、模板、注意事项和验证方法。Skill = 可复用的任务知识 + 操作流程 + 必要资源什么时候使用这个 skill;论文结构应该如何组织;摘要怎么写;相关工作怎么写;实验部分怎么检查;常见问题有哪些;最后如何验证输
基于 Lucene 内核开发、由 Elastic 公司维护的分布式、实时、可扩展JSON 全文检索与数据分析引擎,核心开发语言为 Java,兼容多语言客户端接入,是当前互联网主流的开源搜索引擎与时序数据存储分析组件。核心技术特质:天然分布式架构、近实时数据写入与检索、支持水平无限扩容、内置容错高可用机制、无需复杂部署即可实现集群部署,兼顾检索性能、海量数据存储与多维统计分析能力。核心业务能力:主打
通过 Cursor Agent + Claude API,你可以为任何遗留项目自动生成结构清晰、内容完整的文档。这套方案不仅适用于初始文档生成,也适合在代码迭代中持续同步。你不再需要手动整理模块关系、编写枯燥的 API 说明——把这些交给 AI,把精力留给更有价值的架构设计。
《多平台商品搜索与比价系统技术架构》 本文介绍了一个支持多平台数据聚合的智能搜索与比价系统架构,主要包含以下内容: 系统采用分层架构设计,包括前端应用层、服务层、数据处理层和数据存储层,各层级通过标准接口通信。 关键技术选型包括:Spring Boot后端框架、Elasticsearch 8.x支持混合检索、Qwen和SPLADE向量模型实现文本向量化,以及Selenium用于动态页面采集。 数据
会被理解成「新建一个叫 main 的分支」,和你要的改名完全是两回事,所以。分支,并且设置成默认关联(以后直接。就能直接推送到远程,再也不用写。如果你现在已经把本地分支改成。
通过 Cursor Agent + Claude API,你可以在不深入了解遗留代码细节的情况下,安全、快速地完成大规模重构。让 AI 先分析:不要急着动手,先让 Agent 生成拆分方案分步执行:从抽取公共工具开始,再拆分路由测试驱动:要求 AI 同时生成测试,并用测试验证重构结果迭代修复:遇到错误时,直接把错误信息喂给 AI 让它自己修这套方法不仅适用于 Flask,也可以推广到 Expres
本文探讨了**AI编程**从Copilot等辅助工具向**开发Agent**这一智能"同事"角色的深刻转变。这一演进不仅重构了开发工作流,更推动了**人机协同**成为软件开发的新范式,要求开发者从代码执行者转变为任务规划与质量把控者。未来,掌握与AI协作的能力将成为开发者的核心竞争力。
http://my.oschina.net/itblog/blog/547250http://baidu.blog.51cto.com/71938/16767981、ELK由ElasticSearch、Logstash和Kiabana三个开源工具组成。官方网站:https://www.elastic.co/products•Elasticsearch是个开源分布式搜索引擎,它的特点
cursor是AI时代的研发工具,作为『研发工具』,它给了我们一个机会,去结合AI做一些事情。比如:业务分析,整合创新,研发提效等。本文只是『如何启动cursor并能简单使用』的一个"如何起步"的简单说明。如何『用工具创造价值』还有待后续补充。
这篇文章系统讲解了Git日常开发工作流,重点介绍了三个核心命令的使用技巧: git status - 查看仓库状态的最佳实践,包括完整输出解读和简洁模式(-s参数) git add - 从基础用法(./-A/-u)到高级交互式暂存(-p参数),教你精准控制提交内容 git diff - 三种对比模式详解(工作区vs暂存区/暂存区vs仓库/工作区vs仓库) 文章通过实际场景演示了如何: 使用git
摘要 本文介绍了HarmonyOS中的时域AI超分技术实现方案。相比基于单帧图像的空域超分,时域超分通过融合多帧图像信息(利用相机抖动技术)实现更高质量的图像重建。文章详细说明了开发环境要求、项目结构,并重点讲解了使用Vulkan API实现时域超分的关键步骤:包括设备支持检查、创建超分实例、计算相机抖动值(采用Halton序列生成均匀分布抖动)以及具体实现方法。该技术适用于需要高质量图像放大的场