登录社区云,与社区用户共同成长
邀请您加入社区
本文介绍了前端开发中手机号格式校验的正则表达式应用。通过详细的11位手机号正则拆解,说明了对各运营商号段的匹配规则,包括中国电信、联通、移动、广电等号段分布。文章还列出了特殊号段和未分配号段,并建议开发者定期参考工信部最新信息更新校验规则。该正则表达式可应用于用户注册、登录等场景,确保手机号输入的有效性。
正则表达式语法大全,忘了多久写的了。。。。
正则表达式学习笔记前言好久没写文章了,这一次是为了记录最近学习的正则表达式,正则表达式看起来虽然很复杂,但是学会了真的很好用,接下来我将结合具体例子来讲解正则表达式。在介绍正则表达式之前先介绍一个专门为正则表达式练习的网站 https://regex101.com/,大家最好一边学一边练习加深印象,不然记不住(我不练习是真记不住呀 )正文1、什么是正则表达式正则表达式是一组由字母和符号组成的特殊文
COUNTIF 函数会统计指定区域内,符合指定条件的单元格数量。例如统计工资大于指定值的员工数量;统计指定职称的员工数量等。如下图所示,统计“C19:F19”区域中,">10"的单元格数量:01语法COUNTIF(range, criteria)range 必需。 要计数的一个或多个单元格,包括数字或包含数字的名称、数组或引用。 空值和文本值将被忽略。criteria 必需。 定义要进行..
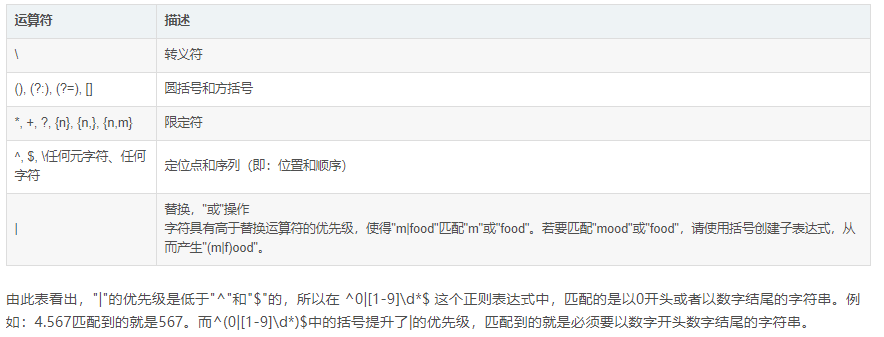
1、表达式全集字符描述\将下一个字符标记为一个特殊字符、或一个原义字符、或一个向后引用、或一个八进制转义符。例如,“n”匹配字符“n”。“\n”匹配一个换行符。串行“\\”匹配“\”而“\(”则匹配“(”。^匹配输入字符串的开始位置。如果设置了RegExp对象的Multiline属性,^也匹配“\n”或“\r”之后的位置。$匹配输入字符串的结束位置。如果设置了RegExp对象的Multiline属
前言:代码百分百手打,无抄袭整理一下思路1.向目标网站发起请求,获取书名,章节,内容2.拿到内容后清洗3.将清洗后的数据存入txt文件用到的库:requests,re目标网站新笔趣阁获取每一本书的url点击全部小说查看源代码寻找书籍url,名称l进入小说详细页查看页面源代码,寻找章节url获取小说详细内容然后清洗,写入txt文件代码贴上,实测可用人头担保????import requestsimp
正则表达式中的*,+,?,^ , $,范围和次数用法1.正则表达式——元字符符号解释.任意字符?0个或1个*0个或多个+1个或多个举例说明:agagagaagagaaaaagaghijklmn例1:/ag./ 中包含符号 .,即会匹配到 任意字符, 故可以匹配上面的agag、agaag、agaaaaag、aghijklmn例2:/ag?/ 中包含符号 ?,即会匹配到 0个或1个g,故可以匹配上面的
正则表达式详解正则表达式 英文名称叫 Regular Expression简称RegEx,是用来匹配字符的一种工具,它常被用在网页爬虫,文稿整理,数据筛选等方面,最常用的就是用在网页爬虫,数据抓取。一、正则表达式的各种符号解释(来自维基百科)~~~是不是感觉太多了,因此我将常用的整理出来了二、进行逐个详解1.首先导入模块import re2.匹配多种可能 使用 []...
首先要记住的是: 正则表达式与通配符不一样,它们表示的含义并不相同!正则表达式只是一种表示法,只要工具支持这种表示法, 那么该工具就可以处理正则表达式的字符串。vim、grep、awk 、sed 都支持正则表达式,也正是因为由于它们支持正则,才显得它们强大;在以前上班的公司里,由于公司是基于web的服务型网站(nginx),对正则的需求比 较大,所以也花了点时间研究正则,特与大家分享下:
public boolean methes(String regex)此方法是:字符串是否匹配给定的正则表达式用法:str.methes(regex);例子1:public static void main(String args[]){String a = "0";String b = "\\d";System.out.println(a.matches(b));
摘要 本文从信息论基础概念出发,系统阐述了熵、交叉熵与KL散度的理论关系及其在机器学习中的应用逻辑: 信息熵作为不确定性度量,量化系统的平均信息量;KL散度衡量两个概率分布的差异,具有非负性和非对称性;交叉熵则作为连接桥梁,其最小化等价于最小化KL散度,成为分类任务的核心损失函数。 在拒绝采样部分,对比了统计学与大模型应用的差异:统计学中是通过辅助分布逼近目标分布,而大模型训练中则是利用奖励模型筛
摘要 语言模型评估指标困惑度(Perplexity) 困惑度(PPL)是衡量语言模型预测能力的核心指标,表示模型预测下一个词时的平均不确定程度。其计算基于条件概率的乘积,通过取对数避免数值下溢,最终取指数得到PPL值。PPL越低,模型预测越准确。公式为:$PPL = \exp(-\frac{1}{N}\sum \log P(w_i|w_{<i}))$。面试中需强调其与交叉熵的关系($PPL = e
文章摘要: 本文探讨了大模型深度思考(CoT)的自主切换技术(AutoThink)与新型优化器Muon。针对CoT的“过度思考”问题,提出三类解决方案:基于规则(熵值/概率差值)、分类模型及多阶段强化学习(AutoThink),后者通过奖励机制动态平衡思考与效率。Muon优化器则通过正交化梯度动量,减少显存占用(仅为AdamW一半)并加速收敛,尤其适合分布式训练。两项技术分别提升模型推理效率与训练
本文对比分析了NLP领域两大里程碑模型LSTM和BERT的核心差异。LSTM作为时序模型,通过门控机制实现序列记忆,但存在串行计算和长程依赖问题;而BERT基于Transformer编码器,利用自注意力机制实现并行全局语义理解。关键区别在于:1)LSTM适合序列生成任务,BERT擅长语义理解;2)BERT支持并行计算和预训练范式,显著提升效率与泛化能力。文章还深入解析了混合专家模型(MoE)架构,
下面把 Codex CLI(OpenAI 那个 codex 命令行)最常见的几类安装报错,按现象+原因+一键修复给你整理好,照着对号入座即可。
DeepSeek推出DeepSeek Sparse Attention (DSA),通过稀疏注意力机制优化长文本处理效率。核心包括闪电索引器(轻量级FP8加速相关性计算)和细粒度Token选择(仅处理Top-k关键Token),显著降低计算复杂度(从$O(L^2)$降至$O(Lk)$)。训练分两步:先密集热身优化索引器,再稀疏训练适配全模型。实测在128K上下文中,推理成本预填充阶段降低50%-6
本文系统介绍了信息检索算法从TF-IDF到BM25的演进历程。TF-IDF通过词频(TF)和逆文档频率(IDF)的乘积衡量文档相关性,但其存在词频线性增长、文档长度偏差和缺乏调参空间三大缺陷。BM25针对这些问题进行了优化:引入k1参数实现词频的非线性饱和,通过b参数进行文档长度归一化处理,有效抑制了高频词堆砌和长文档优势。实战对比显示,BM25能更准确地识别文档相关性,避免TF-IDF的评分偏差
YaRN是一种突破性的大语言模型长文本处理技术,通过创新的"高频外推+低频内插"策略解决了传统位置编码的长度限制问题。该技术将RoPE位置编码的不同频率分量进行分层处理:对高频信息保留精细位置关系,对低频分量采用压缩内插,同时完全保留极端低频分量。相比完全重新训练,YaRN只需少量微调即可实现数倍长度扩展,既保持了绝对位置的确定性,又具备相对位置的灵活性。这种智能的频率分配方案有效避免了位置信息漂
摘要: DeepSeek-V3 引入两大核心技术突破:MTP(多 Token 预测) 和 DCA(双块注意力),显著提升模型效率与长文本处理能力。 MTP:打破传统单 Token 预测模式,通过并行预测未来多个 Token 并验证,实现推理加速(理论提速近1倍)。其训练时强制模型学习长程依赖,推理时通过自投机解码(Self-Speculative Decoding)三步走(预测→验证→采纳)高效生
AI只会输出文字,怎么让它操作文件、打开软件?本篇讲工具系统的设计思路。核心是设计一套AI能学会、程序能读懂的“暗号”——[TOOL]标记协议。AI输出[TOOL] ls(“src”) [/TOOL],程序用正则解析出工具名和参数,通过switch分发到对应函数执行,最后把结果写回对话历史,让AI“看到”自己做了什么。所有工具函数遵守统一契约:返回{success, data/error}。添加新
如果你已经了解了 AI Agent 是什么,那么接下来面试官最爱考的,就是它的。一个完整的 AI Agent 就像是一个高度自动化的“数字员工”,为了能独立完成复杂任务,它必须具备一套完整的“器官”。今天我们来把 Agent 拆开揉碎,看看它到底是由哪几个核心部件组成的!
DeepSeek提出的原生稀疏注意力机制(NSA)通过"压缩、选择和滑动窗口"三大策略优化长文本处理。NSA首先压缩历史文本为关键向量进行粗筛选,然后精选高相关片段细读,同时保留最近上下文的精确计算,最后通过门控机制动态聚合三部分结果。相比传统全注意力机制,NSA显著降低了平方级计算复杂度,在解码、推理等任务上实现最高11.6倍和9.0倍的加速,同时保持模型性能。这种"全局把握、重点精读、强化近期
Your AI remembered wrong?That’s memory decay.Minta checks for stale, conflicting, and fragmented AI memory.All local. No API calls.Claude Code · Cursor · Codex · VS Codegithub.com/xinchen03/minta
https://github.com/xinchen03/minta,欢迎各位一起反馈优化,也麻烦大家点点🌟🌟。诚挚招募团队,一起打磨产品、拓展生态,把这个项目做得更远~重新定义AI记忆管理工具。AI记忆居然也会“生病”感兴趣的小伙伴可以体验/交流!
本文介绍了大模型分布式训练中的关键技术:DeepSpeed ZeRO系列通过分片存储优化器状态、梯度和参数,实现显存高效利用;Sequence Parallel将长文本切分处理降低显存峰值;Expert Parallelism利用MoE架构的稀疏性提升吞吐量。文章还总结了混合并行策略的性能权衡,并列出5个面试核心问题,包括显存优化、通信机制、并发度平衡、MoE路由设计和混合并行拓扑优化。这些技术组
GRPO(组内相对策略优化)是一种改进的强化学习算法,通过组内对比优化策略更新。相比PPO,GRPO的核心创新在于:1)采用组内标准化计算相对优势(A_i^G=(r_i-μ_G)/(σ_G+ε)),激励样本超越组内平均水平;2)完全省去Value模型,大幅节省显存资源;3)通过KL散度约束策略更新幅度。实验表明,GRPO在保持生成质量的同时显著提升训练效率,尤其适合大模型对齐任务。其损失函数结合了
这种数据格式的核心作用是让 DPO 的损失函数(通过对比 chosen 和 rejected 的概率差异)有效优化模型,使其更倾向于生成 chosen 级别的回答。相比之下,PPO 的损失函数考虑了结果整体的分值(霸总逻辑:除非你能拿到高分,否则必须给我守规矩保持结果合理分布),因此在对齐的稳健性上 PPO 通常更胜一筹。DPO 需要的数据与 RLHF 一致,都是经过人工排序后的 QA 语料对。不
PPO(近端策略优化)是一种强化学习方法,旨在优化语言模型生成高质量且分布合理的回答。其核心目标包括:1)保持回答分布与监督微调(SFT)模型相近,防止幻觉;2)提高回答得分。PPO涉及四个模型:Actor(目标模型)、Critic(预期收益计算)、Reward(实际收益计算)和Reference(约束模型)。训练步骤包括:Actor生成回答后,通过多模型评估计算优势(实际收益与预期收益之差),并
本文介绍了大语言模型生成文本时的两种主要推理策略:贪心解码和集束搜索。贪心解码在每一步选择概率最高的token,虽然简单高效但容易导致文本单调重复。集束搜索则保留多个候选序列(beam size=k),通过综合考虑历史分数和当前概率来优化生成质量。文章详细阐述了集束搜索的算法实现,包括候选序列维护、分数计算和终止条件处理,并提供了完整的Python实现代码。这两种策略在平衡生成质量和计算效率方面各
本文通过班级考试的生动故事,通俗讲解了强化学习(RL)在大模型训练中的核心概念。故事中,学生(Actor)通过考试分数获得星星奖励(Reward),班主任(Critic)设置动态基准线评估进步,并引入截断(Clip)防止冒险行为,参考模型(Reference)则记录历史表现保持稳定。这些角色对应了RLHF训练中的四个关键模型:演员模型生成回答,评论家模型评估预期收益,奖励模型计算实际收益,参考模型
摘要:昇腾NPU性能优化关键在于算子库优化而非硬件适配。CANN的ops-nn算子库提供高性能神经网络基础算子(如Conv2D、MatMul、LayerNorm等),通过算子融合技术显著减少显存读写次数。典型场景下,融合算子(如Conv2D+BN+ReLU)可降低55%延迟,提升121%吞吐。ops-nn作为CANN架构第二层,连接上层框架与底层硬件,其优化实现比手动AscendC开发效率高20-
**摘要:**QLoRA技术通过4位NF4量化、双重量化和高秩LoRA适配器,显著降低大模型微调显存需求,使13B模型仅需7GB显存。知识蒸馏则通过教师模型输出Soft Label指导学生模型训练,提升小模型泛化能力。DeepSeek案例显示,词表不一致时可能仅采用SFT微调,凸显高质量数据的重要性。两项技术共同推动大模型在资源受限场景下的应用落地。(149字)
本文介绍了Transformer模型的核心组件及其工作原理。Transformer由Encoder和Decoder两部分组成,其中Encoder包含词嵌入层、多头注意力机制、残差连接和层归一化、前馈神经网络等模块。重点解析了位置编码的必要性、多头注意力机制的计算流程及其设计原理,以及层归一化与批归一化的区别。Decoder部分则采用掩码机制实现自回归生成,GPT等大语言模型采用精简的Decoder
摘要:词向量Embedding是将自然语言转换为计算机可处理的数学表示方法。最初采用One-Hot编码存在维度灾难和无法计算词语相似度的问题。现代方法使用连续向量表示,通过多维特征评分解决这些问题。Word2Vec是典型训练方法,包括CBOW和Skip-gram两种模型。为提高效率,引入负采样技术,将多分类转为二分类任务。这些技术使计算机能有效理解语言语义关系,为自然语言处理奠定基础。(149字)
摘要: Token是文本拆分的最小单元,分词(Tokenizer)将文本拆分为词元(token),便于后续处理。分词有四种粒度: 词粒度:保留完整语义,但词表庞大且易遇OOV问题; 字符粒度:解决OOV但语义稀疏且序列过长; 子词粒度(如BPE):平衡词表与语义,通过合并高频字符对构建词表; 字节粒度(如BBPE):跨语言通用但语义缺失。 BPE通过迭代合并高频字符对优化分词,BBPE进一步扩展至
本文介绍了两种参数高效的轻量级微调方法:Adapter Tuning和LoRA。Adapter Tuning通过在预训练模型各层插入小型适配器模块(仅占全量微调0.5%-5%参数量),冻结主干参数仅训练适配器,实现任务适配。其模块化设计支持多任务共享模型,且不影响推理效率。LoRA则采用低秩矩阵分解技术,为原始权重矩阵添加可训练的低秩补丁(如秩r=4时参数量降至1.2%),通过B·A乘积形式更新参
摘要:Prompt Tuning是一种通过修改输入提示来引导大模型输出的高效微调方法,无需调整模型参数,仅需微调少量提示嵌入(约20K参数)即可适配不同任务。相比传统全量微调(需保存多个11B参数模型),它支持混合任务批处理,显著降低部署成本。类似地,Prefix Tuning通过添加可学习前缀(贯穿模型各层)实现更深层次的适配,在复杂任务中表现更优。这两种方法以极小参数调整激发大模型潜力,为多任
本文介绍了使用逆概率加权(IPW)因果模型分析戒烟对体重变化的影响。通过逻辑回归估计倾向得分,构建平衡的合成人群,结果显示戒烟导致平均体重增加3.52公斤。未调整混杂因素时,效应被低估1公斤。Love图显示IPW有效平衡了协变量分布(平衡后标准化均值差显著降低),验证了模型的有效性。研究表明控制混杂因素对准确估计因果效应至关重要。
有些坑,踩过才知道疼。这一节汇总最常见的正则陷阱,以及用DeepSeek预防和修复的方法。说实话,我写这篇文章的时候,也在回忆自己当年被正则折磨的日子。那时候没有DeepSeek,没有这些AI工具,只能靠硬啃《精通正则表达式》那本砖头书,在Regex101网站上反复调试,在Stack Overflow上翻遍答案。现在的你们,真的很幸运。工具再强,也不能替代你对需求的理解、对边界的思考、对质量的把控
本文展示了在因果分析中使用自定义后端进行样本匹配的方法。主要内容包括: 使用Faiss后端替代scikit-learn的NearestNeighbors,在Lalonde数据集上实现了5倍以上的速度提升(从约2分钟缩短至20秒)。 介绍了如何通过knn_backend参数指定自定义后端,支持直接传入类名或实例化对象两种方式。 提出了倾向得分对数比距离函数,通过log(x/(1-x))转换解决原始差
本文全面梳理了大语言模型(LLM)的主流评估方法。基础评估包括文本相似度指标(BLEU、ROUGE、编辑距离)和语言模型内在性能指标(困惑度)。针对长文本处理能力,介绍了"大海捞针"测试方法。此外,重点分析了综合评测基准体系,涵盖中文/通用模型评测(SuperCLUE、C-Eval)、国际权威榜单(Open LLM Leaderboard、Chatbot Arena)以及专项能力评测(MMLU、G
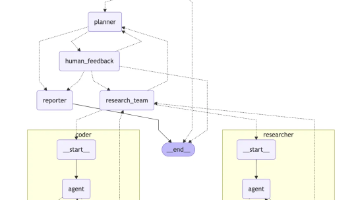
摘要: Deep Research(深度研究)是AI领域的新范式,通过结合检索探索、结构化分析与报告生成,将零散信息转化为连贯的长篇分析报告。其核心架构分为规划、执行和合成三步骤,利用不同模型优化算力分配。开源框架如ByteDance的DeerFlow(多智能体协同)、LangChainAI的OpenDeep_Research(规划-搜索-反思-撰写)和SkyworkAI的Deep_Researc
在现代的推荐系统或 RAG(检索增强生成)业务中,我们不可避免地需要用到检索。最简单直接的方法是将用户的 Query 向量与数据库中的每一个向量进行遍历对比,这被称为“暴力计算”。这种方法精度最高,但效率极低,且面临着非常严峻的。让我们算一笔账:假设一个向量用 1024 维的float32(4字节)表示,那么单个向量的内存占用就是4Byte×1024。1000w×4Byte×102438GB暴力计
本文介绍了异质效应混合模型(HEMM)在治疗效果估计中的应用。HEMM通过假设数据中存在潜在子群,利用有限混合模型来识别异质性治疗效果,提高模型可解释性。研究使用合成数据验证HEMM性能,通过均匀采样生成特征变量X和治疗变量T,并模拟不同子群对治疗的不同响应。实验结果表明,HEMM能有效估计个体治疗效果(ITE),在样本内和样本外均获得较低的精确异质性效应指标(PEHE),验证了其在发现治疗异质性
线控转向失效下的容错差动转向控制以四轮轮毂电机驱动智能电动汽车为研究对象,针对线控转向系统执行机构失效时的轨迹跟踪和横摆稳定性协同控制问题,提出一种基于差动转向与直接横摆力矩协同的容错控制方法。该方法采用分层控制架构,上层控制器首先基于模型预测控制方法求解期望前轮转角和附加横摆力矩,然后设计基于滑模变结构控制的前轮转角跟踪控制策略,下层控制器以轮胎负荷率最小化为目标,利用有效集法实现四轮转矩优化分