登录社区云,与社区用户共同成长
邀请您加入社区
英伟达全家桶安装指南本文提供了Linux(Ubuntu)、Windows和WSL2环境下安装最新版英伟达驱动及相关工具的全套方案。安装完成后,作者提供了详细的验证方法,包括版本检查、编译测试及常见问题解决方案。本文包含3万多字详细配置记录,适用于不同平台需求,建议读者按需参考对应章节。
Dify离线插件本地打包与部署教程 本文详细介绍了Dify 1.0版本后在离线环境下部署插件的解决方案。针对OpenAI-API-compatible插件,通过本地重新打包(使用dify-plugin-repackaging工具)和修改Dify配置文件(关闭签名验证FORCE_VERIFYING_SIGNATURE=false)的方式,解决了离线安装时出现的网络不通和空指针异常问题。关键步骤包括:
Kaggle平台在线GPU使用教程,详细版
首先庆祝踩坑踩了一万个的我终于搞懂TensorBoard的原理了,是我太蠢了!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!首先说明一下Tensorboard是个神马东西,官方给出的声明:TensorBoard是一个可视化工具,它可以用来展示网络图、张量的指标变化、张量的分布情况等。特别是在训练网络的时候,我们可以设置不同的参数(比如:权重W、偏置B、卷积层数、全连接层数等),使用T
TensorLayer是一个基于TensorFlow的开源深度学习库,解决了Keras灵活性不足和TensorFlow编码繁琐的问题。它提供高层API实现快速建模,同时保持底层透明性,支持灵活修改。性能与原生TensorFlow相当,文档完善且社区活跃,覆盖学术和工业界用户。目前已升级为多后端框架TensorLayerX,支持TensorFlow、PyTorch等6种框架及多种硬件,建议新用户直接
📌 TensorFlow 训练模型常见导入总结。
输入↓第一层↓第二层↓输出x = 1.57输入Tensor↓隐藏层Tensor↓输出Tensor这些过程数据都需要内存存放。
本文将演示石头剪刀布图片库的神经网络训练过程。包含了不同的手势图片,来自不同的种族、年龄和性别。注意:指定目录根据自己的实际情况设定。若wget无法下载,尝试使用浏览器手动下载!然后解压下载的数据集。检测数据集的解压结果,打印相关信息。各打印两张石头剪刀布训练集图片调用TensorFlow的keras进行数据模型的训练和评估。Keras是开源人工神经网络库,TensorFlow集成了keras的调
TensorFlow Serving 不是一个新工具,但它解决的问题很实在。模型训练只是第一步,怎么把模型稳定地放到生产环境里持续服务,才是工程团队要长期面对的挑战。它提供了完整的生命周期管理和版本控制机制,对需要在生产环境部署 TensorFlow 模型的团队来说,是一个成熟且经过验证的选择。队要长期面对的挑战。它提供了完整的生命周期管理和版本控制机制,对需要在生产环境部署 TensorFlow
全连接层分类:将提取的特征展平,通过全连接层进行分类,输出10个类别的概率分布,最终通过softmax函数得到预测结果。对输入的手写数字图像进行归一化处理,将像素值缩放到0到1之间,确保数据的一致性和模型的稳定性。利用先进的卷积神经网络技术,算法具有极高的识别准确率,确保每个手写数字都能被准确识别。提供直观的结果展示,每次识别的结果都能通过图像展示,方便用户查看和验证。多层卷积操作用于提取图像中的
GPflow是基于TensorFlow的高斯过程建模开源库,提供模块化的核函数、似然函数和推断方法组合。它利用TensorFlow的自动微分和GPU加速能力,支持Python 3.7+,安装简单。文档完善,社区活跃,适用于空间插值、时间序列预测等任务。作为成熟的高斯过程工具,GPflow适合需要概率建模的研究者和工程师,但要求用户具备一定理论基础。其模块化设计和TensorFlow底层支持使其在性
本文介绍了一个基于深度学习的人脸性别年龄识别系统。该系统采用卷积神经网络(CNN)架构,使用TensorFlow和Keras框架实现。系统主要功能包括:通过人脸图像预测性别(二元分类)和年龄(回归分析)。关键技术步骤包括:1)数据预处理(图像缩放、归一化);2)构建双输出CNN模型(共享特征提取层,分别输出年龄和性别预测);3)模型训练与评估(采用MAE评估年龄预测,准确率评估性别分类)。文章提供
↓tf_keras缺失↓升级 TensorFlow 2.14↓tf-slim case/cond 不兼容↓手动补丁修复↓训练启动↓↓定位到 XLA↓发现缺少 CUDA Toolkit↓安装 nvidia-cuda-toolkit↓配置 XLA_FLAGS↓训练恢复正常TFRecord 数据正常pipeline.config 正常SSD 模型正常根因是 TensorFlow XLA 无法找到 lib
在机器学习中,我们有两个常用的运算库(TensorFlow 和 Numpy),由于库的开发与发展历史的种种原因,他们有着不同的数据形式。用一个外层中括号表示数组,内层的中括号表示数据,每一个内层中括号表示一个数据,而内层中括号中数字的个数表示了数据维度的大小。再者就是数据维度的变换了,在数据训练的过程中,我们常见到对数据维度的变换。所以,当我们去处理数据的时候需要使用 Numpy ,而在模型训练的
为了获得更加稳健的深度学习训练模型,一些庞大的训练在个人电脑上无法实现,本文主要以在LiCO中实现tensorflow2.0-gpu训练模型为例,为读者提供参考,若文档存在问题,请读者提出宝贵的意见。提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档文章目录一、在ubuntu中下载docker二、利用docker下载镜像三、构造自己的容器四、修改容器名,生成镜像五、发布自定义镜像六、
在本地部署大语言模型时,很多开发者往往会陷入“环境配不通、权重下不动、跑起来就爆显存”的困境。尤其是面对参数量巨大的模型,如何在有限的硬件资源上实现流畅推理,同时保证对话的连贯性和响应速度,是一个极具挑战性的工程问题。很多时候,我们并不是缺乏算力,而是缺少一套系统化的落地方案,从环境构建到显存优化,每一个环节的疏忽都可能导致整个项目停滞不前。如果你正打算将开源大模型集成到自己的应用中,或者希望在本
本文介绍了使用Python和TensorFlow/Keras实现图像识别的完整流程。首先讲解环境配置和图像预处理方法,包括RGB转换、尺寸调整和归一化处理。然后提供两种解决方案:1)直接使用MobileNetV2等预训练模型进行零训练识别;2)通过迁移学习自定义训练模型,详细说明数据增强、模型构建、训练调优和评估预测等步骤。文章还涵盖模型保存部署、常见问题解决和模型选择建议,特别强调了预处理匹配、
lanenet模型的复现文章有很多,原文的代码是基于tensorflow1.0版本实现的。本文将在以tensorflow2.0版本为后端的keras上对lanenet模型进行复现,实现细节和原文有出入,但是实现目的和原文是一致的。希望读者能够为本文提出宝贵的建议。
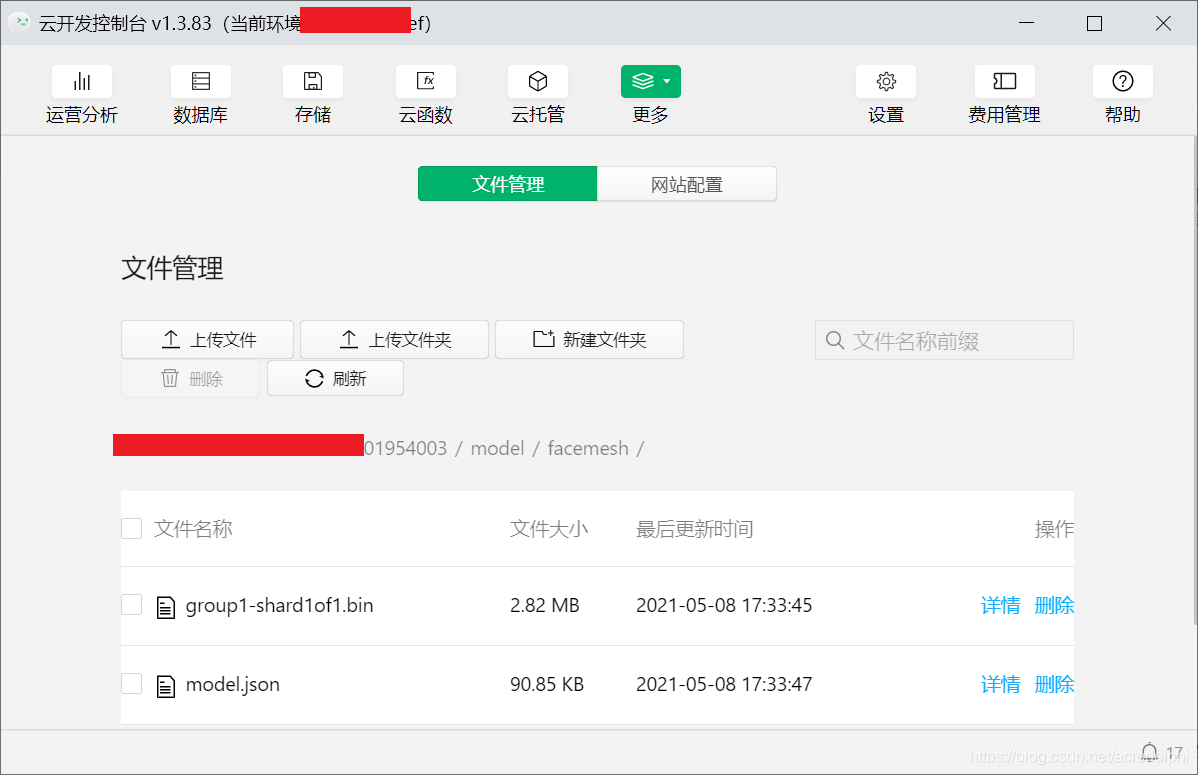
做人脸识别,先要获取面部特征,然后提取面部图片。https://www.npmjs.com/package/@tensorflow-models/face-landmarks-detection查看这个包的源码,发现要下载3个模型文件:facemesh:https://tfhub.dev/mediapipe/tfjs-model/facemesh/1/default/1iris:https://t
PyTorch是Meta开源的深度学习框架,凭借Python风格语法、动态计算图和丰富生态成为新手入门首选。本文提供PyTorch快速安装指南(10分钟完成CPU版本搭建),详解三大核心知识点:张量、自动求导和神经网络模块,并附MNIST手写数字识别完整实战代码。针对常见报错给出解决方案,推荐从基础到进阶的学习路线。PyTorch以其易用性和强大功能,已成为学术界和工业界的标准工具,是深度学习入门
昇腾CANN开源社区通过两个核心仓库(community和cann-agreements)规范贡献流程。贡献者需先签署CLA协议,遵循从Fork到Merge的7步生命周期:签署CLA→Fork仓库→开发测试→提交PR→CI检查→Reviewer审查→Maintainer合并。常见问题包括未签CLA导致PR被拒、缺少DCO签名、PR包含不相关改动等。社区要求代码规范、测试覆盖、commit mess
本文深入解析了CSS背景与边框的两个核心任务,通过构建层次感卡片标题和装饰性卡片,展示了关键技术的实战应用。第一部分重点讲解了边框简写、背景尺寸控制(cover vs contain)以及半透明背景增强文字可读性的技巧。第二部分则演示了如何利用border-radius四值语法创建不对称圆角,并通过CSS多重背景功能实现复杂的星星图案布局。文章特别强调了rgba()透明度控制、background
昇腾NPU驱动采用分层架构实现PyTorch调用NPU执行模型。驱动位于CANN架构最底层,分为HDF(驱动框架)、HDK(硬件开发工具包)和Runtime Library(用户态接口)三层。HDF定义驱动标准框架,HDK提供开发工具,Runtime Library是上层框架调用接口。驱动版本不匹配会导致NPU不可用,因为各层接口需要严格兼容。驱动作为硬件抽象层,是连接软件栈与物理硬件的关键桥梁,
本文分享了在4张Ascend 910 NPU上微调GLM-4-9B模型时遇到的三大性能瓶颈及优化方案。原生的HuggingFace Trainer实现存在数据加载CPU瓶颈、hccl梯度同步延迟高和显存碎片化问题,导致吞吐仅340 tokens/s。通过采用cann-recipes-train工具链,使用NPU原生数据加载器、优化hccl通信拓扑和显存池化管理,最终将吞吐提升至1120 token