登录社区云,与社区用户共同成长
邀请您加入社区
本文围绕抽奖系统UI自动化测试展开全流程实践分享,核心介绍如何基于Java+Selenium+WebDriverManager技术栈,搭建一套高效、可维护的自动化测试框架。全文遵循Page Object设计模式,将系统各页面操作封装为独立测试类,覆盖登录、奖品管理、人员管理、活动创建、抽奖执行等核心业务流程,同时针对自动化测试中的常见难点提供可落地的解决方案。
本文档为抽奖系统测试报告,该系统基于SpringBoot+MySQL前后端分离架构,包含用户登录、活动/奖品/人员管理和抽奖等核心功能。测试覆盖功能、兼容性、性能及安全性等方面,采用Selenium、Postman等工具。结果显示系统运行稳定,在Chrome/Firefox/Edge等浏览器兼容性良好,页面平均响应时间合理,发现10个缺陷(20%高危)均已修复。建议增加活动模板、结果导出功能,优化
本文介绍了抽奖系统UI自动化测试的实现方案。测试基于SpringBoot+Selenium4.0框架,使用WebDriverManager自动管理浏览器驱动版本,配置了6秒隐式等待和60秒显式等待策略。核心工具类实现了随机测试数据生成(手机号、QQ邮箱)和自动化截图功能。测试逻辑覆盖登录/注册模块的异常场景验证、管理员模块的iframe切换和多场景测试(人员管理、奖品管理、活动管理),并设计了全流
本文系统介绍了软件自动化测试的核心概念与应用。主要内容包括:1)自动化测试的定义与局限性,强调其不能完全取代人工测试;2)测试分类(接口、UI、Web等)及典型应用场景;3)测试金字塔理论,分析理想模型与企业实践的差异;4)Web自动化测试原理,重点讲解驱动机制和Selenium工具链。文章通过百度搜索案例,详细展示了Selenium+WebDriver+浏览器的协同工作原理,并介绍了WebDri
本文提供了最新Chrome与Selenium兼容的完整解决方案。主要内容包括:如何查看Chrome版本号(chrome://version/);不同版本驱动下载方法(114及之前通过官网,117+通过测试专用页面);安装配置步骤(解压驱动到安装目录并设置环境变量);以及常见闪退问题的处理方法(selenium版本兼容性和全局变量定义)。通过Python测试脚本验证安装成功与否,确保自动化测试环境顺
• 需在 IE 的「Internet 选项」中取消勾选「启用保护模式」并设置缩放为 100%。• 若启动报错,优先检查浏览器与驱动版本是否匹配,必要时降级浏览器或更新驱动。• 内置驱动,无需额外下载,但需在「偏好设置」中启用「允许远程自动化」。• 使用 ChromeDriver,需在代码中指定浏览器和驱动的路径。:需与 Chrome 浏览器版本对应,可通过浏览器地址栏输入。• 选择与 Firefo
Google ChromeDriver 分享 谷歌浏览器驱动 谷歌驱动
本文主要介绍了在使用Python自动化Web浏览器背景下,Microsoft Edge浏览器的下载配置流程。首先查看当前浏览器的版本,然后到官方网站下载对应的驱动器,接着将下载好的驱动器exe文件放到python解释器对应文件目录内,最后运行Python脚本成功打开Edge浏览器。
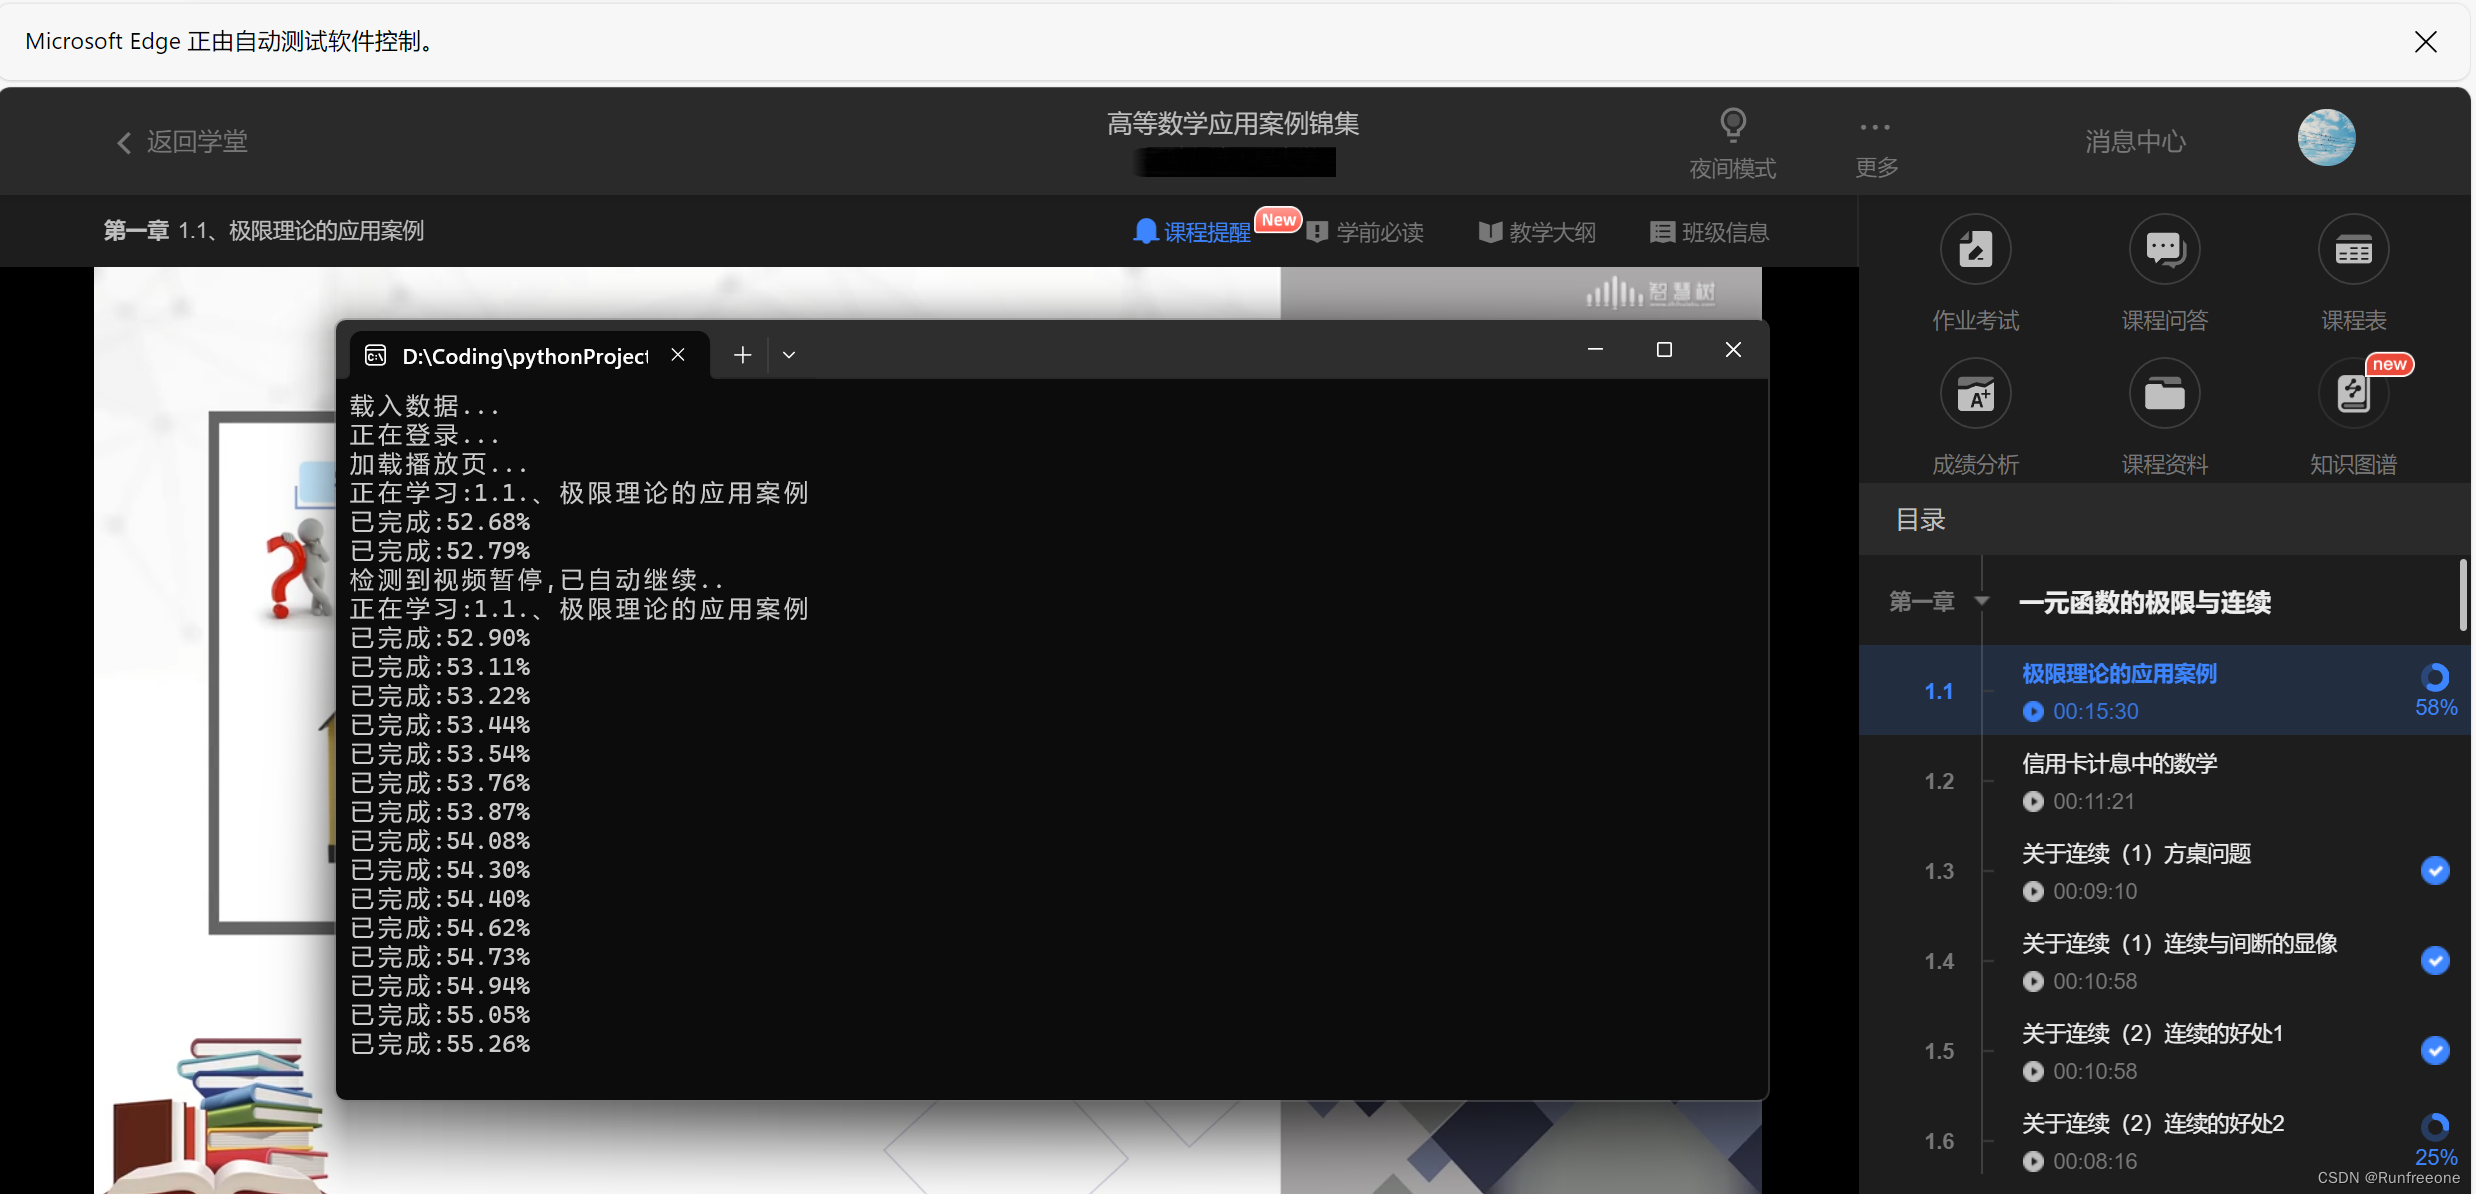
这是一个自动化的智慧树刷课程序,由Python和JavaScript编写而成。相对于油猴脚本,本程序可有效防止被网页检测, 核心原理是使浏览器模拟用户的点击操作, 不会导致封号等问题。
3.在环境变量设置中,找到名为“PATH”的变量,并在其值中添加ChromeDriver的路径。例如,如果将ChromeDriver解压缩到“C:\chromedriver”(Windows)或“/usr/local/bin/chromedriver”(macOS / Linux),则需要将该路径添加到PATH变量中。请记住,确保下载与Chrome浏览器版本匹配的ChromeDriver,并将其正
ChromeDriver的官方下载页面,获取ChromeDriver的最新版本。
Fiddler抓取App端请求准备工作:将手机和电脑连接到同一路由器(保证两者能够ping通);如果使用的模拟器则不需要上面的步骤,因为模拟器是共享PC端的网络,两者网络默认就是连通的状态;查询PC端的IP地址;配置fiddler可以抓取远程端设备请求。
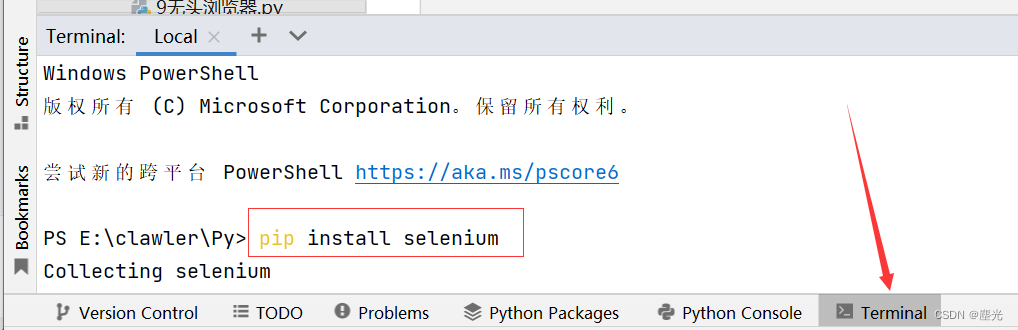
安装selenium(超级详细),以及安装过程中可能报错的问题解决方案
Selenium是广泛使用的模拟浏览器运行的库,它是一个用于Web应用程序测试的工具。Selenium测试直接运行在浏览器中,就像真正的用户在操作一样,并且支持大多数现代 Web 浏览器。
实践详细说明Page Object 是基础,AI 是增强层AI 不能替代良好的架构设计,它让好架构变得更好AI 定位作为第二路径,不是唯一路径有显式定位器时优先使用,能避免 95% 的 AI 调用不做全量 AI 替代只在异常时触发 AI,而非每个元素都走 AI 定位一定要有 Mock 模式没有 API Key 时框架必须可用,这是 CI 不可达环境的基础AI 不是在"替代"测试工程师,而是在"解放
📉 GitHub 上 Selenium 相关的 Issues 增速同比下降 40%📊 Stack Overflow 上 Selenium 标签的提问量连续 3 年下滑🚀 新兴 AI 测试框架 Midscene、Applitools、Testim、UiPath,90% 都不把 Selenium 作为首选方案💀 更扎心的是:2024 年招聘市场上,「Selenium 工程师」岗位减少 35%,
pytest-selenium是一个将Selenium浏览器自动化功能集成到pytest测试框架的插件,支持Chrome、Firefox等主流浏览器。它简化了测试流程,自动管理浏览器生命周期,提供失败截图和源码捕获功能。安装简便(pip安装),支持本地和远程(Selenium Grid)测试,可生成HTML报告,并适配CI环境的无头模式。通过内置fixture,开发者能直接调用浏览器实例编写测试,
做网页自动化这几年,踩过的坑比写的代码还多。去年帮公司做一个财务对账系统,每天登录内部系统、识别发票图片、汇总 Excel,本以为 Selenium + OCR 就能搞定,结果交付时客户问"能不能打包成双击就能用的软件"。后来调研了一圈国产工具,发现蓝印 rpa这类产品把网页自动化、AI 识别、打包分发整合得挺完整,走的是本地离线路线。不过本文先不聊工具,我们从 Python 源码层面把 RPA
本文介绍了Selenium中鼠标操作的实现方式,主要通过ActionChains类完成。内容包括:1)鼠标操作需要调用ActionChains类;2)常用鼠标操作方法如右击(context_click)、双击(double_click)、拖动(drag_and_drop)、悬停(move_to_element)等;3)每个方法的调用步骤:导入类→实例化对象→调用事件方法→执行perform();4
本文介绍了Selenium中的窗口切换和元素等待技术。主要内容包括:1)通过窗口句柄实现多窗口/标签页切换,使用current_window_handle和window_handles获取句柄;2)三种等待机制:显示等待(WebDriverWait配合expected_conditions)、隐式等待(implicitly_wait全局设置)和强制等待(time.sleep),分析各自特点和适用场
各位程序员兄弟姐妹们好,我是你们的老朋友。你花了那么多钱订阅的 AI,到底帮你干了什么?写个邮件?查个 API?解释一段代码?恭喜你,你正在用一台"装了火箭发动机的拖拉机"来送快递。AI 最强大的能力——自主行动——被你白白浪费了。你问 AI:“帮我看看这个文件有什么问题” → AI 说:“请把文件内容贴给我” → 你手动复制粘贴 → AI 分析完 → 你手动改你问 AI:“帮我搜一下这个库的最新
各位测试工程师朋友们,让我猜猜你的日常:凌晨三点,你睡得正香,手机突然炸了。钉钉消息 99+,微信群里 @ 了你八百遍,邮件标题赫然写着——“线上回归测试全挂了!!!”你一个鲤鱼打挺从床上跳起来,打开电脑,颤抖着点开测试报告,发现 200 个用例挂了 87 个。你心里一凉:“完了完了,是不是线上出 Bug 了?”结果排查了半小时发现——前端同事把「登录」按钮的从改成了 。就这?就这。一个驼峰命名的
2026年Web自动化三大工具(Playwright、Puppeteer、Selenium)对比分析显示:Playwright凭借多浏览器原生支持、轻量级架构和领先的AI集成(如自然语言驱动、自动修复)成为新项目首选;Puppeteer在Chrome专属场景和底层控制方面保持优势;Selenium则依靠标准化协议和企业级生态在传统市场占据地位。性能测试中Playwright最快(电商登录测试2.5
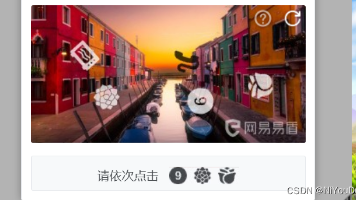
文章介绍了使用图灵在线验证码识别平台(http://tulingcloud.com)快速解析易盾符号点选验证码的方法。相比人工打码平台12秒/次的响应速度,该平台能实现秒级返回结果。作者提供了Python调用代码示例,只需传入账号密码和图片路径即可使用特定模型ID(25998073)进行识别。该服务支持直接官网测试,具有速度快、准确率高的特点。(150字)
摘要: Selenium 是浏览器自动化领域的开源标杆项目,自2004年诞生以来持续迭代,支持多语言(Java/Python/JS等)和全主流浏览器(Chrome/Firefox等)。其核心通过WebDriver协议统一指令,实现表单填写、数据抓取等自动化操作,并凭借分布式测试框架Grid提升效率。尽管面临Puppeteer等新工具竞争,Selenium凭借语言兼容性和跨浏览器支持,仍是大厂多技术
unittest会自动化识别test开头的函数是测试代码,如果你写的函数不是test开头,unittest是不会执行这个函数里面的脚本的,这个千万要记住,所有的测试函数都要test开头,记住是小写的哦。最后结尾处的unittest.main(),添加这个是支持在cmd,里面,cd到这个脚本文件所在的目录,然后python 脚本名.py执行,如果不添加这一段,是无法执行cmd里面运行脚本的,在PyC
本文摘要介绍了UI自动化测试中的三个关键技术点: 等待机制:包括强制等待(time.sleep)、隐式等待(driver.implicitly_wait)和显式等待(WebDriverWait),用于处理网络延迟或元素加载问题,确保脚本稳定性。 文件操作:上传文件可通过input标签直接传路径或借助AutoIT工具;下载文件需配置浏览器参数(如指定目录)。 验证码处理:提出五种方案:去除验证码、设
Selenium 4.44.0 没有对定位能力做减法,核心改变只是统一了API写法,同时新增了相对定位提升定位灵活性,原有的定位策略逻辑没有变化,仅需要调整语法格式即可迁移。声明:以上内容,部分来自AI总结,仅供参考。
本文介绍了WebDriver API在自动化测试中的应用,重点讲解了鼠标键盘操作、iframe切换和下拉列表框处理等模块。WebDriver API提供了简洁的面向对象接口,支持动态网页测试,通过ActionChains类实现鼠标右键、双击、拖拽等操作,Keys类处理键盘事件。针对iframe嵌套,使用switch_to.frame()切换框架,switch_to.default_content(
创建python@dataclass"""上市公司公告数据模型"""announcement_id: str# 公告ID(唯一标识)stock_code: str# 股票代码stock_name: str# 股票名称title: str# 公告标题announcement_time: datetime # 公告发布时间。
在量化投资和财务分析领域,上市公司的财务数据是最基础也是最重要的数据来源。无论是进行基本面分析、构建估值模型,还是监控行业趋势,准确、及时的财务指标都是决策的关键。网易财经作为国内主流的财经门户网站,提供了丰富的上市公司财报数据,包括利润表、资产负债表、现金流量表等核心报表的关键指标。然而,手动复制粘贴成百上千家公司的财务数据显然不现实。Python爬虫技术为我们提供了自动化获取这些数据的可能性。
aid:视频的AV号对应的数字ID,例如av123456的aid就是123456。现在主流使用BV号,但API内部依然使用aid。cid:视频分P对应的评论ID,每个分P有自己的评论池。获取评论前必须先拿到cid。B站未公开proto文件,但可以通过反编译或社区逆向得到。以下是最新的protobuf。
Playwright 由微软开源,自动管理浏览器驱动、内置浏览器指纹伪装、自带网络拦截、异步多浏览器内核,相比 Selenium 启动更快、资源占用更低、原生规避 webdriver 检测,完美适配 Vue/SPA 单页、动态接口加密、JS 强校验站点。本章实现无头静默抓取、请求拦截抓接口、Cookie 注入、代理 + UA 动态轮换、懒加载滚动采集,无缝对接前期代理池、UA 池、Cookie 池
摘要 本文系统介绍了微软开源的现代化端到端测试框架Playwright,对比其与Selenium、Cypress的优劣势,并提供完整实战指南。核心内容包括: 核心优势:支持Chromium/Firefox/WebKit三大引擎,内置自动等待、并行测试、移动端模拟等特性,测试效率提升5倍以上 实战演示:从环境搭建到编写首个测试用例,详解Locator定位策略与Action操作,推荐PageObjec
选用亿牛云固定转发代理的核心优势:代理IP有效期1-3分钟,适配浏览器页面完整加载、JS渲染、交互操作全流程,单通道独立账号密码认证,可保障单次会话IP一致性,避免动态IP切换导致的页面请求中断、会话失效问题,完美适配Selenium自动化场景。整合反指纹浏览器、真人行为模拟、分页采集、结构化数据提取、数据导出全流程能力,搭建高可用、可复用的智能爬虫框架,支持分页批量采集、数据去重、CSV标准化导
想象一下面包店的场景:面包师(生产者)不停地制作面包,放入柜台(缓冲区),顾客(消费者)从柜台取走面包。如果面包做得太快,柜台堆满,面包师就得等待;如果顾客吃得太多,柜台空了,顾客就得等待。在爬虫世界里,生产者负责生产任务(URL链接),消费者负责处理任务(请求网页、解析数据、持久化存储)。两者通过一个线程安全的队列进行解耦。为什么要解耦?如果没有队列,生产者必须等待消费者完成当前任务才能生产下一
大概三个月前,我接了一个有点头疼的需求:需要从某电商平台抓取大约50万件商品的价格和库存信息。如果按照传统方式,用requests库写一个循环,逐个请求,每秒钟顶多能处理3-5个请求。算下来,光是网络IO等待时间就要花掉将近30个小时。更糟糕的是,目标网站对单IP的并发连接数虽然限制不算严格,但对请求间隔很敏感——如果请求间隔不固定,很容易触发反爬机制。我需要一种既能提高抓取速度,又能灵活控制请求