登录社区云,与社区用户共同成长
邀请您加入社区
《字节跳动 Agent 实践手册》系统构建了 Agent 技术从理论到实践、从技术到业务的完整指导体系,全面覆盖字节跳动 Agent 技术应用的核心维度。
本篇给大家介绍一下RAGFlow的本地搭建,以下过程基于Ubuntu24,其它Linux系统的搭建方法也基本相同。先来温补一下,RAGFlow是一个基于对文档深入理解的开源 RAG(检索增强生成)引擎。它的作用是可以让用户创建自有知识库,根据设定的参数对知识库中的文件进行切块处理,用户向大模型提问时,RAGFlow先查找自有知识库中的切块内容,接着把查找到的知识库数据输入到对话大模型中再生成答案输
本文概述文章目标、核心观点和实践价值。> **摘要**:大模型火了两年,很多计算机专业同学反而更焦虑了——基础课要不要认真学?学 Python 还是学 Java?项目做 chatbot 还是做推荐系统?本文从我自己转型踩坑的实际经验出发,梳理一条对初学者更友好的学习路线,讲清楚哪些是坑、哪些是捷径、哪些东西面试官真的会问。**目录**专业就业现状:不是岗位少,是匹配度低基础课价值:别等面试被问倒才
摘要: CRUD-RAG 是一个中文 RAG(检索增强生成)评测项目,核心功能是评估基于检索的生成系统性能。其流程包括:从8万篇新闻文档中检索相关材料,结合用户问题生成答案(如摘要、续写等),并通过BLEU、ROUGE等指标对比生成结果与标准答案。项目通过FAISS索引实现高效检索,利用本地BAAI/bge模型处理文本向量化,并集成不同任务模块(如问答、改错)进行多维度评测。最终输出的是特定RAG
本文探讨视觉Agent从实验室到生产环境部署面临的稳定性挑战及解决方案。文章指出,当前视觉Agent在真实场景中常因多智能体视觉幻觉、资源泄漏、视觉感知失败等问题导致宕机。作者提出四层弹性架构设计模式,包括混合可供性集成、自适应视觉锚定等关键方法,强调快慢双路决策和状态可观测性的重要性。同时介绍了2026年Q2值得关注的新模型及稳定性选型标准,建议优先考虑资源效率、容错机制等生产指标而非单纯精度。
给模型一张图、一句话,让它把目标区域的像素精确圈出来——听起来简单直接,但一旦目标描述含糊、被遮挡、或者需要推理才能定位,一次性猜出正确掩码就变得相当困难。传统图像分割模型就像闭着眼睛猜答案,猜对了算运气,猜错了没人告诉它错在哪。2026年,这个局面正在被彻底改写。从ICML 2026到CVPR 2026,从Meta的SAM 3到复旦的RSAgent,多模态AI Agent正在将图像分割从“单次猜
老刘也收到了同样的brief。他的反应是:泡了杯咖啡,打开空白文档,然后在工位前面的白板上开始画脑图——产品卖点、人群画像、情绪关键词、场景清单。非常专业,非常系统,跟他做了六年的每一个案子一样。
“大家都觉得AI跟超市理货员八竿子打不着,但我见过一个大姐,用仨月时间,硬是从快被辞退的边缘人变成了品类主管。”
大模型本身无状态,记忆是外挂能力。本文讲透 AI Agent 的两类记忆:短期记忆(当前对话上下文,靠压缩裁剪)与长期记忆(跨会话持久信息,靠向量库检索,本质是 RAG),附对比表、协作流程图和 6 个实践建议。
本文深入解析企业级大模型项目的真实门槛,拒绝纸上谈兵。通过实测 LangChain 实战、RAG 数据治理及模型微调部署全流程,揭示从 Demo 到生产系统的核心差异,助力开发者掌握高含金量工程落地能力。
本文揭秘前端与测试工程师转型大模型应用的实战路径。通过掌握 Prompt 工程、RAG 检索增强生成及 Agent 智能体构建等核心技能,开发者无需深究算法即可将 AI 能力集成至业务系统,实现从代码执行者到应用架构师的职业跃迁。
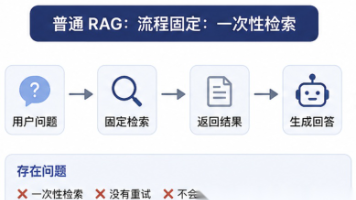
先问个灵魂拷问——你团队里的 RAG 系统,现在是不是还长这样?用户问题 → 文本切块 → Embedding → 向量库检索 → 拼接上下文 → 大模型生成如果答案是肯定的,别慌,你并不孤独。根据 SegmentFault 在 2026 年初发布的《RAG 技术落地现状调研》,超过 65% 的生产环境 RAG 系统仍然停留在这种经典的向量检索流水线上。问题具体表现影响程度语义天花板向量相似度只能
本文笔记围绕RAG的文本嵌入与向量存储环节。讲解如何将文档转为语义向量并存入向量数据库进行高效相似检索。演示了Chroma等向量库的统一接口用法,并详解了如何通过as_retriever()将检索器融入LCEL链,结合数据透传与格式化,串联起完整的检索增强生成流程。
这篇文章讲了RAG(检索增强生成)技术是什么,它是怎么让AI拥有"外挂大脑"的,包括它的工作原理、应用场景,以及它和联网搜索的区别。适合想了解AI知识库、想给自己公司搭建AI客服或内部助手的人阅读。
摘要: 提示词工程(Prompt Engineering)是决定大模型输出质量的关键,通过结构化规则、角色设定、范例约束等技巧,可显著提升输出的精准度和可用性。基础Prompt包含角色、任务、背景、约束、格式五要素,而高阶技巧如Few-shot(少样本学习)能强制模型对齐范例,减少幻觉。企业级应用中,负向约束(如禁止编造信息)和场景适配(如RAG、Agent)尤为重要。掌握这些方法可解决输出不稳定
这篇笔记系统梳理了 LangChain RAG 流程的基石环节:从 RAG 解决的实际痛点出发,逐步拆解数据在管道中的流转形态。核心围绕 Document 对象展开,它是所有文本在 Loader、Splitter、Embedding 等环节间传递的统一载体。文章详解了各类 Loader 如何将 PDF、网页、CSV、JSON 等异构数据转换为标准 Document,再通过 RecursiveCha
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?答案只有一个:人工智能(尤其是大模型方向)当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应
本文系统性地探讨了AI知识库构建的技术路径,提出从基础RAG到LLM Wiki的演进方案。文章指出大模型不适合直接作为数据库使用,推荐采用RAG技术实现检索增强生成,并根据应用场景复杂度提供了分层选型建议:简单问答用基础RAG、跨文档关联用Graph RAG、系统推理用Agentic RAG、长期研究用LLM Wiki。重点介绍了LLM Wiki的创新三层次结构(原始材料层、派生知识层、行为约束层
本文对比分析了RAG、GraphRAG和LlamaIndex三种技术在大模型落地应用中的区别与联系。RAG是基础的检索增强生成技术范式,GraphRAG是基于知识图谱的进阶方案,LlamaIndex则是开发工具框架。三者底层逻辑相同,但在数据存储、检索方式、处理能力和成本上存在差异。文章通过生活化比喻和场景案例,为新手提供了明确的选型建议:简单问答用基础RAG,复杂关联分析用GraphRAG,自主
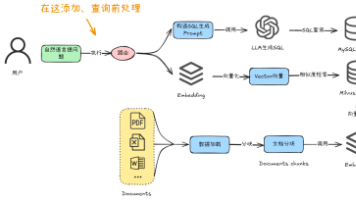
本文介绍了RAG系统中的查询前处理技术,包括查询改写、查询拆分和生成HyDE假设性文档三种方法。这些方法通过调用大语言模型(LLM)对用户原始问题进行优化处理,以提高检索的准确性和效率。查询改写可将口语化问题转换为标准财务术语;查询拆分将复杂问题分解为多个子问题;HyDE技术则通过生成假设性文档来改进向量检索效果。文章提供了每种方法的流程图和Python代码示例,展示了如何在实际财务场景中应用这些
本教程介绍了如何利用检索增强生成(RAG)技术构建基于大语言模型的问答系统。内容涵盖RAG的核心组件(索引构建、检索与生成)、环境配置和代码实现,并提供了一个从网页抓取数据到生成答案的完整示例。文章还强调了AI行业的高薪前景,并附赠大模型学习资源包,包括学习路线、视频教程、书籍文档、行业报告和面试真题等,帮助初学者快速入门。教程适合希望掌握大模型应用开发或转型AI领域的技术人员,重点解决私有数据处
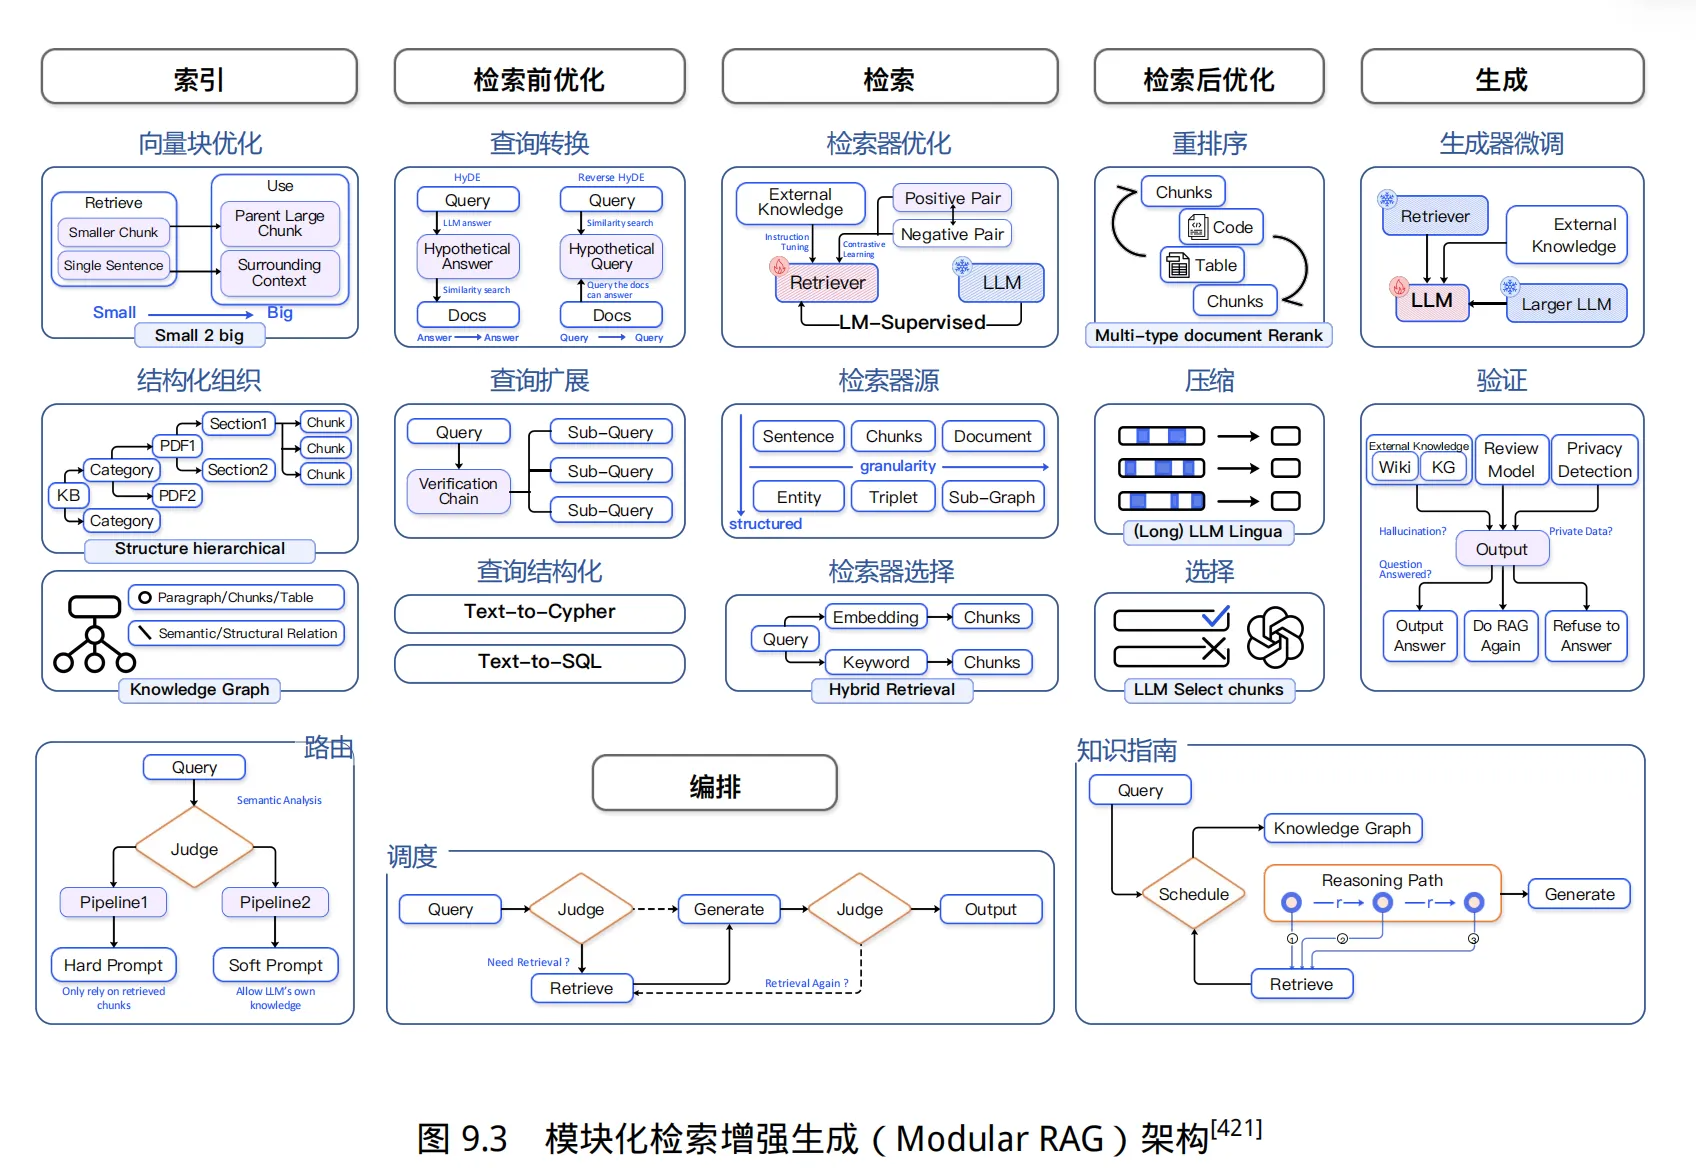
RAG(检索增强生成)技术通过结合检索和生成模块,显著提升大语言模型的性能。其核心优势包括生成内容更准确、知识即时更新、可解释性高、缓解幻觉问题,并保障本地数据隐私。RAG系统采用模块化架构,主要步骤涵盖索引构建、检索优化、生成及编排等环节。关键技术涉及文本嵌入模型微调、查询优化(如RQ-RAG算法)、幻觉感知生成模型(如RAG-HAT)、重排模型(如JudgeRank)以及检索生成联合优化(如R