登录社区云,与社区用户共同成长
邀请您加入社区
FramePack 的出现,让长视频生成从 “高端显卡专属” 走向 “人人可玩”,无论是短视频创作者、AI 爱好者还是研究者,都能借此轻松实现创意。关注【或问AI】公众号,回复关键词【FramePack】获取模型和整合包。
延世大学与英伟达联手:视频AI的物理幻觉是被"过度加工"害的
MagicWorld 针对当前视频世界模型在长时间交互中易出现运动不合理与场景崩坏的问题,提出了一种面向长时稳定性的交互式建模框架。该方法通过引入基于光流的运动约束提升动态真实性,利用历史检索机制增强跨时间一致性,并通过多步聚合的训练策略优化整体交互序列质量,从而有效缓解误差累积问题。整体上,MagicWorld 实现了在长时间交互下更加稳定、一致的世界生成能力。
英伟达与MIT联手:让AI视频"回头看",长视频生成再也不怕"忘性大"
中科院计算所研发"Echo-Forcing":让AI视频生成拥有真正的"记忆"
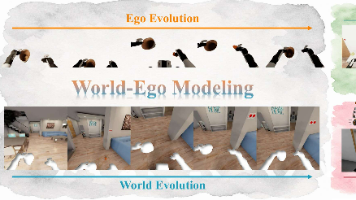
最近,视频世界模型正在从“生成好看的视频”,走向“预测机器人在物理世界中的未来”。从机器人数据生成,到策略评估,再到长时序任务想象,大家都希望模型能够提前“想象”机器人接下来会看到什么、会怎样行动、世界会怎样变化。但一进入具身场景,尤其是长时序任务,问题就不再只是画面质量。机器人需要一边导航、一边操作、一边根据连续指令改变环境。模型既要记住房间布局、物体位置、场景结构,又要预测机器人手臂、被操作物
NVIDIA突破:单显卡实现图片驱动720p长视频世界模型生成能力提升
(Multi-Agent Video Generation Framework),通过智能体协同实现自动化多镜头视频生成,并确保角色与场景的一致性。:只需输入你的创意概念,ViMax 自主处理剩余一切——端到端自动化视频创作。
谷歌与新加坡国立大学联手打造"视频导演AI"
字节跳动与厦门大学突破:视频AI生成速度提升6倍无损画质
Motif Technologies的视频生成模型是如何做到的?
深度解读米哈游蔡浩宇带队新作:170亿参数视频大模型LPM 1.0,让AI角色真正“活”起来!
【AI行业动态速览】Google推出新一代AI芯片挑战Nvidia垄断地位,同时升级Workspace AI功能打造"智能办公室";OpenAI发布GPT-Image-2图像生成模型,Anthropic更新AI安全治理框架;特斯拉追加250亿美元投资AI芯片研发,SpaceX融资600亿美元布局航天AI应用。今日三大焦点:AI芯片竞争白热化、企业级AI应用深化、安全治理体系完善
复旦大学与腾讯联手,让AI学会"看图说路"
昆仑天工AI突破:游戏世界生成器实现实时可探索虚拟空间创建能力
AI视频生成实现物理常识驱动动态行为真实性提升突破
北大携手北邮,教AI"感知光线"—让生成视频真正懂得光影的秘密
POSTECH团队突破视频生成瓶颈:用虚拟数据教AI生成现实中的动作
南加州大学让AI学会"看懂手势":从视频中学习人与物体的精妙互动
通过 GCP Vertex AI Veo 3.1 生成短视频,结合 Python moviepy 自动叠加字幕,实现从脚本到成品视频的全自动化流程,适用于 AI 短视频批量生产。:本文基于实际视频生成项目整理,涵盖 Veo 3.1 异步调用、提示词工程、字幕叠加和批量生产方案,去除敏感信息后形成通用化指南。
通过 GCP 服务账号 + Vertex AI 接入 Gemini 3 Pro、Gemini Flash 和 Veo 3.1 视频生成模型的完整实践,涵盖认证方式、模型调用、AWS 集成、生产部署和运维管理。:本文基于实际接入过程整理,去除敏感信息后形成通用化指南,适用于需要在 AWS 环境中调用 GCP AI 模型的团队。
WildWorld数据集突破:游戏世界赋能AI实现真实场景学习能力提升
清华6Bit-Diffusion:视频生成AI实现3倍模型瘦身与双倍速度提升
麦克马斯特大学团队让AI预测未来运动
本文提出了一种从视频扩散模型生成的不一致多视角图像中重建高质量三维场景的方法。针对单帧图像缺乏三维一致性的问题,该方法首先利用几何基础模型获取每帧的深度和相机参数,生成初始点云;然后通过非刚性迭代帧到模型ICP算法实现帧间对齐,并结合全局优化提升点云质量;最后采用非刚性高斯泼溅优化构建标准空间重建。实验结果表明,该方法能有效解决生成漂移问题,显著提升三维重建质量,实现从视频模型到三维一致性世界生成
SenseTime联合多所高校揭秘:视频AI的"思考过程"竟然如此神奇
InterDyn提出了一种基于视频扩散模型的可控交互动态生成框架,通过利用大规模预训练视频模型的隐式物理知识,实现了对复杂物体互动过程的连续动态预测。该方法仅需初始帧和运动控制信号,即可生成高质量、时序一致的交互视频,在真实场景中展现出优于传统状态转换方法的性能。InterDyn的创新在于将视频生成模型视为神经渲染器和隐式物理模拟器,并通过轻量级控制模块实现精确的运动约束,为机器人、VR/AR等应
港科大团队让AI学会了电影摄影师的全套技能
复旦大学重新定义视频制作:让虚拟人物完美听从指挥AI导演系统
本文提出了一种将双向视频扩散模型转化为快速自回归模型的方法CausVid,显著提升了视频生成效率。传统双向扩散模型生成128帧视频需219秒且需等待全部生成完成,而该方法通过将预训练双向扩散Transformer改造为因果自回归架构,结合创新的非对称蒸馏策略,实现了仅1.3秒初始延迟后以9.4 FPS流式生成。该方法还引入了基于教师ODE轨迹的学生初始化方案,有效缓解了自回归模型的误差累积问题,使
Helios:实时长视频生成新突破 北京大学等机构联合推出14B参数视频生成大模型Helios,在单张H100 GPU上实现19.5FPS的实时视频生成,支持分钟级长视频生成且保持高质量。Helios通过三大创新技术解决行业痛点: 深度压缩流技术:通过多期记忆补丁化和金字塔统一预测校正器大幅减少计算冗余,无需传统加速技术即可实现实时生成 简易防漂移方案:采用相对旋转位置编码消除重复动作,首帧锚点稳
当前视觉内容创作领域存在高度碎片化的问题:现有工作多聚焦于单一模态(如图像或视频)或仅实现部分创作功能(如仅生成或仅编辑)。这导致解决方案彼此割裂、接口互不兼容,且上下文条件(如草图、参考帧)往往作为任务特定的附加模块引入,难以构建一个支持多样化多模态输入、具备统一创作流程的单一系统。
摘要:MistralAI开源VoxtralMini4BRealtime2602多语言实时语音转录模型,支持13种语言,延迟可低至240ms,准确率接近离线系统,适合边缘计算部署。HyperAI官网更新了4个优质数据集(包括STEM推理、肺癌临床等)、3个教程(含腾讯视频生成模型)及3篇社区文章(物理信息GNN、肽预测框架等),并提供免费CPU资源部署热门开源模型的教程。
坦诚的评估是,这是在解决一个真实问题上取得的进展,而非一个完整的解决方案。视频扩散模型——目前最好的视频生成器——是在互联网数据上训练的,在这些数据中,手通常是微小的背景细节。在解释模型如何学会使用这些信号之前,值得理解的是,追踪提供的是精确的空间信息,而非模糊的推断。采用不良的条件策略时,模型生成的手会偏离输入的追踪数据,或者完全忽略信号,仅执行一般性的人体动作。这不是模糊的数据,而是具体的3D