登录社区云,与社区用户共同成长
邀请您加入社区
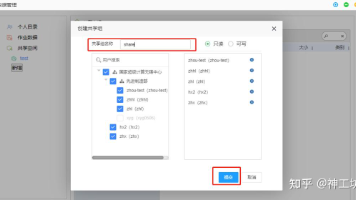
工业仿真从来不是单兵作战——复杂模型的多方协作、海量数据的跨团队流转,才是研发场景的常态。为此,SimForge™平台推出「共享空间」功能,打破传统孤岛式研发模式,为仿真团队构建云端协同中枢,让数据流转与知识沉淀更安全、更智能。
是由法国数据分析公司QuantStack主导维护的一套现代 C++ 数值计算生态开源组织,对标 Python NumPy、MATLAB、Eigen,但更侧重现代 C++、向量化 SIMD、零开销抽象、跨平台、高性能科学计算。官网:https://github.com/xtensor-stack把 Python 式简单易用的数组语法,搬到高性能 C++,兼顾易用性 + 极致性能。
是数值线性代数与高性能计算领域的杰出青年学者,目前担任布拉格查理大学数学与物理学院数值数学系副教授。她于2025年荣获数值分析领域最高荣誉之一的。:数值线性代数、混合精度算法、通信避免算法 (s-step Krylov 方法)、Krylov 子空间方法的数值稳定性。的计算趋势,核心是设计能适应当代多精度、异构硬件架构(如 GPU、AI 芯片)的数值算法。资助领导 InEXASCALE 项目。以下是
IDAES(Institute for the Design of Advanced Energy Systems)是美国能源部(DOE)旗下、由国家能源技术实验室(NETL)主导开发的开源过程系统工程(PSE)平台,2016年正式启动,核心用于先进能源系统的多尺度建模、仿真与优化。定位:填补商用模拟器(如Aspen)与通用代数建模语言(如Pyomo)之间的空白,专注复杂能源/化工过程的设计、强化
(Huawei Zürich Research Center)计算系统实验室的研究科学家与专家(Research Scientist and Expert)[[2]][[8]]。博士是一位专注于高性能计算与并行编程模型研究的计算机科学家,目前担任。
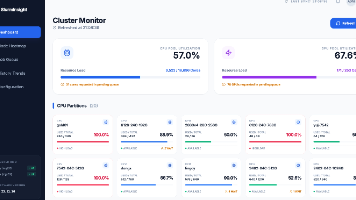
还在用 scontrol 和 sinfo 手动查集群状态?SlurmInsight 是一款专为 Slurm 调度系统打造的 Web 可视化监控平台。从仪表盘到节点热图,从作业队列到历史趋势,让 HPC 集群管理像看仪表盘一样简单。即将开源,敬请关注!
MPI Sessions 是MPI-4.0 新一代并行执行模型,彻底替代传统全局初始化模型,专门解决多物理场耦合、多求解器独立运行、动态资源划分、异构GPU/CPU分区、FSI液固耦合等复杂场景。结合你之前学的MPI Partitioned分区通信、CUDA-aware GPU通信,本文一次性讲清原理、API、标准流程、FSI双向流固耦合完整工程实现。模块作用FSI耦合用途独立MPI环境流体/固体
NVIDIA HPC-X 并不是一个孤立的 MPI 变体,而是一个由 NVIDIA (原 Mellanox) 提供的高性能通信软件工具包。[1, 2]它通过将开源组件与专有加速技术“打包”并进行深度调优,为基于 InfiniBand 网络的集群提供极致性能。[3, 4]
欧洲超算 CFD 旗舰:把传统CFD推向百亿亿次工业+学术双驱动:兼顾基础算法与工程应用全链路覆盖:代码→算法→硬件适配→工业验证开源开放:所有改进回馈社区,可直接用于你的相变/沸腾/冷凝研究欧洲CFD全面上Exascale:5大旗舰代码GPU化+千万核+低能耗相变/多相流工业化沸腾/冷凝/凝固从实验室走向百亿亿次工程开源回馈:所有优化合并回主线工业落地:6大领域达TRL 4–5,直接用于航空、能
FrontISTR 是日本开源、大规模并行非线性结构有限元求解器,主打超算/集群高效并行,适合大模型、非线性、高算力需求场景,MIT 协议可商用二次开发。FrontISTR(开源大规模并行非线性结构有限元程序)开发背景:日本文部科学省下一代 IT 基盘仿真软件项目成果维护主体:FrontISTR Commons 社团MIT 开源许可,个人/商用/二次开发自由超大规模并行、强非线性、超算/集群友好、
TCLB(CUDA Lattice Boltzmann)是一款基于格子玻尔兹曼方法(Lattice Boltzmann Method, LBM)的高性能计算流体动力学(CFD)仿真代码,由华沙理工大学的 Zakład Aerodynamiki 团队主导开发,核心目标是为复杂物理场计算和新模型实现提供高效、灵活的框架。
发起:2001 年,由 Prof. Dhabaleswar K. (DK) Panda 团队主导定位:基于 MPICH 架构(ADI3 通道),专注RDMA 网络 + HPC 场景的高性能 MPI 库BSD 开源许可(商用友好)现状:全球超 3200 家机构、89 个国家使用,大量 TOP500 超算采用MVAPICH 是RDMA 网络 HPC 的性能标杆,在 InfiniBand/GPU 超算场
Georg Hager = HPC性能优化领域的“宗师”他以LIKWID、ECM模型、Node-Level Performance Engineering三大里程碑,定义了现代HPC性能工程的方法论与工具链,是全球超算与科学计算开发者必须了解、学习、致敬的标杆人物。
Spack软件包管理器
HPCToolkit工具使用
DEM商软比较
本文从工程痛点出发,深度解构了 SaaS 化通风仿真平台底层的核心计算理论。
将以上所有层次综合起来,我们可以得到一张完整的NVLink/NVSwitch通信协议栈视图。这张图清晰地展示了从最底层的物理连接到最顶层的应用,以及贯穿始终的控制平面,是如何共同构成一个强大、高效的系统的。NVLink/NVSwitch协议栈本质上是一个为AI和高性能计算(HPC)工作负载量身定制的、全栈式协同设计的、高性能互联系统。它通过简化协议、地址直通、网络内计算和强大的软件控制,将成千上万
“风神NF3”数字孪生风洞是神工坊®CAE“基座+应用”生态的里程碑,本文将深度解析其背后的两大核心技术——HSF-SAMR网格自适应与HSF-AI智能求解技术,看它们如何让仿真从“能算”进阶为“智能算”。