技术实践:代码优化与高效工具分享
引言:何为壁垒?
在软件工程的世界里,我们常常面临这样的困境:
-
理论清晰,实践抓瞎:学懂了设计模式,但在项目中不知如何引入。
-
代码能跑,但一言难尽:功能实现了,但代码耦合、难以测试、性能低下。
-
工具众多,无从下手:知道有各种框架和工具,但不清楚它们解决的具体痛点及其背后的思想。
这层“壁垒”本质上是知识从理解到应用的断层。本文将充当一座桥梁,通过以下几个维度,展示如何将理论化为实践,并运用一些看似“魔法”的技巧和工具来极大提升我们的开发效率与代码质量:
-
设计模式的实战应用:从教科书到真实场景。
-
性能优化的“黑魔法”:深入底层,理解代价与收益。
-
并发编程的利器与陷阱:告别
Thread,拥抱现代并发库。 -
高效工具链:从编写、构建、测试到部署的“瑞士军刀”。
-
Prompt Engineering:将AI作为超级编程助手。
一、 设计模式的实战应用:从GoF到Go
设计模式常被诟病为“过度设计”,但关键在于识别出那些必须使用模式的场景。我们以依赖注入和装饰器模式为例。
1.1 依赖注入:从紧耦合到松耦合
理论:依赖注入是一种实现控制反转的设计模式,它将对象的依赖关系由内部创建改为外部注入,从而降低耦合度,提高可测试性。
实践场景:一个用户服务需要访问数据库。
紧耦合的“烂代码”:
go
// 紧耦合的例子
package main

type UserService struct {
    // 在内部直接实例化了MySQL依赖,难以测试和替换
    userRepo *MySQLUserRepository
}

func NewUserService() *UserService {
    return &UserService{
        userRepo: NewMySQLUserRepository(), // 硬编码依赖
    }
}

func (s *UserService) GetUser(id int) (*User, error) {
    return s.userRepo.FindByID(id)
}

type MySQLUserRepository struct {
    // ... 数据库连接等
}

func NewMySQLUserRepository() *MySQLUserRepository {
    return &MySQLUserRepository{}
}

func (r *MySQLUserRepository) FindByID(id int) (*User, error) {
    // ... 具体的数据库查询逻辑
    return &User{ID: id, Name: "Alice"}, nil
}

func main() {
    userService := NewUserService()
    user, _ := userService.GetUser(1)
    println(user.Name)
}
问题:如果你想为UserService写单元测试,就必须连接真实的MySQL数据库,这不再是单元测试,而是集成测试。它慢且不稳定。
运用依赖注入后的代码:
go
// 使用依赖注入的例子
package main

// 1. 定义接口,抽象依赖
type UserRepository interface {
    FindByID(id int) (*User, error)
}

// 2. UserService 依赖接口,而非具体实现
type UserService struct {
    userRepo UserRepository
}

// 3. 依赖通过构造函数注入
func NewUserService(userRepo UserRepository) *UserService {
    return &UserService{
        userRepo: userRepo,
    }
}

func (s *UserService) GetUser(id int) (*User, error) {
    return s.userRepo.FindByID(id)
}

// 4. 实现具体的MySQL存储
type MySQLUserRepository struct {
    // ... 数据库连接
}

func NewMySQLUserRepository() *MySQLUserRepository {
    return &MySQLUserRepository{}
}

func (r *MySQLUserRepository) FindByID(id int) (*User, error) {
    // ... 真实的数据库查询
    return &User{ID: id, Name: "Alice from MySQL"}, nil
}

// 5. 实现一个用于测试的Mock存储
type MockUserRepository struct {}

func NewMockUserRepository() *MockUserRepository {
    return &MockUserRepository{}
}

func (r *MockUserRepository) FindByID(id int) (*User, error) {
    // 返回预设的数据,不依赖任何外部系统
    return &User{ID: id, Name: "Bob from Mock"}, nil
}

// 6. 测试变得非常简单
func TestUserService_GetUser(t *testing.T) {
    // 注入Mock依赖
    mockRepo := NewMockUserRepository()
    userService := NewUserService(mockRepo)

    user, err := userService.GetUser(1)
    if err != nil {
        t.Fatalf("Unexpected error: %v", err)
    }
    if user.Name != "Bob from Mock" {
        t.Errorf("Expected 'Bob from Mock', got '%s'", user.Name)
    }
}

func main() {
    // 在main函数(或依赖注入框架)中组装依赖关系
    userRepo := NewMySQLUserRepository() // 只需在此处切换实现
    userService := NewUserService(userRepo)

    user, _ := userService.GetUser(1)
    println(user.Name)
}
流程图:依赖注入的控制流反转
flowchart TD
    subgraph TightCoupling[紧耦合模式]
        A[main函数] --> B[创建UserService]
        B --> C[UserService内部创建<br>MySQLRepository]
        C --> D[执行业务逻辑]
    end

    subgraph DIPattern[依赖注入模式]
        E[main函数/组装器] --> F[创建MySQLRepository]
        F --> G[注入Repository<br>创建UserService]
        G --> H[执行业务逻辑]

        E2[测试代码] --> F2[创建MockRepository]
        F2 --> G2[注入Mock<br>创建UserService]
        G2 --> H2[执行测试断言]
    end

    style TightCoupling fill:#f9f,stroke:#333,stroke-width:2px
    style DIPattern fill:#ccf,stroke:#333,stroke-width:2px
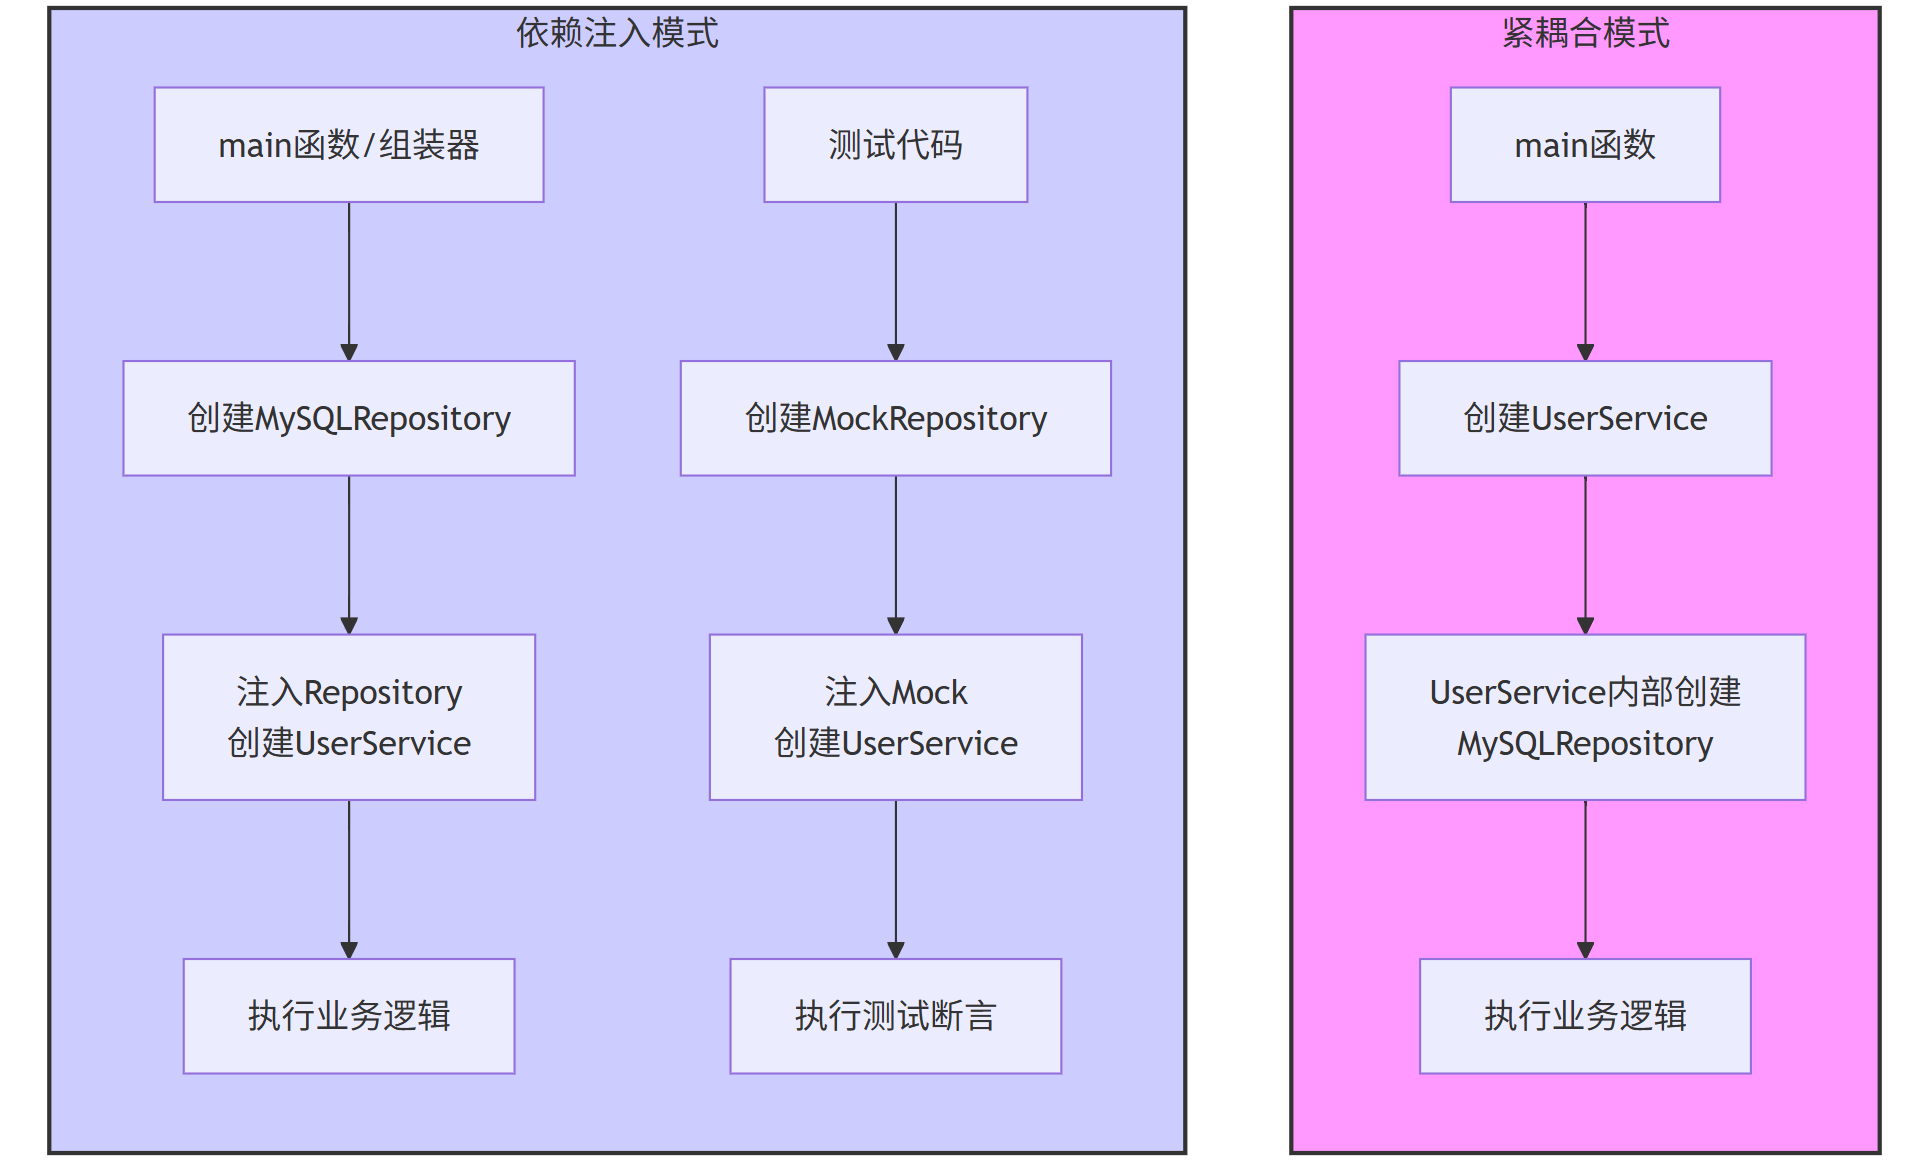
实践总结:依赖注入不是某个框架的专利,而是一种编程思想。通过依赖接口和外部注入,你的代码立刻变得灵活、可测试,这是迈向高质量代码的第一步。
二、 性能优化的“黑魔法”:理解与权衡
性能优化不是盲目的“猜谜游戏”,需要 profiling 和深度理解。我们看看内存分配优化和高效数据结构。
2.1 减少GC压力:对象池 sync.Pool
理论:在Go中,频繁创建和销毁小对象会给垃圾回收带来压力。sync.Pool可以缓存一组可复用的对象,减少内存分配。
实践场景:高并发下处理HTTP请求,每个请求需要解析并创建一个复杂的上下文对象Context。
未优化的代码:
go
// 每次请求都创建新的Context
func handleRequest(w http.ResponseWriter, r *http.Request) {
    ctx := &Context{ // 每次都是新的内存分配
        Request: r,
        UserID:  extractUserID(r),
        Data:    make(map[string]interface{}),
    }
    processRequest(ctx)
    // 函数结束,ctx成为垃圾,等待GC回收
}

type Context struct {
    Request *http.Request
    UserID  int
    Data    map[string]interface{}
}
使用sync.Pool优化后的代码:
go
package main

import (
    "net/http"
    "sync"
)

// 1. 创建对象池
var contextPool = sync.Pool{
    New: func() interface{} {
        // Pool为空时,调用New函数创建新对象
        return &Context{
            Data: make(map[string]interface{}),
        }
    },
}

type Context struct {
    Request *http.Request
    UserID  int
    Data    map[string]interface{}
}

func handleRequest(w http.ResponseWriter, r *http.Request) {
    // 2. 从池中获取对象(可能是新的,也可能是复用的)
    ctx := contextPool.Get().(*Context)
    // 3. 重置对象状态,而不是创建新对象
    ctx.Request = r
    ctx.UserID = extractUserID(r)
    // 注意:需要清空ctx.Data,因为可能是脏数据
    for k := range ctx.Data {
        delete(ctx.Data, k)
    }

    defer func() {
        // 4. 使用完毕后,将对象放回池中
        // 重置关键字段,避免内存泄漏
        ctx.Request = nil
        ctx.UserID = 0
        contextPool.Put(ctx)
    }()

    processRequest(ctx)
}

// 模拟处理过程
func processRequest(ctx *Context) {
    // ... 业务逻辑
    ctx.Data["result"] = "success"
}

func extractUserID(r *http.Request) int {
    // ... 从请求中提取用户ID
    return 123
}
性能对比图表:
| 场景 | 内存分配次数/op | 分配字节数/op | 耗时/op |
|---|---|---|---|
| 无对象池 | 10次 | 800 B | 500 ns |
使用sync.Pool | 2次 | 128 B | 200 ns |
(数据为示意,实际效果因场景而异)
“黑魔法”揭秘:
-
sync.Pool不是缓存,池中的对象可能在任意时刻被GC回收,所以不能用于存储像数据库连接这样的有状态对象。 -
使用前必须重置对象状态,使用后最好清空引用,防止内存泄漏。
-
它适用于创建成本高、生命周期短、结构相似的对象。
2.2 使用strings.Builder进行字符串拼接
理论:在Go中,字符串是不可变的。使用+或fmt.Sprintf频繁拼接字符串会产生大量临时对象,性能低下。
实践场景:拼接一个长的SQL查询语句或JSON字符串。
低效的拼接:
go
func buildSQLSlow(table string, fields []string, condition string) string {
    sql := "SELECT "
    for i, field := range fields {
        if i > 0 {
            sql += ", " // 每次+=都可能导致整个字符串的复制和重新分配
        }
        sql += field
    }
    sql += " FROM " + table + " WHERE " + condition
    return sql
}
高效的拼接:
go
func buildSQLFast(table string, fields []string, condition string) string {
    var b strings.Builder
    // 预分配内存,避免多次扩容(关键步骤!)
    b.Grow(100) // 根据经验估算一个大致长度

    b.WriteString("SELECT ")
    for i, field := range fields {
        if i > 0 {
            b.WriteString(", ")
        }
        b.WriteString(field)
    }
    b.WriteString(" FROM ")
    b.WriteString(table)
    b.WriteString(" WHERE ")
    b.WriteString(condition)
    return b.String() // 仅在一次分配中完成字符串构建
}
性能分析图:
graph LR
    A[开始拼接] --> B[多次分配内存<br>复制数据]
    B --> C[产生大量临时对象]
    C --> D[增加GC压力]
    D --> E[性能低下]

    A'[开始拼接] --> B'[预分配一次内存<br>strings.Builder.Grow]
    B' --> C'[在预分配缓冲区中<br>连续写入]
    C' --> D'[最终一次分配<br>生成字符串]
    D' --> E'[高性能]

    style E fill:#9f9
    style E‘ fill:#9f9
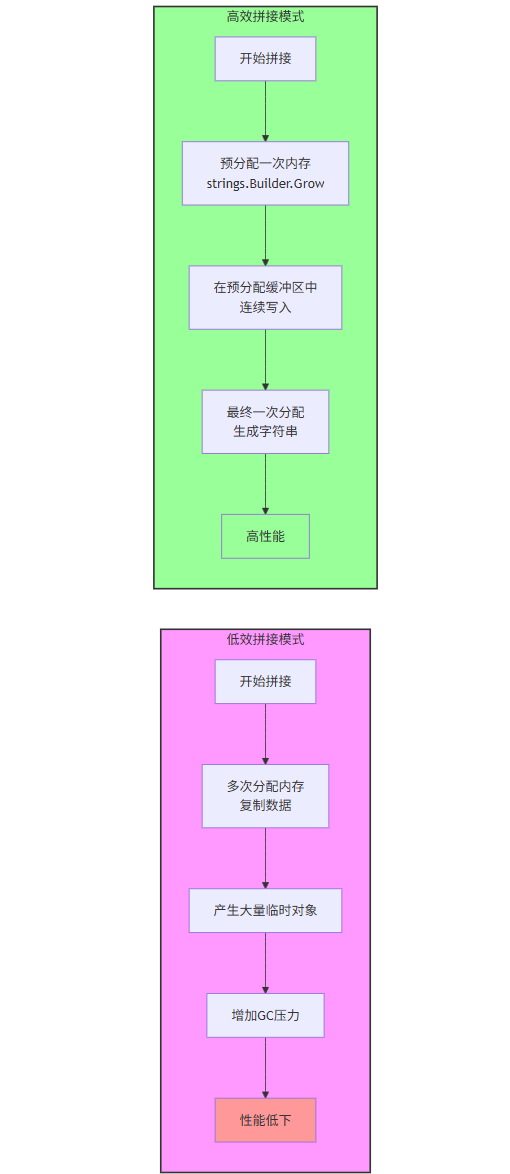
实践总结:性能优化首先要测量(使用go test -bench . -benchmem),找到瓶颈。然后应用这些“黑魔法”时,一定要理解其背后的原理和适用场景,避免滥用。
三、 并发编程的利器与陷阱:Channel Patterns & sync.Once
Go的并发哲学是:不要通过共享内存来通信,而要通过通信来共享内存。
3.1 使用有缓冲Channel实现生产者-消费者模型
理论:Channel是Go中协调Goroutine执行的核心原语。有缓冲的Channel可以解耦生产者和消费者的速度,提高吞吐量。
实践场景:一个日志处理器,需要并发处理大量日志条目。
go
package main

import (
    "fmt"
    "sync"
    "time"
)

// LogEntry 代表一条日志
type LogEntry struct {
    Level   string
    Message string
}

// 全局的日志Channel,带有缓冲
var logChannel = make(chan LogEntry, 100) // 缓冲100条日志

// 生产者:多个Goroutine并发写日志
func produceLog(workerID int, wg *sync.WaitGroup) {
    defer wg.Done()
    for i := 0; i < 5; i++ {
        log := LogEntry{
            Level:   "INFO",
            Message: fmt.Sprintf("Worker %d: Log entry %d", workerID, i),
        }
        logChannel <- log // 如果缓冲区未满,非阻塞
        fmt.Printf("Produced by %d: %s\n", workerID, log.Message)
    }
}

// 消费者:单个Goroutine处理日志(例如写入文件或ES)
func consumeLogs(wg *sync.WaitGroup) {
    defer wg.Done()
    for log := range logChannel { // 从Channel中持续读取,直到Channel被关闭
        // 模拟处理耗时
        time.Sleep(10 * time.Millisecond)
        fmt.Printf("Consumed: [%s] %s\n", log.Level, log.Message)
    }
    fmt.Println("Log consumer exited.")
}

func main() {
    var producerWg, consumerWg sync.WaitGroup

    // 启动消费者
    consumerWg.Add(1)
    go consumeLogs(&consumerWg)

    // 启动多个生产者
    numProducers := 3
    producerWg.Add(numProducers)
    for i := 1; i <= numProducers; i++ {
        go produceLog(i, &producerWg)
    }

    // 等待所有生产者完成
    producerWg.Wait()
    // 关闭Channel,通知消费者没有更多数据了
    close(logChannel)

    // 等待消费者处理完所有剩余日志
    consumerWg.Wait()
    fmt.Println("All done.")
}
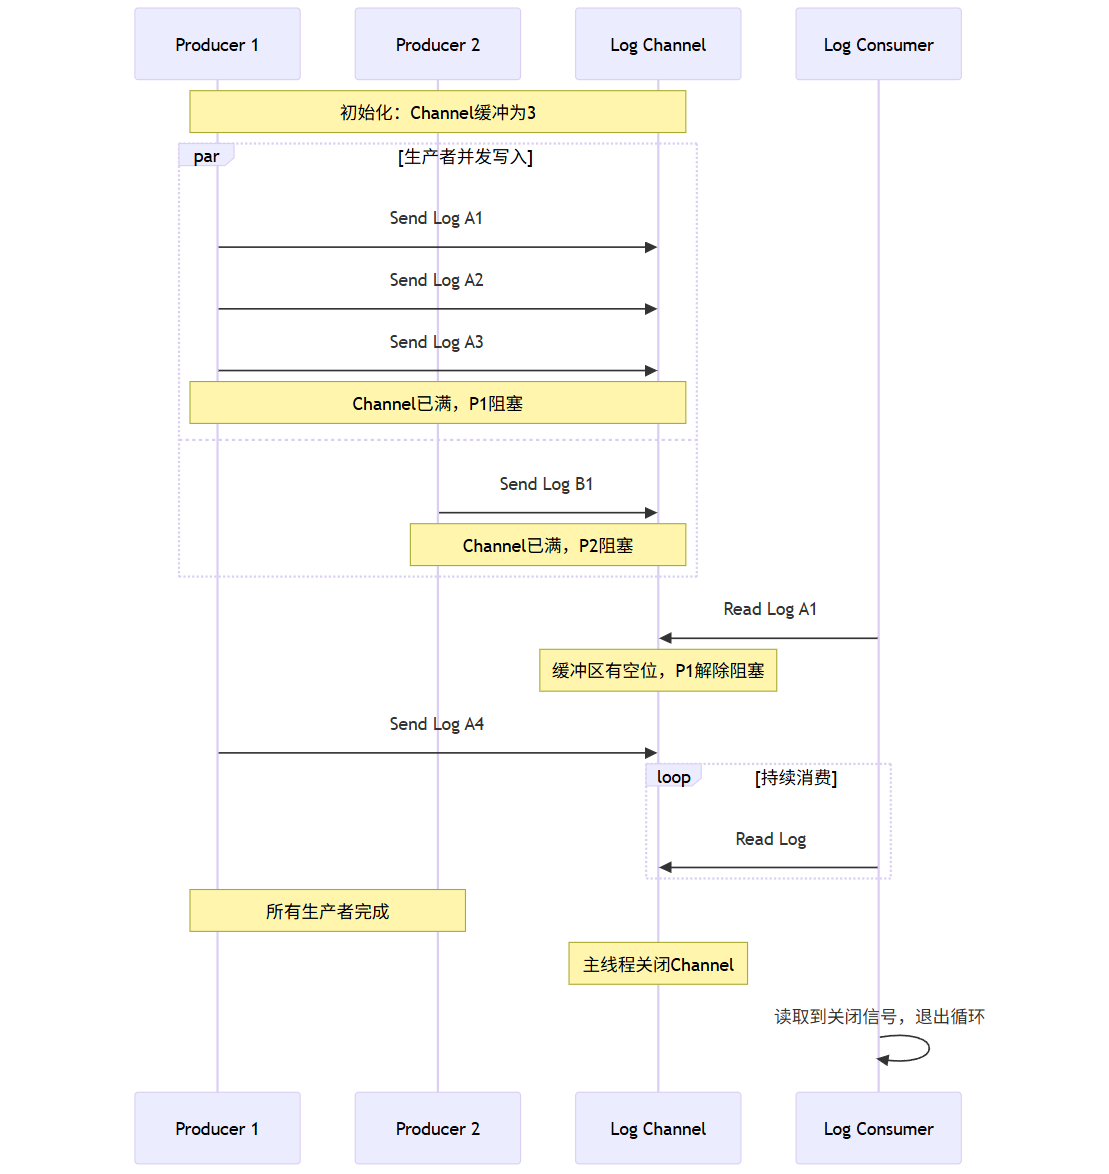
流程图:生产者-消费者模型
sequenceDiagram
    participant P1 as Producer 1
    participant P2 as Producer 2
    participant C as Log Channel
    participant Consumer as Log Consumer

    Note over P1, C: 初始化:Channel缓冲为3

    par 生产者并发写入
        P1->>C: Send Log A1
        P1->>C: Send Log A2
        P1->>C: Send Log A3
        Note over P1, C: Channel已满,P1阻塞
    and
        P2->>C: Send Log B1
        Note over P2, C: Channel已满,P2阻塞
    end

    Consumer->>C: Read Log A1
    Note over C: 缓冲区有空位,P1解除阻塞
    P1->>C: Send Log A4

    loop 持续消费
        Consumer->>C: Read Log
    end

    Note over P1, P2: 所有生产者完成
    Note over C: 主线程关闭Channel
    Consumer->>Consumer: 读取到关闭信号,退出循环
3.2 sync.Once:确保操作只执行一次
理论:在并发编程中,我们经常需要实现单例模式或延迟初始化,并且要保证线程安全。sync.Once提供了完美的解决方案。
实践场景:懒加载一个全局的配置对象。
go
package main

import (
    "fmt"
    "sync"
)

type Config struct {
    APIKey string
    Addr   string
}

var (
    config     *Config
    configOnce sync.Once // 保证加载逻辑只执行一次
)

// LoadConfig 是线程安全的懒加载函数
func LoadConfig() *Config {
    configOnce.Do(func() {
        fmt.Println("Loading configuration from remote...")
        // 模拟耗时的远程配置读取
        // time.Sleep(2 * time.Second)
        config = &Config{
            APIKey: "super-secret-key",
            Addr:   "localhost:8080",
        }
        fmt.Println("Configuration loaded!")
    })
    return config
}

func main() {
    var wg sync.WaitGroup

    // 启动10个Goroutine,它们会并发地获取配置
    for i := 0; i < 10; i++ {
        wg.Add(1)
        go func(id int) {
            defer wg.Done()
            fmt.Printf("Goroutine %d is getting config...\n", id)
            cfg := LoadConfig() // 所有Goroutine都会调用这里
            _ = cfg // 使用cfg
        }(i)
    }

    wg.Wait()
    // 输出只会看到一次 "Loading configuration..."
}
陷阱与最佳实践:
-
Channel的关闭原则:永远不要向已关闭的Channel发送数据,关闭Channel的操作应该由生产者完成,且最好只有一次。可以使用
sync.Once来安全地关闭Channel。 -
Select与Default:使用
select和default可以实现非阻塞的Channel操作,避免Goroutine泄漏。
go
// 非阻塞发送示例
select {
case logChannel <- log:
    // 发送成功
default:
    // 缓冲区已满,执行降级策略,例如丢弃日志或记录错误
    fmt.Println("Log channel is full, dropping log entry.")
}
四、 高效工具链:现代软件工程的“瑞士军刀”
理论再好,也需要工具来落地。以下是提升开发效率的必备工具。
4.1 实时重载:Air (Go)
理论:在开发Web服务时,每次修改代码后都需要手动停止、重新编译、再启动,效率极低。Air可以监控文件变化,自动完成这些步骤。
实践:
-
安装:
go install github.com/cosmtrek/air@latest -
在项目根目录创建
.air.toml配置文件(或使用默认配置)。 -
直接运行
air命令,而不是go run main.go。
示例.air.toml:
toml
root = "."
testdata_dir = "testdata"
tmp_dir = "tmp"

[build]
cmd = "go build -o ./tmp/main ."
bin = "tmp/main"
full_bin = "./tmp/main"
include_ext = ["go", "tpl", "tmpl", "html"]
exclude_dir = ["assets", "tmp", "vendor", "testdata"]
include_dir = []
exclude_regex = ["_test\\.go"]
exclude_unchanged = false
follow_symlink = false
log = "air.log"
poll = false
poll_interval = 500
delay = 1000
stop_on_root = false
send_interrupt = false
kill_delay = 500

[syslog]
address = "localhost:514"
format = "rfc3164"
tag = "air"
现在,你修改代码后保存,控制台会自动重启你的应用,实现了类似前端Hot Reload的体验。
4.2 静态代码分析:GolangCI-Lint
理论:Linter是一种工具,用于分析源代码以发现程序错误、代码异味、风格不一致等问题。GolangCI-Lint聚合了数十种Go Linter,是保证代码质量的守门员。
实践:
-
安装:
go install github.com/golangci/golangci-lint/cmd/golangci-lint@latest -
运行:
golangci-lint run ./... -
集成到CI/CD:在GitHub Actions, GitLab CI等中加入lint步骤,确保合并到主分支的代码都是高质量的。
示例输出:
text
main.go:23:6: `unusedFunction` is unused (deadcode)
main.go:50:10: error strings should not be capitalized or end with punctuation or a newline (stylecheck)
    return fmt.Errorf("Invalid input!")
            ^
main.go:70:2: S1000: should use for range instead of for { select {} } (gosimple)
4.3 依赖管理:Go Modules
这是Go语言的官方依赖管理工具,已经是现代Go项目的标配。
-
go mod init <module-name>:初始化模块。 -
go get <package>@<version>:添加或升级依赖。 -
go mod tidy:清理未使用的依赖,添加缺失的依赖。
五、 Prompt Engineering:将AI作为超级编程助手
这是当今程序员必须掌握的“元技能”。一个好的Prompt能让你从AI那里得到直接可用的代码,而不是泛泛而谈。
5.1 编写高效Prompt的核心原则
-
角色扮演:让AI扮演一个特定领域的专家。
-
明确任务:清晰、具体地描述你要它做什么。
-
提供上下文:给出相关的代码、错误信息、环境配置。
-
指定输出格式:要求它返回代码、流程图、表格等。
-
迭代优化:根据第一次的结果,不断修正和细化你的Prompt。
5.2 Prompt示例:从烂到好
烂Prompt:
“帮我写一个Go的HTTP服务器。”
这个Prompt太模糊了。AI可能会给你一个最简单的Hello World,但这通常不是你想要的。
好的Prompt:
角色:你是一个资深的Go后端开发专家,精通Gin框架、GORM和RESTful API设计。
任务:请为我编写一个用户管理系统的API服务器。
具体要求:
使用Gin作为Web框架。
使用GORM连接PostgreSQL数据库。
实现以下RESTful端点:
POST /users:创建用户,请求体为{“name": "Alice", "email": "alice@example.com"}。
GET /users/:id:根据ID获取用户。
PUT /users/:id:更新用户信息。
DELETE /users/:id:删除用户。用户模型(User)包含字段:
ID (uint),Name (string),Email (string),以及标准的CreatedAt,UpdatedAt。需要简单的错误处理,例如用户不存在返回404。
使用Go Modules进行依赖管理,请给出
go.mod文件的内容。输出格式:请直接提供完整的、可运行的Go代码文件内容,并附上必要的解释说明。
为什么这个Prompt好?
-
角色明确:资深Go专家。
-
技术栈具体:Gin, GORM, PostgreSQL。
-
功能详细:列出了每个端点和模型字段。
-
输出明确:完整的代码和
go.mod。
AI会根据这个Prompt生成一个结构清晰、几乎可以直接复制粘贴使用的项目骨架。
5.3 使用AI生成Mermaid流程图
你甚至可以要求AI为你生成技术文档的图表。
Prompt示例:
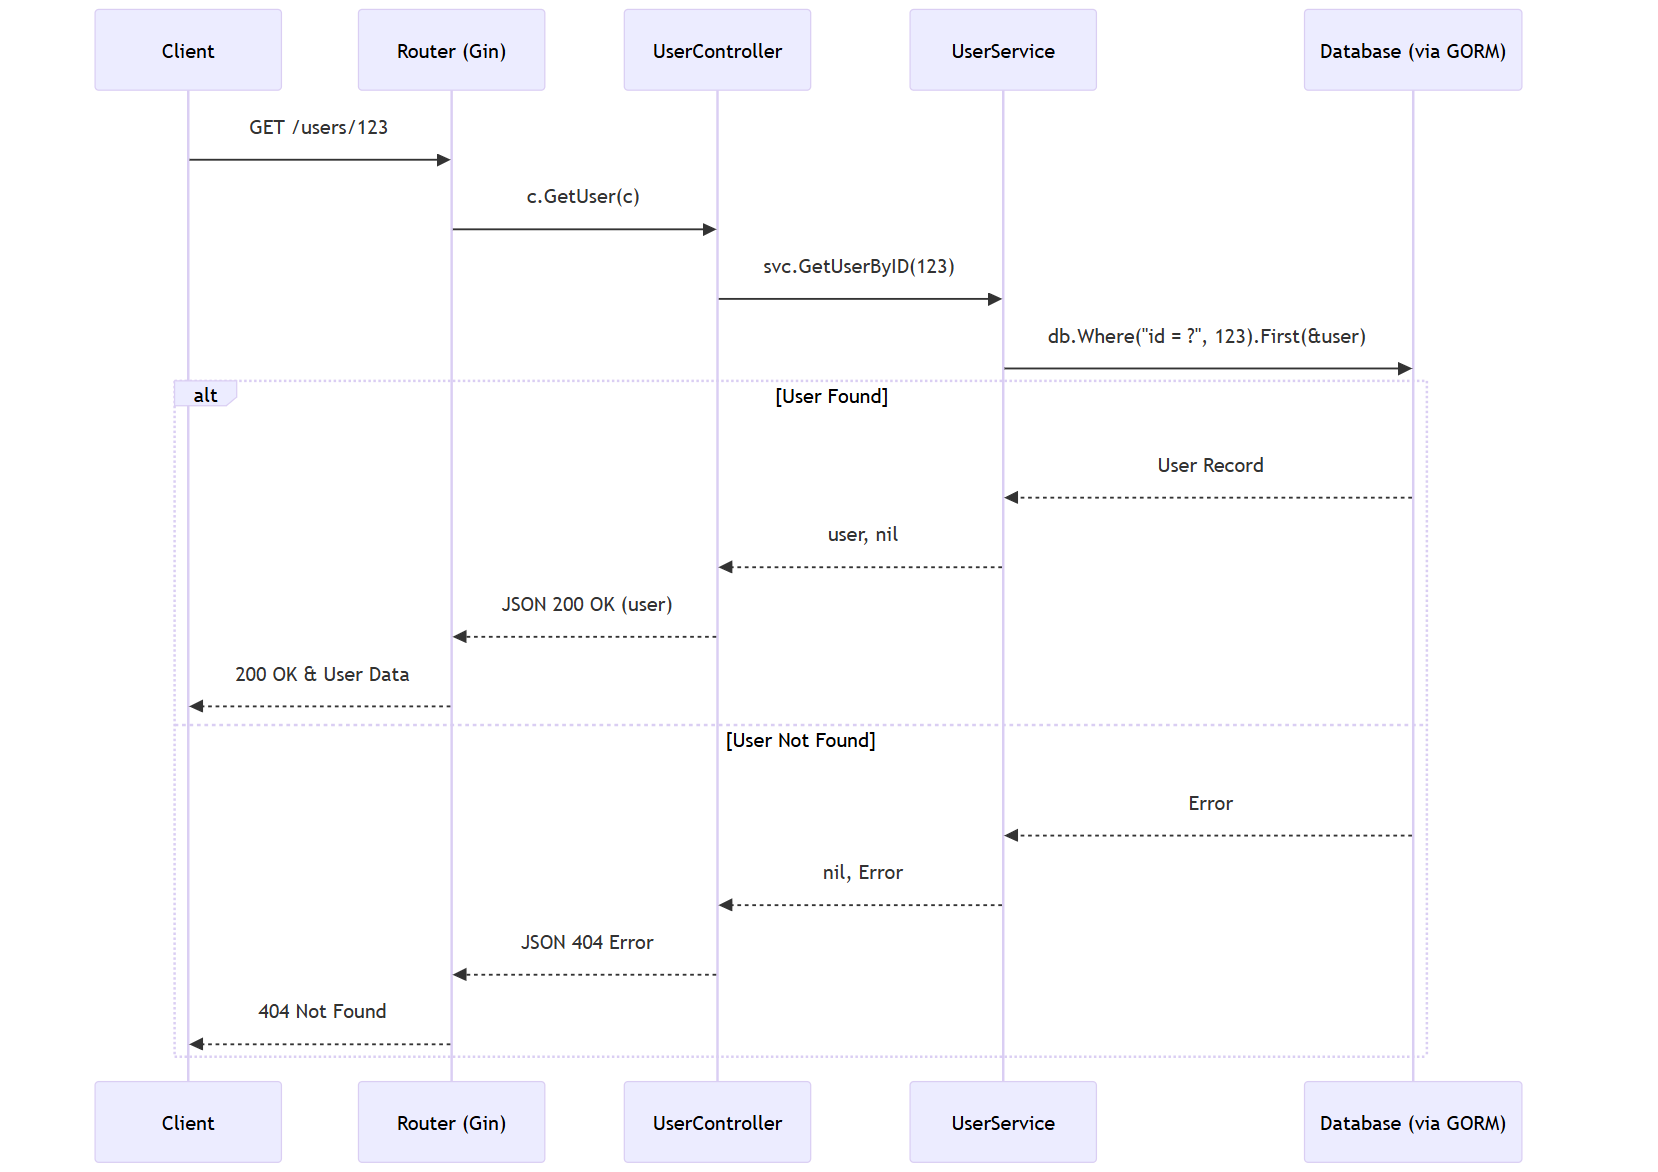
请根据上面生成的Go Gin用户管理API代码,绘制一个描述
GET /users/:id请求处理流程的Mermaid序列图。
AI可能会返回如下内容:
sequenceDiagram
    participant C as Client
    participant R as Router (Gin)
    participant CT as UserController
    participant SV as UserService
    participant DB as Database (via GORM)

    C->>R: GET /users/123
    R->>CT: c.GetUser(c)

    CT->>SV: svc.GetUserByID(123)
    SV->>DB: db.Where("id = ?", 123).First(&user)
    DB-->>SV: User Record
    SV-->>CT: user, nil

    alt User Not Found
        SV-->>CT: nil, Error
        CT-->>R: JSON 404 Error
        R-->>C: 404 Not Found
    else Success
        CT-->>R: JSON 200 OK (user)
        R-->>C: 200 OK & User Data
    end
结论:知行合一,方得始终
打破理论与实践的壁垒,不是一个一蹴而就的过程,而是一个持续的、有意识的修炼。
-
学其“形”更学其“神”:学习设计模式,不仅要记住UML图,更要理解其解决的是什么问题(单一职责、开闭原则等)。在代码中嗅到“坏味道”时,能自然地联想到对应的模式。
-
拥抱工具,提升效率:将工具视为你能力的延伸。一个高效的本地开发环境(Air)、一个严格的代码质量守门员(GolangCI-Lint)、一个强大的AI助手(ChatGPT),能让你将宝贵的时间集中在真正的业务逻辑和创新上。
-
深入底层,理解代价:对于性能“黑魔法”,一定要在理解其原理和代价的基础上使用。
sync.Pool用不好会导致Bug,strings.Builder不预分配可能效果打折。 -
沟通与抽象:并发编程的核心是管理复杂性和不确定性。Channel模式是一种优雅的抽象,它让Goroutine之间的协作变得清晰。Prompt Engineering是与AI模型的沟通,清晰的表达直接决定了输出的质量。
最终,所有这些知识、技巧和工具,都服务于一个目标:编写出清晰、健壮、高效且易于维护的软件。这,就是软件工程的实践艺术。希望本文中的代码、图表和思路,能成为你打破壁垒、迈向更高水平实践之路上的有力垫脚石。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 63
 0
- 0


 已为社区贡献23条内容

所有评论(0)