【详细教程】前沿RF-DETR 目标检测模型训练,推理,评估,可视化
《------往期经典推荐------》
二、机器学习实战专栏【链接】,已更新31期,欢迎关注,持续更新中~~
三、深度学习【Pytorch】专栏【链接】
四、【Stable Diffusion绘画系列】专栏【链接】
五、YOLOv8改进专栏【链接】,持续更新中~~
六、YOLO性能对比专栏【链接】,持续更新中~
《------正文------》
目录
RF-DETR 模型介绍
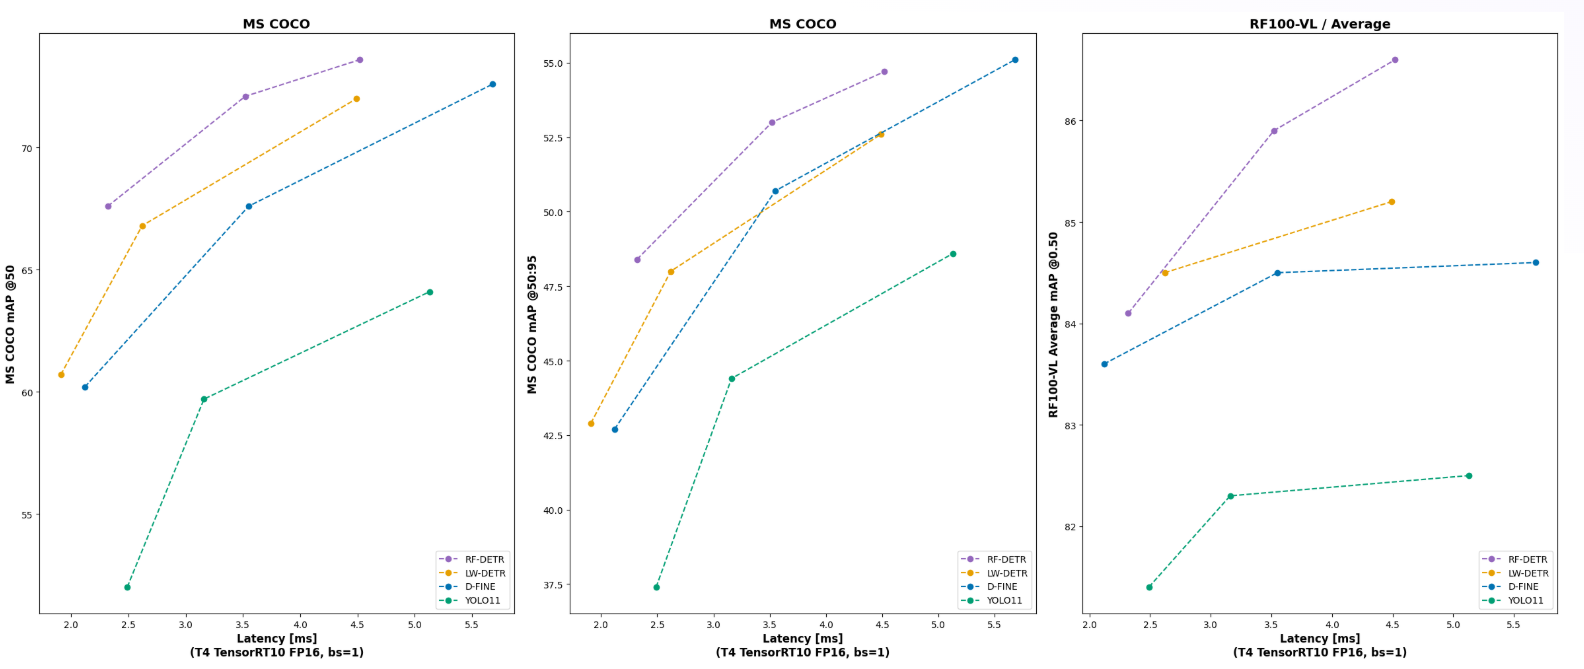
RF-DETR 是由 Roboflow 开发的基于 Transformer 的实时目标检测模型架构。
RF-DETR 系列模型在所有尺寸的目标检测模型中都是最快和最精确的。RF-DETR 在 Microsoft COCO 基准测试中取得了超过 60 mAP 的成绩,这是衡量目标检测性能的领先标准。它还在 RF100-VL 基准测试中创下了新纪录,该基准测试展示了模型在标准数据集之外适应现实问题的能力。
RF-DETR 模型组包括五种尺寸:Nano、Small、Medium、Base 和 Large。这些模型提供了满足不同需求的选择。例如,RF-DETR-Nano 比 YOLO11-n(在 mAP50:95 上)高 11 mAP,运行速度快 0.17 毫秒。同样,RF-DETR-Small 比 YOLO11-x(最大的 YOLO11 模型)好 1.8 mAP,速度快 7.77 毫秒。这种广泛的模型选择使 RF-DETR 成为许多现实应用的绝佳选择,从需要超快速度的小型设备到需要最高精度的大型任务。RF-DETR 足够小,可以在边缘设备上运行,非常适合需要高精度和实时性能的部署。
环境配置
安装依赖库
安装 RF-DETR 1.2.1 或更高版本(包含新的 Nano、Small 和 Medium 检查点),以及用于基准测试的 Supervision。
!pip install -q rfdetr==1.2.1 supervision==0.26.1
使用预训练的 COCO 模型进行推理
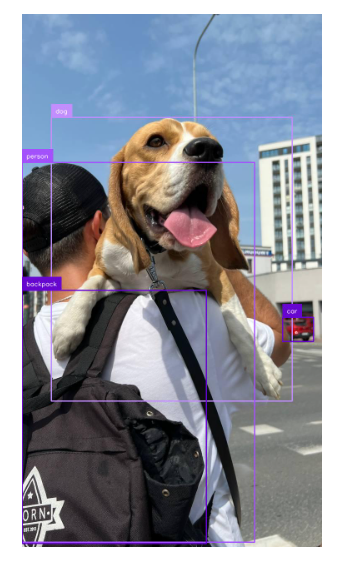
在示例图像上使用预训练的 RF-DETR Medium 模型(在 COCO 上训练)运行推理。要使用不同大小的模型,只需根据需要将 RFDETRMedium 替换为 RFDETRNano、RFDETRSmall、RFDETRBase 或 RFDETRLarge。
import numpy as np
import supervision as sv
from PIL import Image
from rfdetr import RFDETRMedium
from rfdetr.util.coco_classes import COCO_CLASSES

image = Image.open("dog-2.jpeg")

model = RFDETRMedium(resolution=640)
model.optimize_for_inference()

detections = model.predict(image, threshold=0.5)

color = sv.ColorPalette.from_hex([
    "#ffff00", "#ff9b00", "#ff8080", "#ff66b2", "#ff66ff", "#b266ff",
    "#9999ff", "#3399ff", "#66ffff", "#33ff99", "#66ff66", "#99ff00"
])
text_scale = sv.calculate_optimal_text_scale(resolution_wh=image.size)
thickness = sv.calculate_optimal_line_thickness(resolution_wh=image.size)

bbox_annotator = sv.BoxAnnotator(color=color, thickness=thickness)
label_annotator = sv.LabelAnnotator(
    color=color,
    text_color=sv.Color.BLACK,
    text_scale=text_scale,
    smart_position=True
)

labels = [
    f"{COCO_CLASSES[class_id]} {confidence:.2f}"
    for class_id, confidence
    in zip(detections.class_id, detections.confidence)
]

annotated_image = image.copy()
annotated_image = bbox_annotator.annotate(annotated_image, detections)
annotated_image = label_annotator.annotate(annotated_image, detections, labels)
annotated_image.thumbnail((800, 800))
annotated_image
在自定义数据集上训练 RF-DETR模型
准备数据集
RF-DETR 期望数据集采用 COCO 格式。将您的数据集分为三个子目录:train、valid 和 test。每个子目录应包含自己的 _annotations.coco.json 文件,该文件保存该特定分割的注释,以及相应的图像文件。以下是目录结构的示例:
dataset/
├── train/
│   ├── _annotations.coco.json
│   ├── image1.jpg
│   ├── image2.jpg
│   └── ... (其他图像文件)
├── valid/
│   ├── _annotations.coco.json
│   ├── image1.jpg
│   ├── image2.jpg
│   └── ... (其他图像文件)
└── test/
    ├── _annotations.coco.json
    ├── image1.jpg
    ├── image2.jpg
    └── ... (其他图像文件)
训练模型
选择合适的 batch_size
不同的 GPU 具有不同数量的 VRAM(视频内存),这限制了它们在训练期间一次可以处理的数据量。为了使训练在任何机器上都能正常工作,您可以调整两个设置:batch_size 和 grad_accum_steps。这些控制一次处理的样本数量。关键是保持它们的乘积等于 16 — 这是我们推荐的总批量大小。例如,在 A100 等强大的 GPU 上,设置 batch_size=16 和 grad_accum_steps=1。在 T4 等较小的 GPU 上,使用 batch_size=4 和 grad_accum_steps=4。我们使用一种称为梯度累积的方法,该方法允许模型通过逐步收集更新然后调整权重来模拟使用较大批量大小的训练。
from rfdetr import RFDETRMedium

model = RFDETRMedium()

model.train(dataset_dir=dataset.location,
epochs=10,
batch_size=8,
grad_accum_steps=2)
训练参数说明
以下是参数描述的Markdown表格格式:
| 参数 | 描述 |
|---|---|
| dataset_dir | 指定 COCO 格式的数据集位置,其中包含 train、valid 和 test 文件夹,每个文件夹都包含 _annotations.coco.json。确保模型可以正确读取和解析数据。 |
| output_dir | 训练结果相关文件存放路径。 |
| epochs | 数据集上的完整训练轮次。增加这个可以提高性能,但延长总训练时间。 |
| batch_size | 每次迭代处理的样本数。较高的值需要更多的 GPU 内存,但可以加快训练速度。必须与 grad_accum_steps 平衡,以保持预期的总批量。 |
| grad_accum_steps | 在多个小批处理上累积梯度,有效地提高总批处理大小,而无需一次占用大量内存。帮助在较小的 GPU 上进行训练,每次更新的时间稍长。 |
| lr | 模型训练的学习率。影响模型调整其参数的速度。 |
| lr_encoder | 学习速率专门用于模型的编码器部分。用于以不同的速度微调编码器层。 |
| resolution | 设置输入图像尺寸。更高的值可以提高准确性,但需要更多的内存,并可能减慢训练。必须能被56整除。 |
| weight_decay | L2 正则化的系数。通过惩罚较大的权重来帮助防止过度拟合,通常可以提高泛化能力。 |
| device | 指定硬件(例如,CPU 或 cuda)上运行训练。GPU 显著加快了训练速度。 |
| use_ema | 启用权重的指数移动平均,生成平滑的检查点。通常以轻微的开销提高最终性能。 |
| gradient_checkpointing | 在反向传播期间重新计算前向传递的部分,以减少内存使用。降低记忆需求,但增加训练时间。 |
| checkpoint_interval | 保存模型检查点的频率(以epoch为单位)。更频繁的保存可以提供更好的覆盖范围,但会消耗更多的存储空间。 |
| resume | 用于继续培训的已保存检查点的路径。恢复模型权重和优化器状态。 |
| tensorboard | 支持将训练指标记录到 TensorBoard,以监控进度和性能。 |
| wandb | 激活对权重和偏差的日志记录,促进基于云的实验跟踪和可视化。 |
| project | 权重和偏差记录的项目名称。将多个试验分组到单个标题下。 |
| run | 权重和偏差日志的运行名称,有助于区分项目中的各个培训课程。 |
| early_stopping | 启用提前停止机制,用于监视 mAP 的改进,以决定是否应停止训练。有助于避免 mAP 稳定时出现不必要的时期。 |
| early_stopping_patience | 停止前无 mAP 改善的连续时期数。防止在最小收益上浪费资源。 |
| early_stopping_min_delta | mAP 的最小变化符合改善的条件。 |
| early_stopping_use_ema | 是否使用 EMA 版本的模型跟踪改进。如果可用,则使用 EMA 指标,否则返回常规 mAP。 |
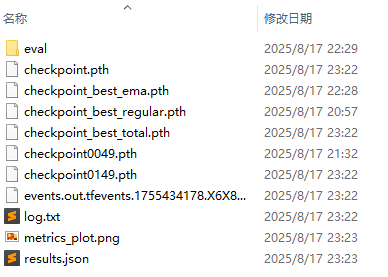
训练完成后,结果将保存在 /content/output 目录中:
在训练过程中,多个模型检查点被保存到输出目录,说明如下:
checkpoint.pth-最近的检查点,保存在最后一个 epoch 的模型。
checkpoint_.pth-每 N 个 epoch 保存一次定期检查点(默认为每 10 个)。
checkpoint_best_ema.pth-基于验证分数的最佳检查点,使用 EMA(指数移动平均)权重。EMA 权重是模型参数在训练步骤中的平滑版本,通常会产生更好的泛化能力。
checkpoint_best_regular.pth-基于验证分数的最佳检查点,使用原始(非 EMA)模型权重。
checkpoint_best_total.pth-为推理和基准测试选择的最终检查点。它只包含模型权重(没有优化器状态或调度程序),并根据验证性能选择 EMA 和非 EMA 模型中较好的一个。
使用训练好的模型进行推理
我们使用 RFDETRMedium 类从 checkpoint_best_total.pth 文件加载性能最佳的模型。此检查点包含我们最成功的训练运行的训练权重。加载后,我们调用 optimize_for_inference(),它准备模型以进行高效推理。
model = RFDETRMedium(pretrain_weights="/content/output/checkpoint_best_total.pth")
model.optimize_for_inference()
运行推理并可视化结果:
from rfdetr import RFDETRBase
import supervision as sv
from PIL import Image

path, image, annotations = ds[0]
image = Image.open(path)

detections = model.predict(image, threshold=0.5)

text_scale = sv.calculate_optimal_text_scale(resolution_wh=image.size)
thickness = sv.calculate_optimal_line_thickness(resolution_wh=image.size)
color = sv.ColorPalette.from_hex([
    "#ffff00", "#ff9b00", "#ff66ff", "#3399ff", "#ff66b2", "#ff8080",
    "#b266ff", "#9999ff", "#66ffff", "#33ff99", "#66ff66", "#99ff00"
])

bbox_annotator = sv.BoxAnnotator(color=color,thickness=thickness)
label_annotator = sv.LabelAnnotator(
    color=color,
    text_color=sv.Color.BLACK,
    text_scale=text_scale)

annotations_labels = [
    f"{ds.classes[class_id]}"
    for class_id
    in annotations.class_id
]

detections_labels = [
    f"{ds.classes[class_id]} {confidence:.2f}"
    for class_id, confidence
    in zip(detections.class_id, detections.confidence)
]

annotation_image = image.copy()
annotation_image = bbox_annotator.annotate(annotation_image, annotations)
annotation_image = label_annotator.annotate(annotation_image, annotations, annotations_labels)

detections_image = image.copy()
detections_image = bbox_annotator.annotate(detections_image, detections)
detections_image = label_annotator.annotate(detections_image, detections, detections_labels)

sv.plot_images_grid(images=[annotation_image, detections_image], grid_size=(1, 2), titles=["Annotation", "Detection"])
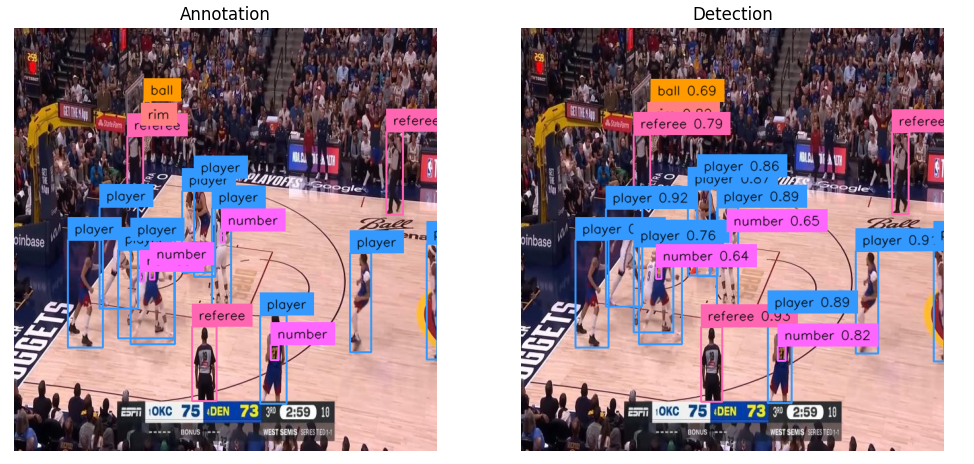
评估训练好的RF-DETR 模型
加载测试数据集:
import supervision as sv

ds = sv.DetectionDataset.from_coco(
    images_directory_path=f"{dataset.location}/test",
    annotations_path=f"{dataset.location}/test/_annotations.coco.json",
)
模型评估:
import supervision as sv
from tqdm import tqdm
from supervision.metrics import MeanAveragePrecision

targets = []
predictions = []

for path, image, annotations in tqdm(ds):
    image = Image.open(path)
    detections = model.predict(image, threshold=0)

    targets.append(annotations)
    predictions.append(detections)

map_metric = MeanAveragePrecision()
map_result = map_metric.update(predictions, targets).compute()
print(map_result)
Average Precision (AP) @[ IoU=0.50:0.95 | area= all | maxDets=100 ] = 0.407
Average Precision (AP) @[ IoU=0.50 | area= all | maxDets=100 ] = 0.844
Average Precision (AP) @[ IoU=0.75 | area= all | maxDets=100 ] = 0.309
Average Precision (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.000
Average Precision (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.409
Average Precision (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.391
训练结果可视化
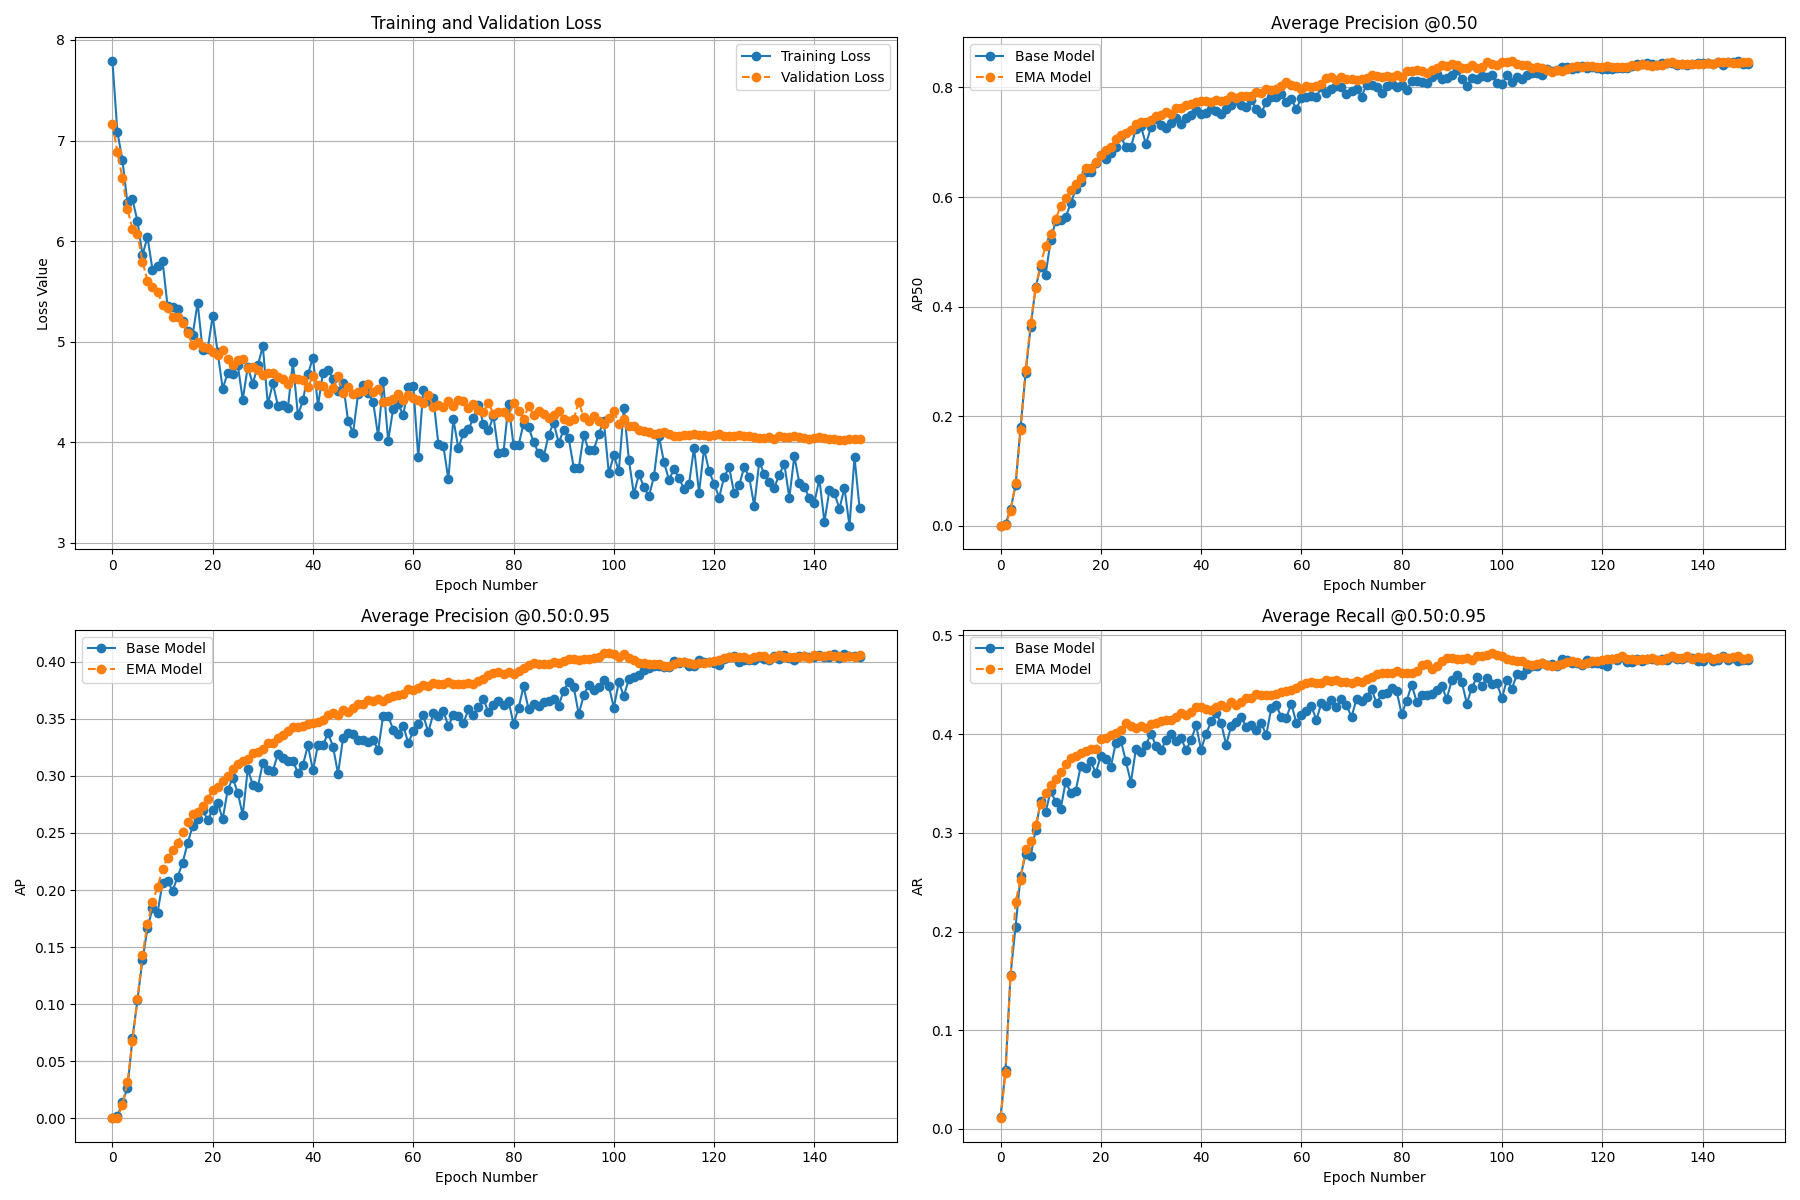
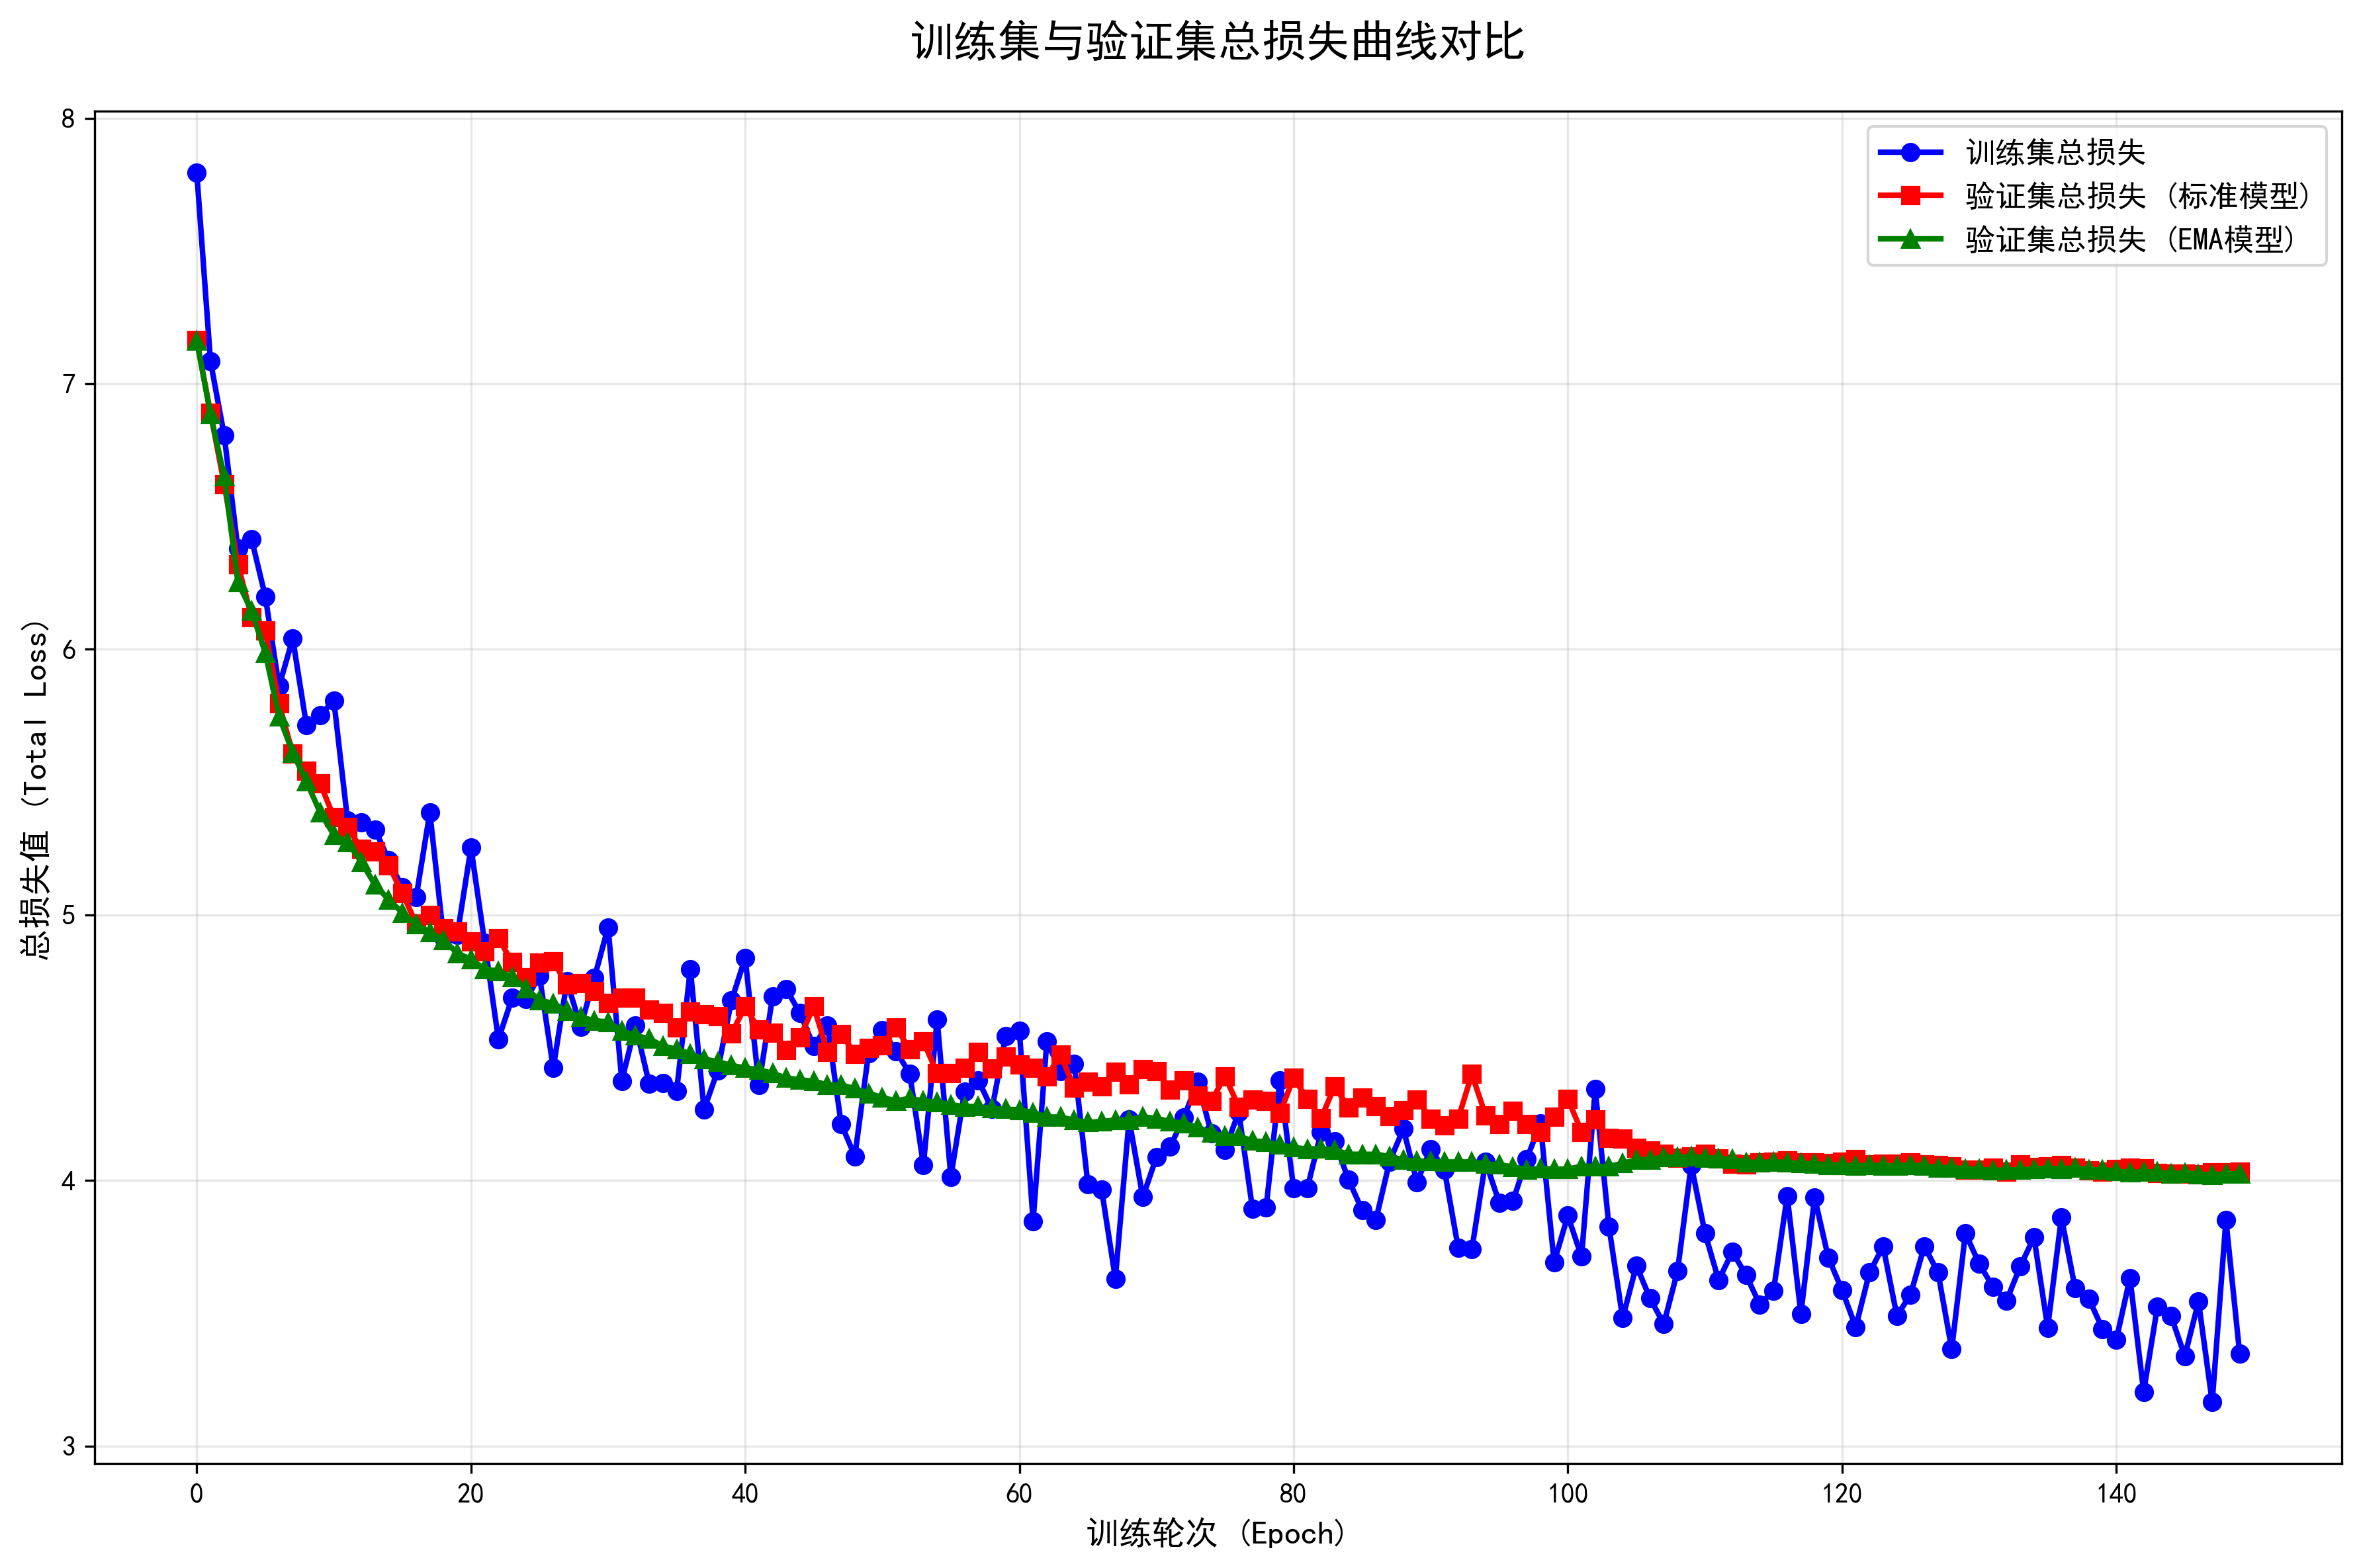
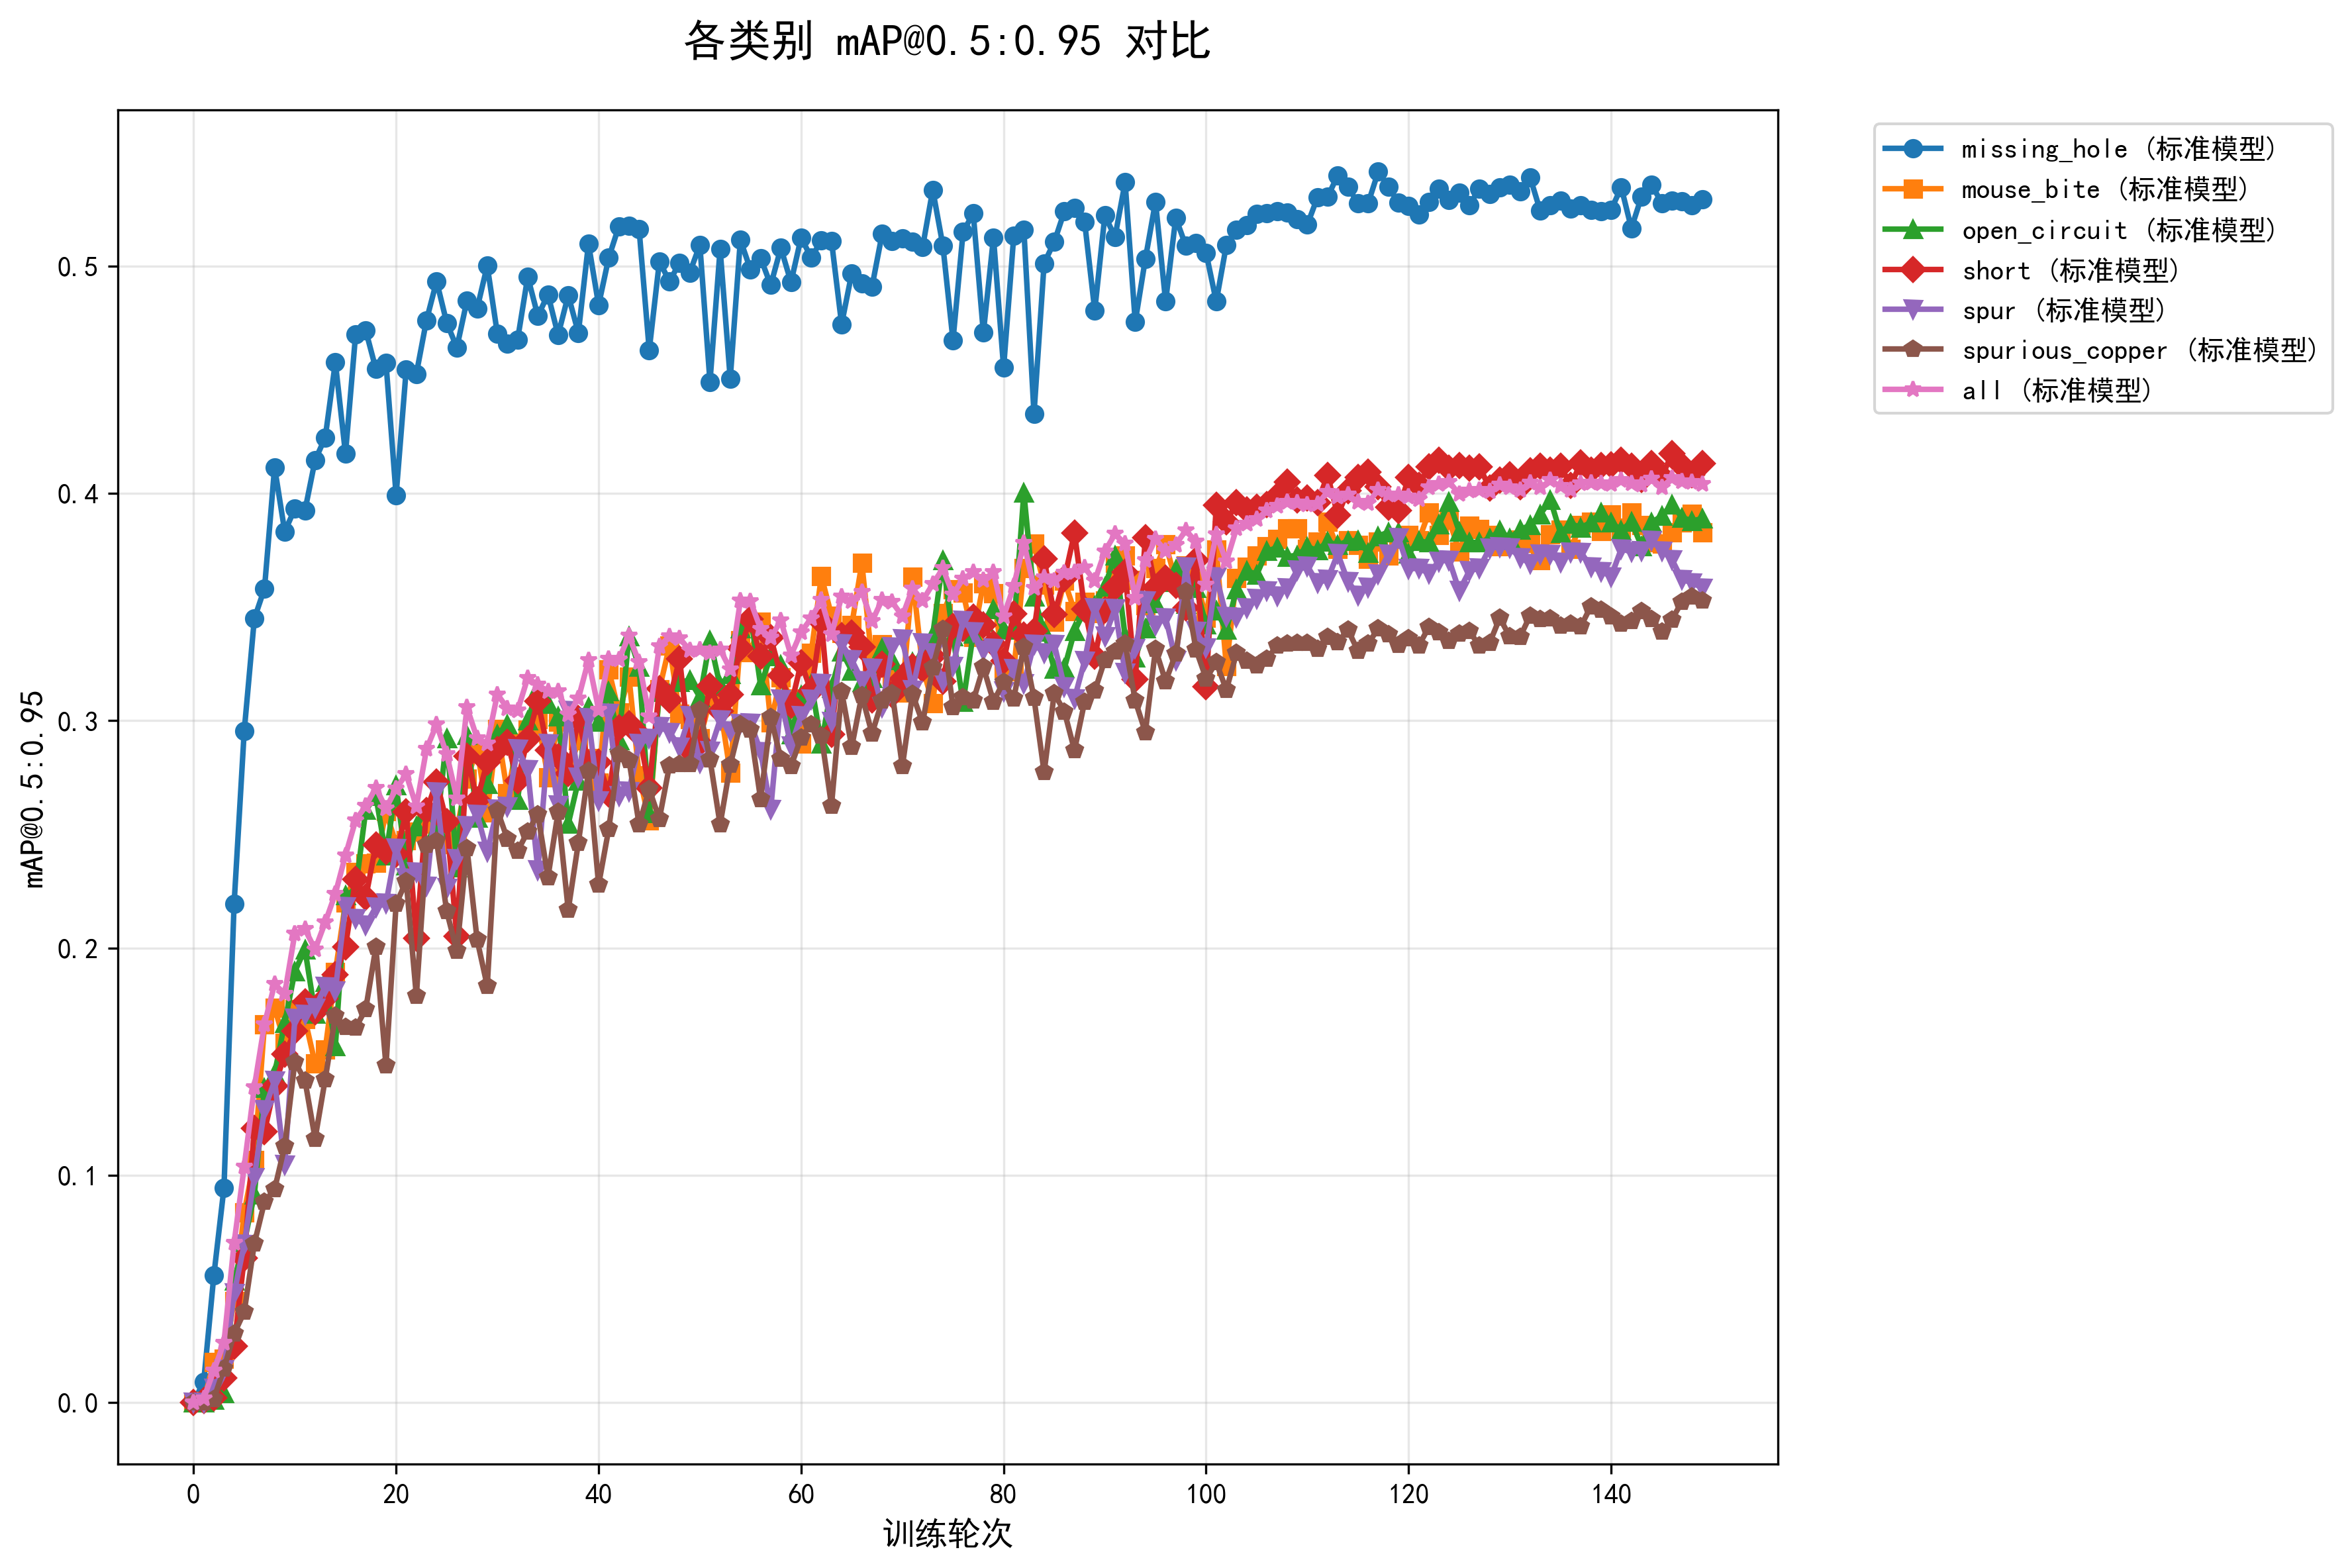
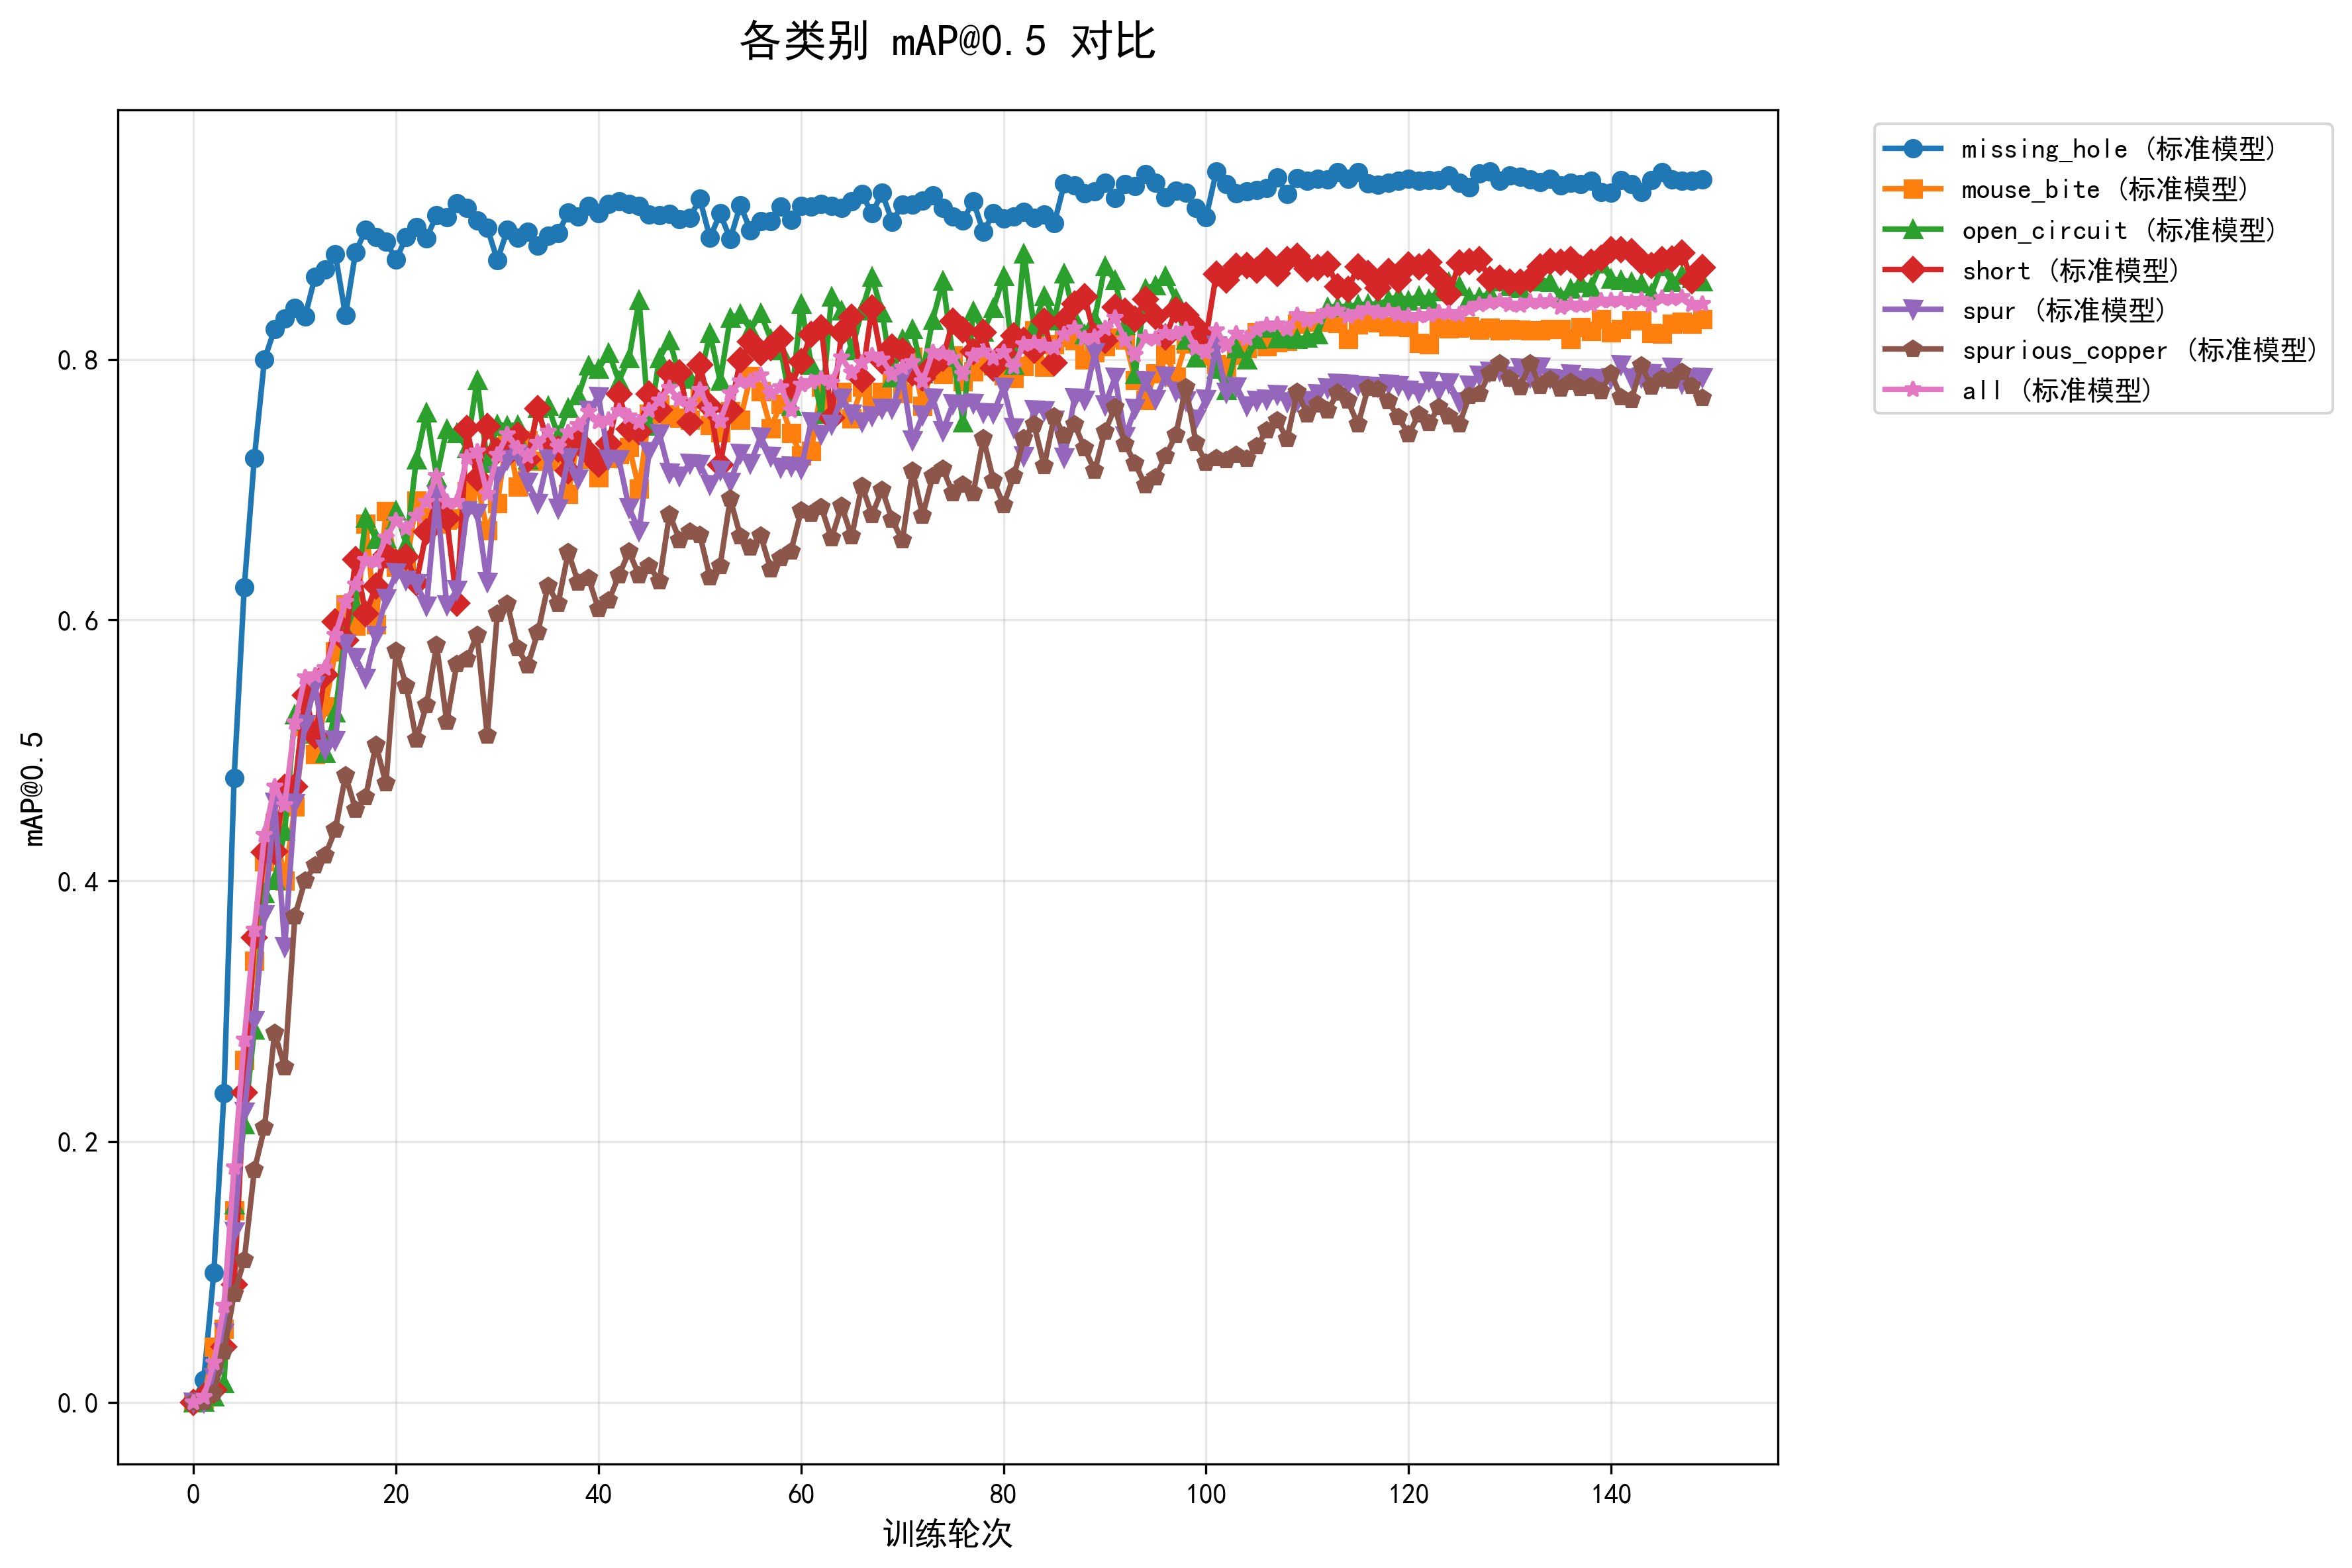
以下为在某PCB板缺陷检测数据集上训练结果可视化后的相关结果:
训练损失曲线:
mAP@0.5:0.95曲线:
mAP@0.5曲线:
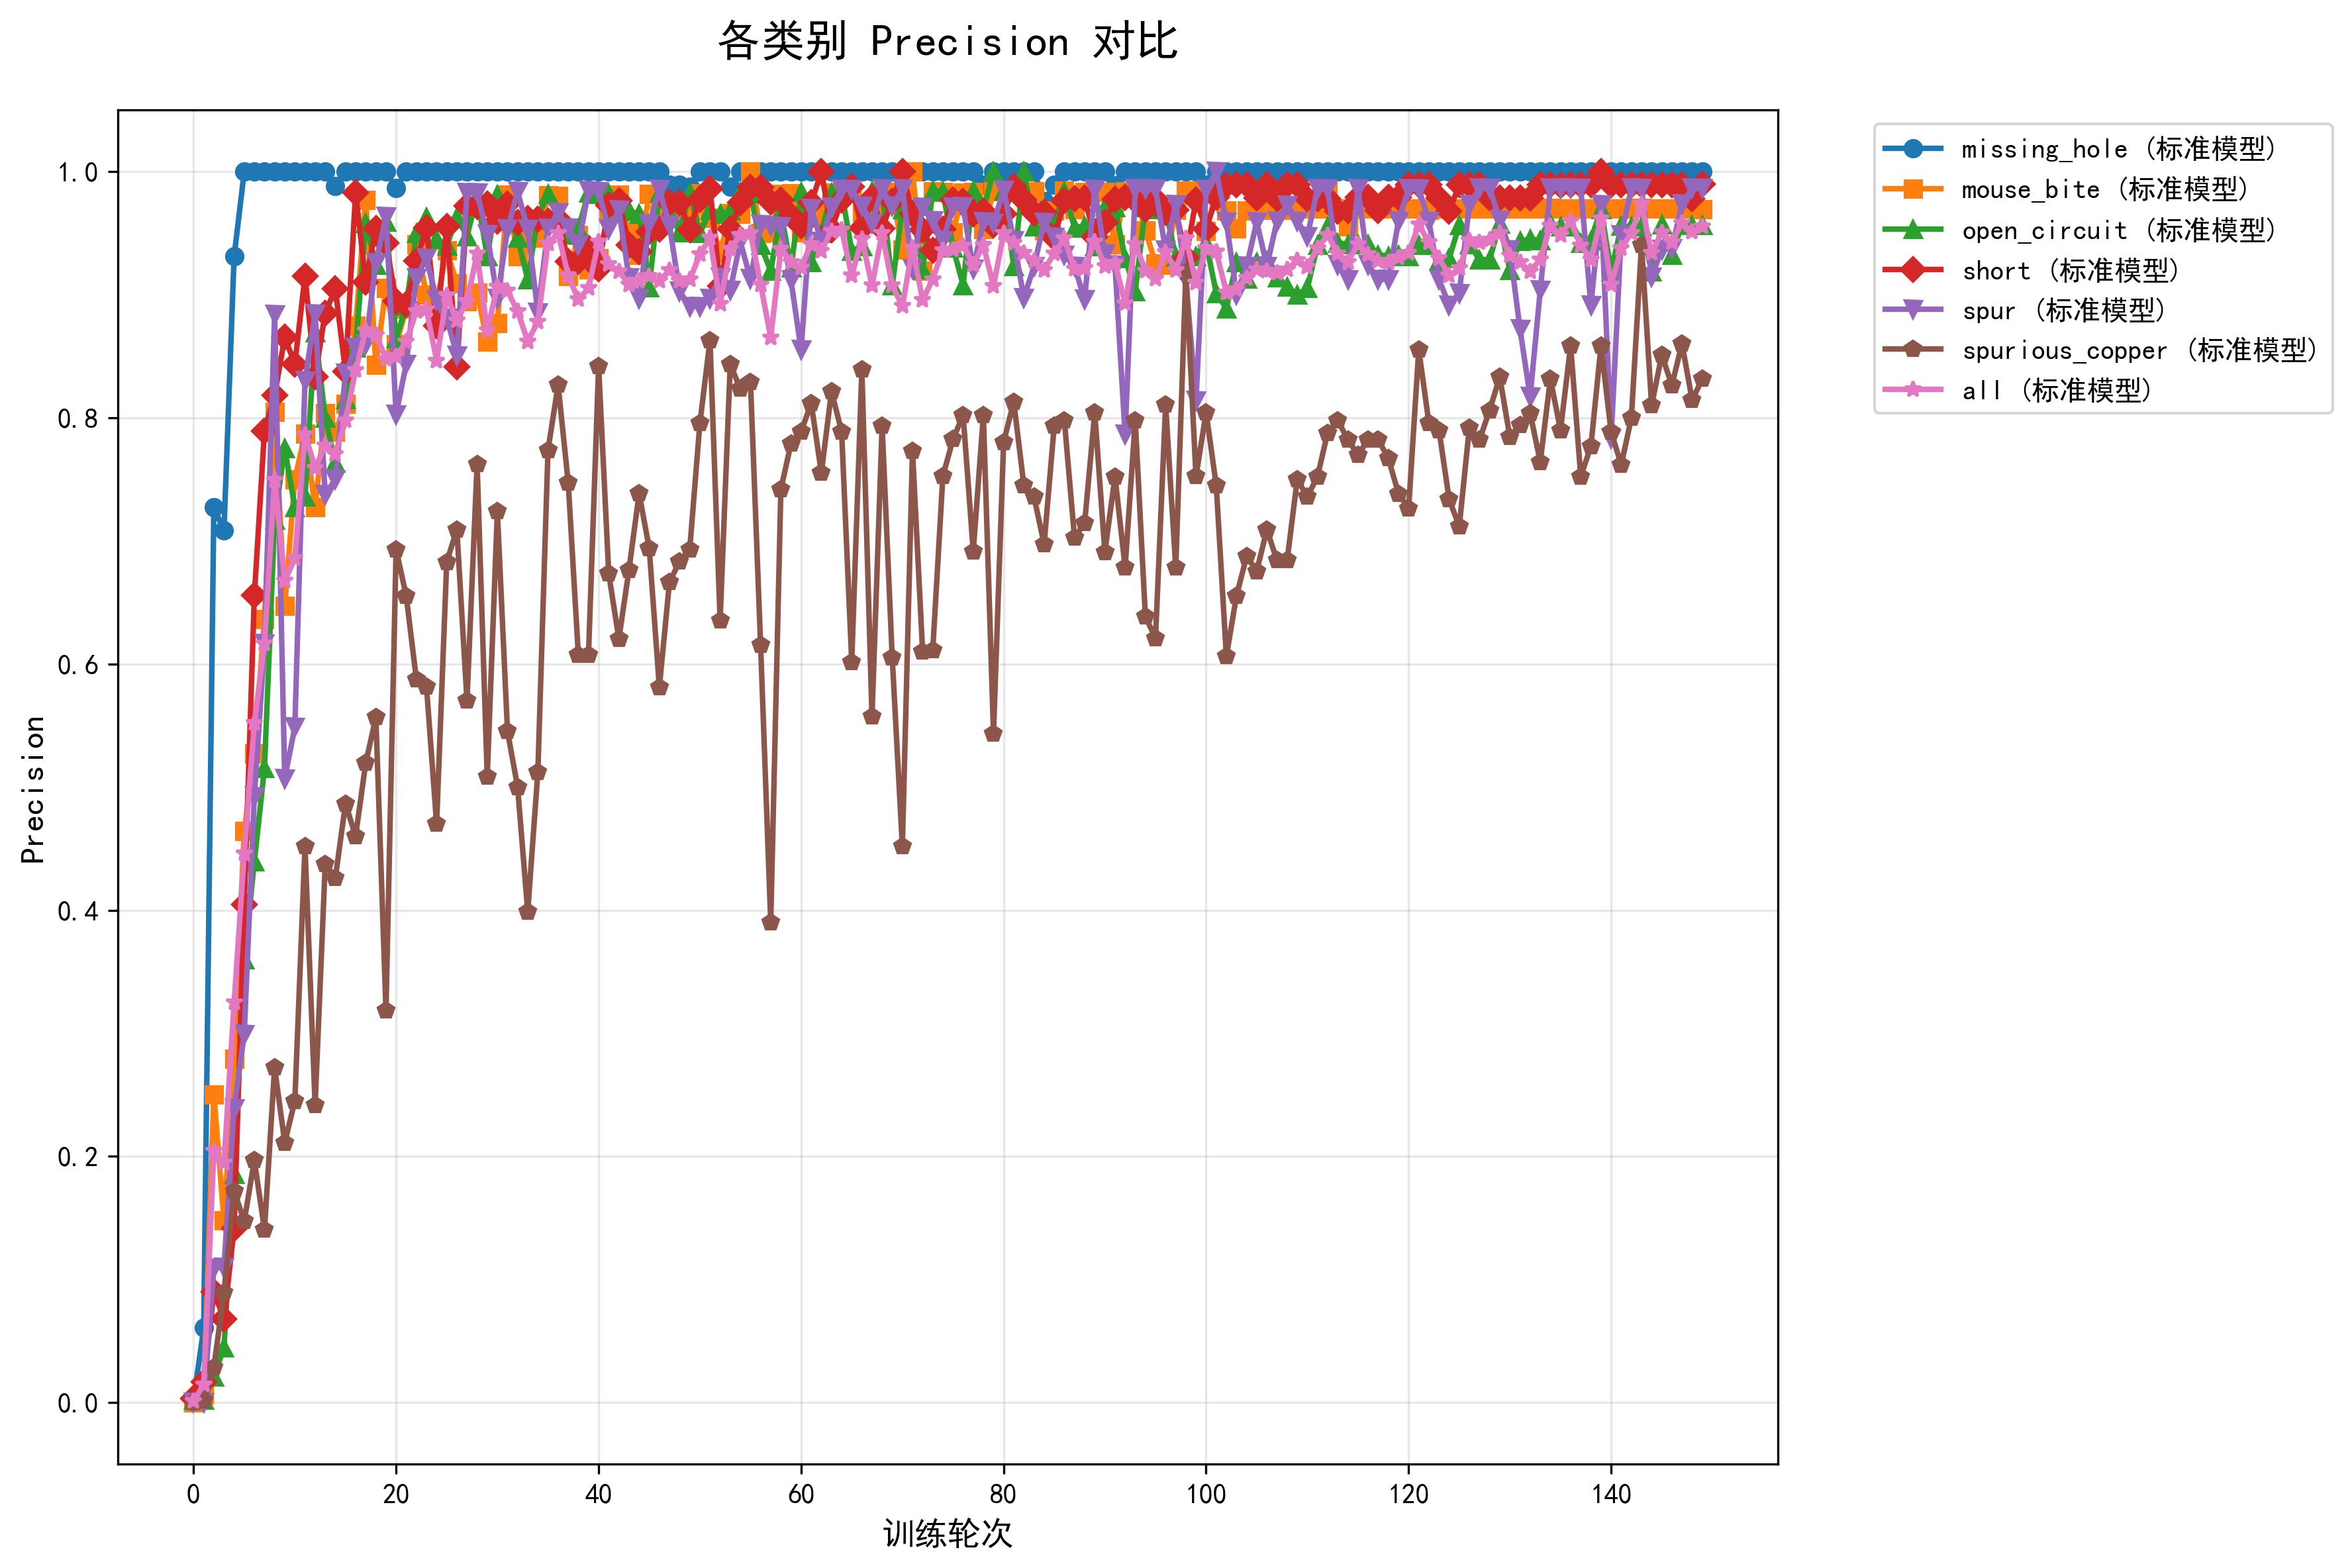
Precision曲线:
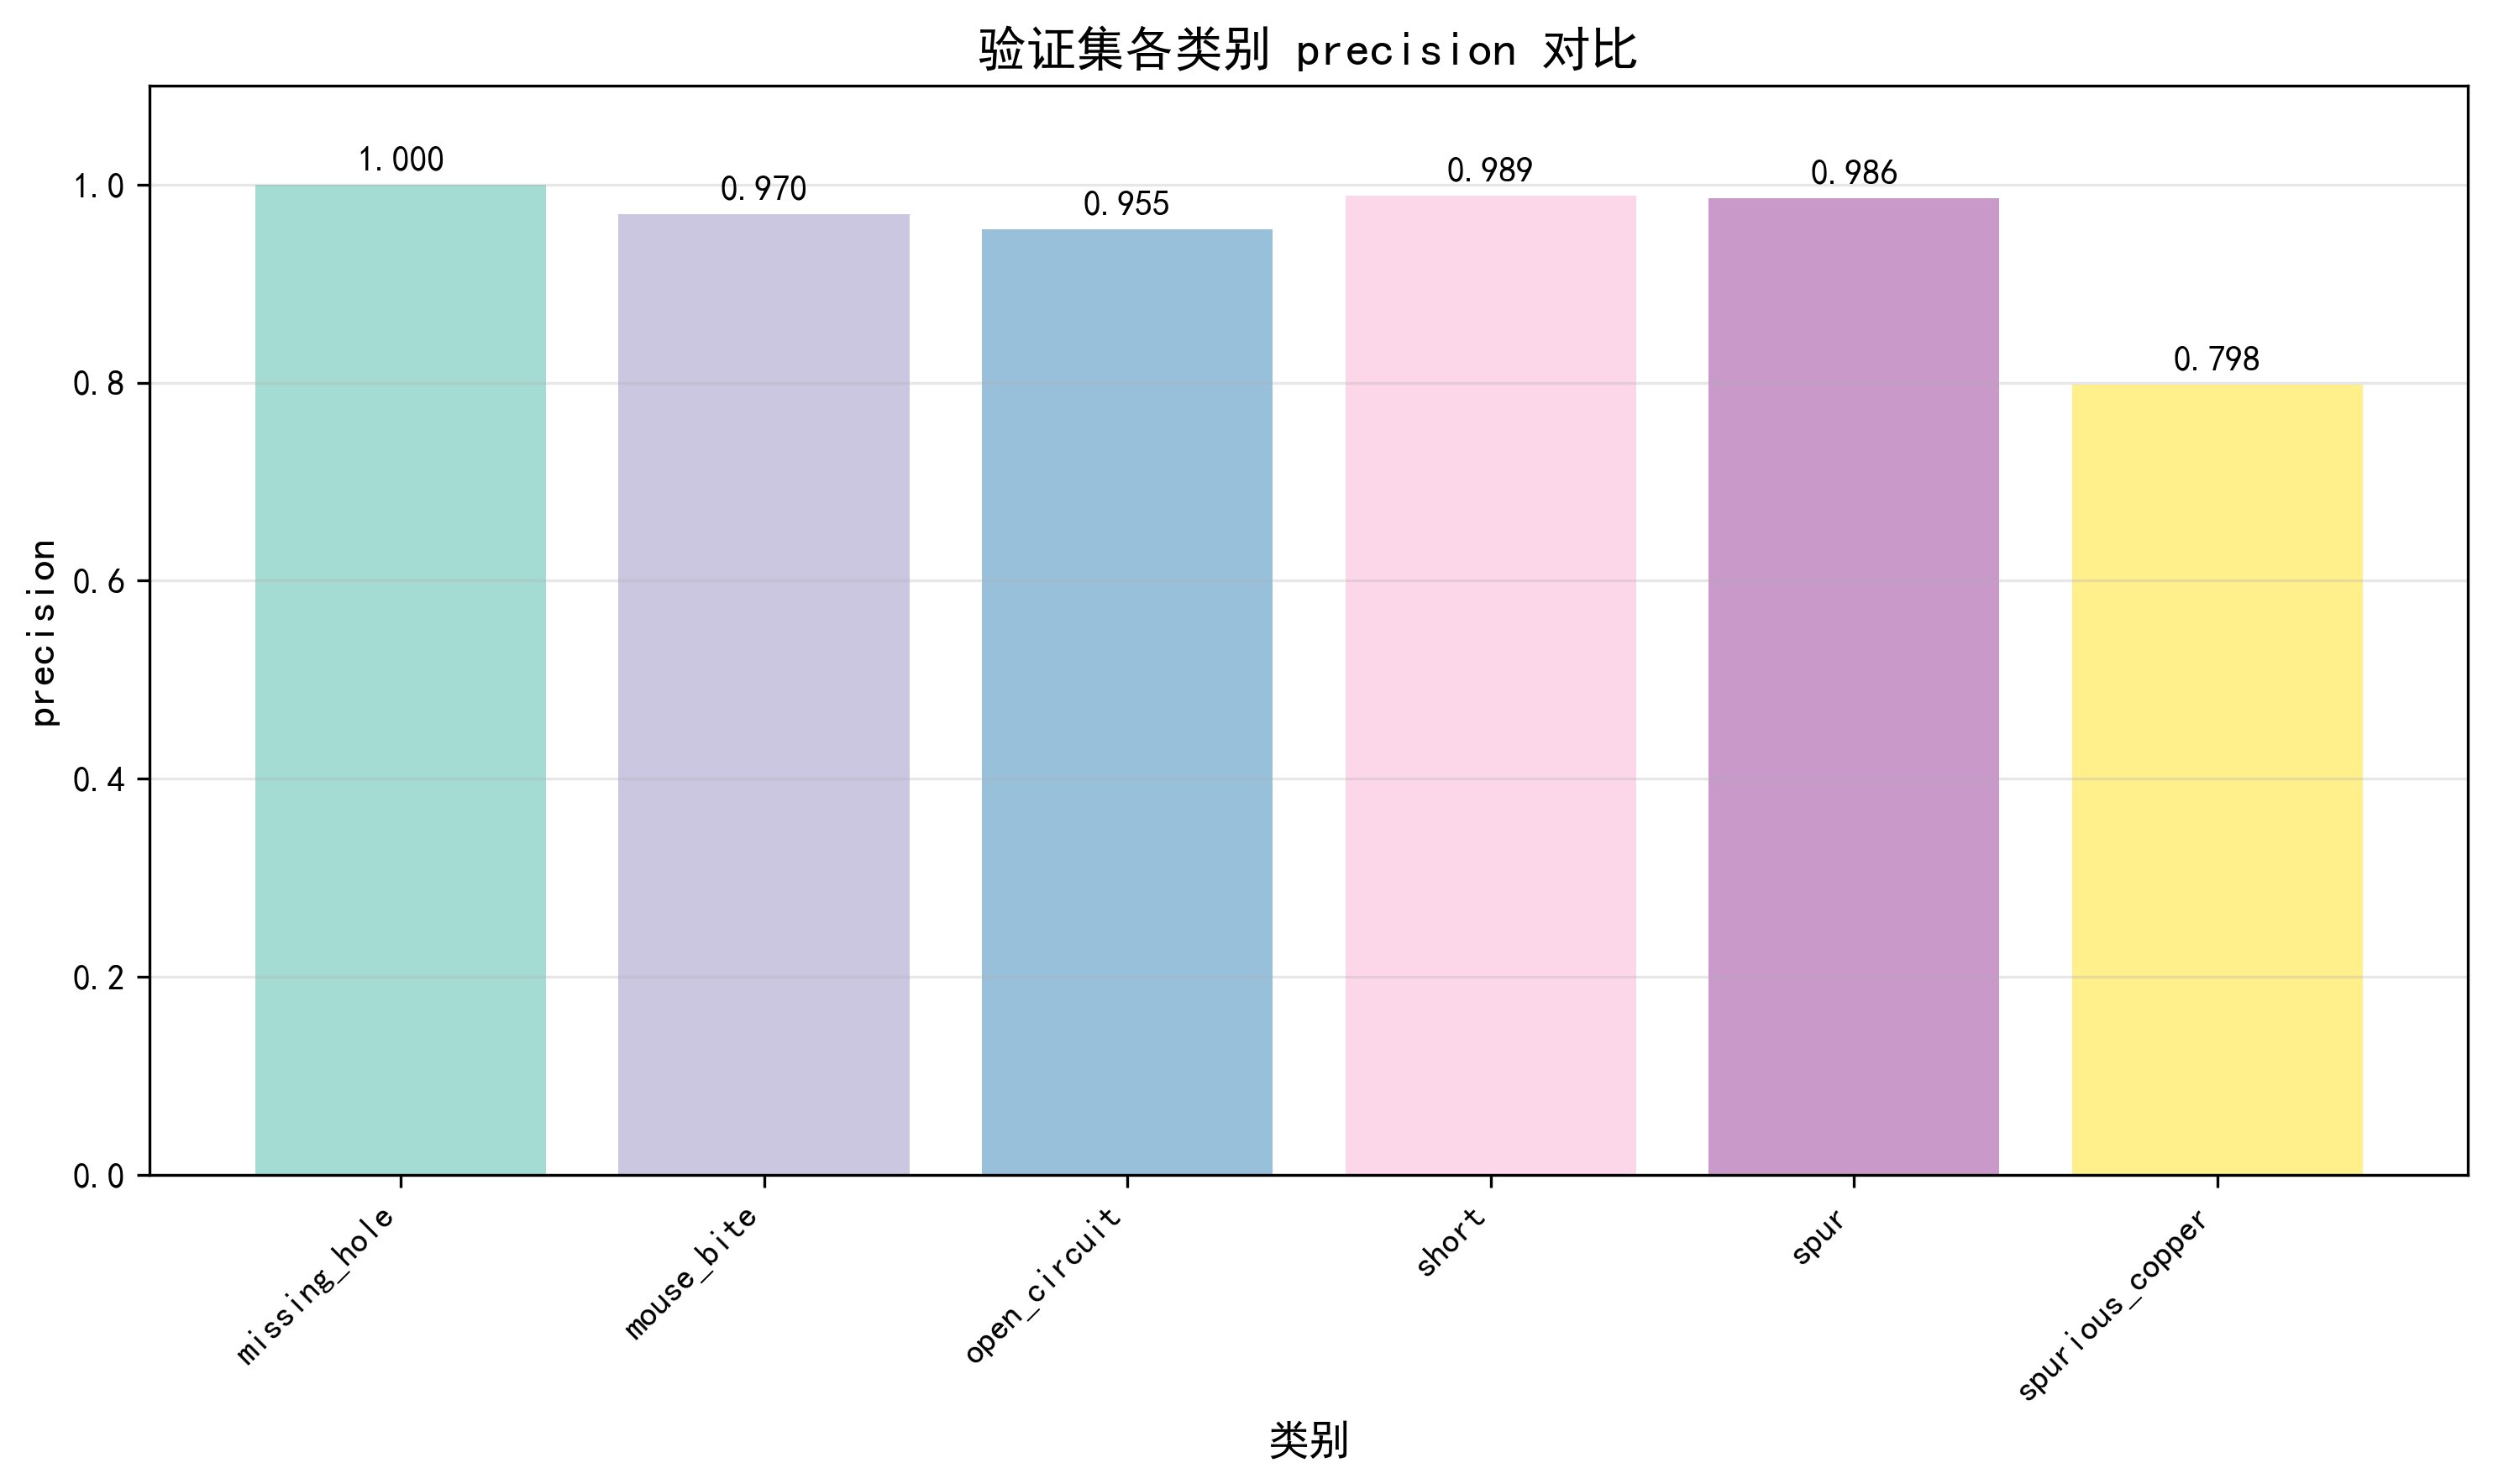
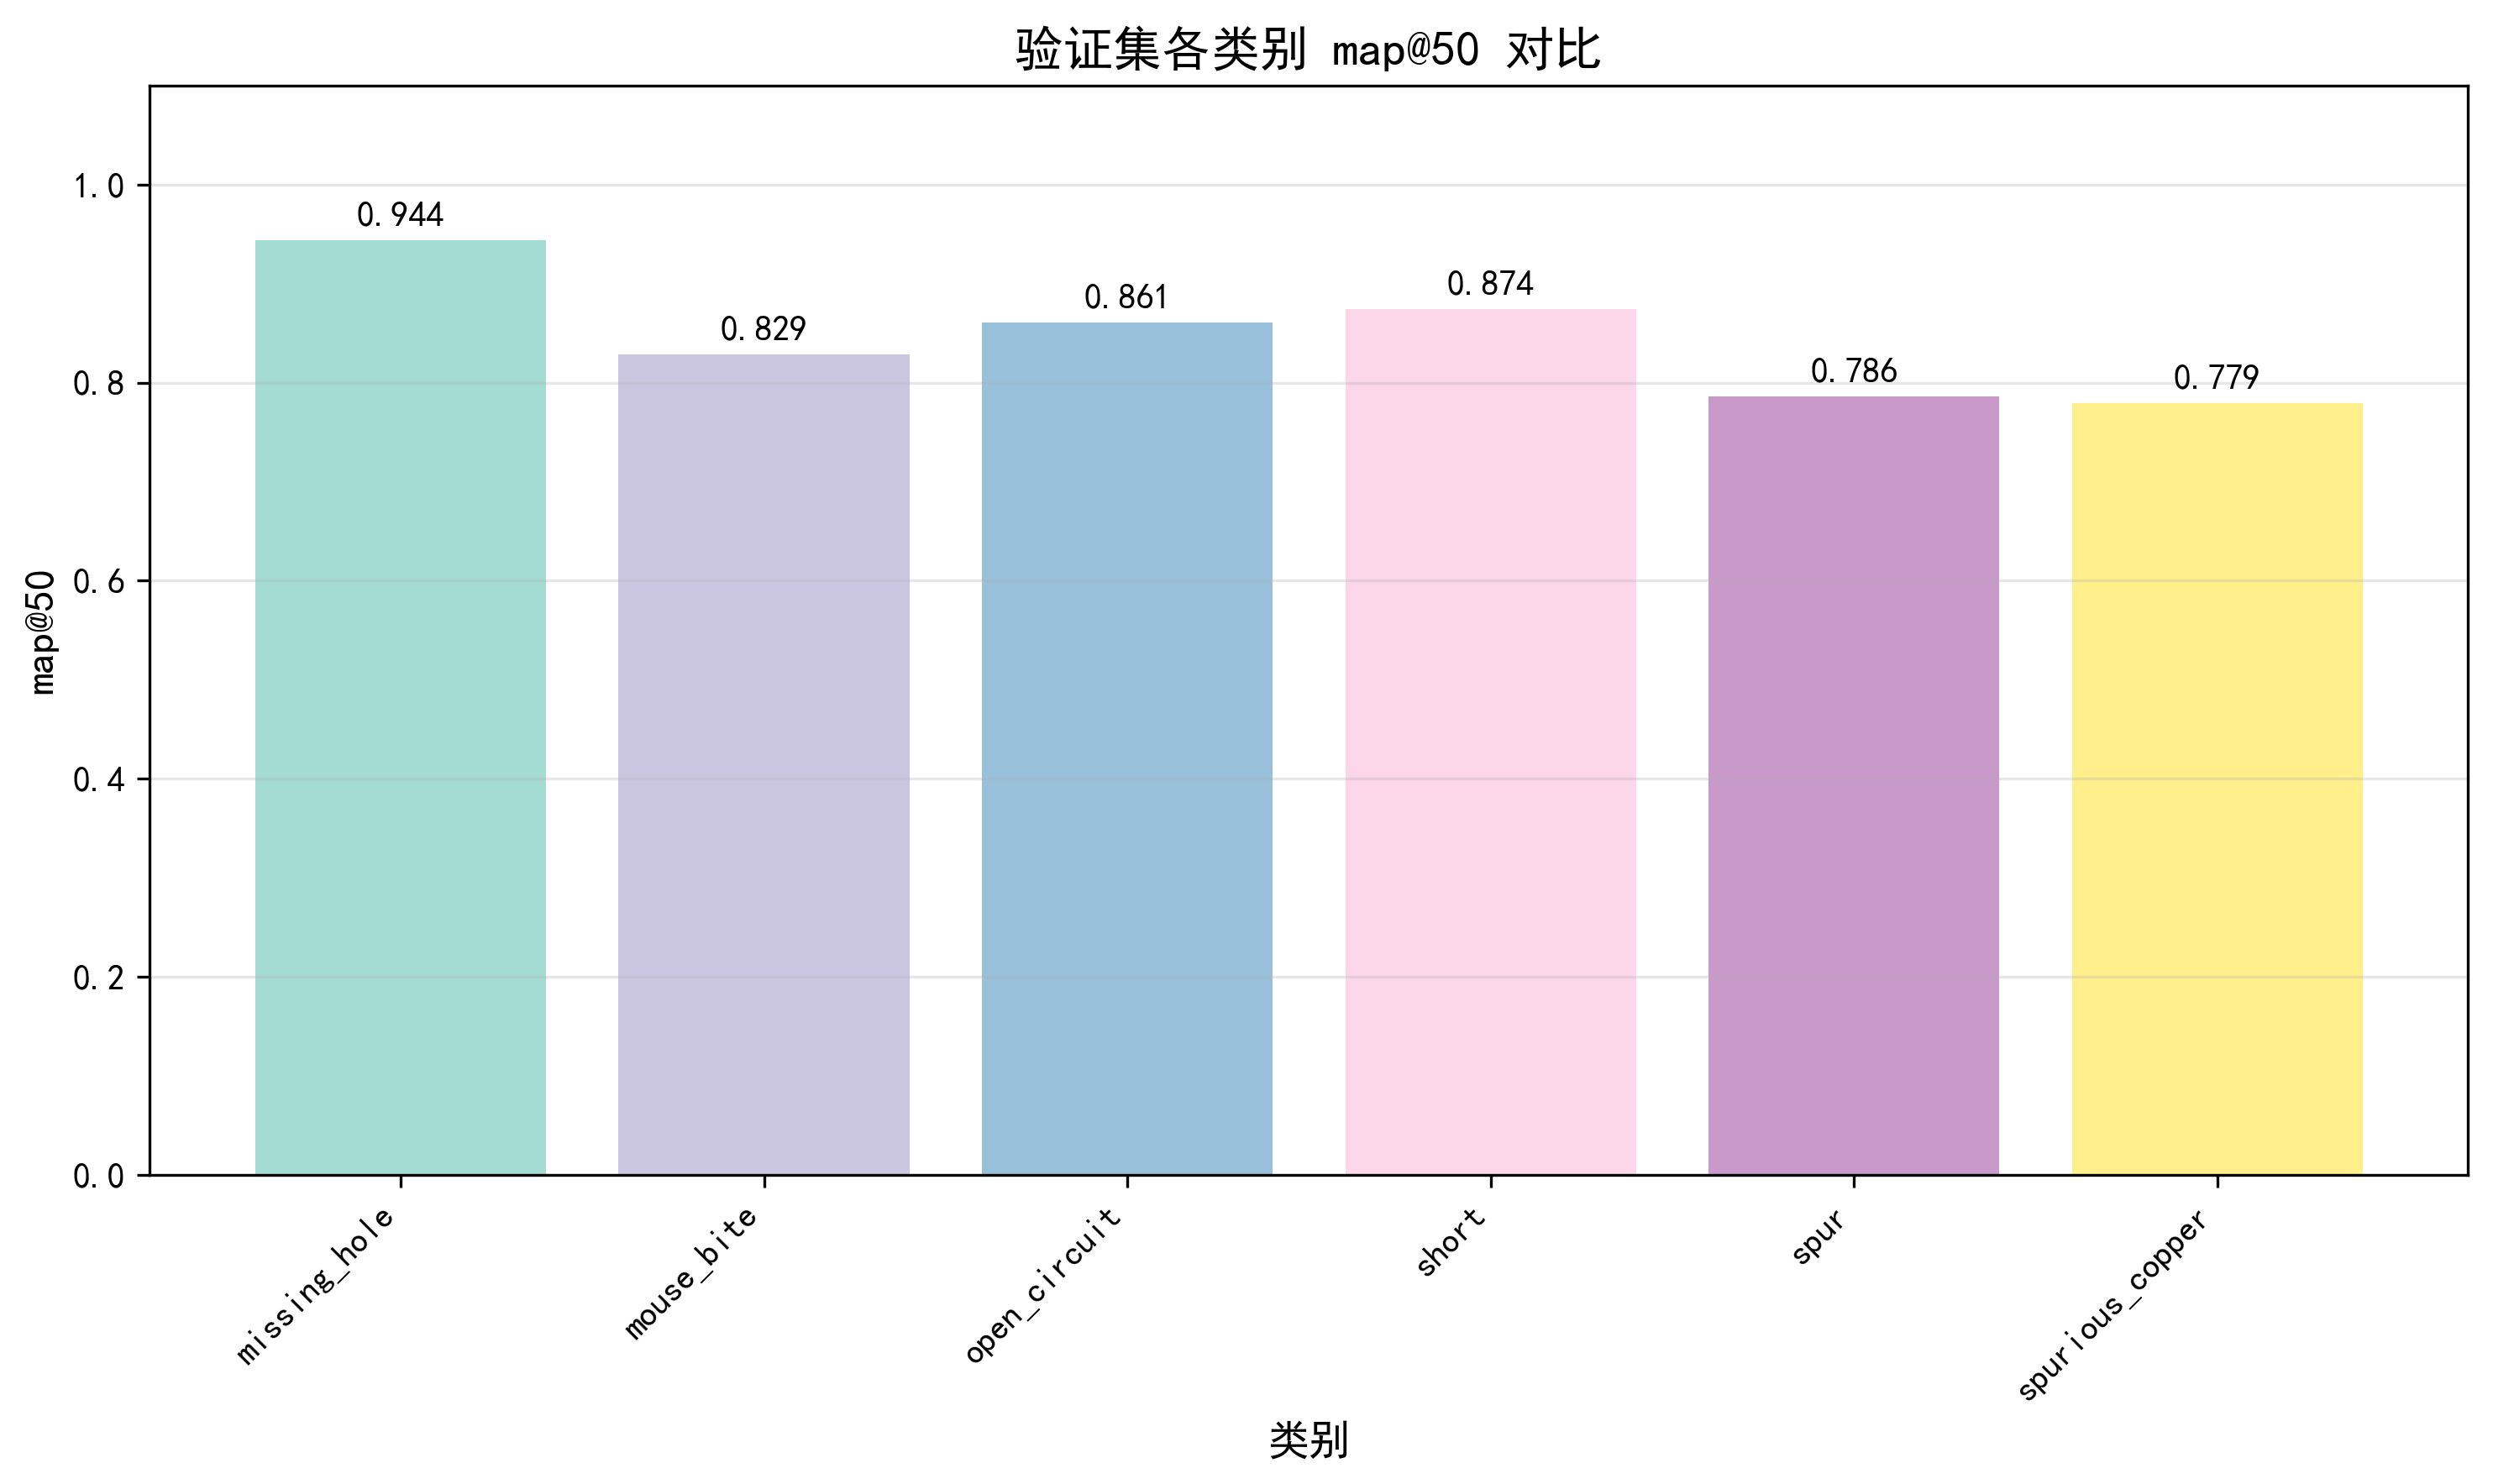
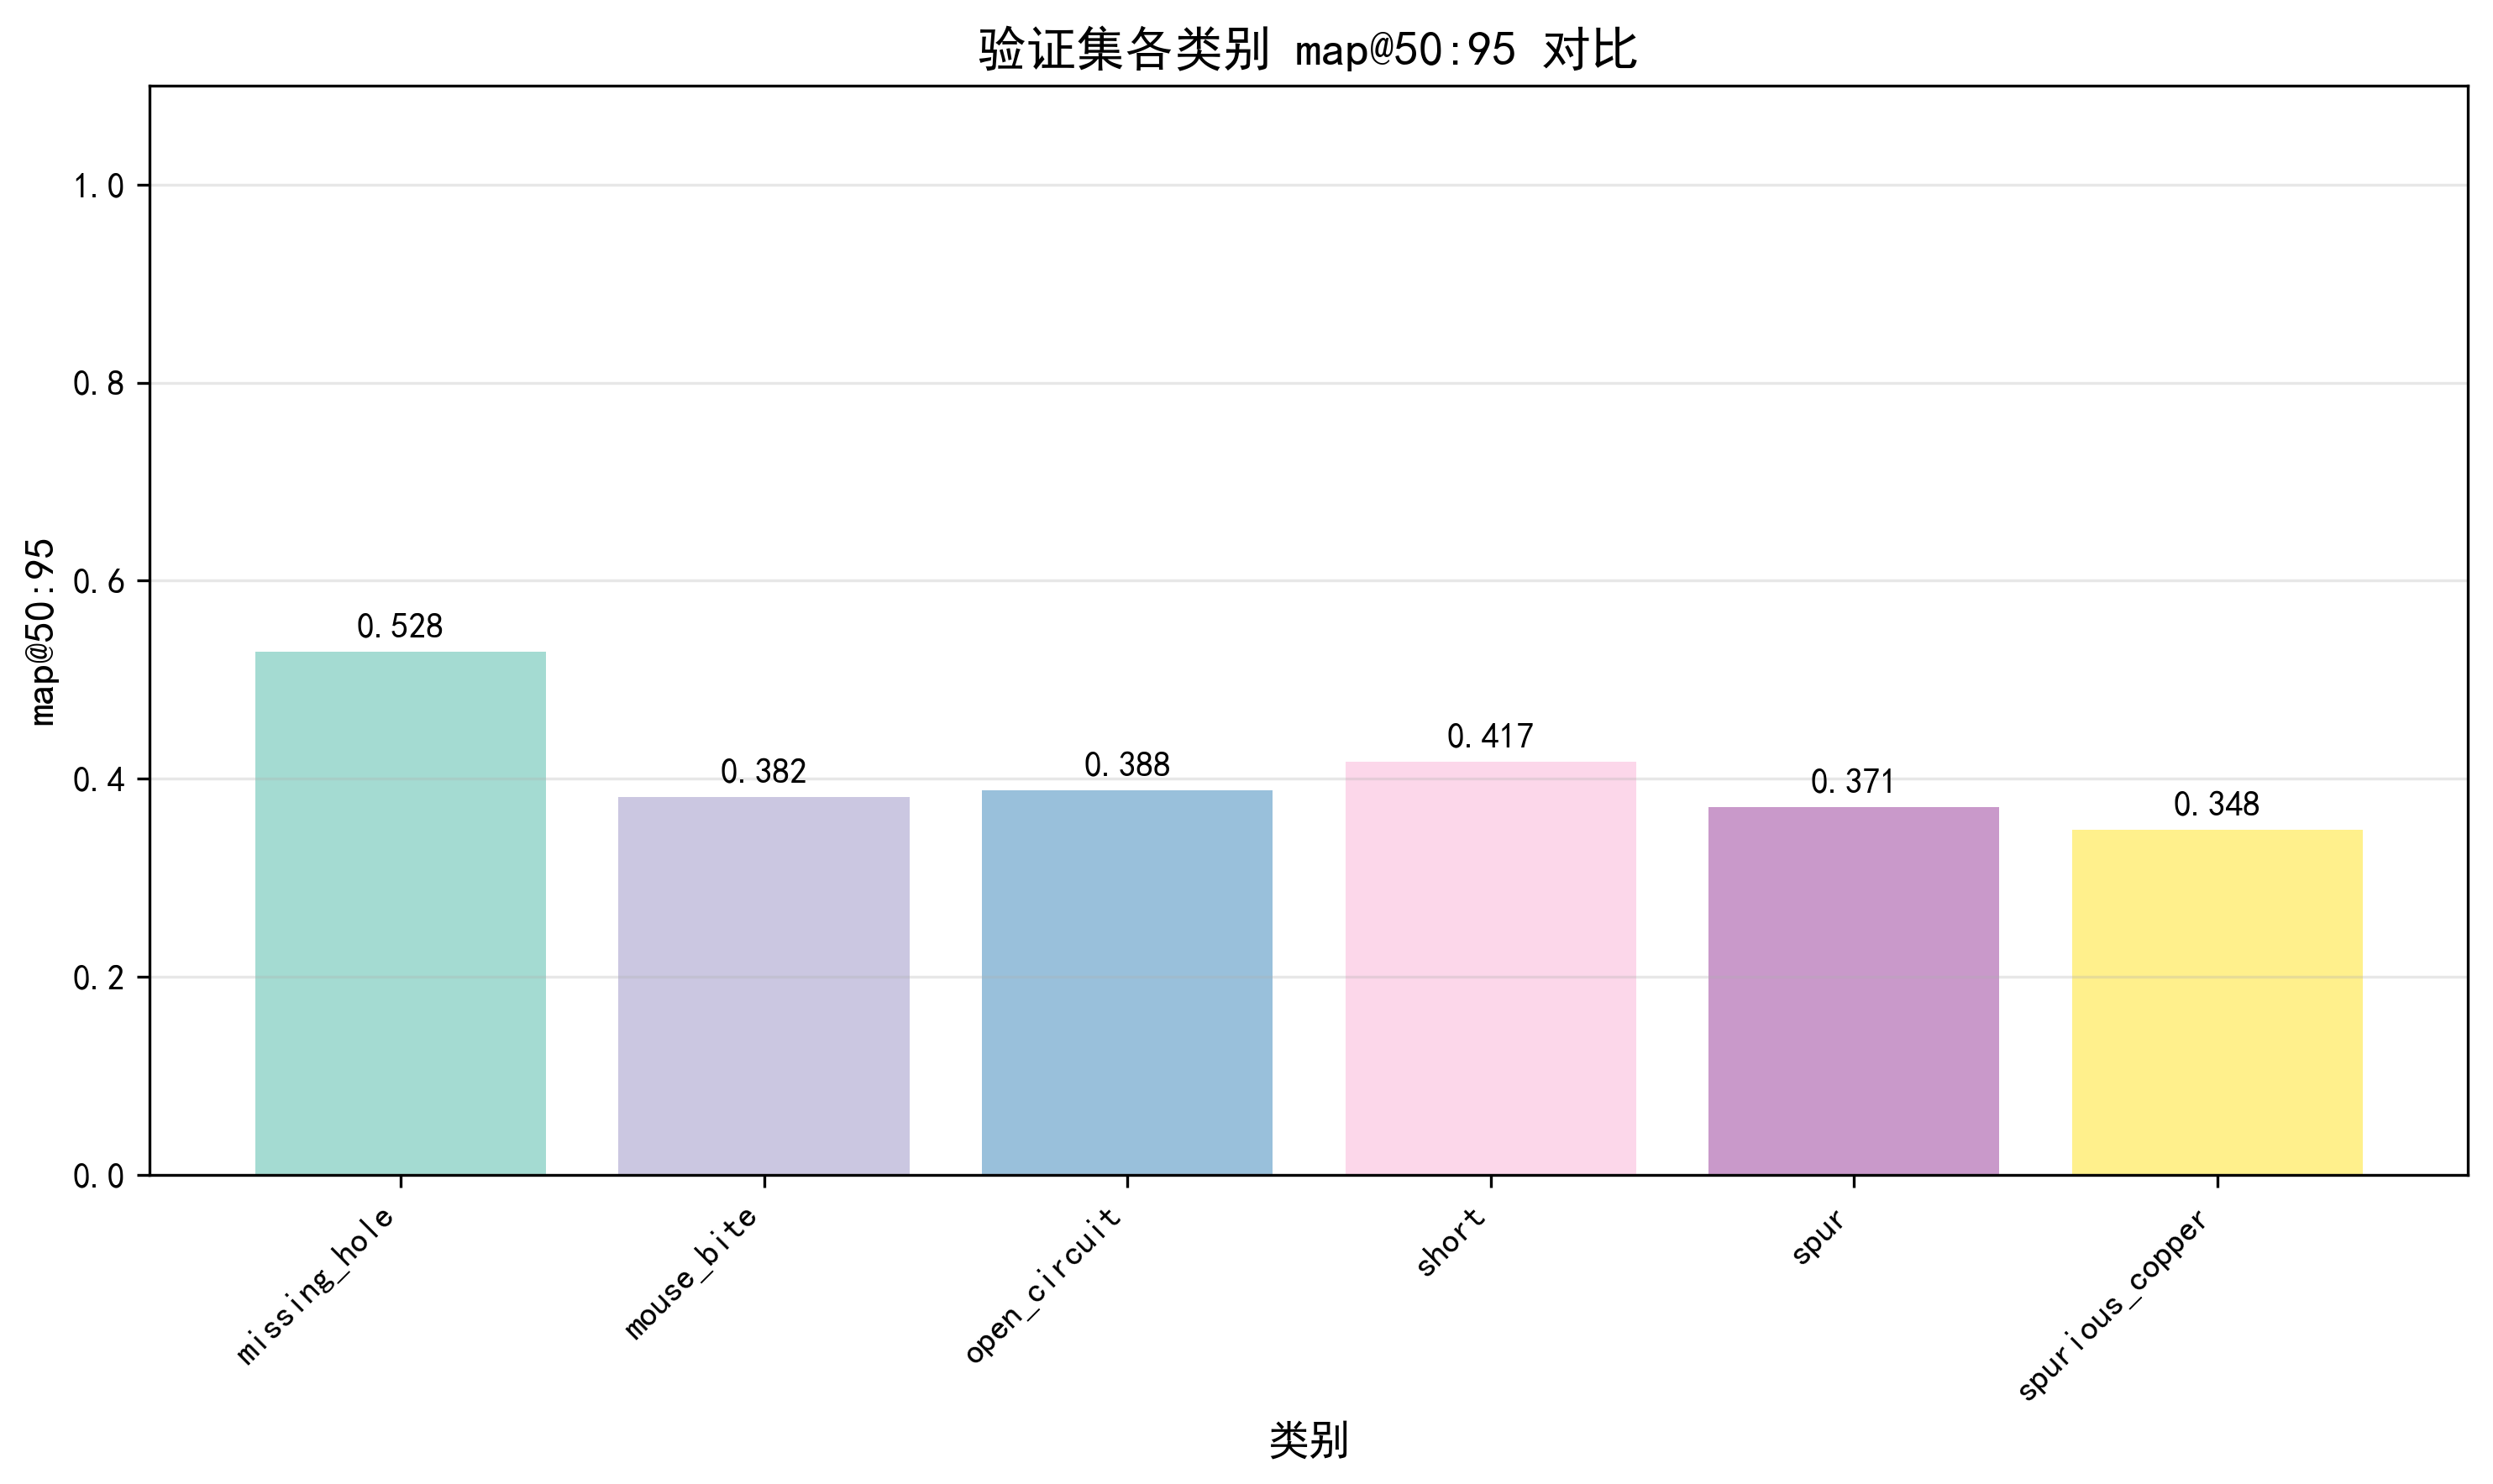
模型性能评估结果柱状图:
好了,这篇文章就介绍到这里,喜欢的小伙伴感谢给点个赞和关注,更多精彩内容持续更新~~
关于本篇文章大家有任何建议或意见,欢迎在评论区留言交流!

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐
 23
 0
- 0


 已为社区贡献23条内容

所有评论(0)