Google Colab的简介及使用(非常详细)
·
提示:此文章帮助新手快速理解和上手Colab
一、Colab是上什么?
Colab 全称 Google Colaboratory,是谷歌免费提供的云端交互式编程环境,核心为开发者(尤其深度学习领域)提供 “开箱即用” 的 GPU 算力和 Jupyter Notebook 编辑功能,无需本地配置硬件或环境。
二、Colab和云服务器的区别?
Colab并非传统意义上的云服务器,而是依托云服务器的云端交互式编程环境;它和云服务器的核心作用有重叠(都提供 GPU 算力支持深度学习),但定位、功能和使用场景差异显著。Colab免费提供 Tesla T4/K80 等 GPU,单会话有 12 小时左右的使用限制,资源会被动态分配和回收。具体如下图所示:
| 维度 | 谷歌 Colab | 云服务器 |
|---|---|---|
| 核心定位 | 免费的云端 Jupyter Notebook 编程环境 | 专注 AI 领域的GPU 云服务器租赁平台 |
| 资源与付费 | 免费为主,Pro 版付费;GPU 型号固定且资源有限 | 按需付费,可选 RTX 3090/A100 等高端 GPU,算力灵活 |
| 使用灵活性 | 仅支持 Notebook 界面,无法远程登录服务器 | 支持 SSH 登录、Jupyter Lab、自定义环境配置 |
| 资源持续性 | 会话超时后数据丢失,无持久化存储(需挂载 Google Drive) | 支持实例克隆、镜像保存,数据可持久化 |
| 网络与访问 | 国内访问需特殊工具,网络速度受限 | 国内平台,访问流畅,支持网盘加速传输数据 |
| 适用场景 | 入门学习、小型模型实验、短时任务 | 大型模型训练、长期项目开发、企业级研究 |
简单来说,Colab 适合零基础入门、快速验证小实验的用户,而 AutoDL 更适合需要稳定算力、复杂环境配置和大规模模型训练的开发者或团队。
三、Colab 的优势
Colab 的优势在于零成本、零配置,预装了 PyTorch、TensorFlow 等框架,打开浏览器就能用,非常适合学生和初学者。
四、云服务器的优势
云服务器的优势是算力定制化,支持按小时计费、切换无卡模式节省成本,且能应对工业级的深度学习任务,是国内开发者的主流选择。
五、Colab使用流程
1.科学上网
2.进入官网
3.右上角登录谷歌账号
登陆后,界面如下:

4.新建编译文件and验证cuda

5.查看cuda
输入代码
import torch
print(torch.__version__) #查看当前环境中已安装的 PyTorch 框架版本号
print(torch.cuda.is_available()) #检查当前环境中 PyTorch 是否能使用 GPU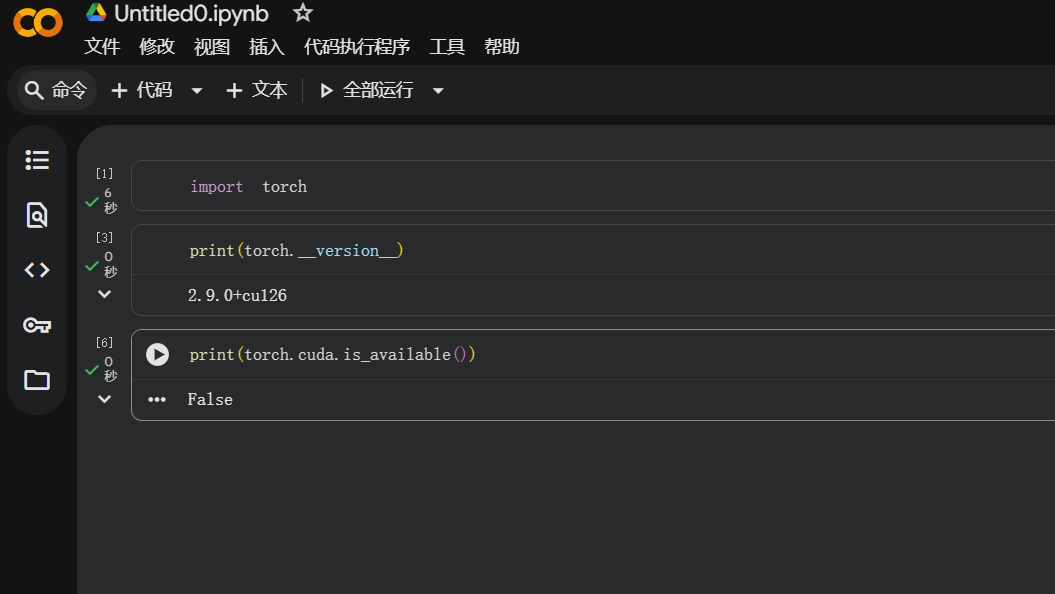
发现输出为False,这时候我们需要修改一下设置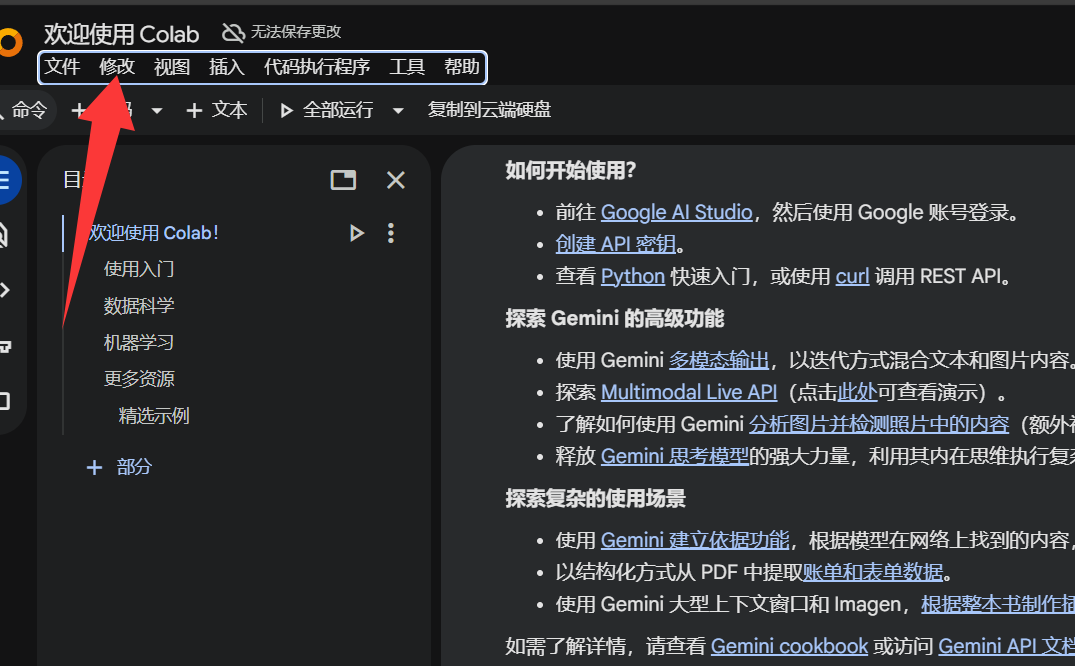
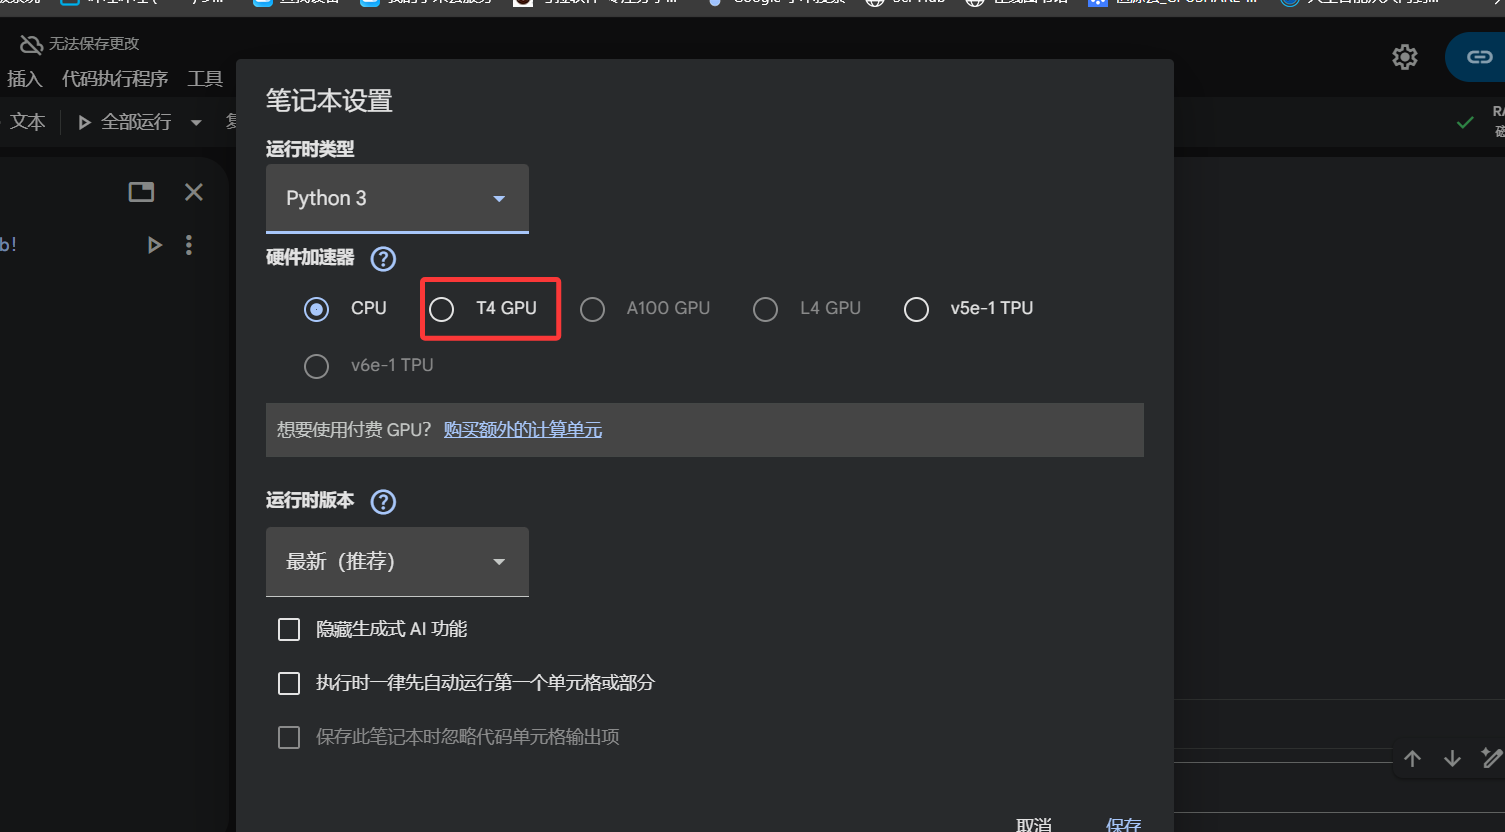
再次运行

5.运行深度学习代码
import torch
import torchvision
from torch.utils.tensorboard import SummaryWriter

# from model import *
# 准备数据集
from torch import nn
from torch.utils.data import DataLoader

if torch.cuda.is_available():
    print('ok')

train_data = torchvision.datasets.CIFAR10(root="./dataset", train=True, transform=torchvision.transforms.ToTensor(),
                                          download=True)
test_data = torchvision.datasets.CIFAR10(root="./dataset", train=False, transform=torchvision.transforms.ToTensor(),
                                         download=True)

# length 长度
train_data_size = len(train_data)
test_data_size = len(test_data)
# 如果train_data_size=10, 训练数据集的长度为:10
print("训练数据集的长度为:{}".format(train_data_size))
print("测试数据集的长度为:{}".format(test_data_size))


# 利用 DataLoader 来加载数据集
train_dataloader = DataLoader(train_data, batch_size=64)
test_dataloader = DataLoader(test_data, batch_size=64)

# 创建网络模型
class Tudui(nn.Module):
    def __init__(self):
        super(Tudui, self).__init__()
        self.model = nn.Sequential(
            nn.Conv2d(3, 32, 5, 1, 2),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 32, 5, 1, 2),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 64, 5, 1, 2),
            nn.MaxPool2d(2),
            nn.Flatten(),
            nn.Linear(64*4*4, 64),
            nn.Linear(64, 10)
        )

    def forward(self, x):
        x = self.model(x)
        return x
tudui = Tudui()
if torch.cuda.is_available():
    tudui = tudui.cuda()

# 损失函数
loss_fn = nn.CrossEntropyLoss()
if torch.cuda.is_available():
    loss_fn = loss_fn.cuda()
# 优化器
# learning_rate = 0.01
# 1e-2=1 x (10)^(-2) = 1 /100 = 0.01
learning_rate = 1e-2
optimizer = torch.optim.SGD(tudui.parameters(), lr=learning_rate)

# 设置训练网络的一些参数
# 记录训练的次数
total_train_step = 0
# 记录测试的次数
total_test_step = 0
# 训练的轮数
epoch = 10

# 添加tensorboard
writer = SummaryWriter("../logs_train")

for i in range(epoch):
    print("-------第 {} 轮训练开始-------".format(i+1))

    # 训练步骤开始
    tudui.train()
    for data in train_dataloader:
        imgs, targets = data
        if torch.cuda.is_available():
            imgs = imgs.cuda()
            targets = targets.cuda()
        outputs = tudui(imgs)
        loss = loss_fn(outputs, targets)

        # 优化器优化模型
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        total_train_step = total_train_step + 1
        if total_train_step % 100 == 0:
            print("训练次数:{}, Loss: {}".format(total_train_step, loss.item()))
            writer.add_scalar("train_loss", loss.item(), total_train_step)

    # 测试步骤开始
    tudui.eval()
    total_test_loss = 0
    total_accuracy = 0
    with torch.no_grad():
        for data in test_dataloader:
            imgs, targets = data
            if torch.cuda.is_available():
                imgs = imgs.cuda()
                targets = targets.cuda()
            outputs = tudui(imgs)
            loss = loss_fn(outputs, targets)
            total_test_loss = total_test_loss + loss.item()
            accuracy = (outputs.argmax(1) == targets).sum()
            total_accuracy = total_accuracy + accuracy

    print("整体测试集上的Loss: {}".format(total_test_loss))
    print("整体测试集上的正确率: {}".format(total_accuracy/test_data_size))
    writer.add_scalar("test_loss", total_test_loss, total_test_step)
    writer.add_scalar("test_accuracy", total_accuracy/test_data_size, total_test_step)
    total_test_step = total_test_step + 1

    torch.save(tudui, "tudui_{}.pth".format(i))
    print("模型已保存")

writer.close()
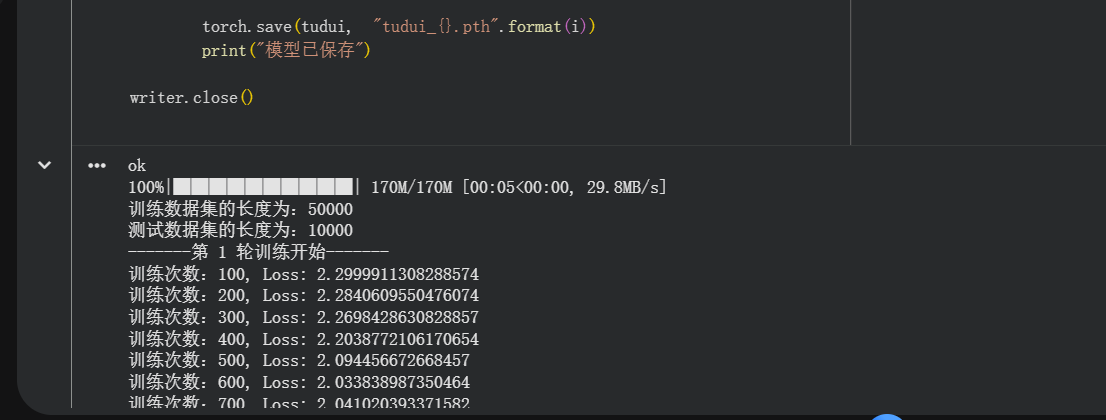
正常运行!
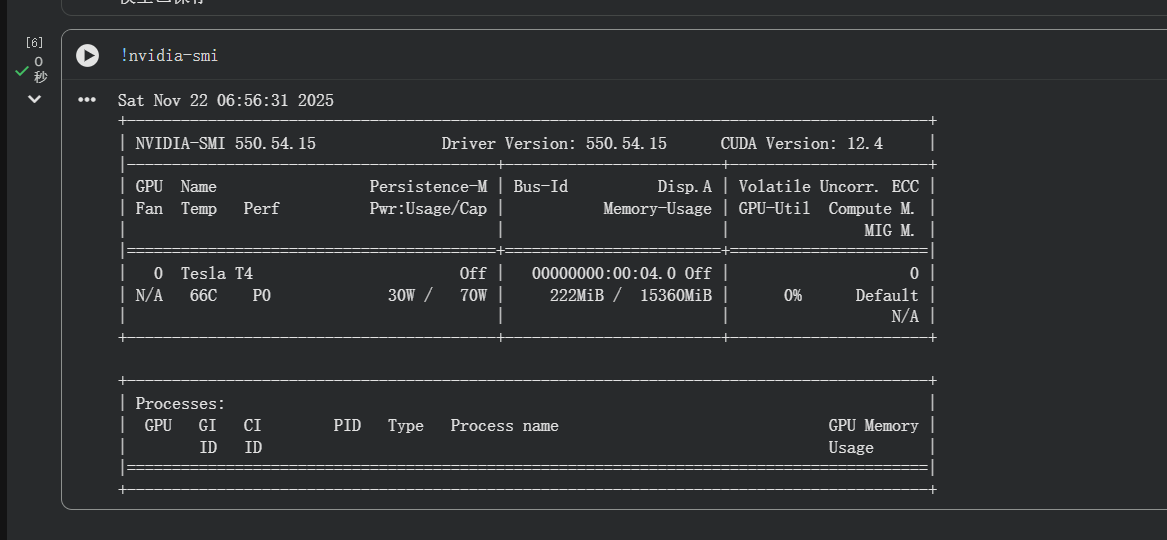
6.运行命令(terminal)指令
在命令前加上“!”
例如:
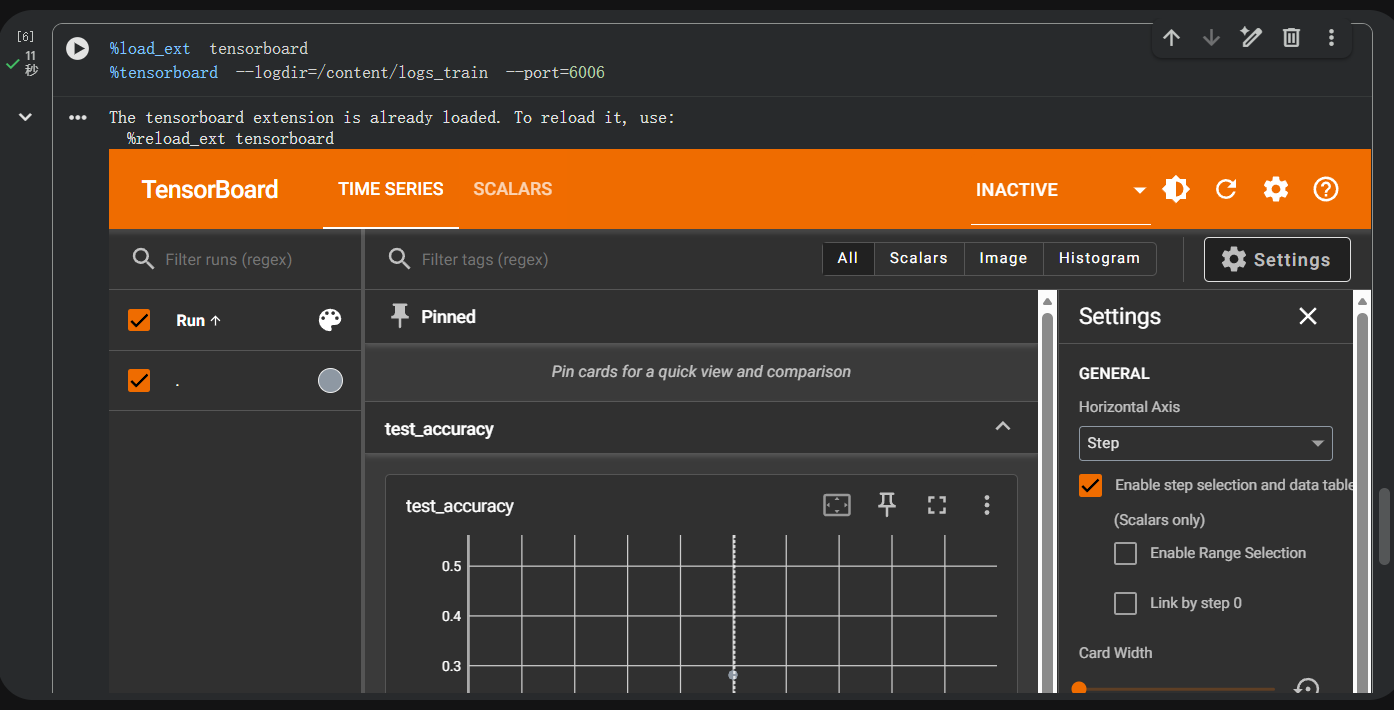
7.在Colab中查看tensorboard
新建一个代码框,输入
%load_ext tensorboard
%tensorboard --logdir=/content/logs_train --port=6006
即可查看
总结
如果你觉得还不错的话,就点个赞吧!

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 50
 0
- 0


 已为社区贡献1条内容

所有评论(0)