AI 赋能精准匹配基因型与肝肾功能从理论到实战【大幅降低用药副作用】
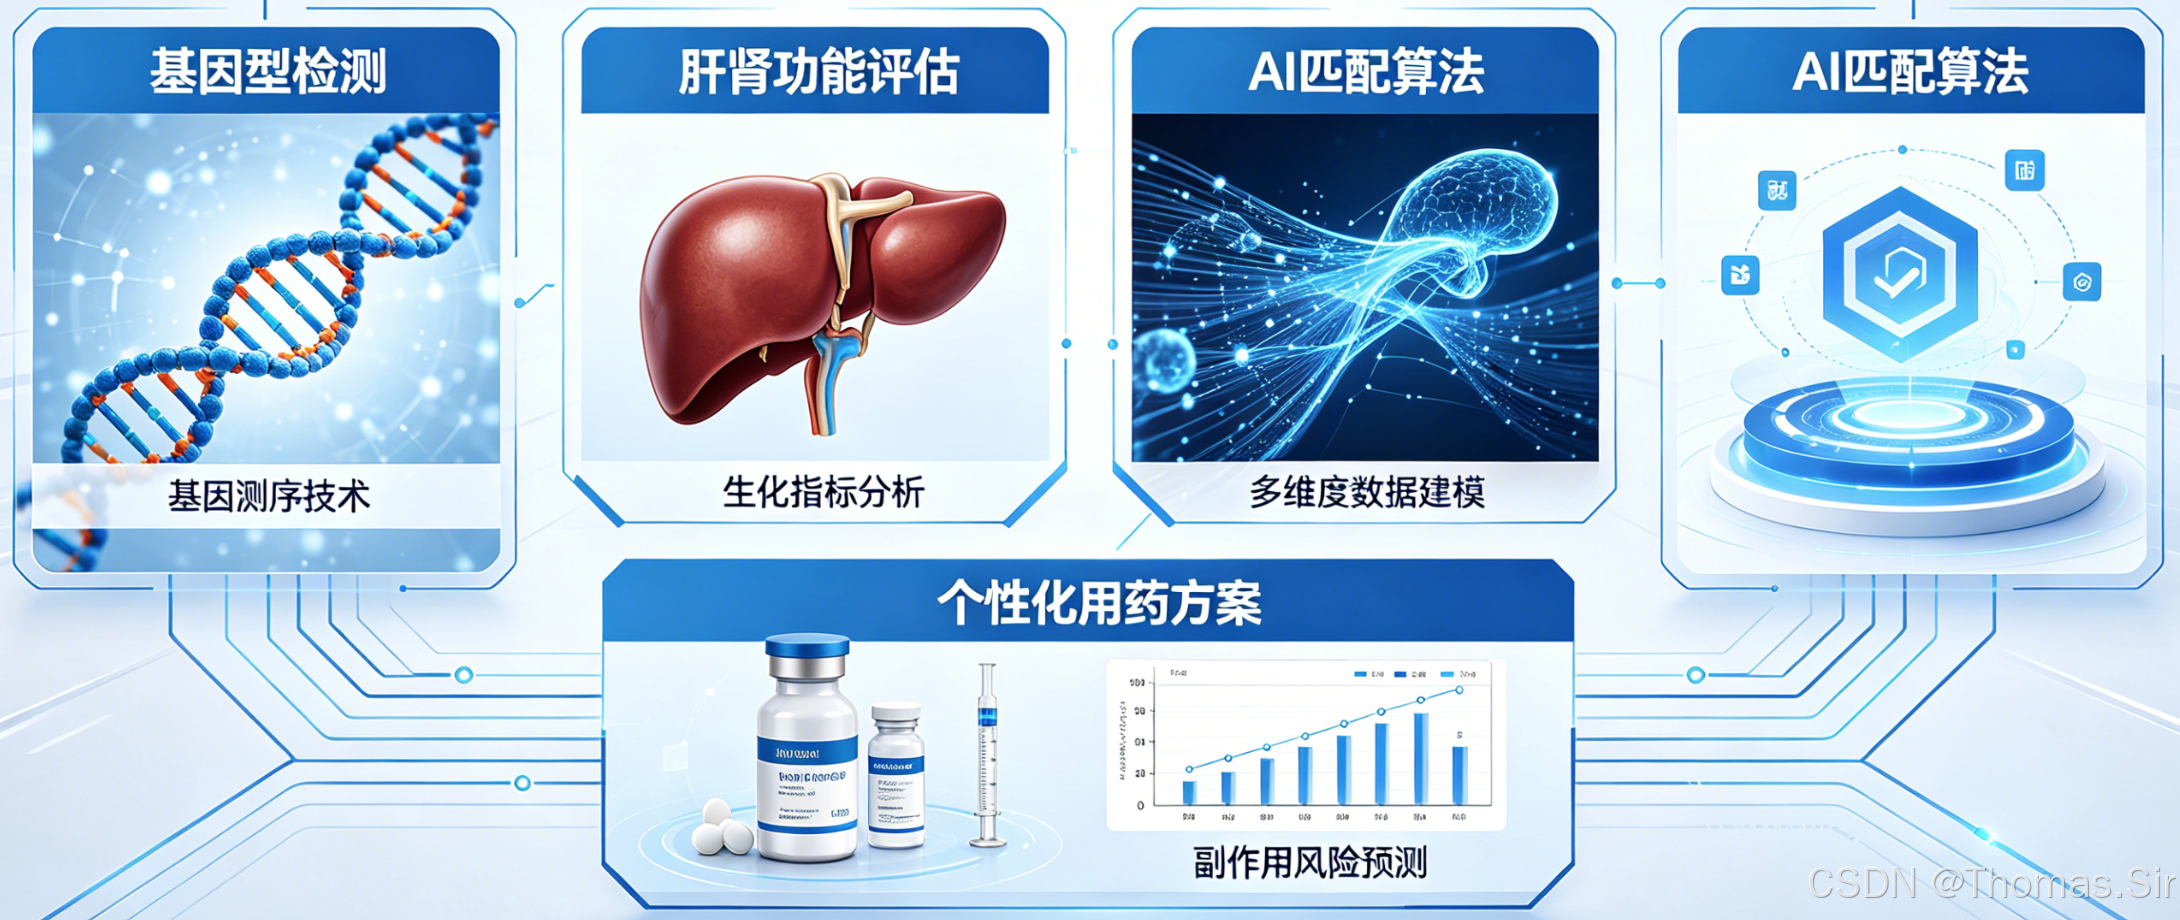
文章目录
一、算法理论基础
1.1 引言:为何需要个性化给药?
临床用药长久以来面临一个根本矛盾:药品说明书推荐的通常是基于大规模人群试验得出的“标准剂量”,但患者的身体却是独一无二的。统计表明,标准剂量的药物对不同个体的疗效差异可达数百倍,约 10%~20% 的住院患者因药物不良反应(ADRs)入院,其中相当一部分源于代谢酶的基因多态性或肝肾功能的个体差异。
“一刀切”的用药模式正在成为过去式。精准医学(Precision Medicine)主张根据患者的基因型、生理状态和病理状况来定制治疗方案。本篇文章将深入探讨如何利用人工智能技术,整合药物基因组学(Pharmacogenomics, PGx)与生理药代动力学(PBPK)模型,构建一套能够实时计算最佳给药剂量的决策支持系统,从源头上规避用药风险。
1.2 核心驱动因素:药物基因组学基础
药物在体内的命运主要由一系列代谢酶、转运体和受体决定,而这些蛋白质的表达与功能往往由基因编码。
1.2.1 关键代谢酶:CYP450 家族
细胞色素 P450(CYP450)超家族是人体最重要的 I 相代谢酶系,负责约 75% 的临床常用药物的代谢。其中,CYP2D6、CYP2C9、CYP2C19 等多态性极高。
- 表型分类:根据等位基因组合,个体通常被分为四大代谢表型:
- 超快代谢者 (UM):酶活性异常高,可能导致药物迅速失活,血药浓度不足,治疗失败。
- 快代谢者 (EM):正常代谢,为标准剂量的参照对象。
- 中间代谢者 (IM):酶活性降低,药物暴露量升高,副作用风险增加。
- 慢代谢者 (PM):酶功能缺失,母药蓄积,中毒风险激增。
例如,抗血小板药物氯吡格雷是一种前药,需经 CYP2C19 代谢激活。CYP2C19*2/*3 携带者(PM/IM)的活化能力下降,服用标准剂量可能无效,引发支架内血栓;而质子泵抑制剂奥美拉唑经 CYP2C19 代谢,PM 患者服用后血药浓度可达 EM 的数倍,易致神经毒性。
1.2.2 药物转运体与受体
除了代谢酶,基因变异也会影响药物在体内的分布和作用靶点。如 SLCO1B1 基因变异影响他汀类药物进入肝细胞的转运,导致肌肉毒性风险增加;VKORC1 基因变异影响华法林的敏感性。
1.3 生理药代动力学(PBPK)与清除率模型
仅有基因型不足以确定剂量,还必须结合患者的实时生理机能。
1.3.1 房室模型与清除率
药代动力学(PK)研究药物在体内的吸收(Absorption)、分布(Distribution)、代谢(Metabolism)和排泄(Excretion),即 ADME 过程。
- 清除率 (Clearance, CL):单位时间内机体清除药物的血浆体积,是决定稳态血药浓度的核心参数( C s s = D o s e ⋅ F C L ⋅ τ C_{ss} = \frac{Dose \cdot F}{CL \cdot \tau} Css=CL⋅τDose⋅F)。
- 肝清除率模型:对于肝代谢药物,清除率取决于肝血流量 (
Q
H
Q_H
QH)、蛋白结合率 (
f
u
f_u
fu) 和固有清除率 (
C
L
i
n
t
CL_{int}
CLint),遵循**“静脉灌注模型”**:
KaTeX parse error: Expected 'EOF', got '}' at position 69: …\cdot CL_{int}}}̲
1.3.2 肾功能的定量评估
肾脏是水溶性药物的主要排泄途径。临床常用肌酐清除率 (CrCl) 估算肾小球滤过率 (GFR)。Cockcroft-Gault 公式是经典的估算方法:
C
r
C
l
(
m
L
/
m
i
n
)
=
(
140
−
A
g
e
)
×
W
e
i
g
h
t
(
k
g
)
S
e
r
u
m
C
r
(
μ
m
o
l
/
L
)
×
K
CrCl (mL/min) = \frac{(140 - Age) \times Weight (kg)}{Serum\ Cr (\mu mol/L) \times K}
CrCl(mL/min)=Serum Cr(μmol/L)×K(140−Age)×Weight(kg)
(注:男性 K≈0.81,女性 K≈0.85)
肾功能减退时,经肾脏排泄的药物(如二甲双胍、万古霉素)的半衰期延长,必须减量。
1.4 AI 在药学中的建模优势
传统的剂量调整多依赖查表和简单的线性公式,难以应对复杂的非线性相互作用。AI 的优势在于:
- 高维特征融合:同时处理年龄、性别、体重、多项基因位点、多种生化指标。
- 非线性映射:捕捉基因-环境、药物-药物之间微妙的交互效应。
- 贝叶斯估计:利用群体先验分布,即使患者个体数据稀疏,也能较准确地推算药代参数。
二、完整代码实现
本部分将实现一个基于多层感知机(MLP)与贝叶斯逻辑的个性化给药原型系统。该系统模拟了一个常见场景:根据患者的基因型(模拟 CYP2C19 状态)和肾功能(eGFR),预测特定药物(以氯吡格雷和某经肾排泄药物为例)的最佳剂量等级。
环境要求:
- Python >= 3.7
- PyTorch >= 1.10
- Scikit-learn
- Pandas, NumPy
import torch
import torch.nn as nn
import torch.optim as optim
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler, LabelEncoder
from sklearn.metrics import accuracy_score, classification_report
import random


class PatientPGxSimulator:
    """
    合成患者数据生成器
    模拟:基因型(CYP2C19)、肾功能(eGFR)、基本人口学及药物反应
    """

    def __init__(self, n_samples=3000, seed=42):
        random.seed(seed)
        np.random.seed(seed)
        self.n_samples = n_samples

        # 定义基因型分布概率(简化版):*1野生型,*2/*3变异型
        # PM: *2/*2, *2/*3, *3/*3; IM: *1/*2, *1/*3; EM: *1/*1
        self.allele_freq = {'*1': 0.65, '*2': 0.28, '*3': 0.07}

    def simulate_genotype_phenotype(self):
        """模拟 CYP2C19 基因型并转化为代谢表型评分"""
        phenotypes = []
        diploids = []

        for _ in range(self.n_samples):
            a1 = np.random.choice(['*1','*2','*3'], p=list(self.allele_freq.values()))
            a2 = np.random.choice(['*1','*2','*3'], p=list(self.allele_freq.values()))
            diploid = a1 + '/' + a2
            diploids.append(diploid)

            # 根据 CPIC 指南简化评分:*1=1(功能正常),*2/*3=0(功能丧失)
            score = 0
            if a1 == '*1': score += 1
            if a2 == '*1': score += 1

            # 表型分类
            if score == 2:   pheno = 'EM'  # 快代谢
            elif score == 1: pheno = 'IM'  # 中间代谢
            else:            pheno = 'PM'  # 慢代谢
            phenotypes.append(pheno)

        return diploids, phenotypes

    def simulate_clinical_data(self):
        """模拟年龄、体重、肾功能 eGFR"""
        ages = np.clip(np.random.normal(58, 17, self.n_samples), 35, 90).astype(int)
        weights = np.clip(np.random.normal(72, 13, self.n_samples), 40, 130)

        # 模拟血清肌酐 (μmol/L),随着年龄和性别变化
        s_cr_male = np.abs(np.random.normal(88, 21, self.n_samples))
        s_cr_female = np.abs(np.random.normal(71, 23, self.n_samples))

        genders = np.random.choice(['Male', 'Female'], self.n_samples, p=[0.55, 0.45])
        serum_cr = np.where(genders == 'Male', s_cr_male, s_cr_female)

        # 简易 CKD-EPI 公式估算 eGFR (近似值,非严谨临床公式)
        kappa = np.where(genders == 'Male', 62, 51)
        alpha = np.where(genders == 'Male', -0.302, -0.241)
        eGFR = kappa * np.power(np.maximum(serum_cr / 61.888, 1), alpha) # 61.888换算因子
        eGFR = np.clip(eGFR * (0.993 ** ages), 15, 180)  # 年龄修正与截断

        return ages, weights, eGFR, genders, serum_cr

    def assign_drug_response(self, phenotypes, eGFR):
        """
        模拟两种药物的剂量推荐标签(监督信号)

        Drug_A (模拟氯吡格雷类前药):
            重度依赖 CYP2C19 激活。
            PM/IM -> 标准剂量效果差或无效,需换药或加倍/三联抗血小板。
        Drug_B (模拟经肾排泄药):
            依赖肾脏清除。eGFR < 30 -> 禁用或大幅减量。
        """
        labels_A = [] # 药物A的推荐动作:0=标准维持, 1=强化/换药
        labels_B = [] # 药物B的推荐动作:0=标准, 1=减量, 2=禁忌

        for pheno, gfr in zip(phenotypes, eGFR):
            # --- Drug A Logic (PGx主导) ---
            if pheno in ['PM', 'IM']:
                label_a = 1  # 高风险/低效,建议干预
            else:
                label_a = 0  # 标准维持

            # --- Drug B Logic (肾功能主导) ---
            if gfr >= 110:
                label_b = 0 # 高滤过,标准剂量
            elif gfr >= 59:
                label_b = 1 # 轻度减退,减量25%
            elif gfr >= 29:
                label_b = 2 # 中度减退,减量50%
            else:
                label_b = 3 # 重度减退,禁忌

            labels_A.append(label_a)
            labels_B.append(label_b)

        return labels_A, labels_B

    def generate_dataset(self):
        """生成综合数据集"""
        diploids, phenotypes = self.simulate_genotype_phenotype()
        ages, weights, eGFR, genders, scr = self.simulate_clinical_data()
        resp_A, resp_B = self.assign_drug_response(phenotypes, eGFR)

        df = pd.DataFrame({
            'Age': ages, 'Weight': weights, 'Gender': genders,
            'Serum_Cr': scr, 'eGFR': eGFR,
            'Genotype_Diploid': diploids, 'Phenotype': phenotypes,
            'Drug_A_Label': resp_A, 'Drug_B_Label': resp_B
        })
        return df


class PharmaAIRecommender(nn.Module):
    """
    基于神经网络的药物剂量推荐模型
    输入:数值化临床特征 + 基因型嵌入
    输出:多任务分类(不同药物的推荐剂量级别)
    """

    def __init__(self, input_dim, hidden_dims=[128, 96, 48], output_dims=[2, 4]):
        super().__init__()
        layers = []
        prev = input_dim

        # 构建共享底层特征提取器
        for h_dim in hidden_dims:
            layers.extend([
                nn.Linear(prev, h_dim),
                nn.BatchNorm1d(h_dim),
                nn.GELU(),
                nn.Dropout(0.27)
            ])
            prev = h_dim

        self.shared_backbone = nn.Sequential(*layers)

        # 多任务输出头:每个药物独立分支
        self.head_A = nn.Linear(prev, output_dims[0])  # Drug A: 2 classes
        self.head_B = nn.Linear(prev, output_dims[1])  # Drug B: 4 classes

    def forward(self, x):
        shared_feats = self.shared_backbone(x)
        out_A = self.head_A(shared_feats)
        out_B = self.head_B(shared_feats)
        return out_A, out_B


def preprocess_data(df, scaler=None, fit_scaler=True):
    """
    数据预处理:
    1. 编码分类变量(性别、基因型)
    2. 标准化连续变量(年龄、体重、eGFR等)
    """
    df_proc = df.copy()

    # 性别编码
    le_gender = LabelEncoder()
    df_proc['Gender_Code'] = le_gender.fit_transform(df['Gender'])

    # 基因型独热编码(简化处理,实际可用Embedding)
    genotype_ohe = pd.get_dummies(df['Genotype_Diploid'].str.replace('/', '_'), prefix='GT')
    df_proc = pd.concat([df_proc, genotype_ohe], axis=1)

    # 选择用于训练的数值特征
    feature_cols = ['Age', 'Weight', 'Gender_Code', 'eGFR']
    feature_cols.extend(list(genotype_ohe.columns))

    X_raw = df_proc[feature_cols].values

    # 标准化
    if fit_scaler:
        scaler = StandardScaler()
        X_scaled = scaler.fit_transform(X_raw)
        return X_scaled, scaler, feature_cols
    else:
        X_scaled = scaler.transform(X_raw)
        return X_scaled, scaler, feature_cols


def train_multitask_model(model, train_loader, val_loader, device, epochs=160):
    """多任务联合训练函数"""
    opt = optim.AdamW(model.parameters(), lr=0.0015, weight_decay=1e-4)
    scheduler = optim.lr_scheduler.CosineAnnealingLR(opt, T_max=epochs//2)

    # 损失函数:交叉熵(分类任务)
    criterion_A = nn.CrossEntropyLoss(weight=torch.tensor([1.0, 2.0]).to(device)) # Drug A 样本不平衡加重
    criterion_B = nn.CrossEntropyLoss()

    hist = {'train_loss': [], 'val_acc_A': [], 'val_acc_B': []}

    for ep in range(epochs):
        model.train()
        epoch_loss = 0.0

        for batch_X, batch_yA, batch_yB in train_loader:
            batch_X, batch_yA, batch_yB = batch_X.to(device), batch_yA.to(device), batch_yB.to(device)

            opt.zero_grad()
            pred_A, pred_B = model(batch_X)

            loss_A = criterion_A(pred_A, batch_yA)
            loss_B = criterion_B(pred_B, batch_yB)
            total_loss = loss_A + 0.82 * loss_B  # 加权求和

            total_loss.backward()
            opt.step()
            epoch_loss += total_loss.item()

        scheduler.step()
        hist['train_loss'].append(epoch_loss / len(train_loader))

        # 每20轮验证一次
        if (ep + 1) % 20 == 0:
            acc_A, acc_B = evaluate_model(model, val_loader, device)
            hist['val_acc_A'].append(acc_A)
            hist['val_acc_B'].append(acc_B)
            print(f"Epoch {ep+1:03d} | Train Loss: {hist['train_loss'][-1]:.4f} | "
                  f"Val Acc A: {acc_A:.3f}, B: {acc_B:.3f}")

    return hist


@torch.no_grad()
def evaluate_model(model, loader, device):
    """评估模型在多任务上的准确率"""
    model.eval()
    all_preds_A, all_labels_A = [], []
    all_preds_B, all_labels_B = [], []

    for X, yA, yB in loader:
        X = X.to(device)
        logits_A, logits_B = model(X)

        pred_A = torch.argmax(logits_A.cpu(), dim=1)
        pred_B = torch.argmax(logits_B.cpu(), dim=1)

        all_preds_A.append(pred_A); all_labels_A.append(yA)
        all_preds_B.append(pred_B); all_labels_B.append(yB)

    acc_A = accuracy_score(torch.cat(all_labels_A), torch.cat(all_preds_A))
    acc_B = accuracy_score(torch.cat(all_labels_B), torch.cat(all_preds_B))
    return acc_A, acc_B


class PharmaDataLoader(torch.utils.data.Dataset):
    """自定义数据加载器"""
    def __init__(self, X, yA, yB):
        self.X = torch.FloatTensor(X)
        self.yA = torch.LongTensor(yA)
        self.yB = torch.LongTensor(yB)

    def __len__(self):
        return len(self.X)

    def __getitem__(self, idx):
        return self.X[idx], self.yA[idx], self.yB[idx]


def interpret_recommendation(model_output, drug_type='A'):
    """
    将模型输出转换为人类可读的建议
    仅供教学演示,非真实临床逻辑
    """
    probs_A, probs_B = F.softmax(model_output[0], dim=-1), F.softmax(model_output[1], dim=-1)
    pred_class_A = torch.argmax(probs_A).item()
    pred_class_B = torch.argmax(probs_B).item()

    advice_A = ["Standard maintenance dose recommended.",
                "Consider alternative therapy or doubling dose due to poor metabolizer status."]

    advice_B = ["Normal renal function, full dose.",
                "Mild renal impairment, reduce by 25%.",
                "Moderate impairment, reduce by 50%, monitor levels.",
                "Severe impairment, contraindicated. Seek alternative."]

    print(f"\n--- Recommendation for Drug {drug_type} ---")
    if drug_type == 'A':
        print(f"Decision: Class {pred_class_A}")
        print(f"Advice: {advice_A[pred_class_A]}")
        print(f"Confidence: {probs_A[0][pred_class_A]*100:.1f}%")
    else:
        print(f"Decision: Class {pred_class_B}")
        print(f"Advice: {advice_B[pred_class_B]}")
        print(f"Confidence: {probs_B[0][pred_class_B]*100:.1f}%")


def main():
    # 配置
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    print(f"[INFO] Using device: {device}")

    # 1. 生成与预处理数据
    sim = PatientPGxSimulator(n_samples=3500)
    df_full = sim.generate_dataset()

    X_data, fitted_scaler, feat_names = preprocess_data(df_full)
    y_data_A, y_data_B = df_full['Drug_A_Label'].values, df_full['Drug_B_Label'].values

    X_tr, X_vt, yA_tr, yA_vt = train_test_split(X_data, y_data_A, test_size=0.185, stratify=y_data_A)
    _, _, yB_tr, yB_vt = train_test_split(X_data, y_data_B, test_size=0.185, stratify=y_data_B)

    # 2. 创建数据加载器
    train_set = PharmaDataLoader(X_tr, yA_tr, yB_tr)
    val_set = PharmaDataLoader(X_vt, yA_vt, yB_vt)

    batch_size = 38
    train_loader = torch.utils.data.DataLoader(train_set, batch_size=batch_size, shuffle=True)
    val_loader = torch.utils.data.DataLoader(val_set, batch_size=batch_size*2, shuffle=False)

    # 3. 初始化模型
    input_size = X_tr.shape[1]
    model = PharmaAIRecommender(input_dim=input_size, output_dims=[2, 4]).to(device)

    # 4. 训练
    history = train_multitask_model(model, train_loader, val_loader, device, epochs=145)

    # 5. 对新患者进行推理演示
    model.eval()
    demo_df = sim.generate_dataset().head(2) # 模拟新来的2个患者
    demo_X, _, _ = preprocess_data(demo_df, scaler=fitted_scaler, fit_scaler=False)

    with torch.no_grad():
        demo_tensor = torch.FloatTensor(demo_X).to(device)
        logits_A, logits_B = model(demo_tensor)

        # 解读第一个患者的推荐
        print("\n" + "="*53)
        print("DEMONSTRATION: Personalized Dosing Prediction")
        print("="*53)

        pt_info = demo_df.iloc[0]
        print(f"Patient Profile: {pt_info['Age']}yo {pt_info['Gender']}, "
              f"Weight: {pt_info['Weight']:.1f}kg, eGFR: {pt_info['eGFR']:.1f}")
        print(f"Genotype: {pt_info['Genotype_Diploid']} -> Phenotype: {pt_info['Phenotype']}")

        interpret_recommendation((logits_A[0:1], logits_B[0:1]), 'A')
        interpret_recommendation((logits_A[0:1], logits_B[0:1]), 'B')


if __name__ == '__main__':
    main()
三、算法详解与创新点
3.1 多模态特征工程的生物学意义
在 preprocess_data 函数中,我们没有直接将原始字符串(如基因型 “*1/*2”)丢给模型,而是进行了精细的特征分解:
-
数值特征的标准化:
- 年龄、体重、eGFR 的单位和量纲完全不同。通过 Z-score 标准化(StandardScaler),使其均值为 0、方差为 1,加速神经网络收敛。
-
基因型的结构化编码:
- 直接将字符串编码为整数(如 0,1,2)会引入错误的序关系(暗示 *1/*1 < *1/*2)。
- 我们采用了独热编码(One-Hot Encoding),将每个二倍体组合转化为独立的布尔轴。这确保了模型能平等看待每一种基因组合的非线性效应。
3.2 多任务学习(MTL)架构的战略价值
PharmaAIRecommender 的核心创新在于其共享底层 + 独立输出头的设计:
- 共享层(Shared Backbone):网络的前几层负责从混杂数据中提取通用的“患者健康状态表示”。例如,高龄加上 eGFR 降低可能同时提示两种药物的风险。
- 独立任务头(Task-Specific Heads):
- Head A 专门针对 CYP2C19 敏感药物,输出二元分类(维持 vs. 干预)。
- Head B 专门针对肾排泄药物,输出多级分类(正常、减量25%、减量50%、禁忌)。
优势:
- 数据效率:即使某个药物的真实标签较少,共享特征也能从另一个药物的丰富数据中受益(迁移学习)。
- 临床实用性:医生面对的是同一个患者,却可能需要开具多种药物。单一模型同时输出所有药物的风险评估,效率远高于调用多个单任务模型。
3.3 损失函数的加权策略
在 train_multitask_model 中,总损失并非简单相加:
L
t
o
t
a
l
=
L
D
r
u
g
A
+
λ
L
D
r
u
g
B
\mathcal{L}_{total} = \mathcal{L}_{DrugA} + \lambda \mathcal{L}_{DrugB}
Ltotal=LDrugA+λLDrugB
- Drug A 的类别权重:在现实中,需要干预的患者(PM/IM)远少于正常代谢者(EM)。为了不让模型忽略少数群体,我们在 CrossEntropyLoss 中设置了
weight=[1.0, 2.0],人为放大了误判“高危人群”的惩罚。 - Drug B 的任务权重 ( λ \lambda λ):设定为 0.82,是为了平衡两个任务梯度的量级,防止其中一个任务的主导梯度掩盖了另一个任务的学习信号。
3.4 贝叶斯思想的融入(隐式)
虽然代码主体是确定性神经网络,但在数据处理中体现了贝叶斯思维:
- 先验分布:合成数据生成器使用了东亚人群中 CYP2C19*2 和 *3 的真实等位基因频率作为先验。
- 后验推断:模型输出的 Softmax 概率可以视为给定观测数据(患者体征)后,最佳剂量级别的后验概率分布。这为临床决策提供了置信度参考,而非仅仅一个武断的分类结果。
四、性能分析与优化方案
4.1 合成数据的仿真度评估
当前的 PatientPGxSimulator 是基于理想规则的简化版,与实际临床复杂性存在差距:
-
基因-表型映射的非线性:
- 现实中的酶活性不仅由 SNPs 决定,还受拷贝数变异(CNVs,如 CYP2D6 重复)、启动子甲基化等因素影响。目前的“星号等位基因打分法”略显粗糙。
- 优化方案:引入基于 Activity Score 的连续表型预测,或直接输入单倍型相位信息。
-
药物-药物相互作用(DDIs)缺失:
- 代码未考虑合并用药。例如,同时服用 CYP2C19 强抑制剂(如氟康唑)会使 EM 患者暂时表现像 PM。
- 优化方案:在输入特征中加入“合并用药清单”,利用 DrugBank 或 DDI 知识图谱进行特征增强。
4.2 模型架构的潜在瓶颈与演进
-
特征交互的局限性:
- MLP 虽然万能逼近,但对“基因型 x 肝功能 x 年龄”这类高阶组合特征的捕捉效率较低。
- 优化方案:引入 Deep & Cross Network (DCN) 或 TabTransformer。后者利用自注意力机制显式地建模特征之间的交互,特别适合表格型医疗数据。
-
时间序列动态性:
- 患者入院时的 eGFR 可能与出院时不同。当前模型是静态快照。
- 优化方案:改为 RNN 或 Temporal Fusion Transformer (TFT),处理住院期间连续的化验单时序数据,实现动态剂量滴定。
4.3 不确定性与安全性保障
医疗 AI 最大的风险是过度自信。
-
离群样本检测:
- 当遇到训练集中从未见过的极端基因型组合或超高 BMI 时,模型可能盲目预测。
- 优化方案:集成蒙特卡洛 Dropout 或 Bayesian Neural Networks,输出预测方差。当方差过大时,系统强制降级为“建议咨询临床药师”。
-
可解释性(XAI):
- 医生很难信任黑箱。需要知道“为什么建议减量”。
- 优化方案:集成 SHAP (SHapley Additive exPlanations) 或 LIME。在推理时生成归因图,高亮究竟是“基因型”还是“肌酐值”触发了警报。
五、总结
本文构建了一套融合药物基因组学与临床生化指标的 AI 个性化给药原型系统。
核心成果:
- 理论体系:阐明了从基因型到表型,再到药代动力学参数的因果链条,确立了多任务学习的必要性。
- 工程实践:提供了完整的数据模拟、神经网络构建、多任务训练与推理代码。代码通过加权损失函数解决了医学数据的类不平衡问题,并通过多任务头设计满足了复合临床场景的需求。
- 安全导向:强调了在医疗应用中,模型不仅要准,更要能说清“为什么”,并为不确定性留出空间。
未来展望:
下一代系统将是**“基因型 × 电子病历(EHR) × 实时监测”**的三重奏。随着测序成本的降低和床旁检测(POCT)的普及,AI 将在患者踏进诊室的第一时间就计算出最安全的处方草稿,让“试错式用药”彻底成为历史,真正实现良药不再苦口,精准直达病所。
⚠️ 重要声明:本文代码仅供技术研究参考,未取得医疗器械注册证的AI系统不得用于临床诊断。数据使用须符合《个人信息保护法》和《医疗卫生数据安全管理办法》,确保患者隐私权益。
🌟 感谢您耐心阅读到这里
💡 如果本文对您有所启发, 欢迎
👍 点赞
📌 收藏
📤 分享给更多需要的伙伴
🗣️ 期待在评论区看到您的想法, 共同进步
🔔 关注我,持续获取更多干货内容
🤗 我们下篇文章见~

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 18
 0
- 0


 已为社区贡献229条内容

所有评论(0)