开源RAG知识库框架盘点:15大主流方案对比与选型指南(详细),大模型入门到精通,收藏这篇就足够了!
随着大语言模型(LLM)的普及,检索增强生成(RAG)技术成为企业构建知识库与智能问答系统的核心工具。然而,开源社区中涌现的RAG框架功能各异,如何选择适合自身场景的方案?本文从 功能特性、适用场景、社区生态 等维度,对15款主流开源RAG框架进行深度对比,并提供选型建议与推荐指数(满分5星)。
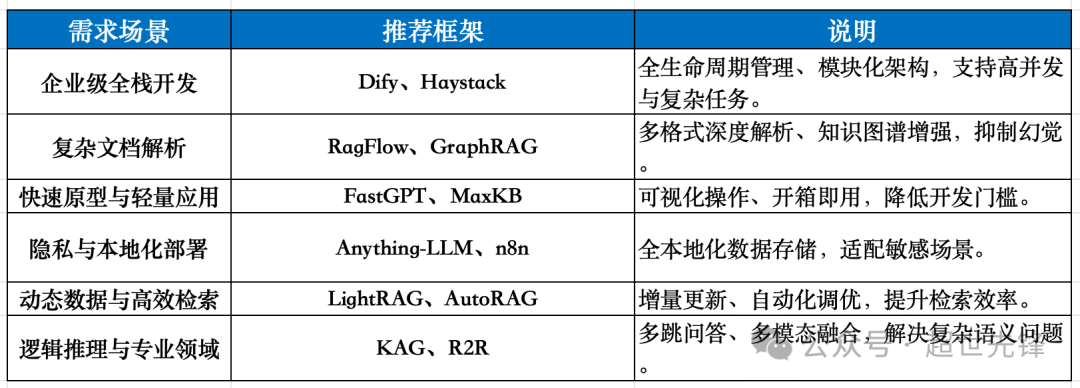
选型指南:按需求场景选择
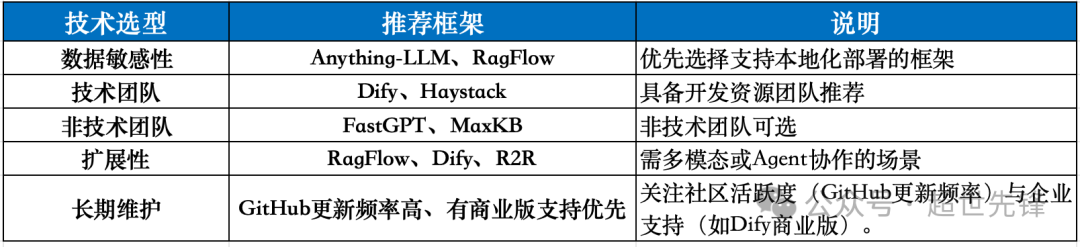
选型指南:按技术要求选择
一、通用型框架:企业级开发与复杂任务
1,Dify

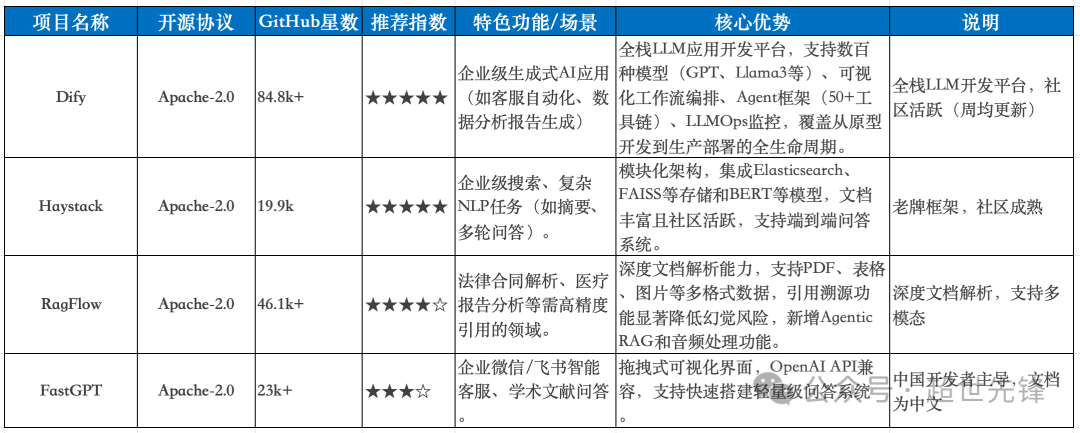
核心优势:全栈LLM应用开发平台,支持数百种模型(GPT、Llama3等)、可视化工作流编排、Agent框架(50+工具链)、LLMOps监控,覆盖从原型开发到生产部署的全生命周期。
适用场景:企业级生成式AI应用(如客服自动化、数据分析报告生成)。
推荐指数:★★★★★
GitHub星数:84.8k+
开源协议:Apache License 2.0
项目地址:https://github.com/langgenius/dify
项目介绍
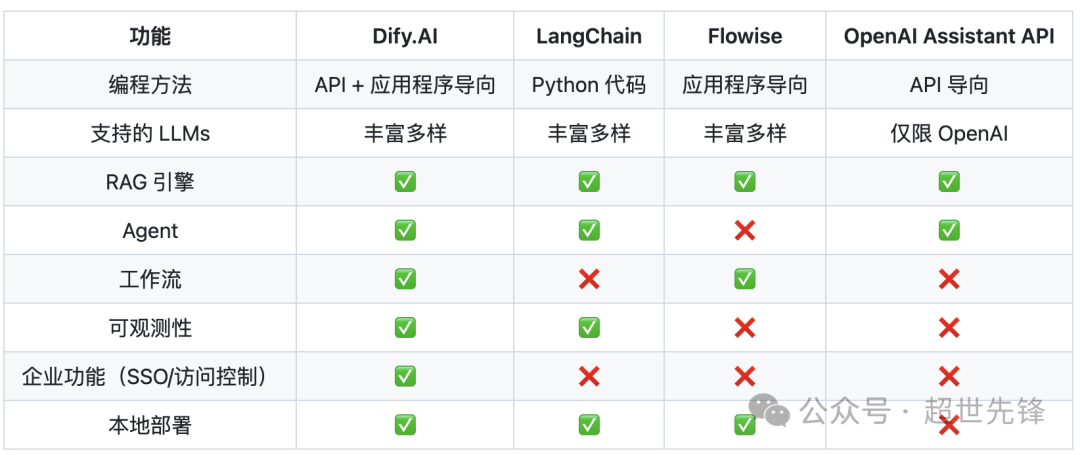
Dify 是一个开源的 LLM 应用开发平台。其直观的界面结合了 AI 工作流、RAG 管道、Agent、模型管理、可观测性功能等,让您可以快速从原型到生产。
服务价格
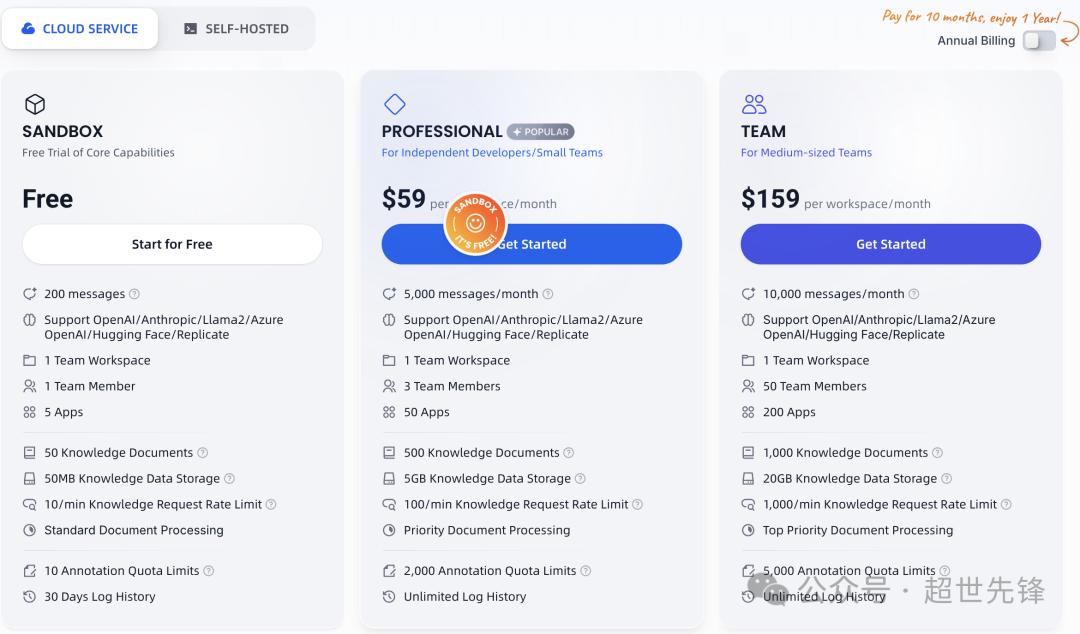
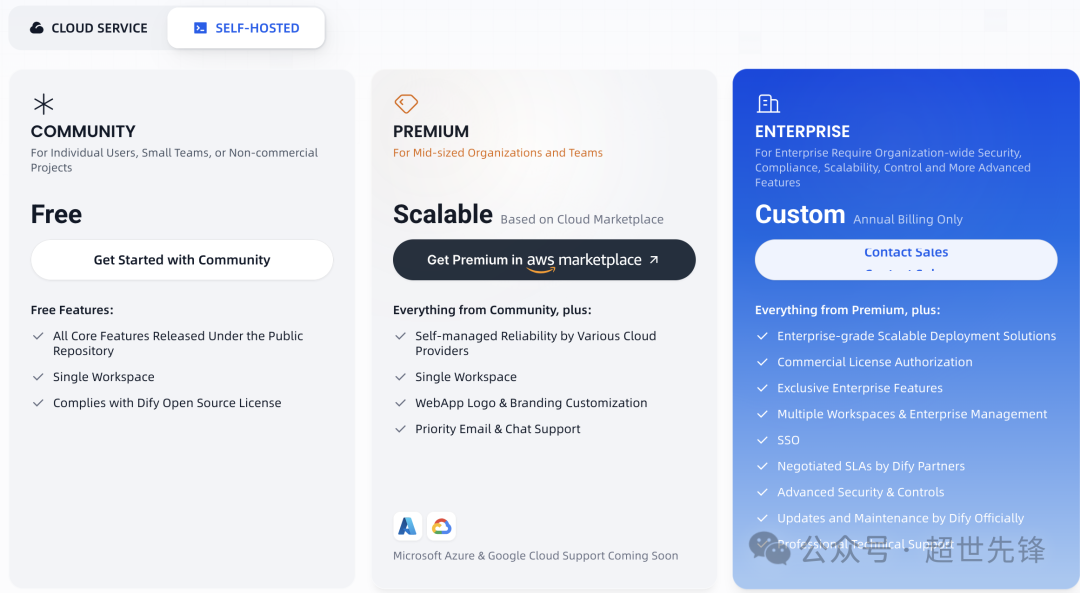
功能特点
工作流: 在画布上构建和测试功能强大的 AI 工作流程,利用以下所有功能以及更多功能。
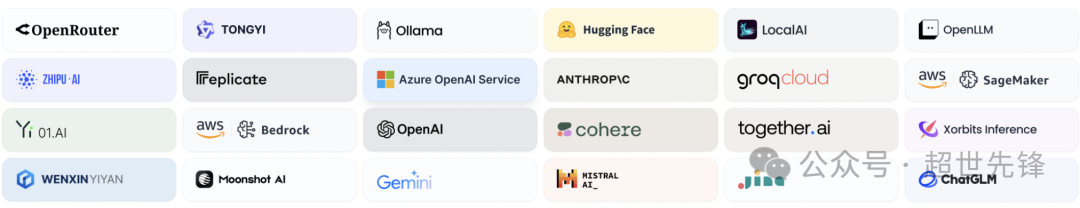
模型支持: 与数百种专有/开源 LLMs 以及数十种推理提供商和自托管解决方案无缝集成,涵盖 GPT、Mistral、Llama3 以及任何与 OpenAI API 兼容的模型。完整的支持模型提供商列表可在此处找到。
Prompt IDE: 用于制作提示、比较模型性能以及向基于聊天的应用程序添加其他功能(如文本转语音)的直观界面。
RAG Pipeline: 广泛的 RAG 功能,涵盖从文档摄入到检索的所有内容,支持从 PDF、PPT 和其他常见文档格式中提取文本的开箱即用的支持。
Agent 智能体: 您可以基于 LLM 函数调用或 ReAct 定义 Agent,并为 Agent 添加预构建或自定义工具。Dify 为 AI Agent 提供了 50 多种内置工具,如谷歌搜索、DALL·E、Stable Diffusion 和 WolframAlpha 等。
LLMOps: 随时间监视和分析应用程序日志和性能。您可以根据生产数据和标注持续改进提示、数据集和模型。
后端即服务: 所有 Dify 的功能都带有相应的 API,因此您可以轻松地将 Dify 集成到自己的业务逻辑中。
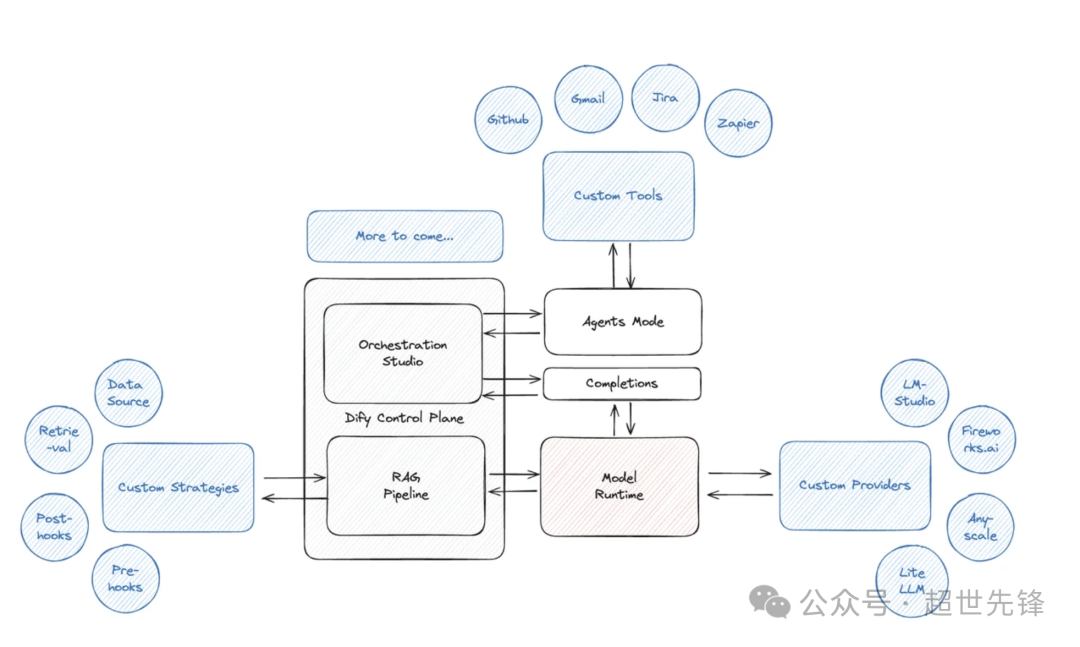
技术架构
部署体验
# 下载
git clone https://github.com/langgenius/dify.git
cd docker
cp .env.example .env
# 使用docker-compose.yml启动
docker compose up -d
# 界面安装:http://localhost/install 进入 Dify 控制台并开始初始化安装
2,Haystack
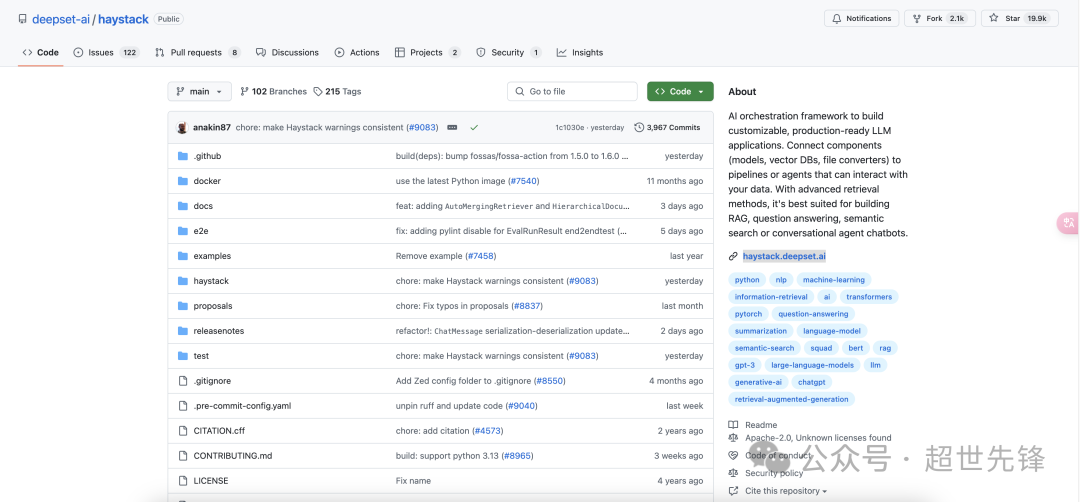
核心优势:模块化架构,集成Elasticsearch、FAISS等存储和BERT等模型,文档丰富且社区活跃,支持端到端问答系统。
适用场景:企业级搜索、复杂NLP任务(如摘要、多轮问答)。
推荐指数:★★★★★
GitHub星数:19.9k
开源协议:Apache License 2.0
项目地址:https://github.com/deepset-ai/haystack
项目介绍
Haystack 是一个端到端LLM框架,允许您构建由 LLMs、Transformer 模型、向量搜索等提供支持的应用程序。无论您是想执行检索增强生成 (RAG)、文档搜索、问答还是答案生成,Haystack 都可以编排最先进的嵌入模型并LLMs集成到管道中,以构建端到端 NLP 应用程序并解决您的用例。
功能特性
技术无关性:允许用户灵活决定使用哪个供应商或技术,并轻松替换任何组件。Haystack 允许您使用并比较来自 OpenAI、Cohere 和 Hugging Face 的模型,以及您自己的本地模型或托管在 Azure、Bedrock 和 SageMaker 上的模型。
明确性:清晰地展示不同组件之间如何“交流”,以便更容易适配您的技术栈和使用场景。
灵活性:Haystack 提供了一个集中的工具集:数据库访问、文件转换、清洗、拆分、训练、评估、推理等。当需要自定义行为时,可以轻松创建自定义组件。
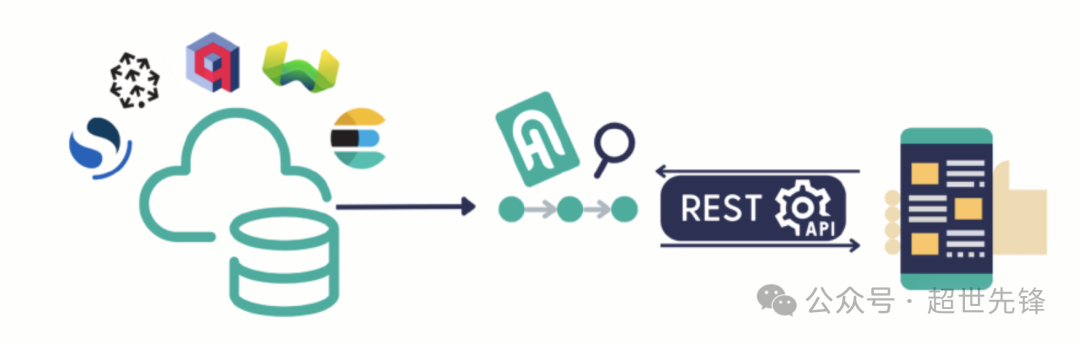
可扩展性:为社区和第三方提供统一且简单的方式构建自己的组件,并围绕 Haystack 培养一个开放的生态系统。
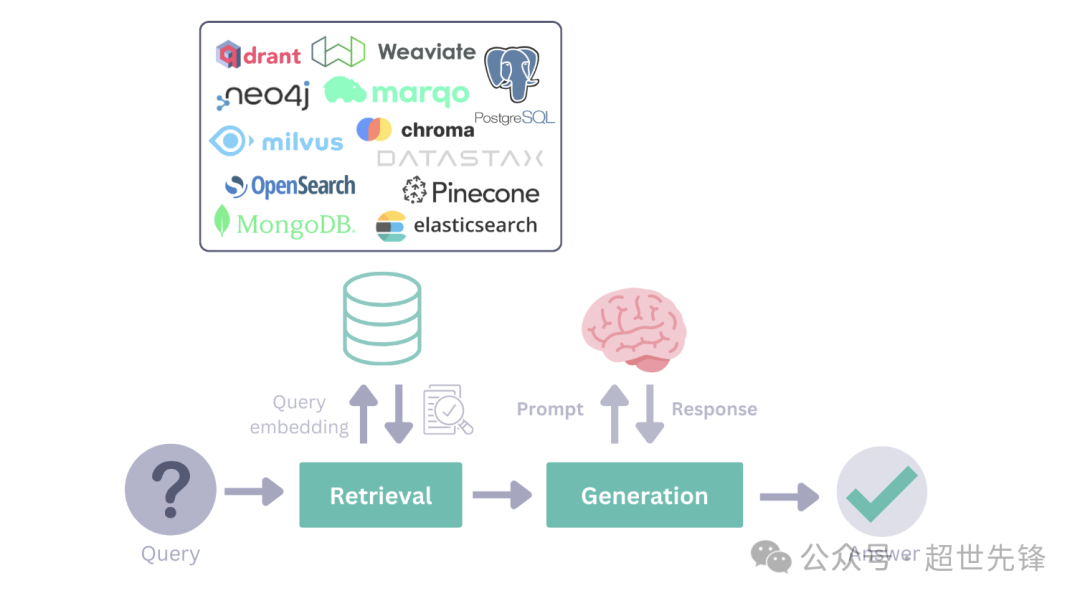
使用Haystack实现示例:
- 利用可用的向量数据库构建检索增强生成 (RAG),并自定义您的 LLM 交互,可能性无限 🚀
- 执行自然语言问题回答,以在文档中找到细致的答案。
- 进行语义搜索并根据意义检索文档。
- 构建可以做出复杂决策的应用程序,以回答复杂的查询:例如能够解决复杂客户查询、在众多孤立的资源中进行知识搜索的系统等。
- 使用检索器和生产规模组件扩展到数百万文档。
- 使用即插即用模型或针对您的数据进行微调。
- 利用用户反馈评估、基准测试并持续改进您的模型。
部署体验
#方式一:pip安装:
pip install haystack-ai
#方式二:conda安装:
conda config --add channels conda-forge/label/haystack-ai_rc
conda install haystack-ai
#方式三:代码安装:
# Clone the repo
git clone https://github.com/deepset-ai/haystack.git
# Move into the cloned folder
cd haystack
# Upgrade pip
pip install --upgrade pip
# Install Haystack in editable mode
pip install -e '.[dev]'
3,RagFlow
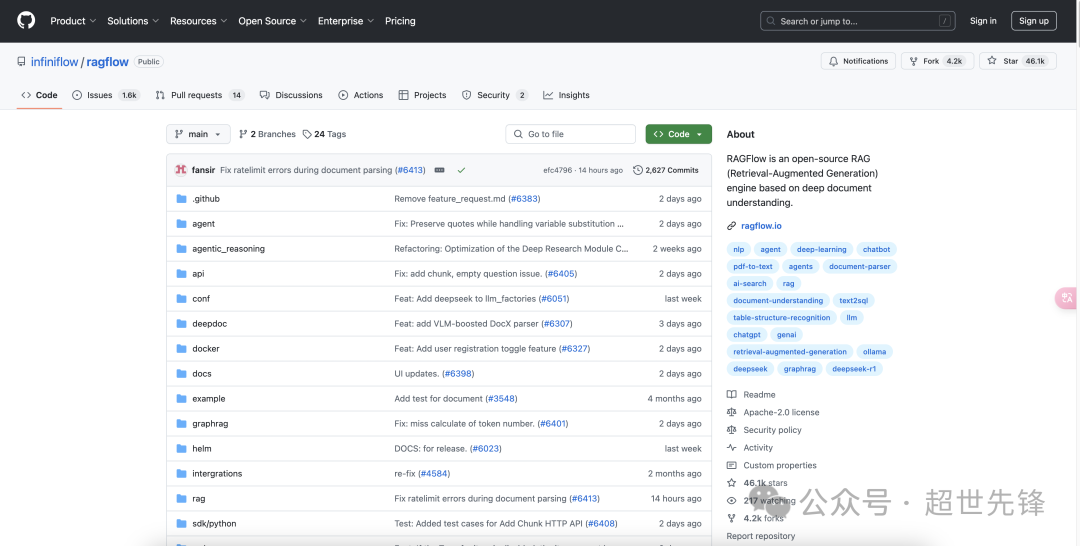
核心优势:深度文档解析能力,支持PDF、表格、图片等多格式数据,引用溯源功能显著降低幻觉风险,新增Agentic RAG和音频处理功能。
适用场景:法律合同解析、医疗报告分析等需高精度引用的领域。
推荐指数:★★★★☆
GitHub星数:46.1k+
开源协议:Apache License 2.0
项目地址:https://github.com/infiniflow/ragflow
#项目地址
RAGFlow 是一款基于深度文档理解构建的开源 RAG(Retrieval-Augmented Generation)引擎。RAGFlow 可以为各种规模的企业及个人提供一套精简的 RAG 工作流程,结合大语言模型(LLM)针对用户各类不同的复杂格式数据提供可靠的问答以及有理有据的引用。
功能特性
深度文档理解:RAGFlow 能够解析复杂格式的非结构化数据(如 PDF、Word、Excel、图片、扫描件等),精准提取文字、表格、图片、标题等元素,并对表格布局和多行文本进行智能合并,确保语义完整性。例如,从医疗报告或法律合同中提取关键信息时,可避免格式混乱导致的语义丢失。
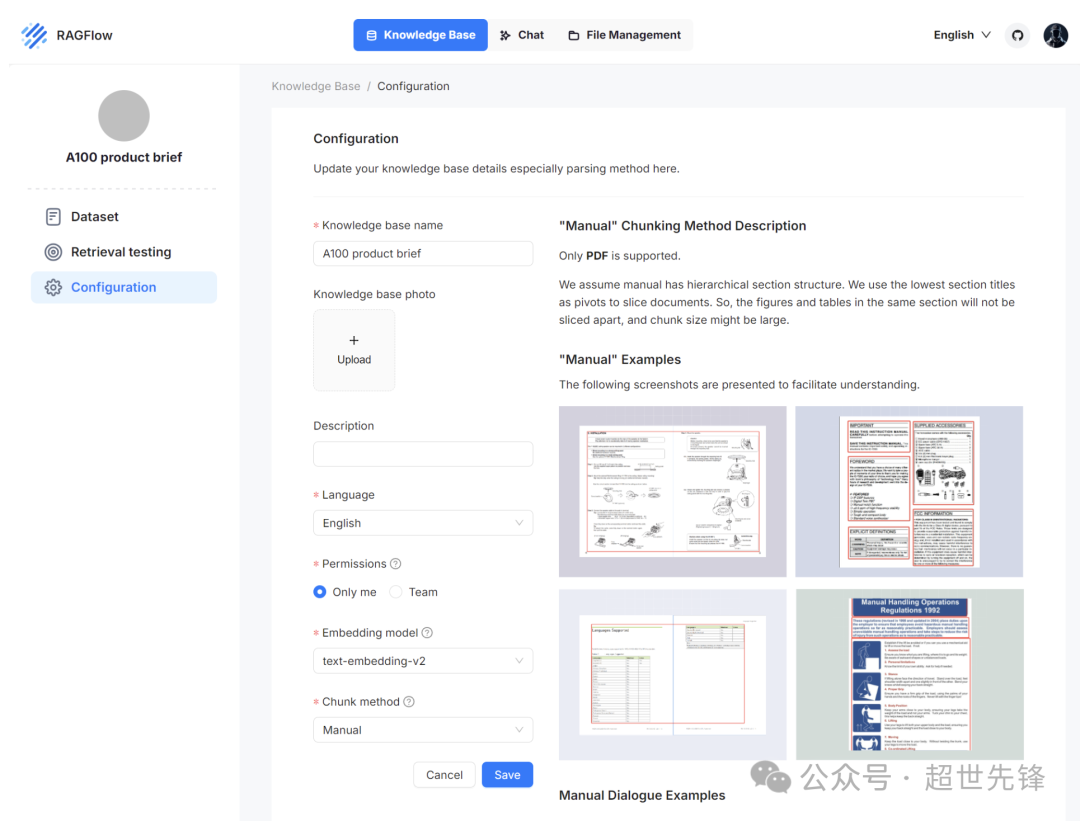
模板化分块与可控性:提供多种分块模板(如常规、问答、法律、表格等),用户可根据文档类型选择合适的分块方式。例如,法律文档可选择“法律模板”以确保条款完整性,表格数据则使用“表格模板”精准解析。分块过程支持可视化调整和手动干预,提升透明度和可控性。
可靠引用与幻觉抑制:答案生成时自动关联原始文档的引用来源,支持用户追溯答案依据,显著减少大模型的“幻觉”问题。例如,在生成医疗诊断建议时,可直接定位到相关医学文献的段落。
多模态与异构数据兼容:支持文本、图片、表格、音频(需特定版本)等多种数据格式,兼容企业内外部异构数据源(如网页、结构化数据库、本地文件等),实现跨模态知识整合。
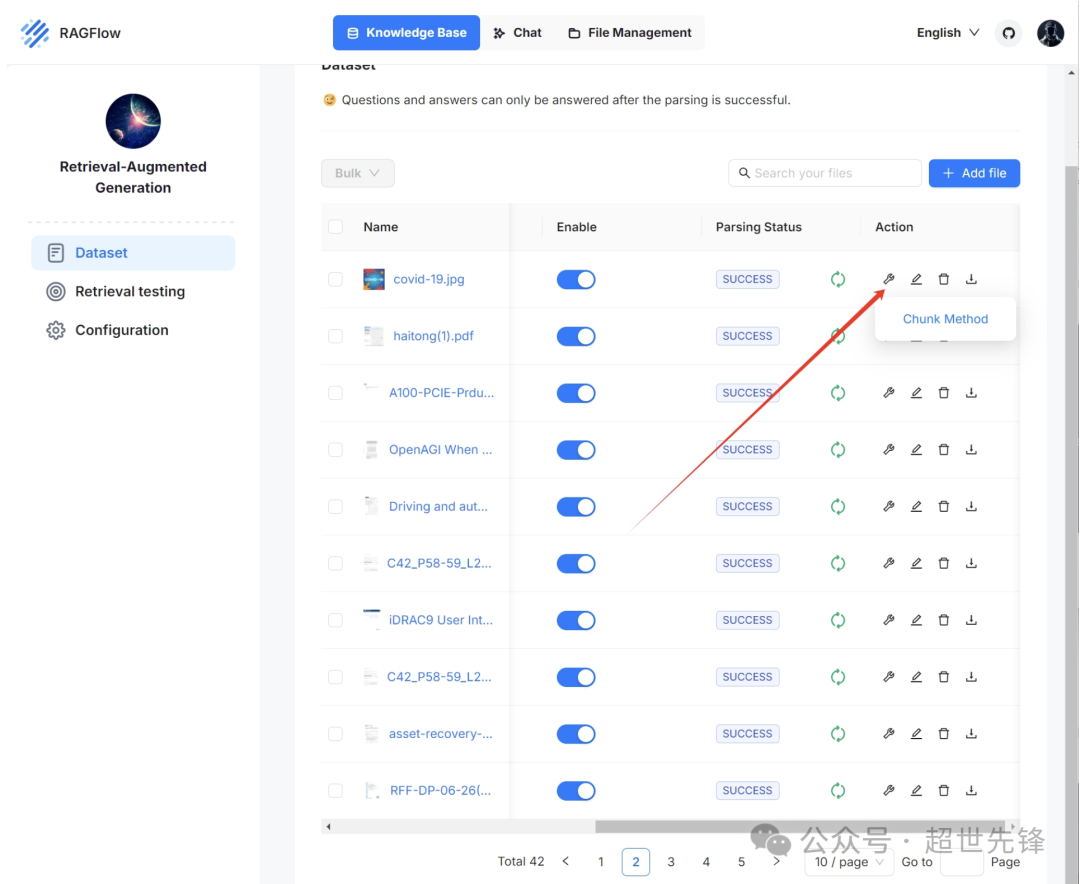
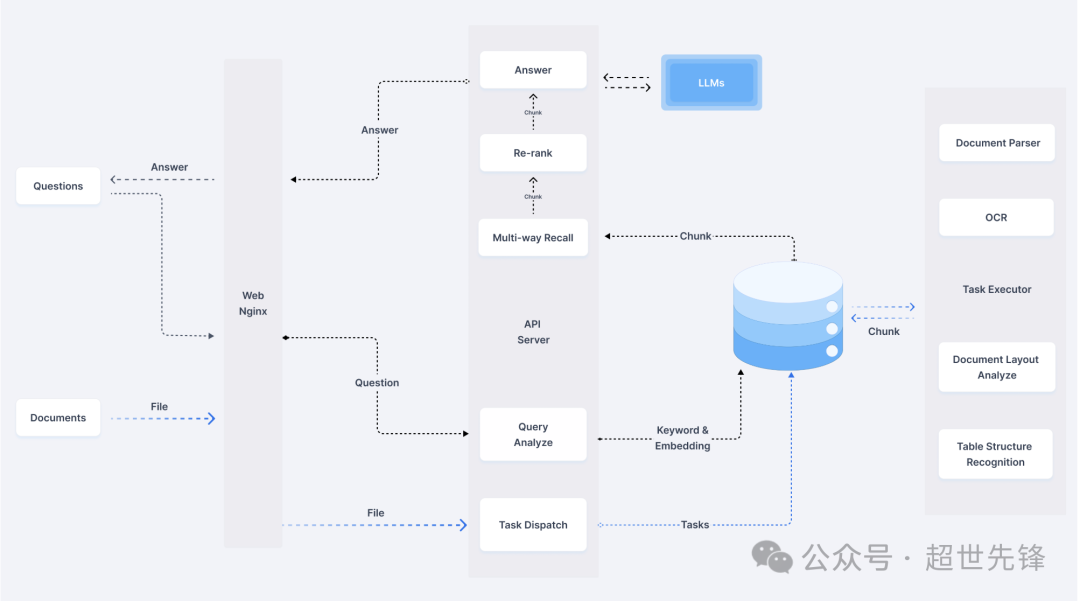
自动化 RAG 工作流:集成文档解析、嵌入、检索、生成全流程自动化,支持多路召回与重排序技术,优化检索效率。用户可通过 API 快速对接企业系统,适用于从个人到大型企业的需求。

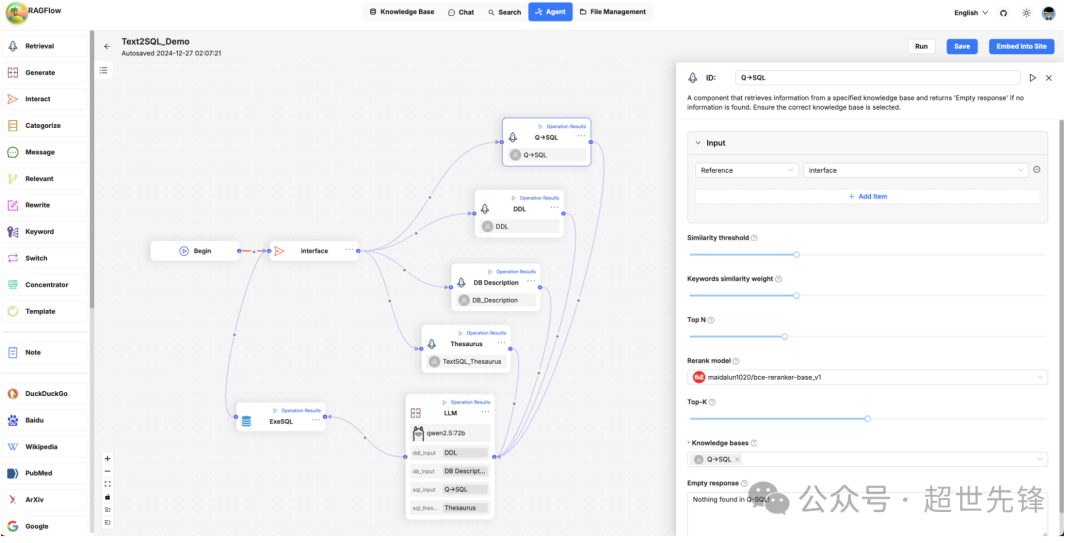
知识图谱与 Agent 增强
GraphRAG 支持:通过知识图谱优化全局语义检索,解决复杂查询问题(如金融投顾需融合多源数据生成答案)。
Agent 框架:支持自定义工具链(如医疗问诊、金融分析模板),结合多模型协作实现复杂任务(如调用 PubMed 论文库生成诊断建议)。
多模态与本地化部署
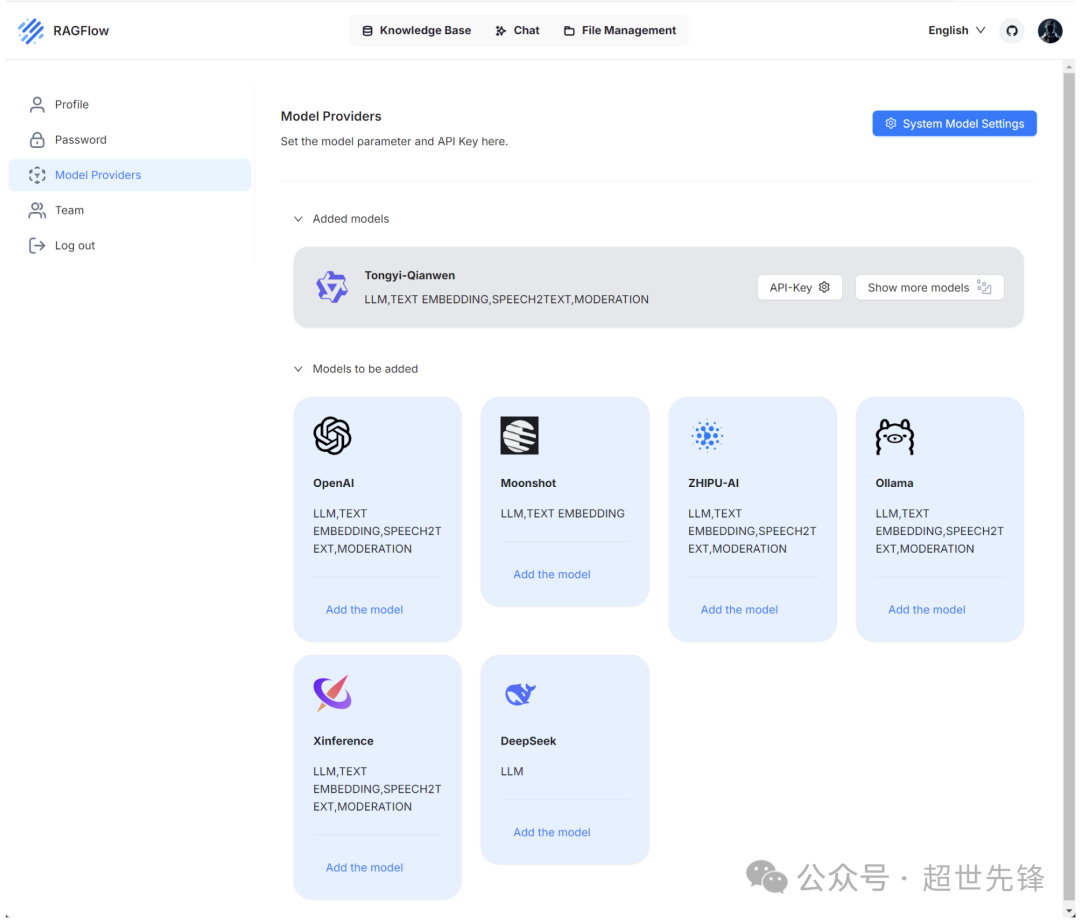
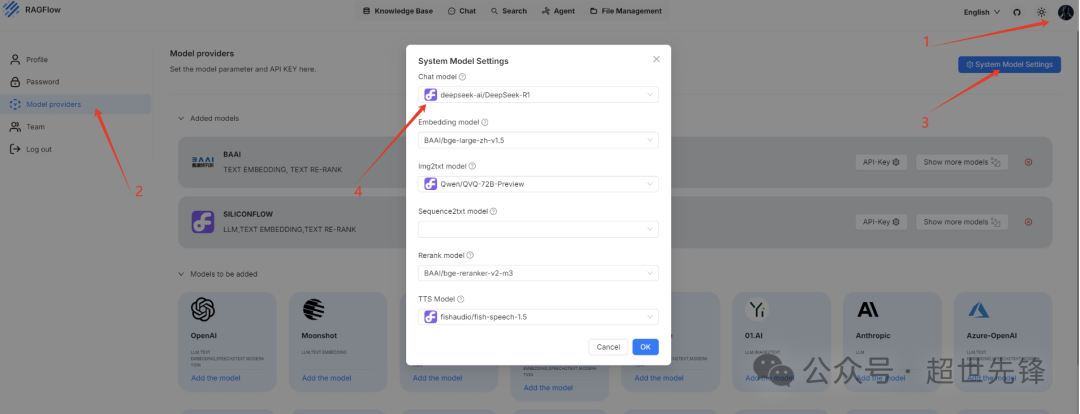
支持本地部署(如 Ollama + Qdrant),保障数据隐私;
集成 TTS(语音合成)和 ASR(语音识别)功能,实现端到端语音交互(需配置第三方 API)。
系统架构
部署体验
git clone https://github.com/infiniflow/ragflow.git
$ cd ragflow/docker
$ git checkout -f v0.17.2
# Use CPU for embedding and DeepDoc tasks:
$ docker compose -f docker-compose.yml up -d
# To use GPU to accelerate embedding and DeepDoc tasks:
# docker compose -f docker-compose-gpu.yml up -d
4,FastGPT
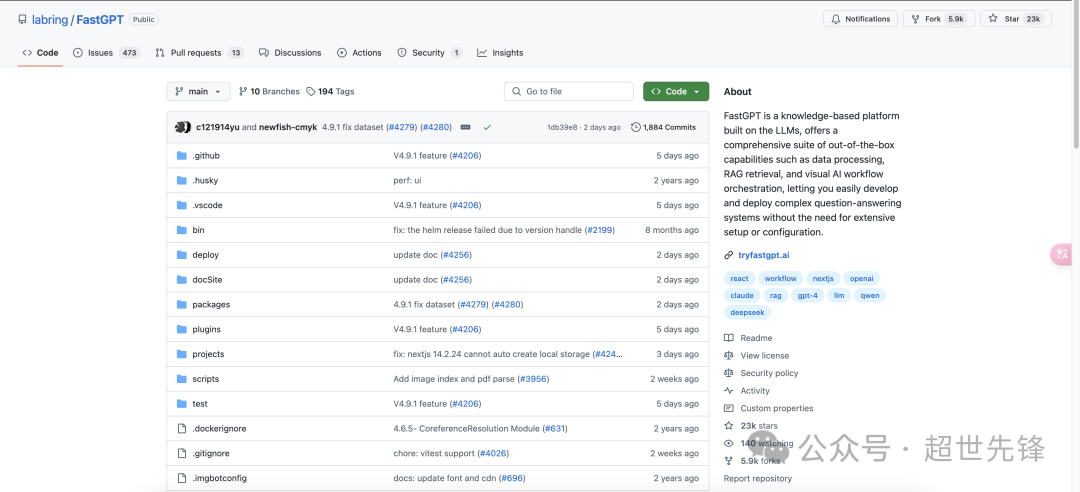
核心优势:拖拽式可视化界面,OpenAI API兼容,支持快速搭建轻量级问答系统。
适用场景:企业微信/飞书智能客服、学术文献问答。
推荐指数:★★★☆
GitHub星数:23k+
开源协议:Apache License 2.0
项目地址:https://github.com/labring/FastGPT
项目介绍
FastGPT 是一个基于 LLM 大语言模型的知识库问答系统,提供开箱即用的数据处理、模型调用等能力。同时可以通过 Flow 可视化进行工作流编排,从而实现复杂的问答场景!
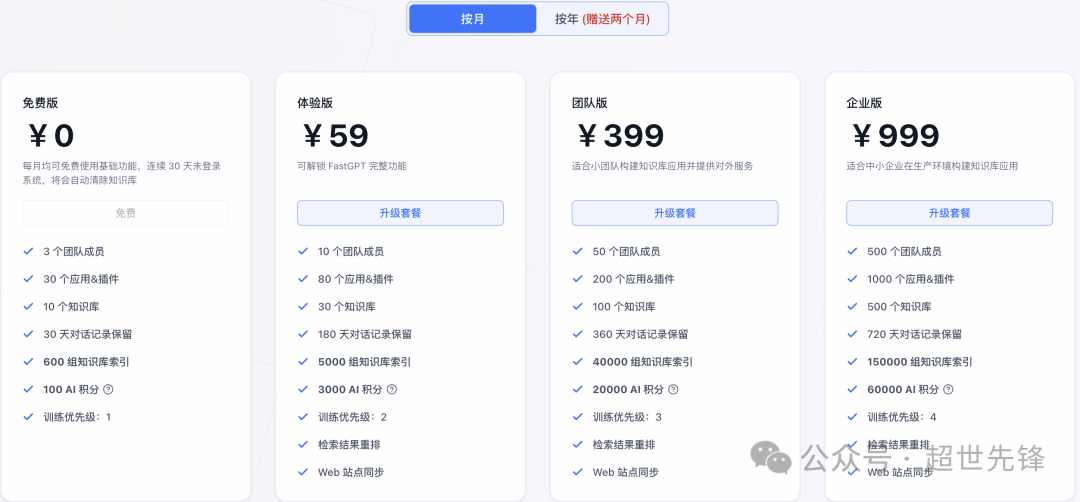
价格
功能特点
数据处理和模型调用:FastGPT能够整合与优化大量的非结构化数据,如文本文档、PDF文件、电子邮件等。系统会自动对内容进行结构化处理,为后续的信息检索和分析打下基础。
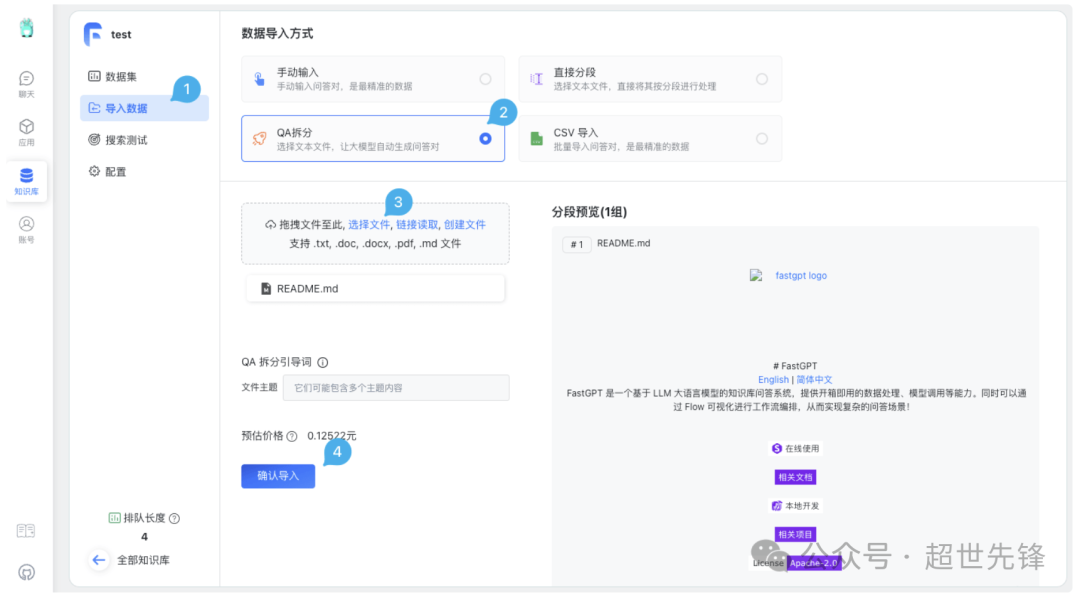
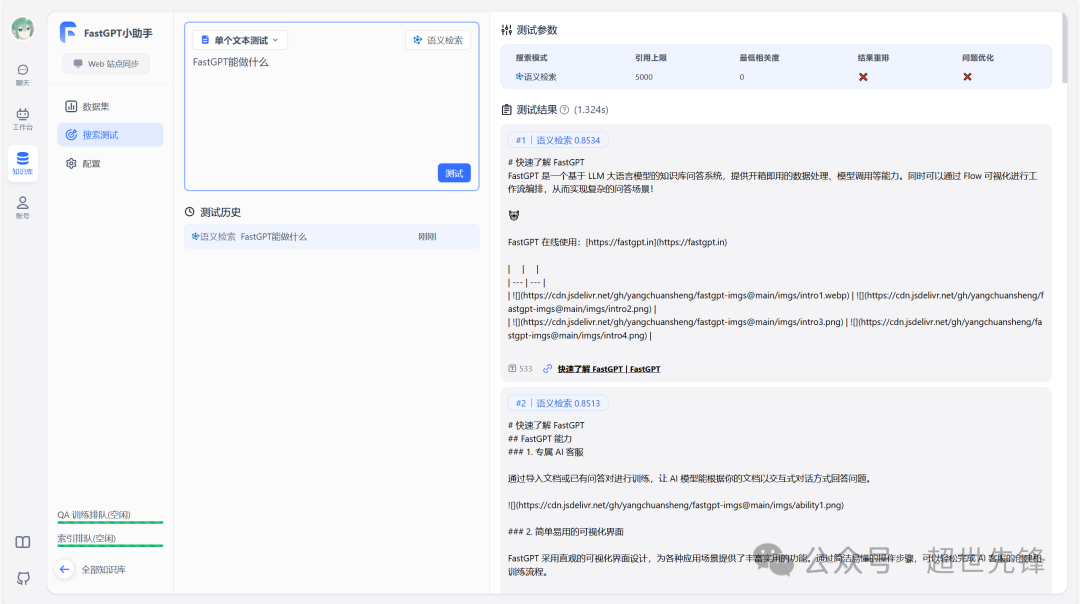
知识库构建:用户可以将不同格式的文件导入系统,构建专属的知识库。FastGPT支持动态更新和扩展库中的内容,提供精确的问答服务。
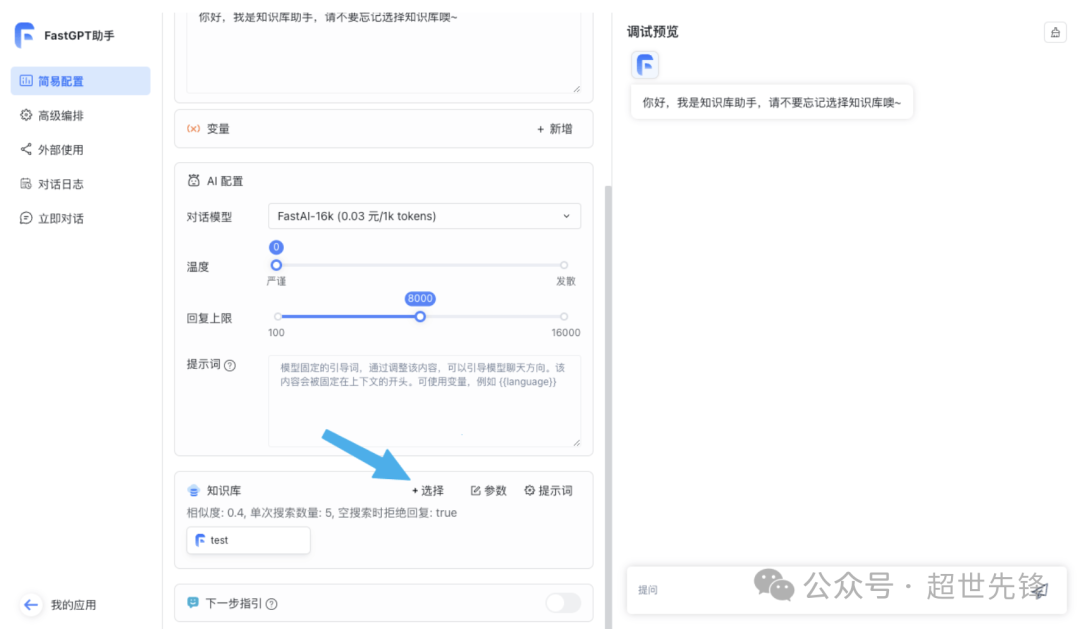
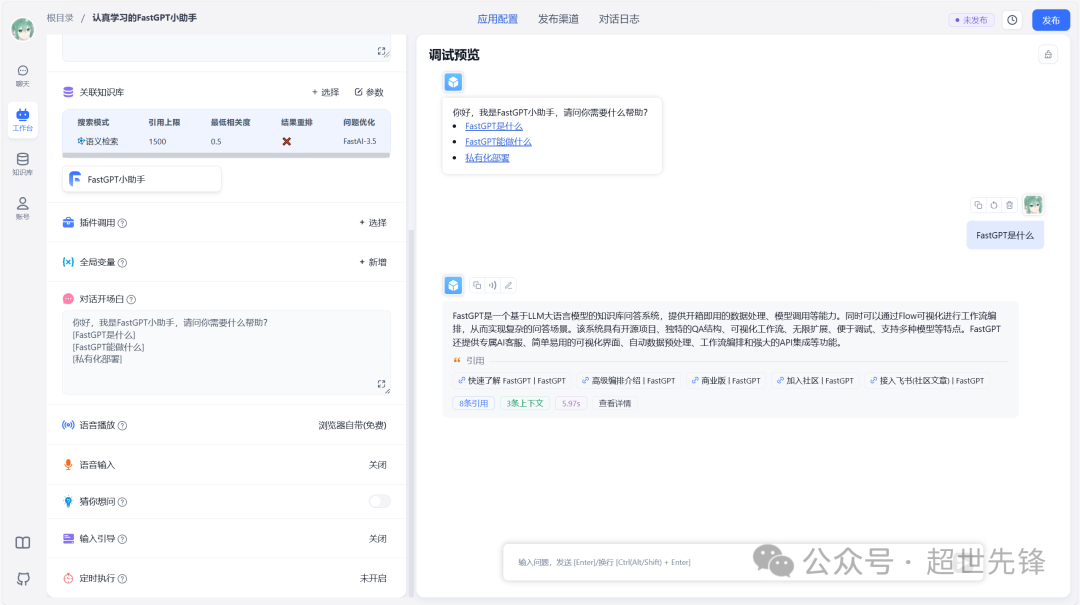
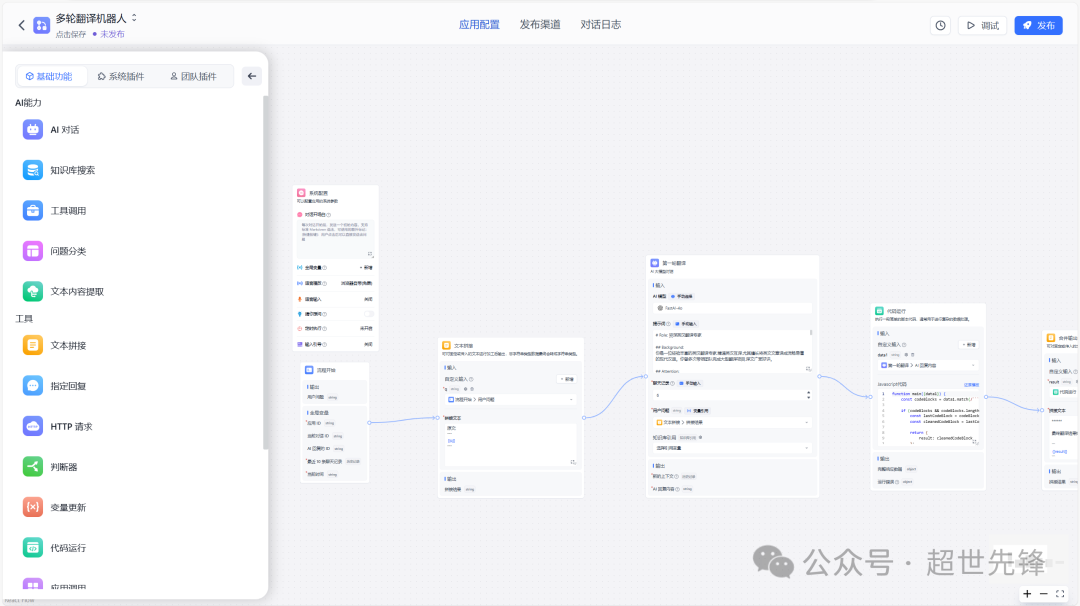
工作流编排:FastGPT提供了强大的工作流编排功能,用户可以通过Flow可视化进行工作流编排,实现复杂的问答场景。这大大提高了系统的易用性和灵活性。
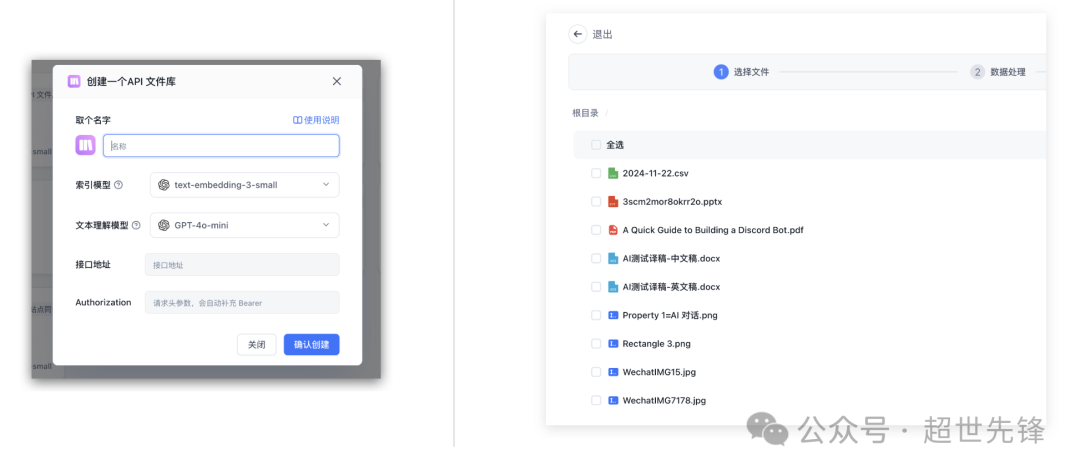
API集成:FastGPT支持强大的API集成功能,可以轻松集成到其他平台,与现有系统快速集成,支持企业按需扩展功能。
自动化处理:FastGPT能够自动化处理大量数据,显著提升信息检索和分析的效率,解放人力。其“循环运行”节点功能特别适用于批量处理大量数据,如批量翻译、内容摘要生成等。
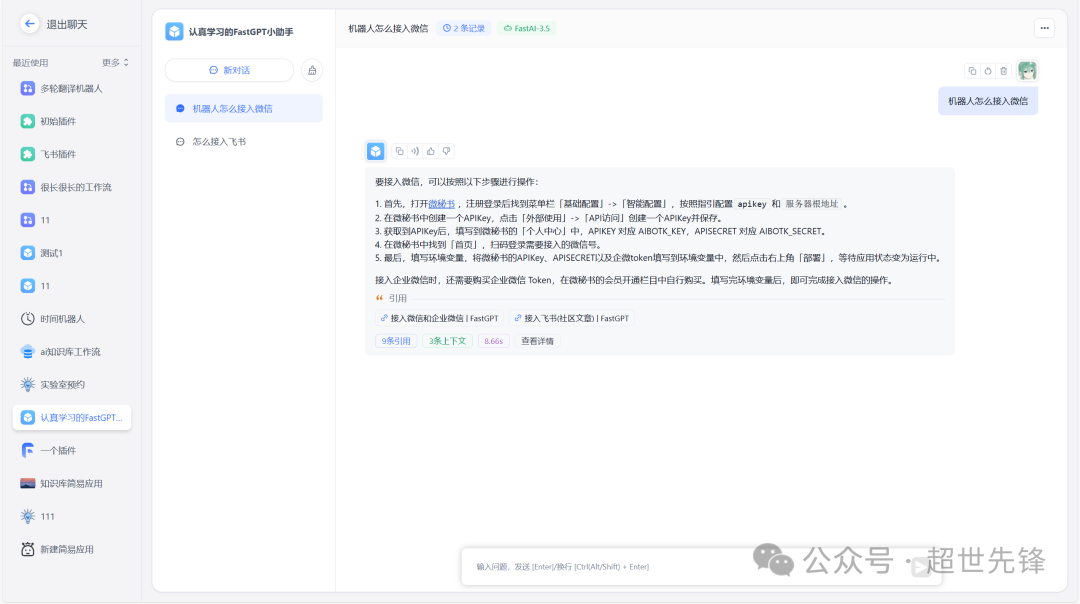
RAG技术(Retrieval-Augmented Generation):FastGPT结合了检索和生成技术,通过引用外部知识库的信息来生成答案或内容,具有较高的可解释性和定制能力。这种技术适用于问答系统、文档生成、智能助手等多个自然语言处理任务。
部署体验
mkdir fastgpt
cd fastgpt
curl -O https://raw.githubusercontent.com/labring/FastGPT/main/projects/app/data/config.json
# pgvector 版本(测试推荐,简单快捷)
curl -o docker-compose.yml https://raw.githubusercontent.com/labring/FastGPT/main/deploy/docker/docker-compose-pgvector.yml
# milvus 版本
# curl -o docker-compose.yml https://raw.githubusercontent.com/labring/FastGPT/main/deploy/docker/docker-compose-milvus.yml
# zilliz 版本
# curl -o docker-compose.yml https://raw.githubusercontent.com/labring/FastGPT/main/deploy/docker/docker-compose-zilliz.yml
# 启动容器
docker-compose up -d
# 目前可以通过 ip:3000 直接访问(注意开放防火墙)。登录用户名为 root,密码为docker-compose.yml环境变量里设置的 DEFAULT_ROOT_PSW。
# 首次运行,会自动初始化 root 用户,密码为 1234(与环境变量中的DEFAULT_ROOT_PSW一致),日志可能会提示一次MongoServerError: Unable to read from a snapshot due to pending collection catalog changes;可忽略。
二、轻量化与自动化框架:快速迭代与动态数据
1,AutoRAG
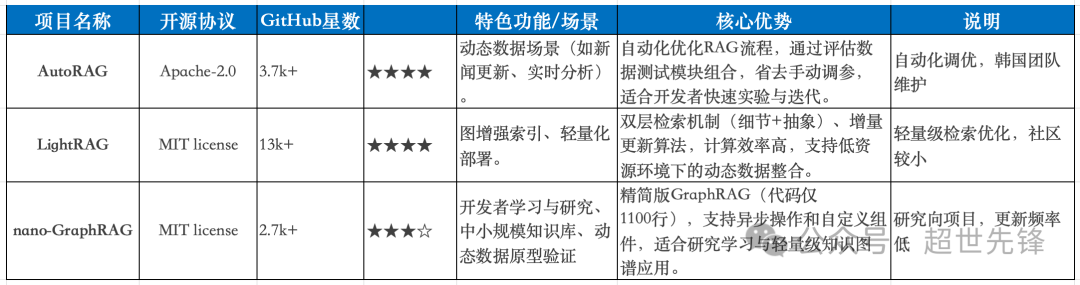
核心优势:自动化优化RAG流程,通过评估数据测试模块组合,省去手动调参,适合开发者快速实验与迭代。
适用场景:动态数据场景(如新闻更新、实时分析)。
推荐指数:★★★★
GitHub星数:3.7k+
开源协议:Apache License 2.0
项目地址:https://github.com/Marker-Inc-Korea/AutoRAG
项目简介
AutoRAG 是一款自动优化 RAG(Retrieval-Augmented Generation)管道的工具。RAG 管道结合了检索和生成模型,用于提高自然语言处理任务的性能。然而,找到适用于特定数据和用例的最佳 RAG 管道是一个复杂且耗时的过程。
AutoRAG 通过自动化评估各种 RAG 模块组合,帮助用户快速找到最优的 RAG 管道。
功能特性
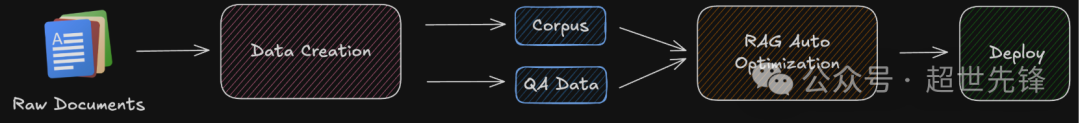
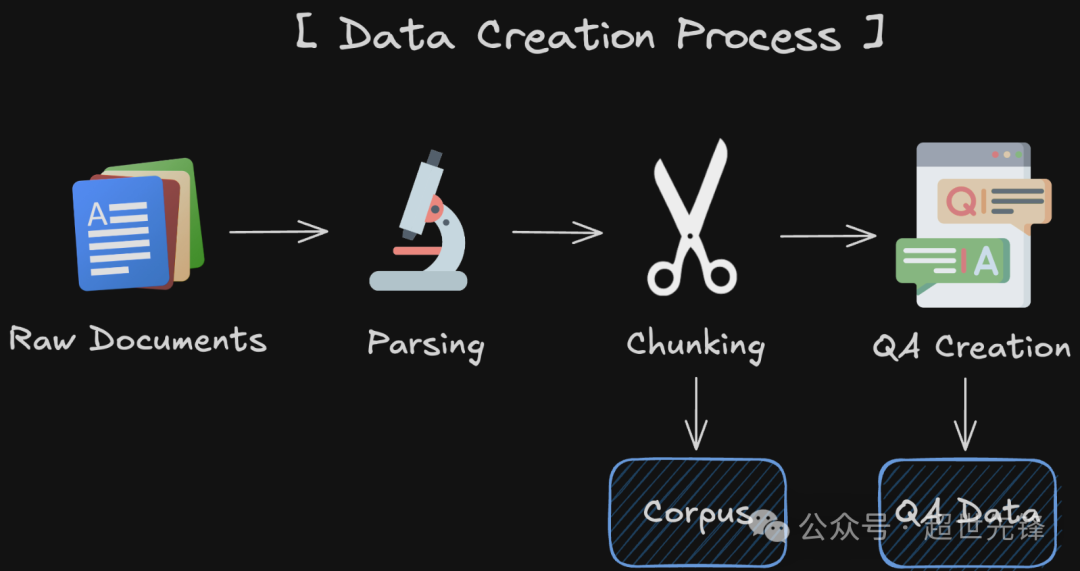
数据创建:支持解析、切分和生成 QA 数据集。
解析:将原始文档转换为可处理的格式。
切分:将解析后的文档切分成小片段。
生成 QA:生成问题和答案对,用于评估 RAG 管道。
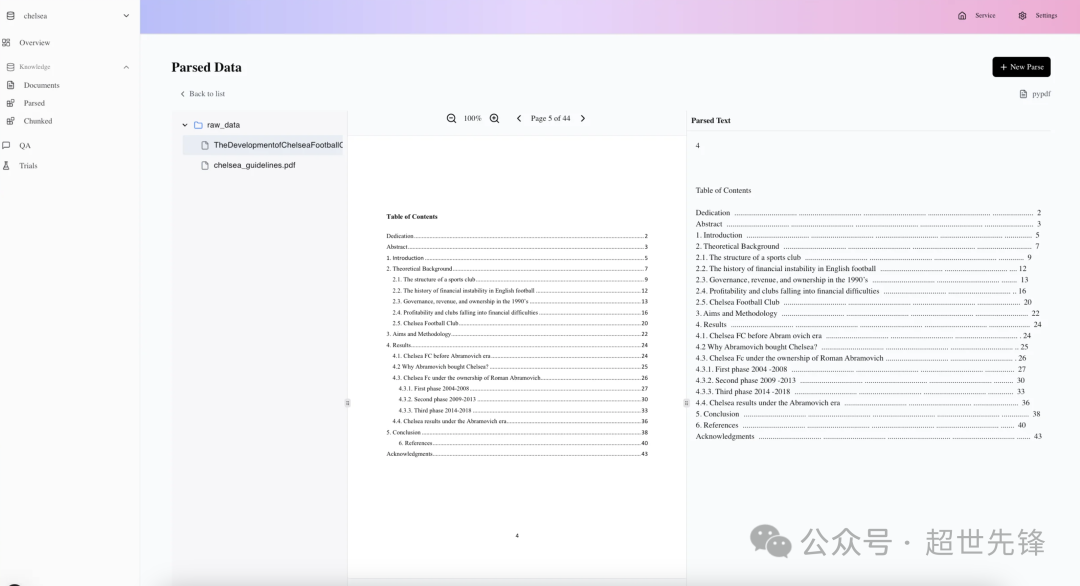
RAG 优化:自动评估和优化不同的 RAG 模块组合。
节点和模块:支持多种 RAG 模块,如检索器、提示生成器和生成器。
评估指标:使用多种评估指标,如 F1 分数、召回率、MRR 和 ROUGE 等。
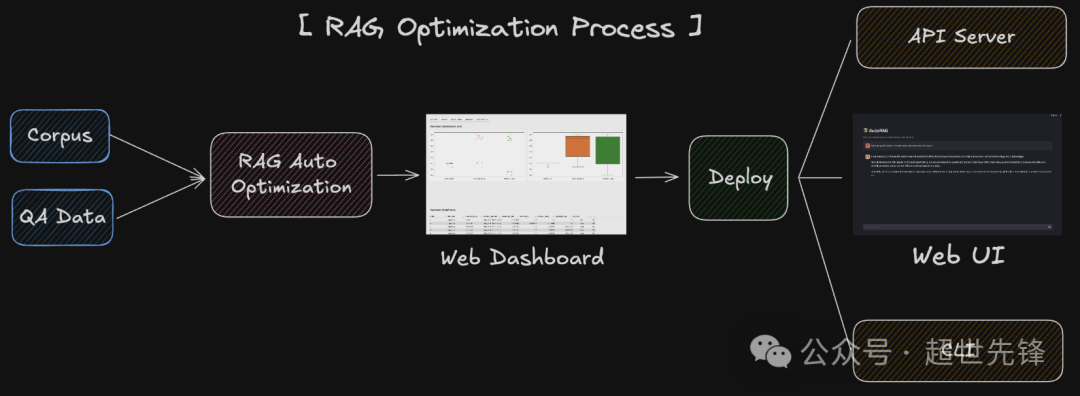
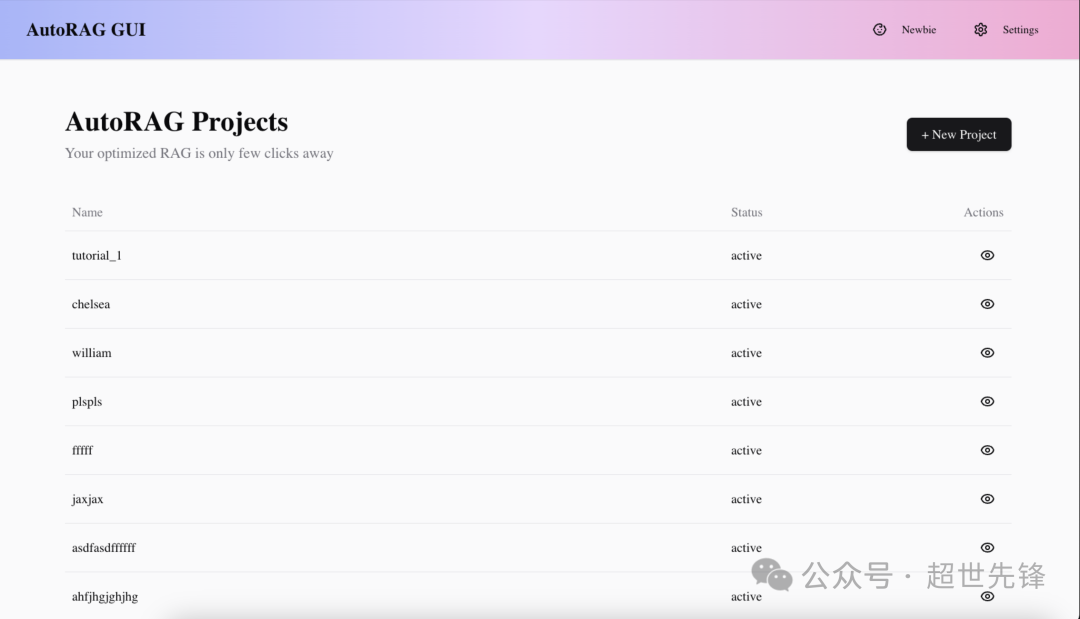
部署:提供多种方式部署优化后的 RAG 管道,包括 API 服务器和 Web 界面。
API 服务器:将优化后的 RAG 管道部署为 API 服务器。
Web 界面:提供用户友好的 Web 界面,方便用户使用。
部署体验
# 方式一:pip安装
# Python 版本 3.10 或更高版本
pip install AutoRAG
#使用本地模型,安装 gpu 版本
pip install "AutoRAG[gpu]"
#使用 parsing 版本。
pip install "AutoRAG[gpu,parse]"
# 方式二;代码安装
# 克隆代码
git clone https://github.com/Marker-Inc-Korea/AutoRAG.git
cd AutoRAG
# 运行
docker compose up -d
# 访问地址:http://localhost:3000
2,LightRAG
核心优势:双层检索机制(细节+抽象)、增量更新算法,计算效率高,支持低资源环境下的动态数据整合。
特色功能:图增强索引、轻量化部署。
推荐指数:★★★★
GitHub星数:13k+
开源协议:MIT license
项目地址:https://github.com/HKUDS/LightRAG
项目介绍
LightRAG 是由香港大学团队提出的开源 RAG 框架,通过引入 知识图谱 和 增量更新算法,显著提升了检索效率与生成质量。LightRAG 通过 图索引 与 双层检索 的创新设计,解决了传统 RAG 在复杂语义理解与动态数据更新中的瓶颈。其轻量化、高性价比的特性,使其成为企业、研究机构构建智能问答系统的优选方案。
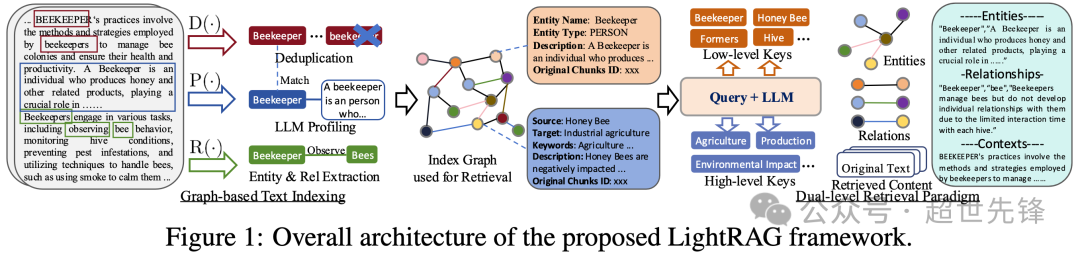
功能特性
图增强文本索引
实体与关系提取:利用大语言模型(LLM)从文档中提取实体(如人物、地点)及其关系(如“开发”“影响”),构建知识图谱,增强对复杂语义的理解。
去重优化:通过去重函数合并相同实体与关系,减少图谱冗余,提升检索效率。
键值对生成:为每个实体和关系生成文本键值对(如“蜜蜂→昆虫,授粉者”),支持高效检索与上下文生成。
双层检索框架
低层检索:针对具体实体或细节(如“蜂巢中的蜂王数量”),基于图谱节点精准匹配信息。
高层检索:处理抽象概念(如“气候变化对农业的影响”),通过聚合图谱中的全局主题生成综合性答案。
混合模式(Hybrid):结合低层与高层检索,兼顾细节与全局,提升回答的全面性。
增量更新机制
新增文档时,仅需提取新实体与关系并合并到现有图谱,无需全量重建,大幅降低计算成本。
支持动态数据环境(如新闻更新、实时分析),确保知识库的实时性。
多模型兼容性
云端模型:支持 OpenAI、Azure 等接口,兼容 GPT-4o-mini 等轻量化模型。
本地模型:集成 Hugging Face、Ollama(如 Llama-3、nomic-embed-text),实现全本地化部署。
部署体验
# 方式一:代码安装
git clone https://github.com/HKUDS/LightRAG.git
cd LightRAG
cp .env.example .env
pip install -e .
# 方式二:PyPI 安装
pip install lightrag-hku
# 方式三:docker安装
docker-compose up -d
# 访问地址:http://localhost:9621
3,nano-GraphRAG
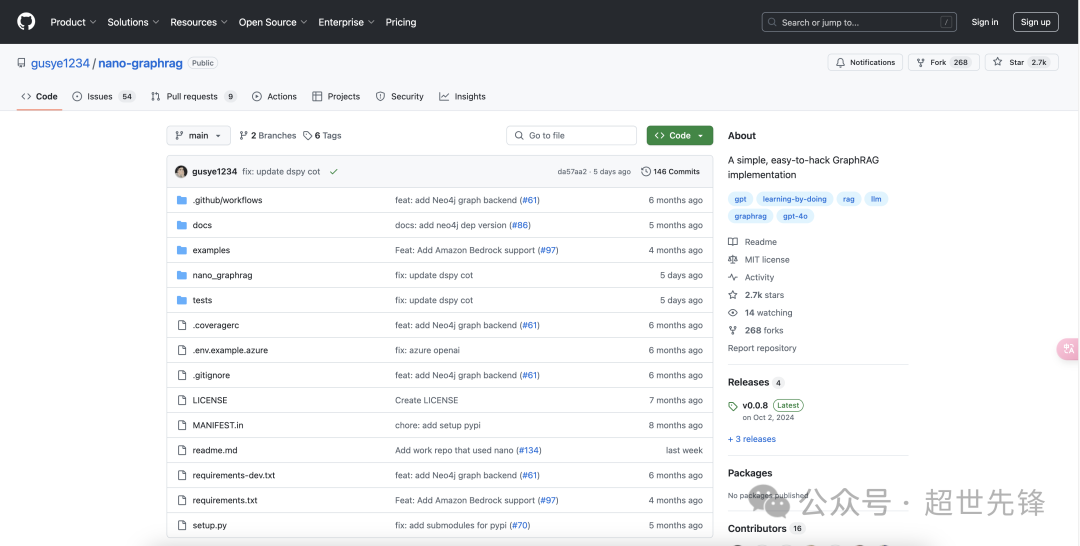
核心优势:精简版GraphRAG(代码仅1100行),支持异步操作和自定义组件,适合研究学习与轻量级知识图谱应用。
推荐指数:★★★☆
GitHub星数:2.7k+
开源协议:MIT license
项目地址:https://github.com/gusye1234/nano-graphrag
项目简介
nano-GraphRAG 是一个轻量级、高可定制的 GraphRAG(图检索增强生成)框架,旨在简化传统 GraphRAG 的复杂性,同时保留其核心功能。nano-GraphRAG 的代码量仅仅约为 1100 行(不包括测试和提示),设计为轻量级、异步和完全类型化,是希望将 GraphRAG 集成到项目中而不增加复杂性的开发者的理想选择。
功能特性
简洁性:代码量小,易于理解和维护。
易用性:提供简单的API接口,方便集成到现有项目中。
可定制性:支持多种分块策略、实体提取策略以及替换默认组件(如LLM函数、Embedding函数和Vector数据库组件),适用于不同的应用场景。
轻量级:设计为轻量级、异步和完全类型化,适合资源受限的环境。
部署体验
# 方式一:从源安装(推荐)
git clone https://github.com/gusye1234/nano-graphrag.git
cd nano-graphrag
pip install -e .
# 方式二:PyPi 安装
pip install nano-graphrag
三、企业级生产环境:高并发与稳定性
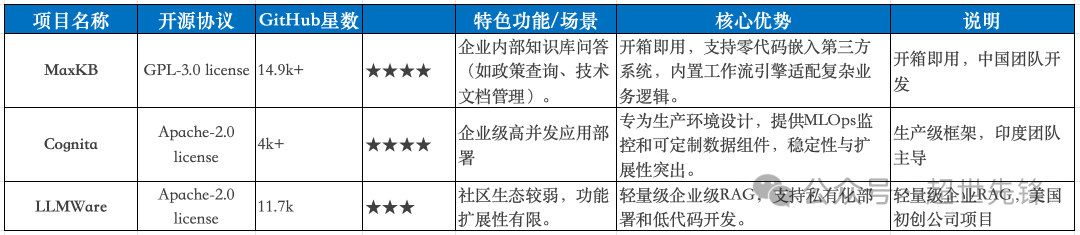
1,MaxKB
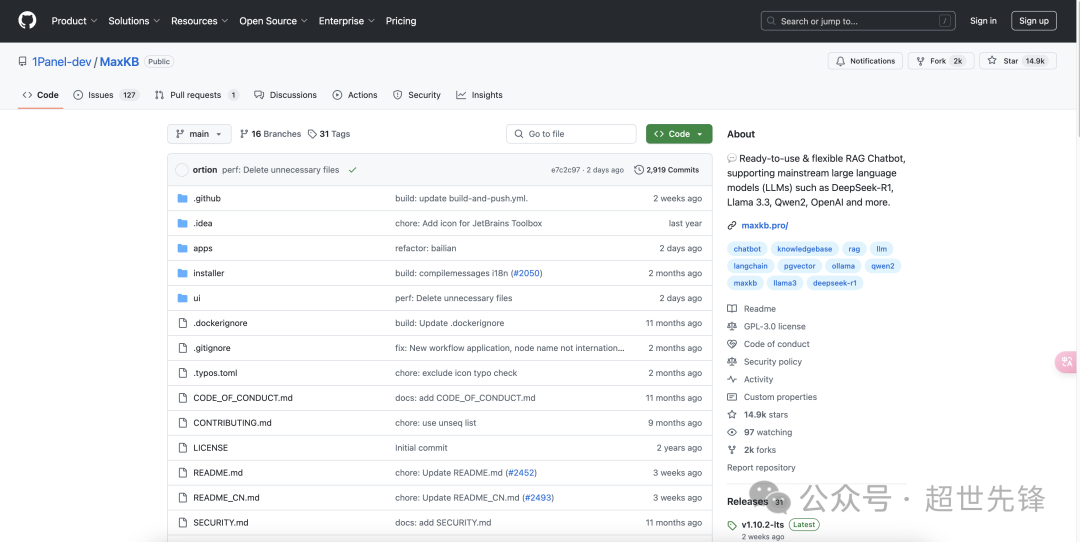
核心优势:开箱即用,支持零代码嵌入第三方系统,内置工作流引擎适配复杂业务逻辑。
适用场景:企业内部知识库问答(如政策查询、技术文档管理)。
推荐指数:★★★★
GitHub星数:14.9k+
开源协议: GPL-3.0 license
项目地址:https://github.com/1Panel-dev/MaxKB
项目介绍
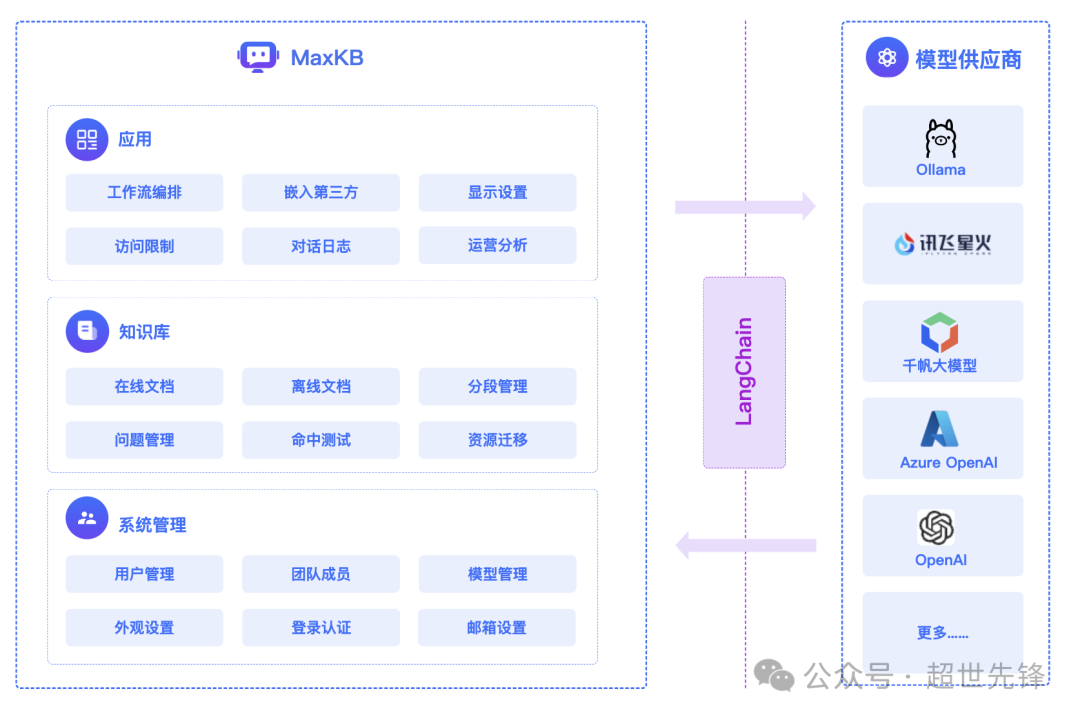
MaxKB = Max Knowledge Base,是一款基于大语言模型和 RAG 的开源知识库问答系统,广泛应用于智能客服、企业内部知识库、学术研究与教育等场景。
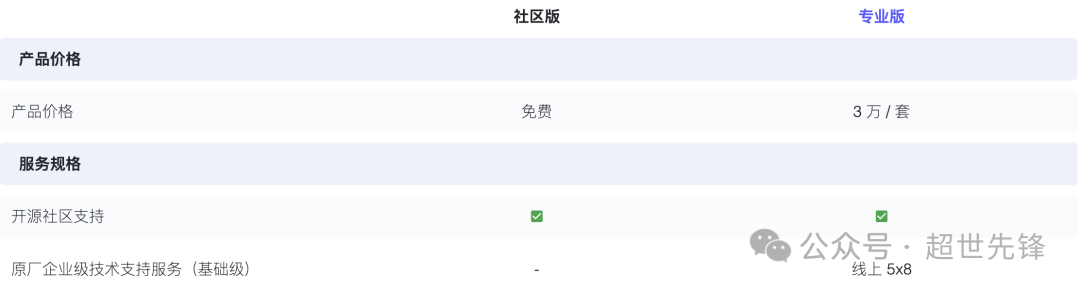
价格
# 功能特点
-
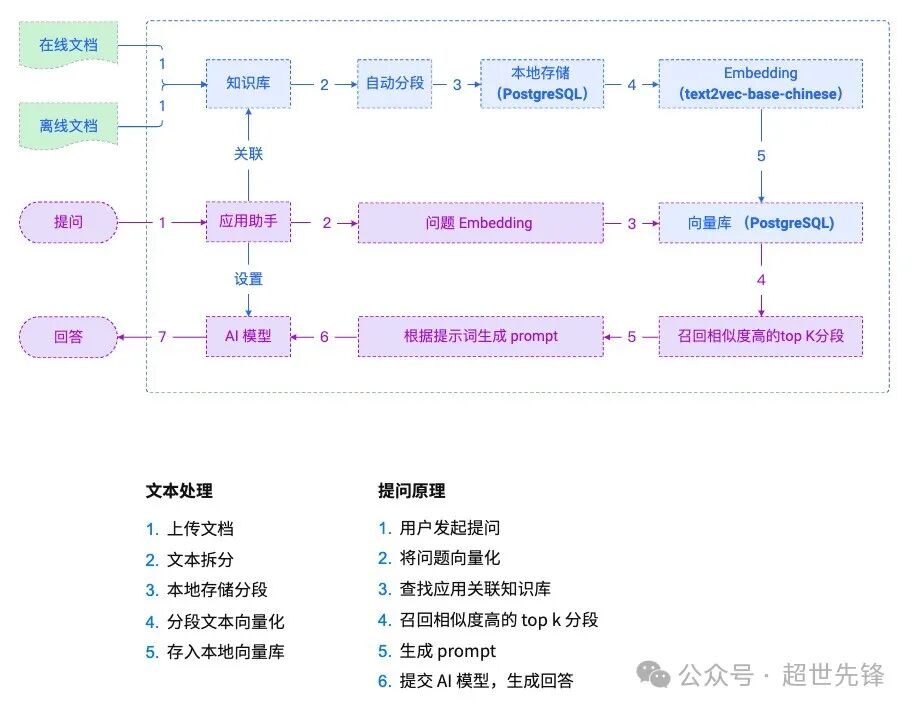
开箱即用:支持直接上传文档 / 自动爬取在线文档,支持文本自动拆分、向量化和 RAG(检索增强生成),有效减少大模型幻觉,智能问答交互体验好。
-
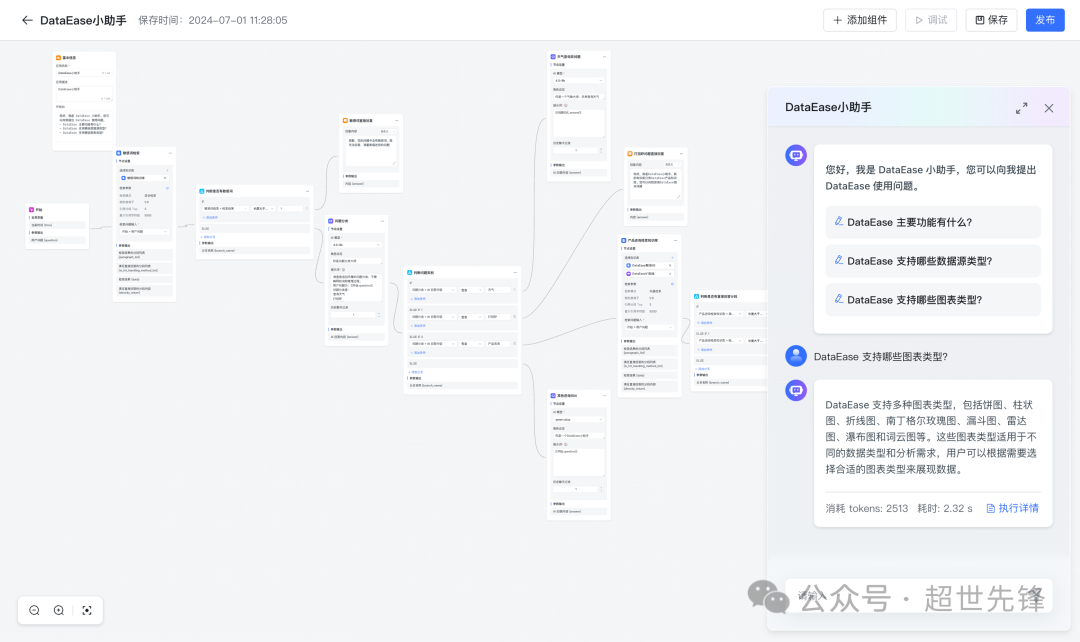
灵活编排:内置强大的工作流引擎和函数库,支持编排 AI 工作过程,满足复杂业务场景下的需求。
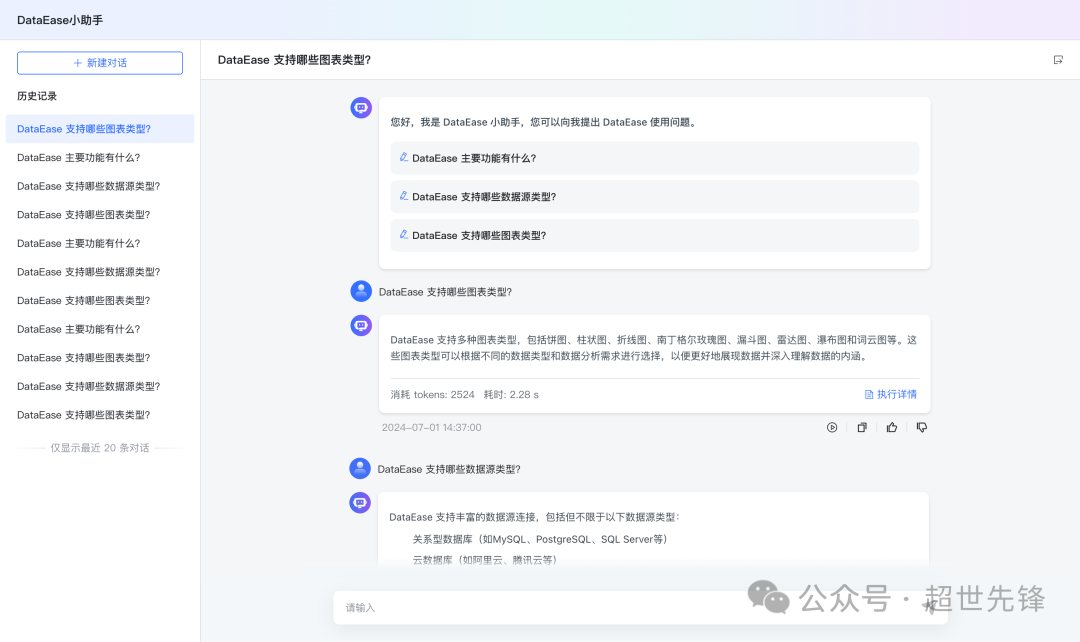
- 无缝嵌入:支持零编码快速嵌入到网站、办公系统(企业微信 / 钉钉 / 飞书)和第三方业务系统,让已有系统快速拥有智能问答能力,提高用户满意度。
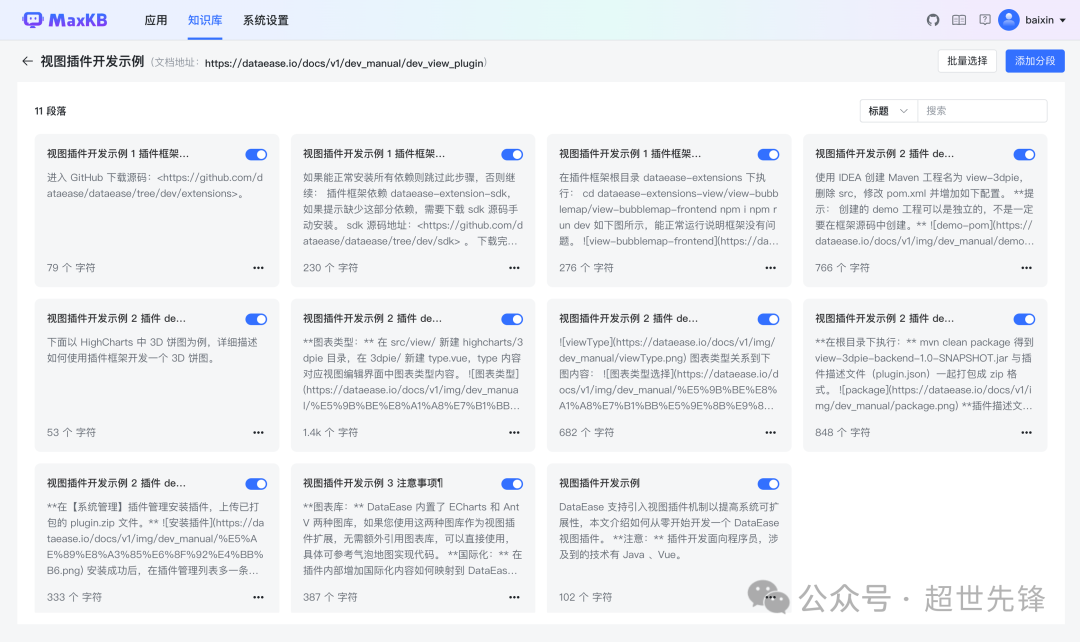
- 模型中立:支持对接各种大语言模型,包括本地私有大模型(DeepSeek / Llama / Qwen 等)、国内公共大模型(通义千问 / 腾讯混元 / 字节豆包 / 百度千帆 / 智谱 AI / Kimi 等)和国外公共大模型(OpenAI / Claude / Gemini 等)。
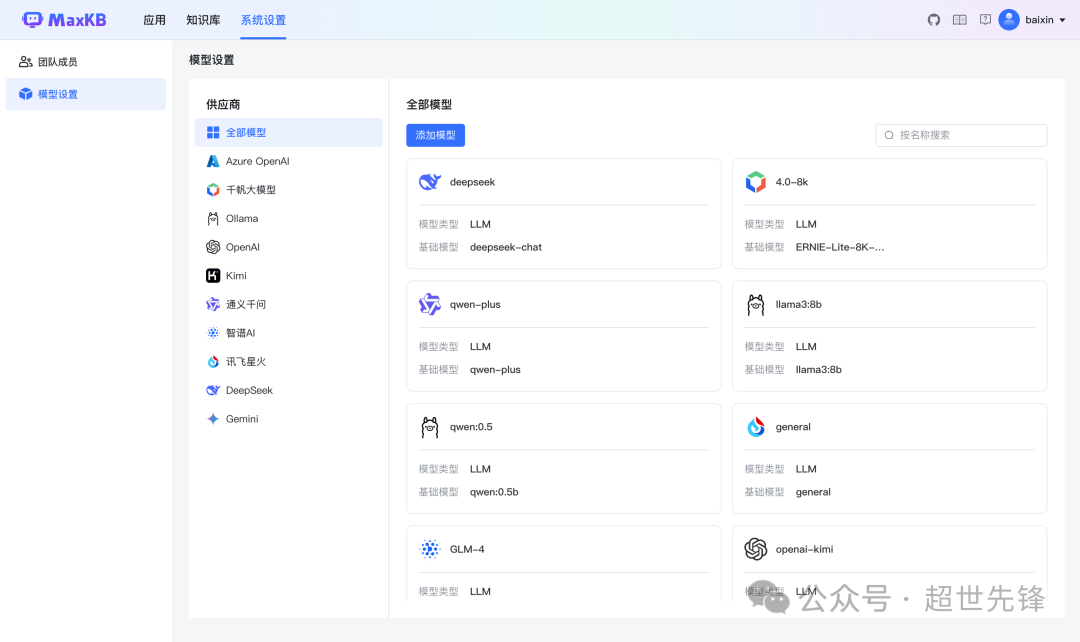
# 技术框架
实现原理
部署体验
# Linux 操作系统
docker run -d --name=maxkb --restart=always -p 8080:8080 -v ~/.maxkb:/var/lib/postgresql/data -v ~/.python-packages:/opt/maxkb/app/sandbox/python-packages registry.fit2cloud.com/maxkb/maxkb
# Windows 操作系统
docker run -d --name=maxkb --restart=always -p 8080:8080 -v C:/maxkb:/var/lib/postgresql/data -v C:/python-packages:/opt/maxkb/app/sandbox/python-packages registry.fit2cloud.com/maxkb/maxkb
待所有容器状态显示为healthy后,可通过浏览器访问 MaxKB:
http://目标服务器 IP 地址:8080
默认登录信息
用户名:admin
默认密码:MaxKB@123..
2,Cognita
核心优势:专为生产环境设计,提供MLOps监控和可定制数据组件,稳定性与扩展性突出。
适用场景:企业级高并发应用部署。
推荐指数:★★★★
GitHub星数:4k
开源协议:Apache-2.0 license
开源地址:https://github.com/truefoundry/cognita
项目介绍
Cognita是一个开源的RAG(Retrieval Augmented Generation)框架,由TrueFoundry开发。它旨在帮助开发者构建模块化、可扩展的生产级应用程序,特别适合需要端到端AI应用开发和部署的场景。Cognita通过简化构建和部署RAG系统的过程,使得不具备丰富编码经验的人也能使用。
功能特性
模块化设计:Cognita的每个RAG组件都是独立的模块,易于维护和扩展。所有组件通过API进行交互,方便集成到其他系统;
API驱动:所有组件都通过API进行交互,方便与其他系统集成,能够轻松连接现有的基础设施和数据流;
增量索引:默认支持增量索引,只对新增、更新的数据进行处理,减少计算负担,提高效率;
多模态支持:支持音频和视频解析,可处理多种类型的数据;
多模型兼容:支持 OpenAI、Llama3、DeepSeek 等主流 LLM,以及 Ollama 本地模型部署,适配不同资源环境。
Agent 框架:内置智能体工具链(如医疗问诊模板、金融分析模板),支持多模型协作与复杂任务处理(如调用 PubMed 论文库生成诊断建议。
部署体验
# 代码下载
git clone https://github.com/truefoundry/cognita.git
cd cognita
cp models_config.sample.yaml models_config.yaml
docker-compose --env-file compose.env up
# 访问 qdrant 服务器: http://localhost:6333
#访问后端: http://localhost:8000
#访问前端: http://localhost:5001
3,LLMWare
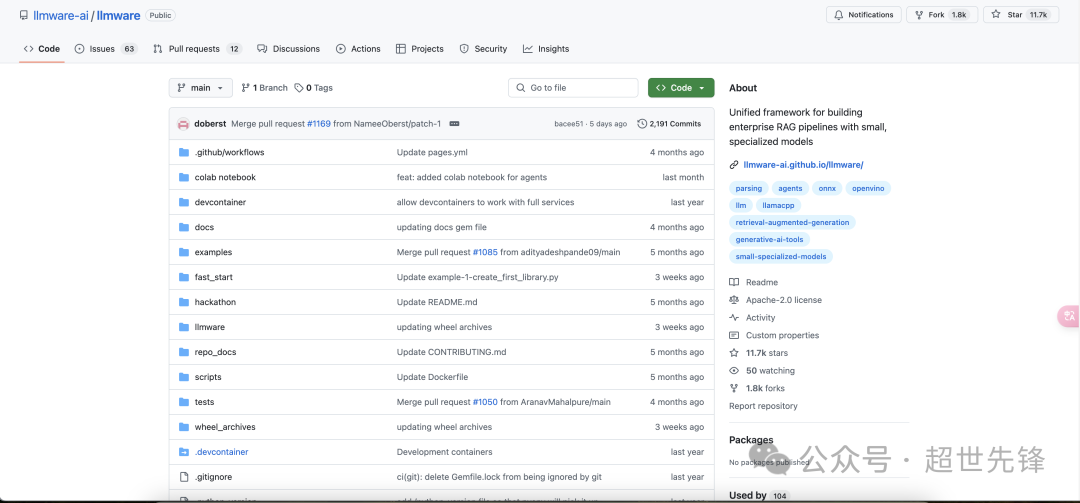
核心优势:轻量级企业级RAG,支持私有化部署和低代码开发。
不足:社区生态较弱,功能扩展性有限。
推荐指数:★★★
GitHub星数:11.7k
开源协议:Apache-2.0 license
开源地址:https://github.com/llmware-ai/llmware
项目介绍
llmware 提供了一个统一的框架,用于构建LLM基于应用程序(例如 RAG、代理),使用小型专用模型,这些模型可以私密部署,安全地与企业知识源集成,并且经济高效地调整和适应任何业务流程。
功能特性
LLMWARE 有两个主要组件:
RAG Pipeline - 用于将知识源连接到生成式 AI 模型的整个生命周期的集成组件.
50+ 小型专用模型,针对企业流程自动化中的关键任务进行了微调,包括基于事实的问答、分类、总结和提取
通过将这两个组件结合在一起,并集成领先的开源模型和底层技术,llmware 提供了一套全面的工具来快速构建基于知识的企业LLM应用程序。
部署体验
# 方式一:代码安装
git clone https://github.com/llmware-ai/llmware.git
cd llmware
sh ./welcome_to_llmware.sh
# 方式二:pip安装
pip3 install llmware
pip3 install 'llmware[full]'
四、隐私与本地化部署:敏感数据场景
1,Anything-LLM
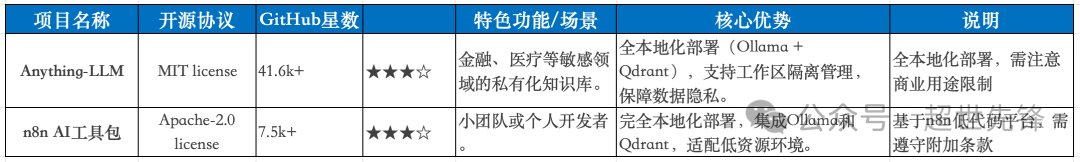
核心优势:全本地化部署(Ollama + Qdrant),支持工作区隔离管理,保障数据隐私。
适用场景:金融、医疗等敏感领域的私有化知识库。
推荐指数:★★★☆
开源协议:MIT
GitHub星数:41.6k+
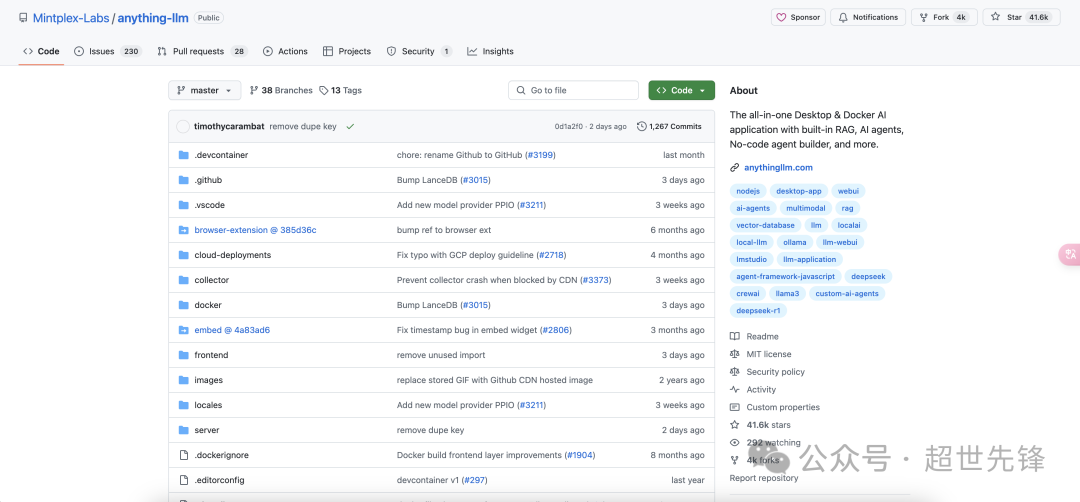
开源地址:https://github.com/Mintplex-Labs/anything-llm
项目介绍
AnythingLLM是一个全栈应用程序,您可以使用现成的商业大语言模型或流行的开源大语言模型,再结合向量数据库解决方案构建一个私有ChatGPT,不再受制于人:您可以本地运行,也可以远程托管,并能够与您提供的任何文档智能聊天。
下载地址
官网:https://anythingllm.com/
开源地址:
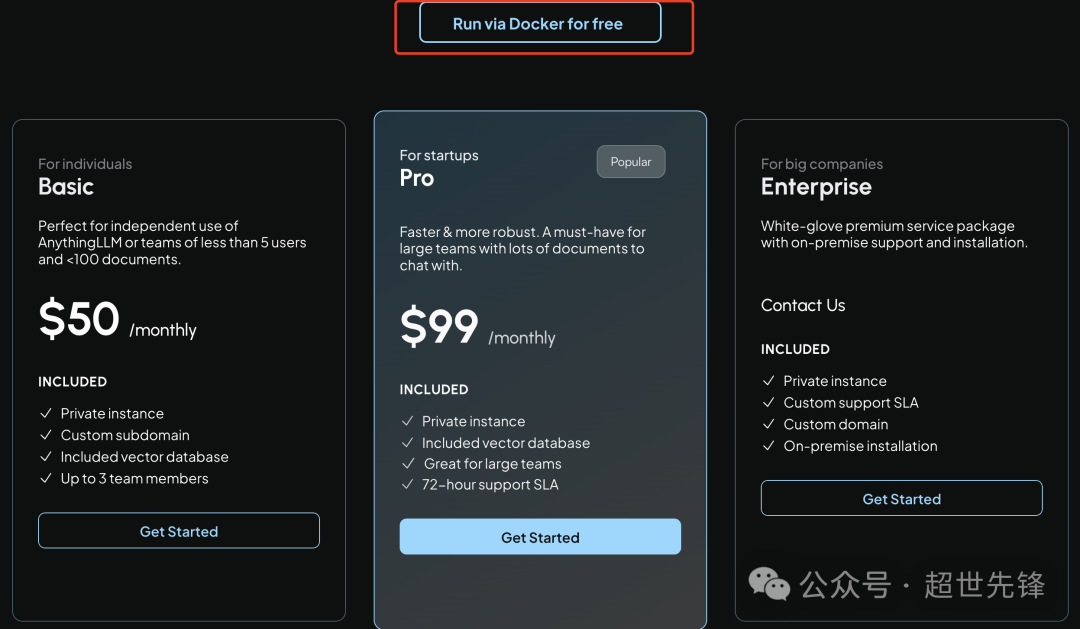
价格
功能特性
多模态文档支持与智能解析:支持 PDF、TXT、DOCX、网页链接等多种格式的文档,能够智能解析复杂结构(如表格、标题、图片),确保语义完整性。
提供可视化界面管理文档,支持批量上传和自动向量化处理,便于后续检索。
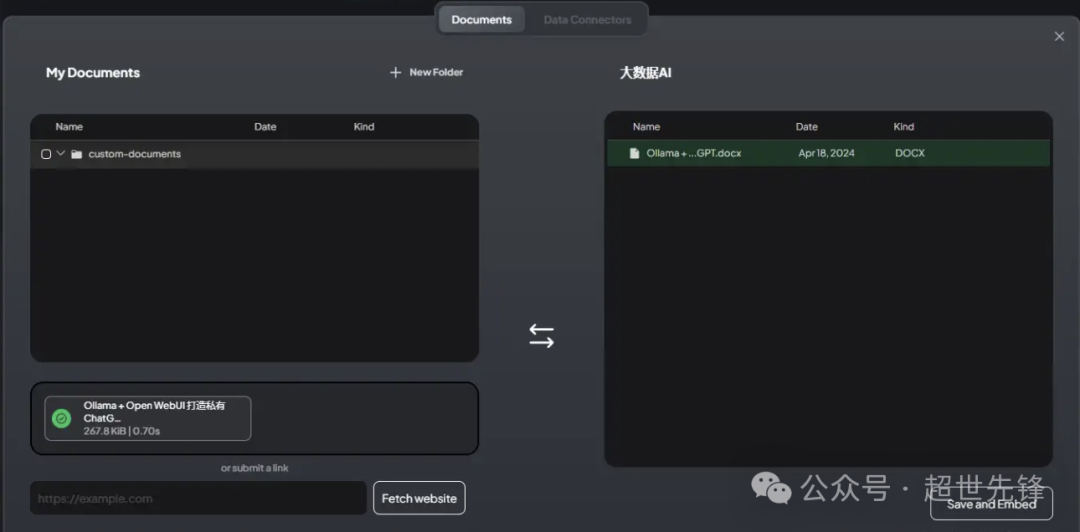
灵活的工作区(Workspace)管理:文档按“工作区”划分,每个工作区独立管理文档和对话上下文,避免不同主题间的干扰。
支持多用户协作,可设置权限控制(如管理员、编辑者、只读用户),适用于企业级场景。
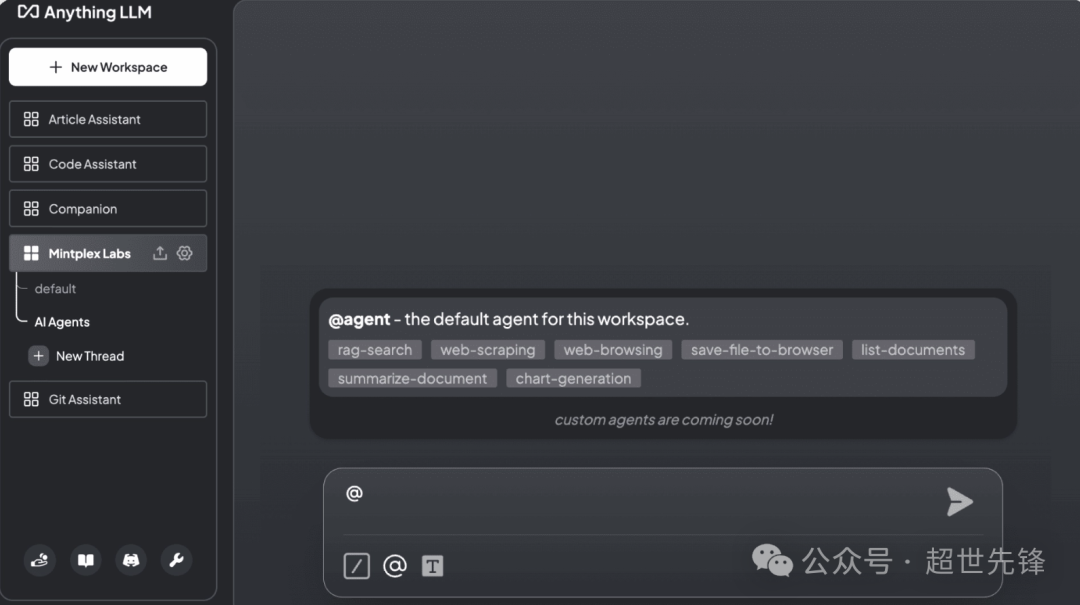
双模式交互:对话与查询
对话模式:保留历史上下文,支持连贯的多轮对话,适用于复杂问题讨论。
查询模式:专注于文档内容的直接问答,回答仅基于检索结果,减少幻觉风险。
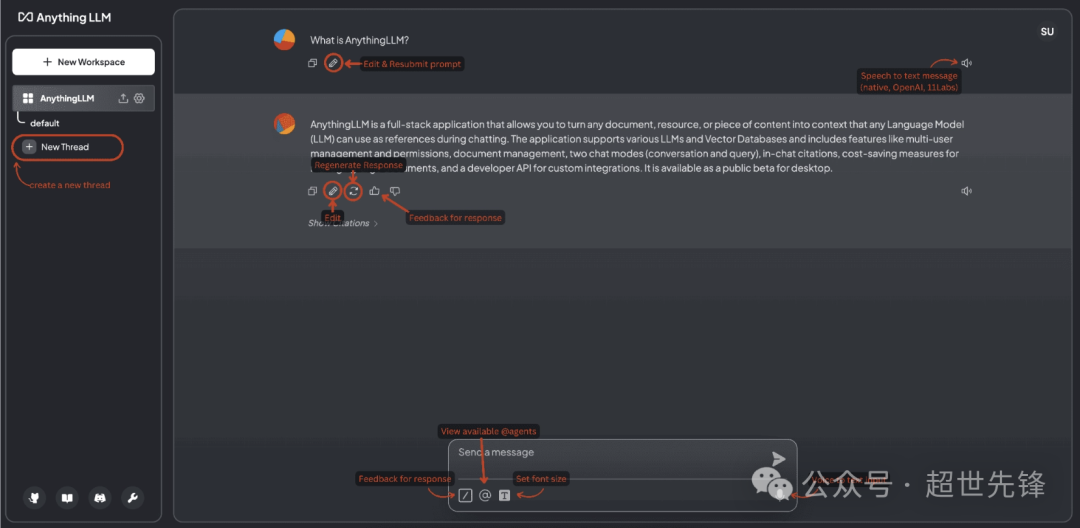
引用溯源与可信度增强:答案生成时自动关联原始文档片段,用户可查看引用来源及匹配度评分,便于验证信息准确性。
提供相似度阈值设置,过滤低相关性内容,优化检索质量。
模型与数据库兼容性:
LLM 支持:兼容 OpenAI、Azure、Anthropic、Llama3 等 20+ 主流模型,支持本地部署(如 Ollama)或云端 API 调用。
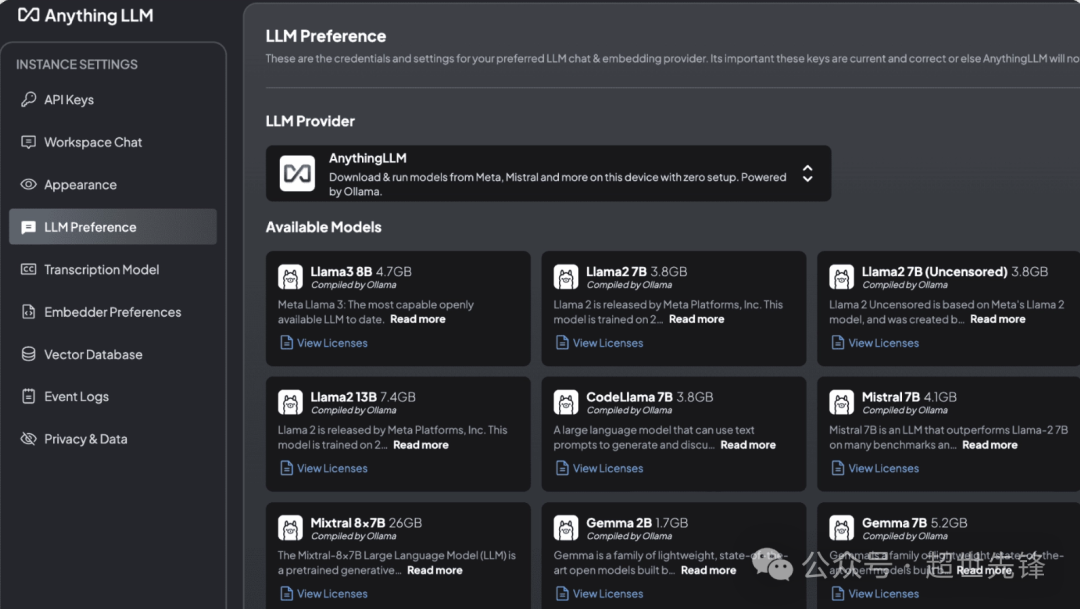
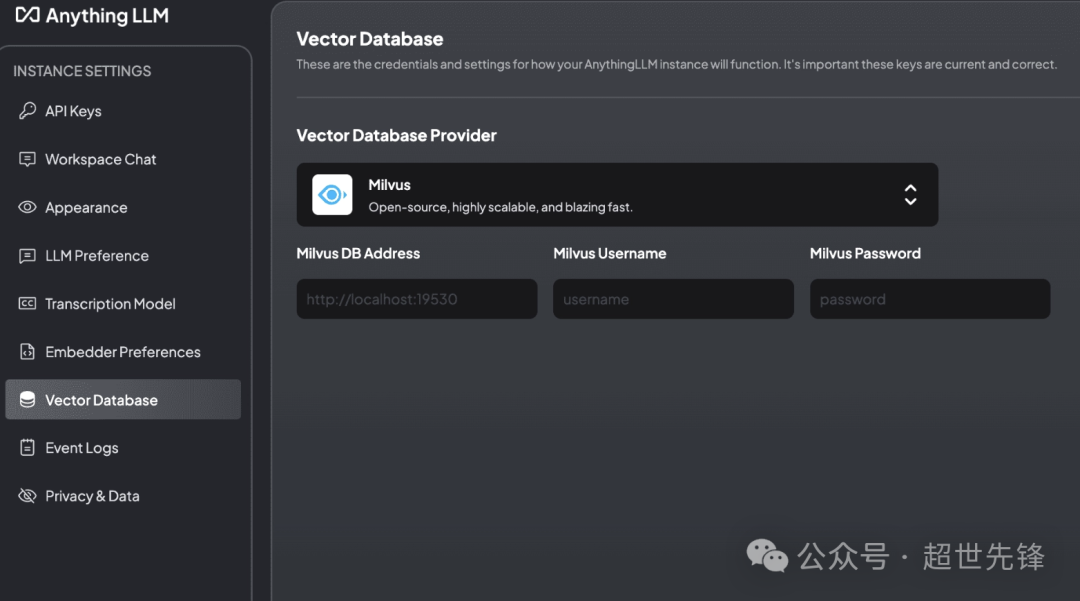
向量数据库:默认集成 LanceDB,同时支持 Pinecone、Chroma、Milvus 等,灵活适配不同规模需求。
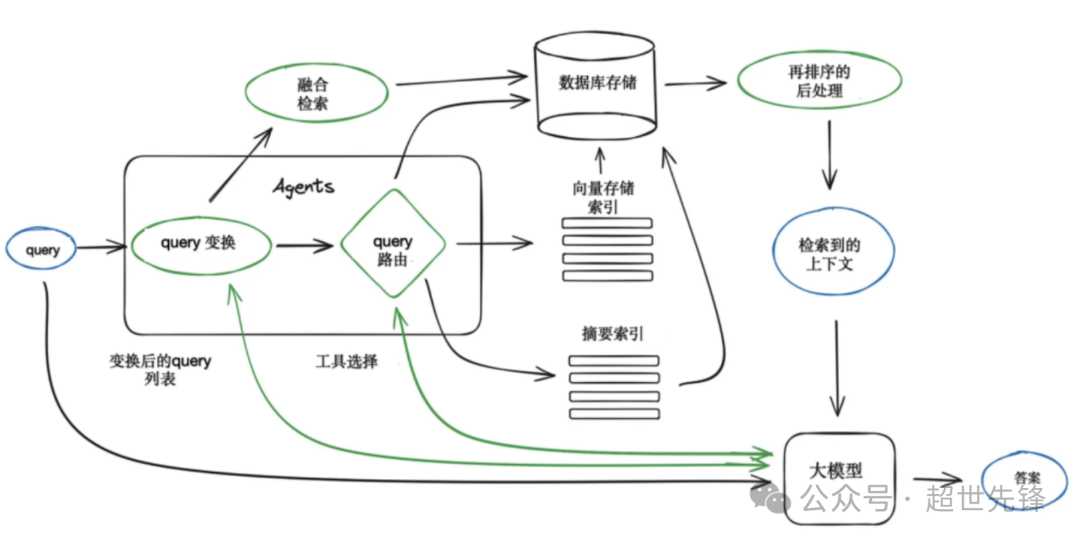
系统架构(RAG)
部署体验
# 下载镜像
docker pull mintplexlabs/anythingllm
# 启动
export STORAGE_LOCATION=$HOME/anythingllm && \
mkdir -p $STORAGE_LOCATION && \
touch "$STORAGE_LOCATION/.env" && \
docker run -d -p 3001:3001 \
--cap-add SYS_ADMIN \
-v ${STORAGE_LOCATION}:/app/server/storage \
-v ${STORAGE_LOCATION}/.env:/app/server/.env \
-e STORAGE_DIR="/app/server/storage" \
mintplexlabs/anythingllm
# 访问地址:http://localhost:3001
2,n8n AI工具包
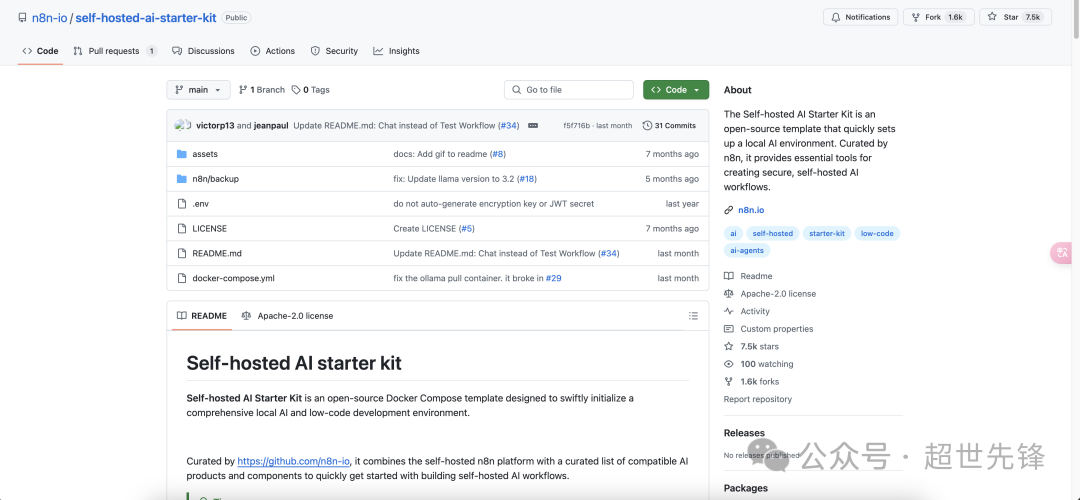
核心优势:完全本地化部署,集成Ollama和Qdrant,适配低资源环境。
适用场景:小团队或个人开发者。
推荐指数:★★★☆
开源协议:Apache-2.0 license
GitHub星数:7.5k+
开源地址:https://github.com/n8n-io/self-hosted-ai-starter-kit
项目介绍
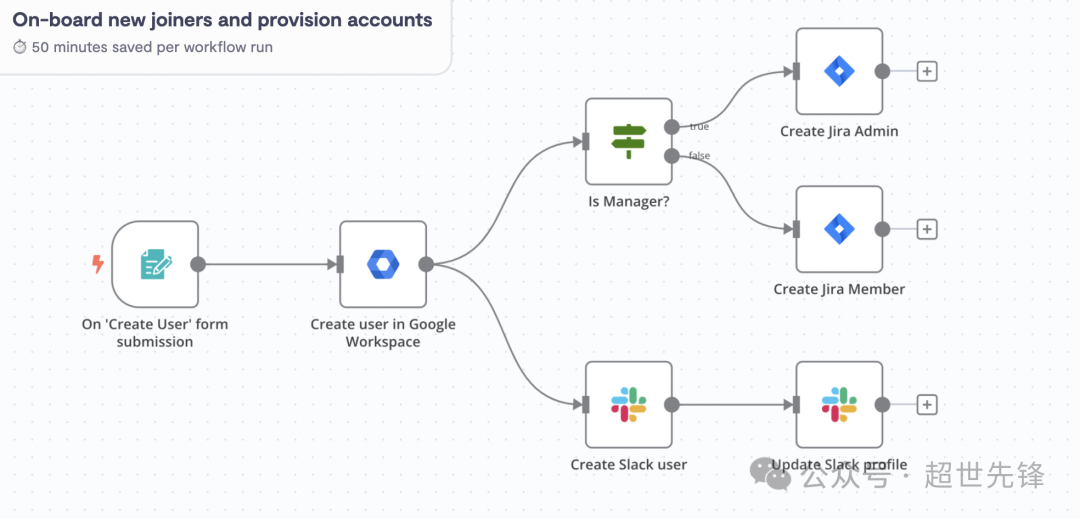
n8n推出了Self-Hosted AI Starter Kit 自托管 AI 入门工具包,帮助用户在本地或私有云环境中快速部署AI项目。此工具包利用Docker Compose模板,包含多种本地AI工具(如Ollama、Qdrant和PostgresQL),并提供AI工作流模板和网络配置,简化了本地AI工具的安装和使用。

功能特性
本地易部署:基于Docker Compose模板的解决方案,包括n8n和一系列精选的本地AI工具,快速启动自托管AI工作流,包括快速安装和设置本地AI工具,如Ollama、Qdrant和PostgresQL,直接使用配置的AI工作流模板等;通过在本地运行AI,用户可以避免外部模型API调用的不可预测费用;
AI应用构建块:n8n提供了无尽的AI可能性,从简单的QA聊天机器人到自动多步骤代理,用户可以拖放每个AI应用组件,同时保留完全的自定义控制权。
自动化、调试和维护:n8n的UI强大而不限制用户,允许在需要时回落到代码,导入cURL请求或触发webhooks和队列等。
部署体验
# 克隆仓库
git clone https://github.com/n8n-io/self-hosted-ai-starter-kit.git
cd self-hosted-ai-starter-kit
# 启动服务(Nvidia GPU)
docker compose --profile gpu-nvidia up
# AMD GPU
docker compose --profile gpu-amd up
# 访问地址:http://localhost:5678/
五、多模态与知识图谱增强:复杂语义分析
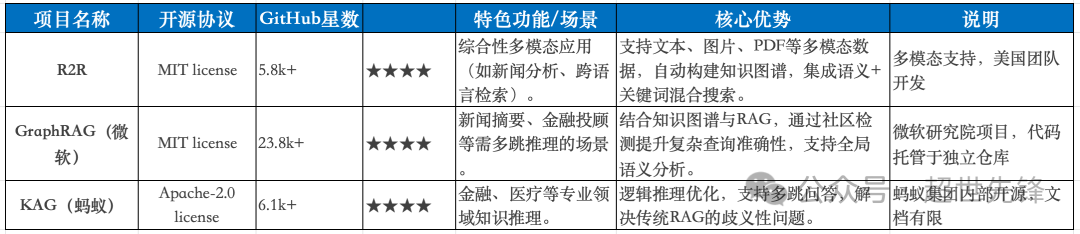
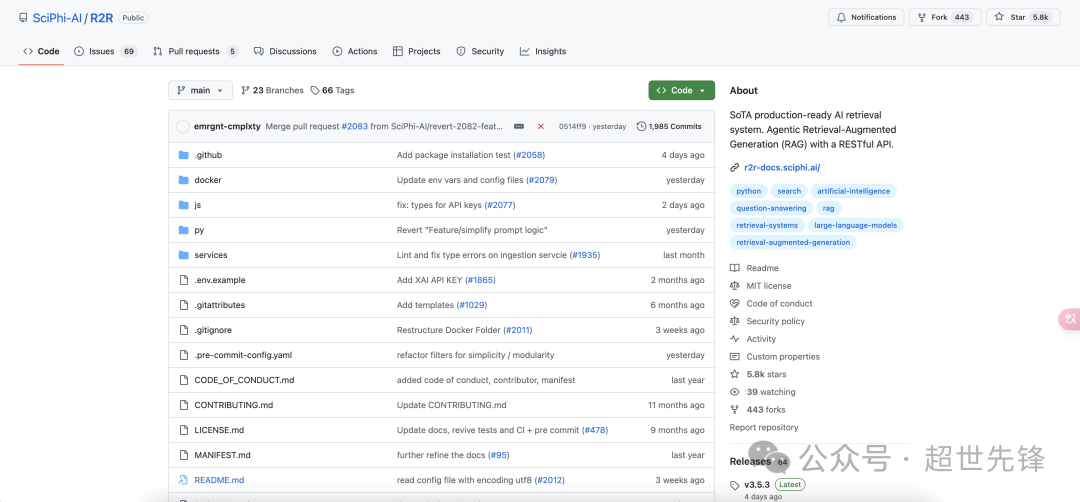
1,R2R
核心优势:支持文本、图片、PDF等多模态数据,自动构建知识图谱,集成语义+关键词混合搜索。
适用场景:综合性多模态应用(如新闻分析、跨语言检索)。
推荐指数:★★★★
开源协议:MIT license
GitHub星数:5.8k+
开源地址:https://github.com/SciPhi-AI/R2R
项目介绍
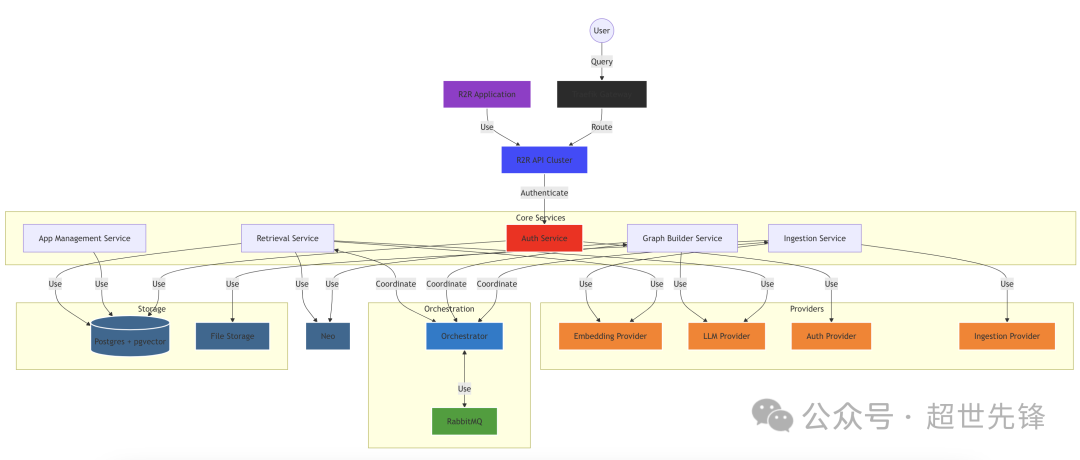
R2R (Reason to Retrieve) 是一种先进的 AI 检索系统,支持具有生产就绪功能的检索增强生成 (RAG)。R2R 围绕 RESTful API 构建,提供多模式内容摄取、混合搜索、知识图谱和全面的文档管理。
R2R 还包括一个 Deep Research API,这是一个多步骤推理系统,可从您的知识库和/或互联网获取相关数据,从而为复杂查询提供更丰富的上下文感知答案。
功能特性
前沿搜索: 高级 RAG 技术,如混合搜索、知识图谱、高级 RAG 和代理检索。
灵活性:运行时配置使调整和调整 R2R 变得容易,以满足您的需求。
扩展:处理不断增加的工作负载和大型数据集,专为性能而设计。
认证和收集:生产必备品,如用户认证和文档集合。
部署体验
# 方式一:Quick install and run in light mode
pip install r2r
export OPENAI_API_KEY=sk-...
python -m r2r.serve
# 方式二:run in full mode with Docker
git clone https://github.com/SciPhi-AI/R2R.git
cd R2R
export R2R_CONFIG_NAME=full OPENAI_API_KEY=sk-...
docker compose -f compose.full.yaml --profile postgres up -d
# 方式三:代码安装:
git clone https://github.com/SciPhi-AI/R2R.git
cd R2R/py
pip install -e .[core]
python -m r2r.serve
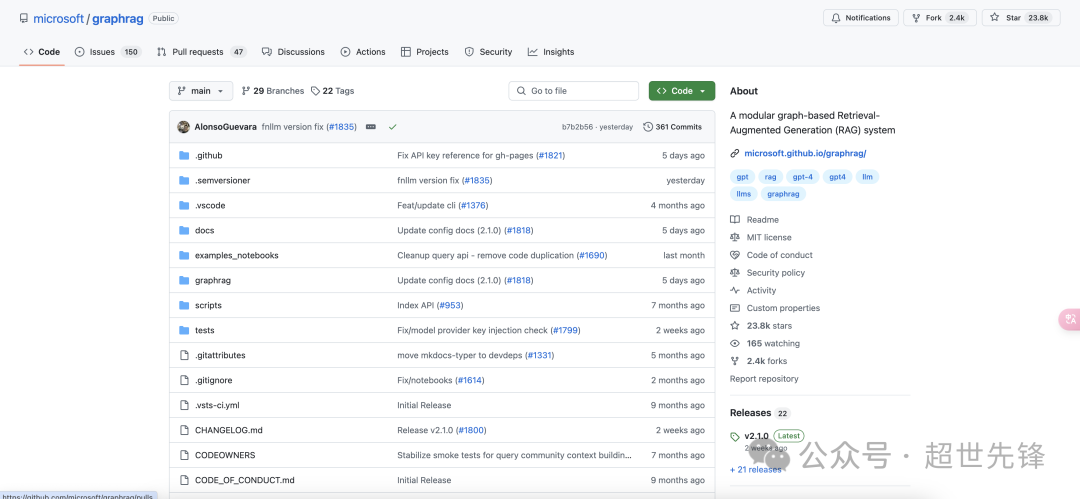
2,GraphRAG(微软)
核心优势:结合知识图谱与RAG,通过社区检测提升复杂查询准确性,支持全局语义分析。
适用场景:新闻摘要、金融投顾等需多跳推理的场景。
推荐指数:★★★★
开源协议:MIT license
GitHub星数:23.8k+
开源地址:https://github.com/microsoft/graphrag
项目介绍
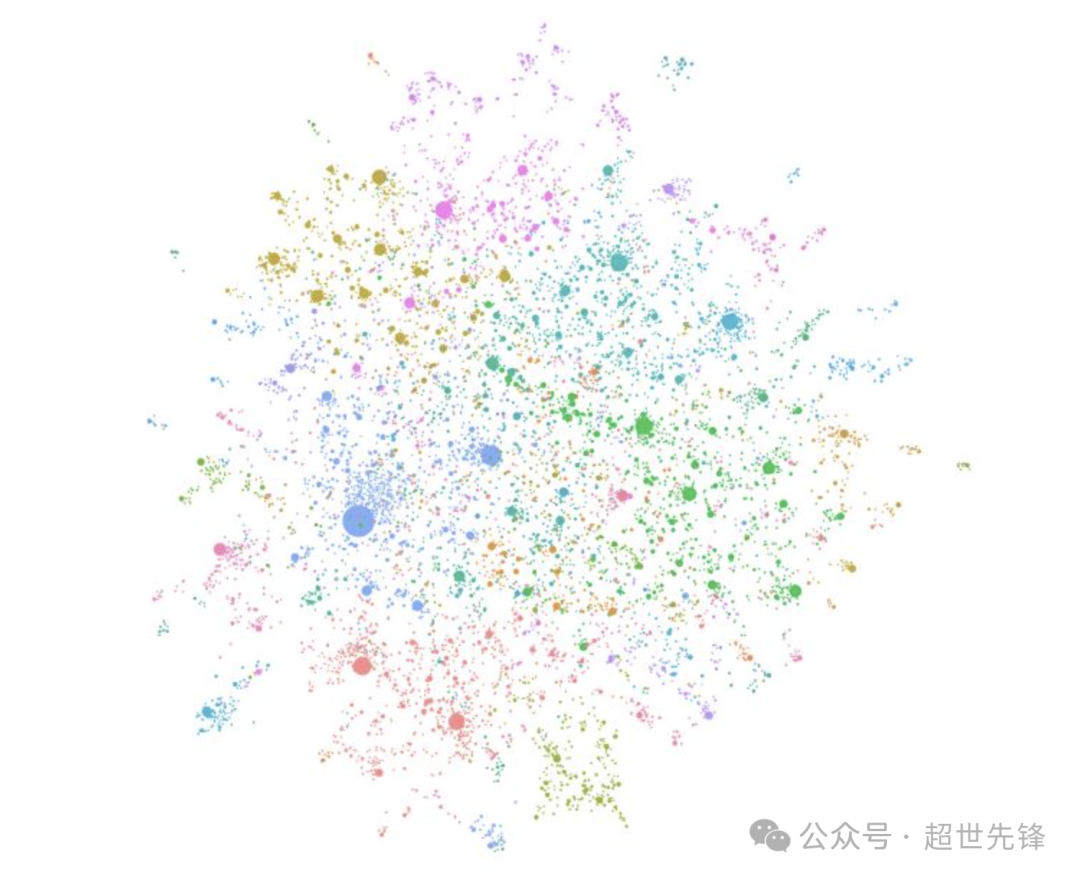
GraphRAG(Graph-based Retrieval-Augmented Generation) 是由微软提出的基于知识图谱的检索增强生成框架,通过结合图机器学习与LLM技术,解决传统RAG在复杂推理、全局语义理解上的短板。
功能特性
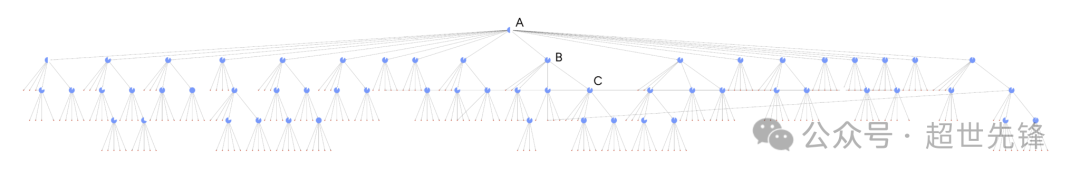
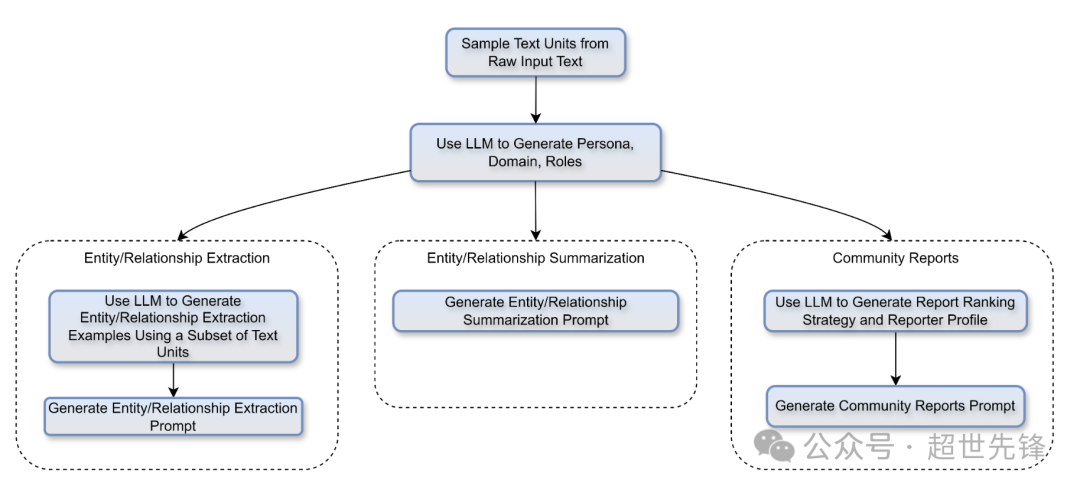
GraphRAG 是一种结构化的分层检索增强生成 (RAG) 方法,而不是使用纯文本片段的朴素语义搜索方法。GraphRAG 流程包括从原始文本中提取知识图谱、构建社区层次结构、为这些社区生成摘要,然后在执行基于 RAG 的任务时利用这些结构。
部署体验
pip install graphrag
# 准备示例数据集
mkdir -p ./ragtest/input
curl https://www.gutenberg.org/cache/epub/24022/pg24022.txt -o ./ragtest/input/book.txt
# 初始化工作区(注意.env、settings.yaml配置)
graphrag init --root ./ragtest
# 运行索引
graphrag index --root ./ragtest
# 执行查询
graphrag query \
--root ./ragtest \
--method global \
--query "What are the top themes in this story?"
3,KAG(蚂蚁)
核心优势:逻辑推理优化,支持多跳问答,解决传统RAG的歧义性问题。
适用场景:金融、医疗等专业领域知识推理。
推荐指数:★★★★
开源协议:Apache-2.0 license
GitHub星数:6.1k+
开源地址:https://github.com/OpenSPG/KAG
项目介绍
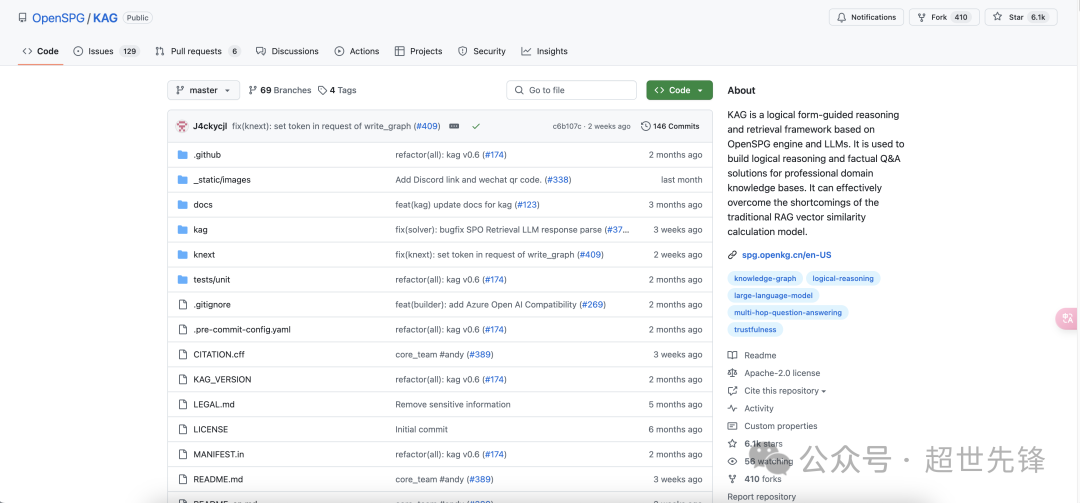
KAG 是基于 OpenSPG 引擎和大型语言模型的逻辑推理问答框架,用于构建垂直领域知识库的逻辑推理问答解决方案。KAG 可以有效克服传统 RAG 向量相似度计算的歧义性和 OpenIE 引入的 GraphRAG 的噪声问题。KAG 支持逻辑推理、多跳事实问答等,并且明显优于目前的 SOTA 方法。
功能特性
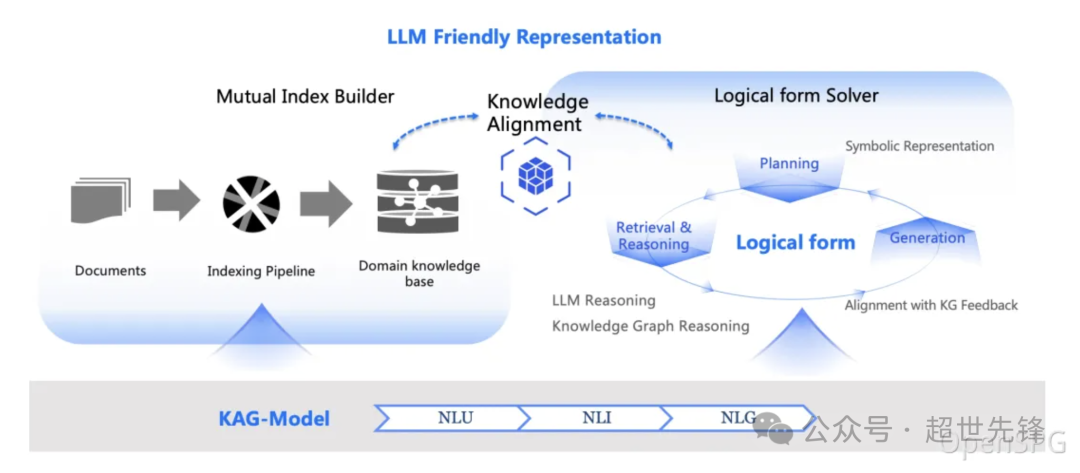
KAG 的目标是在专业领域构建知识增强的 LLM 服务框架,支持逻辑推理、事实问答等。KAG 充分融合了 KG 的逻辑性和事实性特点,其核心功能包括:
知识与 Chunk 互索引结构,以整合更丰富的上下文文本信息
利用概念语义推理进行知识对齐,缓解 OpenIE 引入的噪音问题
支持 Schema-Constraint 知识构建,支持领域专家知识的表示与构建
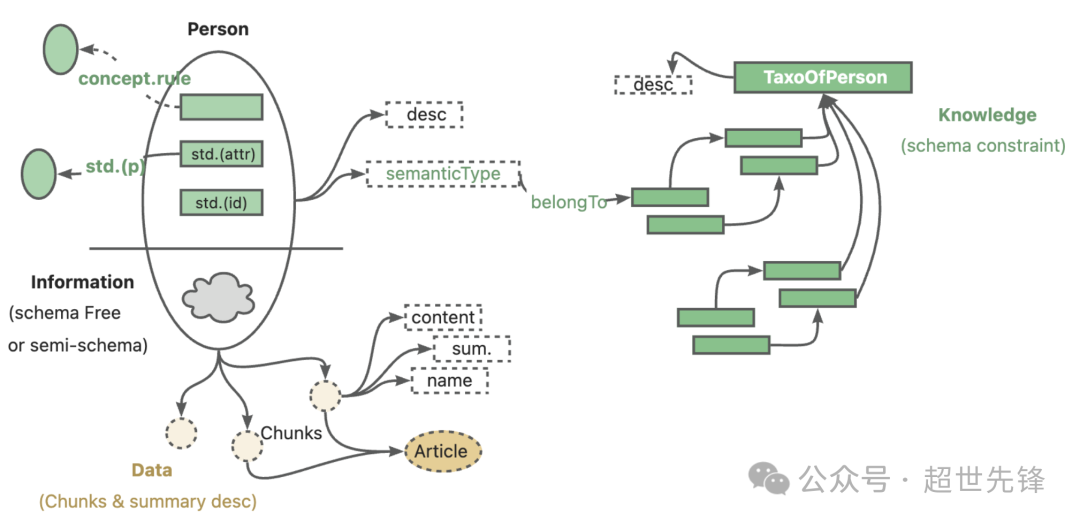
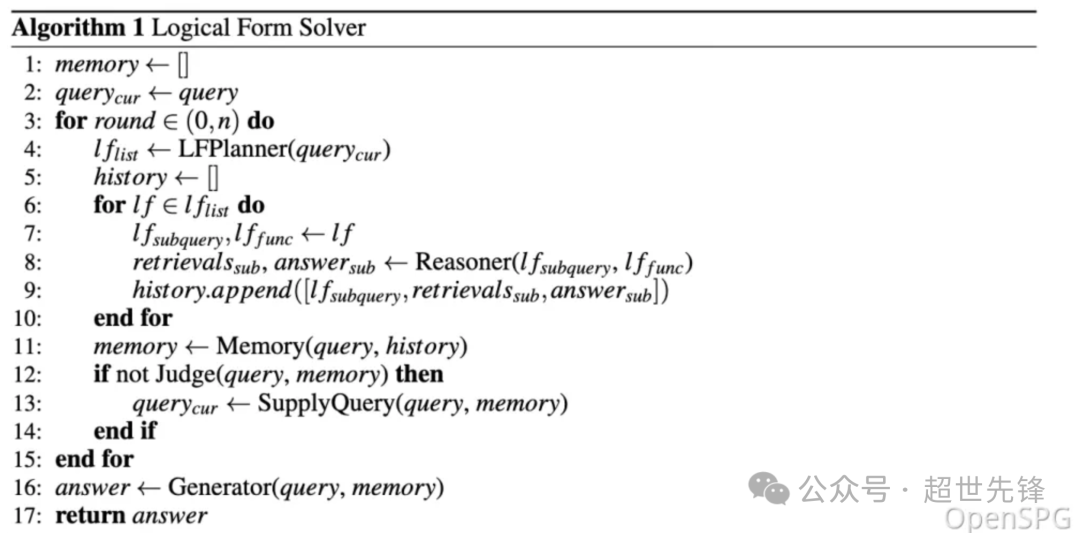
逻辑符号引导的混合推理与检索,实现逻辑推理和多跳推理问答
技术架构
部署体验
# 设置 HOME 环境变量(仅 Windows 用户需要执行)
# set HOME=%USERPROFILE%
# 下载 docker-compose.yml 并用 Docker Compose 启动服务
curl -sSL https://raw.githubusercontent.com/OpenSPG/openspg/refs/heads/master/dev/release/docker-compose.yml -o docker-compose.yml
docker compose -f docker-compose.yml up -d
# 访问地址:http://127.0.0.1:8887 。
Default Username: openspg
Default password: openspg@kag
总结:
开源RAG框架的百花齐放为不同场景提供了多样化选择。企业、团队或个人需结合 数据规模、隐私需求、开发能力 综合评估,优先选择社区活跃、功能匹配的方案。对于复杂场景,可组合使用多框架(如RagFlow + GraphRAG)以发挥协同优势。未来,随着Agent与多模态技术的融合,RAG将向更智能、更场景化的方向发展。
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇
一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书
2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
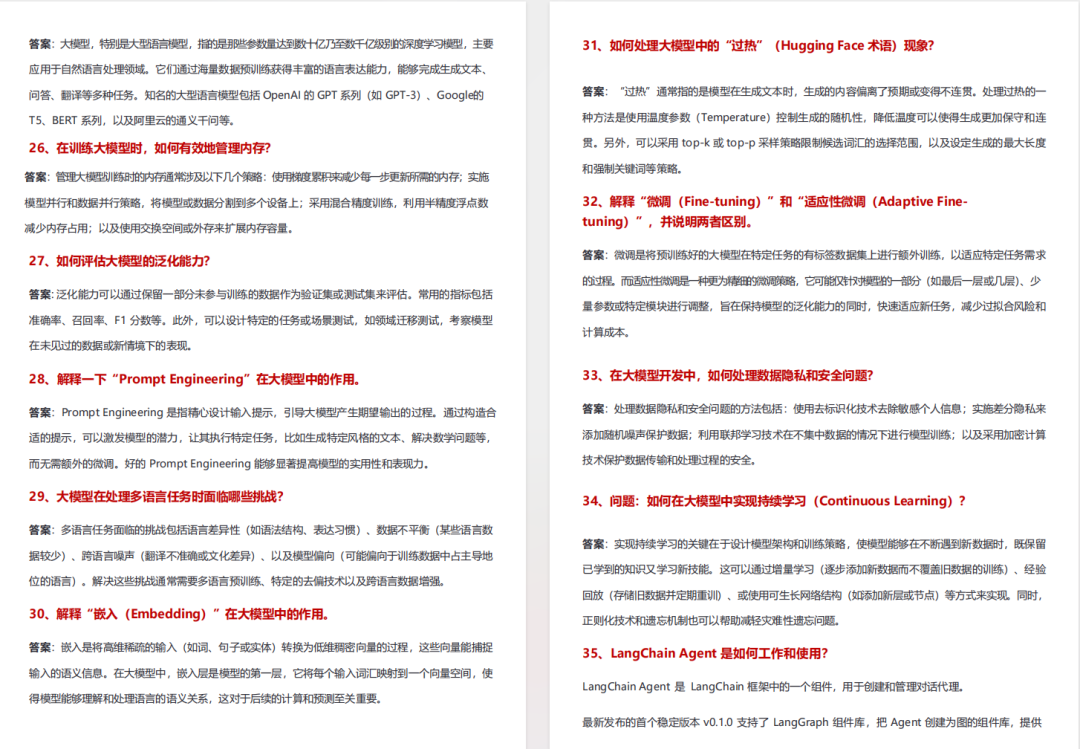
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
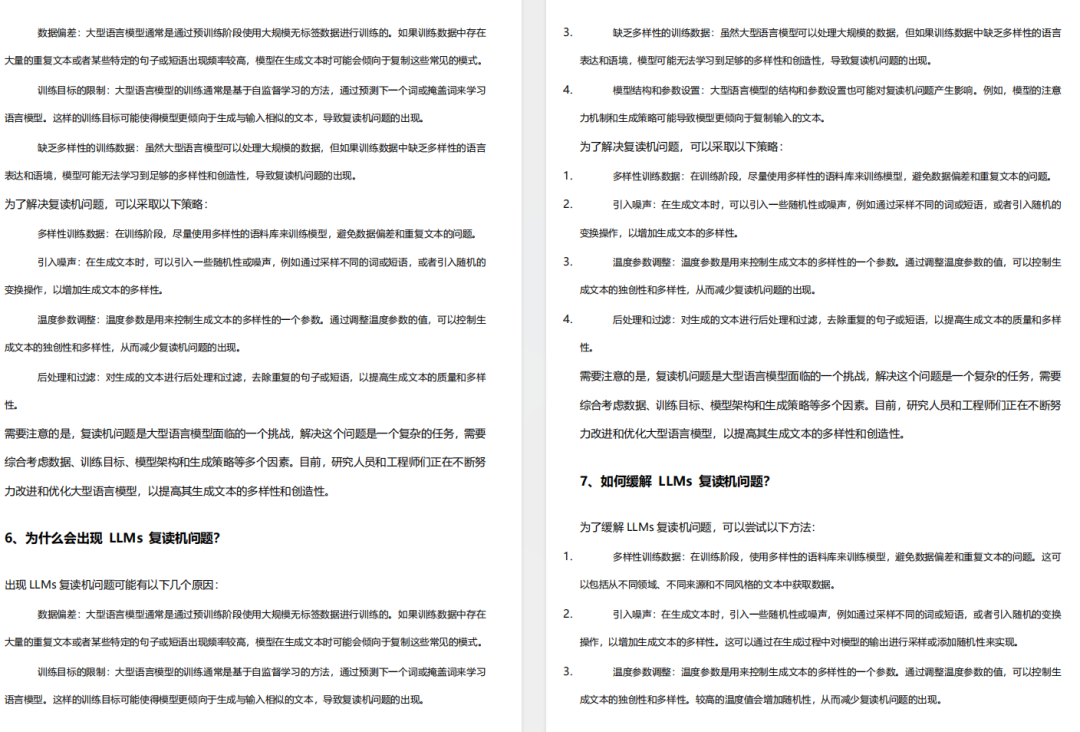
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:
三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
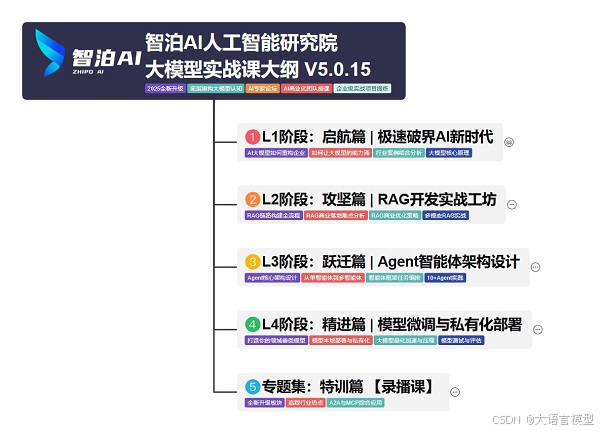
路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
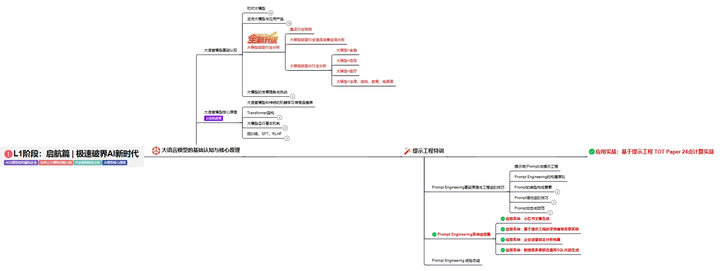
L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
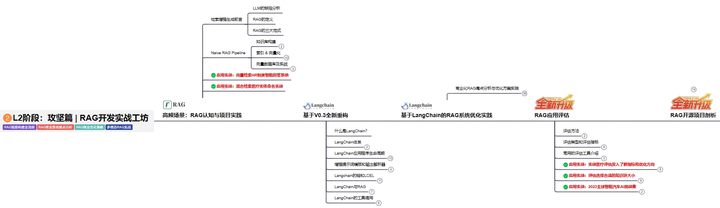
L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
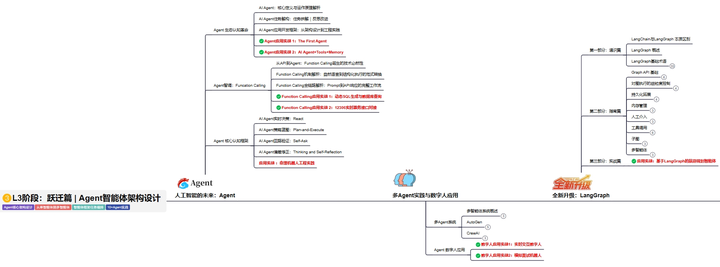
L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
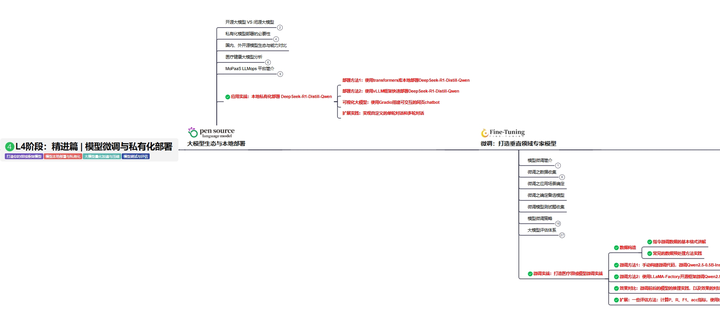
L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
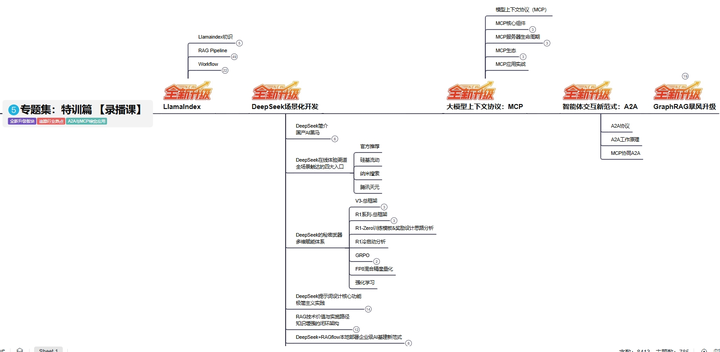
L5阶段:专题集丨特训篇 【录播课】
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 33
 0
- 0


 已为社区贡献73条内容

所有评论(0)