YOLO深入理解Bottleneck、C3、C3k、C2f 、C3k2、C3k2_SP、C2PSA 和 PSABlock模块
一、Bottleneck
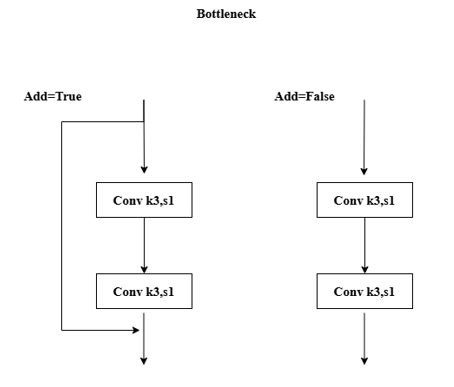
Bottleneck是最基础的模块,用于构建更复杂的 CSP 结构。它包含两个卷积层,能够有效地减少计算量并提取特征。这个模块还可以选择是否使用 shortcut 连接,以增强梯度传播。
class Bottleneck(nn.Module):
    """Standard bottleneck."""

    def __init__(self, c1, c2, shortcut=True, g=1, k=(3, 3), e=0.5):
        """Initializes a standard bottleneck module with optional shortcut connection and configurable parameters."""
        super().__init__()
        c_ = int(c2 * e)  # hidden channels
        self.cv1 = Conv(c1, c_, k[0], 1)
        self.cv2 = Conv(c_, c2, k[1], 1, g=g)
        self.add = shortcut and c1 == c2

    def forward(self, x):
        """Applies the YOLO FPN to input data."""
        return x + self.cv2(self.cv1(x)) if self.add else self.cv2(self.cv1(x))
二、C3

C3是 CSP 瓶颈模块的一个基础版本,它的目的是通过增加特征的传递路径来提升网络的表现。C3 包含三个卷积层和一系列瓶颈层,能够高效提取不同层次的特征。
class C3(nn.Module):
    def __init__(self, c1, c2, n=1, shortcut=True, g=1, e=0.5):
        super().__init__()
        c_ = int(c2 * e)  # hidden channels
        self.cv1 = Conv(c1, c_, 1, 1)  # 第一个卷积层
        self.cv2 = Conv(c1, c_, 1, 1)  # 第二个卷积层
        self.cv3 = Conv(2 * c_, c2, 1)  # 第三个卷积层,用于融合特征
        self.m = nn.Sequential(*(Bottleneck(c_, c_, shortcut, g) for _ in range(n)))  # 多个瓶颈层的组合

    def forward(self, x):
        return self.cv3(torch.cat((self.m(self.cv1(x)), self.cv2(x)), 1))  # 合并特征
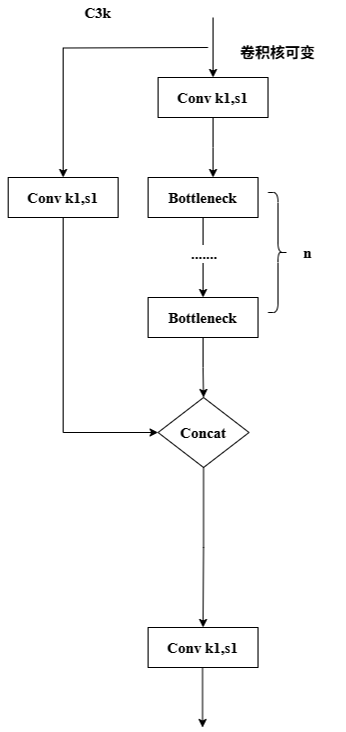
在C3 中,特征被分为两条路径,一条路径通过多层瓶颈层来提取复杂的特征,另一条路径直接传递输入特征。最后,通过拼接两条路径的输出,来增加模型的表达能力。
三、C3k
C3k(可定制卷积核):C3k是C3模块的一个变体,主要改进在于它允许自定义卷积核的大小(kernel size)。可以更好地适应不同尺寸的图像特征,尤其是当我们需要捕捉更大范围的上下文信息时。
class C3k(C3):
    def __init__(self, c1, c2, n=1, shortcut=True, g=1, e=0.5, k=3):
        super().__init__(c1, c2, n, shortcut, g, e)
        c_ = int(c2 * e)  # hidden channels
        self.m = nn.Sequential(*(Bottleneck(c_, c_, shortcut, g, k=(k, k)) for _ in range(n)))
与基础的C3不同,C3k在初始化时允许设置不同的卷积核大小k,以便更灵活地应对各种不同的特征提取需求。比如,在需要捕抓更大区域信息时,我们可以设置k值3 5 7等。当k设置为3时候,C3k在功能上与C3相等。
四、C2f
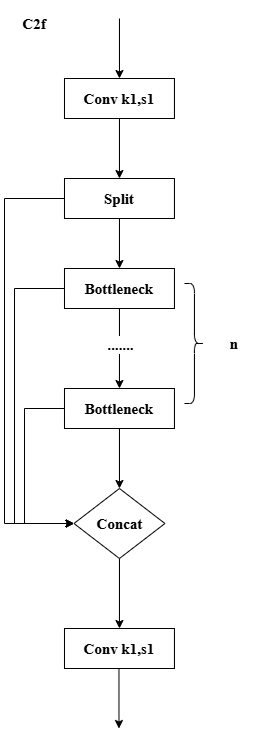
C2f 是一个为了提升处理速度而设计的 CSP 瓶颈模块。它通过减少卷积层的数量和采用更高效的特征合并策略来提高速度。
class C2f(nn.Module):
    def __init__(self, c1, c2, n=1, shortcut=False, g=1, e=0.5):
        super().__init__()
        self.c = int(c2 * e)  # hidden channels
        self.cv1 = Conv(c1, 2 * self.c, 1, 1)  # 用于分割特征
        self.cv2 = Conv((2 + n) * self.c, c2, 1)  # 最终融合层
        self.m = nn.ModuleList(Bottleneck(self.c, self.c, shortcut, g) for _ in range(n))  # 瓶颈层列表

    def forward(self, x):
        y = list(self.cv1(x).chunk(2, 1))  # 将特征分成两部分
        y.extend(m(y[-1]) for m in self.m)  # 逐步增加特征
        return self.cv2(torch.cat(y, 1))  # 最终特征融合
在C2f中,通过减少瓶颈层的数量以及对特征的快速分割和合并,达到了加速网络的目的,非常适合在对速度要求较高的应用场景中使用。
五、C3k2

C3k2结合了C2f的速度优势和C3k的灵活性。它允许在运行时选择是否使用C3k层来处理特征,提供了很高的可配置性。
class C3k2(C2f):
    def __init__(self, c1, c2, n=1, c3k=False, e=0.5, g=1, shortcut=True):
        super().__init__(c1, c2, n, shortcut, g, e)
        self.m = nn.ModuleList(
            C3k(self.c, self.c, 2, shortcut, g) if c3k else Bottleneck(self.c, self.c, shortcut, g) for _ in range(n)
        )
当c3k参数设置为True时,C3k2将使用c3k层,能够利用不同卷积核大小的灵活性;否则,它将使用标准的瓶颈层,与c2f类
似。
C3k2与c2f的不同之处在于,c3k2通过c3k参数可以选择是否使用c3k模块中的可变卷积核大小。这使得c3k2在需要更灵活的特征提取时具备优势,例如在处理需要不同感受野的场景时,可以通过调整C3k来适应特定的特征提取需求。而c2f则保持固定的结构和速度优势,更适合对计算资源有严格限制的应用场景。
六、C3k2、C3k、C3和C2f关系
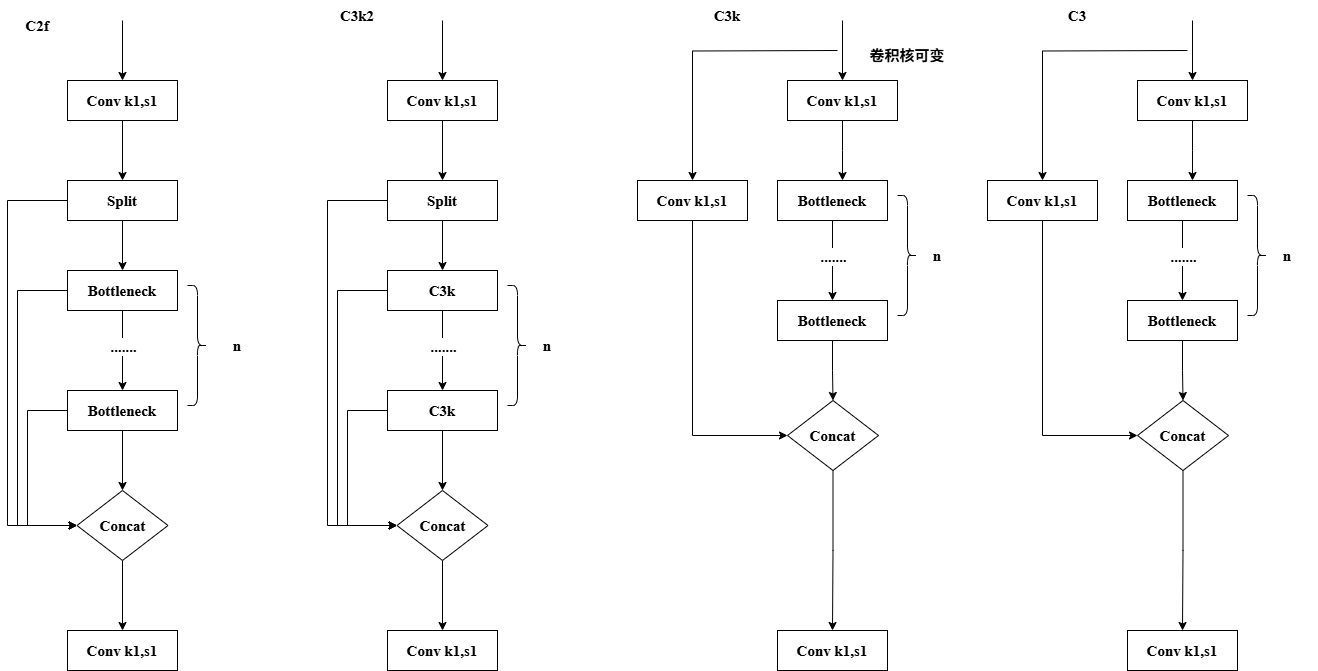
对于C3k2模块,当c3k=True和c3k=False时,其内部模块的选择会有所不同,这影响了其与c3和c3k的关系:
C3k2中c3k=True:
- 在这种情况下,
c3k2将使用c3k模块。c3k模块允许使用不同大小的卷积核,这给模型带来了灵活性,特别是在需要不同感受野来处理复杂特征的场景。 - 这样一来,
C3k2在内部使用c3k的特性,通过可配置的卷积核大小来适应不同的任务需求。
C3k2中c3k=False:
- 在这种情况下,
C3k2使用的模块与标准的c2f类似,即使用了固定的Bottleneck层。 - 在这个配置下,
c3k2在特性上与c2f没有区别,主要强调的是速度优化,而不是灵活性。
因此,C3k2在c3k=True和c3k=False时的区别在于是否使用了C3k模块的灵活卷积核。当c3k=True时,C3k2可以提供更灵活的卷积核大小,因此它与c3、c3k有区别。而当c3k=False时,C3k2与C2f一致,关注的是加速特性。
总结来说,C3k2在c3k=True时与C3k类似,强调灵活性,而在c3k=False时与c2f一致,强调速度和效率。这样,C3k2既可以作为灵活的特征提取模块,也可以作为快速的特征融合模块,具体使用哪个取决于您的任务需求。
c3k2与c2f的不同之处在于,C3k2通过c3k参数可以选择是否使用c3k模块中的可变卷积核大小。这使得c3k2在需要更灵活的特征提取时具备优势,例如在处理需要不同感受野的场景时,可以通过调整C3k来适应特定的特征提取需求。而c2f则保持固定的结构和速度优势,更适合对计算资源有严格限制的应用场景。
通常在提取特征时候采用C3k提取,特征融合时换回普通的Bottleneck(即C2f)快速的特征融合
七、C3k2_SP
class C2f(nn.Module):

    def __init__(self, c1: int, c2: int, n: int = 1, shortcut: bool = False, g: int = 1, e: float = 0.5):
        super().__init__()
        self.c = int(c2 * e)  # hidden channels
        self.cv1 = Conv(c1, 2 * self.c, 1, 1)
        self.cv2 = Conv((2 + n) * self.c, c2, 1)  # optional act=FReLU(c2)
        self.m = nn.ModuleList(Bottleneck(self.c, self.c, shortcut, g, k=((3, 3), (3, 3)), e=1.0) for _ in range(n))

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        """Forward pass through C2f layer."""
        y = list(self.cv1(x).chunk(2, 1))
        y.extend(m(y[-1]) for m in self.m)
        return self.cv2(torch.cat(y, 1))

    def forward_split(self, x: torch.Tensor) -> torch.Tensor:
        """Forward pass using split() instead of chunk()."""
        y = self.cv1(x).split((self.c, self.c), 1)
        y = [y[0], y[1]]
        y.extend(m(y[-1]) for m in self.m)
        return self.cv2(torch.cat(y, 1))

# 在c3k=True时,使用Bottleneck_SP特征融合,为false的时候我们使用普通的Bottleneck提取特征
class C3k2_SP(C2f):
    def __init__(self, c1, c2, n=1, c3k=False, e=0.5, g=1, shortcut=True):
        super().__init__(c1, c2, n, shortcut, g, e)
        self.m = nn.ModuleList( C3k_SP(self.c, self.c, 2, shortcut, g) if c3k else Bottleneck(self.c, self.c, shortcut, g) for _ in range(n) )


class C3k_SP(C3):
    def __init__(self, c1, c2, n=1, shortcut=True, g=1, e=0.5, k=3):
        super().__init__(c1, c2, n, shortcut, g, e)
        c_ = int(c2 * e)  # hidden channels
        self.m = nn.Sequential(*(Bottleneck_SP(c_, c_, shortcut, g, k=(k, k), e=1.0) for _ in range(n)))


class Bottleneck_SP(nn.Module):
    def __init__(self, c1, c2, shortcut=True, g=1, k=(3, 3), e=0.5):
        super().__init__()
        c_ = int(c2 * e)  # hidden channels
        self.cv1 = Conv(c1, c_, k[0], 1)
        self.cv2 = StripPooling(c_, (20, 12), nn.BatchNorm2d, {'mode': 'bilinear', 'align_corners': True})
        self.add = shortcut and c1 == c2

    def forward(self, x):
        return x + self.cv2(self.cv1(x)) if self.add else self.cv2(self.cv1(x))

class C3(nn.Module):
    def __init__(self, c1: int, c2: int, n: int = 1, shortcut: bool = True, g: int = 1, e: float = 0.5):
        super().__init__()
        c_ = int(c2 * e)  # hidden channels
        self.cv1 = Conv(c1, c_, 1, 1)
        self.cv2 = Conv(c1, c_, 1, 1)
        self.cv3 = Conv(2 * c_, c2, 1)  # optional act=FReLU(c2)
        self.m = nn.Sequential(*(Bottleneck(c_, c_, shortcut, g, k=((1, 1), (3, 3)), e=1.0) for _ in range(n)))

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.cv3(torch.cat((self.m(self.cv1(x)), self.cv2(x)), 1))


class Bottleneck(nn.Module):
    def __init__(
        self, c1: int, c2: int, shortcut: bool = True, g: int = 1, k: Tuple[int, int] = (3, 3), e: float = 0.5
    ):
        super().__init__()
        c_ = int(c2 * e)  # hidden channels
        self.cv1 = Conv(c1, c_, k[0], 1)
        self.cv2 = Conv(c_, c2, k[1], 1, g=g)
        self.add = shortcut and c1 == c2

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return x + self.cv2(self.cv1(x)) if self.add else self.cv2(self.cv1(x))


class StripPooling(nn.Module):
    """
    Reference:(20, 12), nn.BatchNorm2d, {'mode': 'bilinear', 'align_corners': True}
    """
    def __init__(self, in_channels, pool_size= (20, 12), norm_layer=nn.BatchNorm2d, up_kwargs={'mode': 'bilinear', 'align_corners': True}):
        super(StripPooling, self).__init__()
        self.pool1 = nn.AdaptiveAvgPool2d(pool_size[0])
        self.pool2 = nn.AdaptiveAvgPool2d(pool_size[1])
        self.pool3 = nn.AdaptiveAvgPool2d((1, None))
        self.pool4 = nn.AdaptiveAvgPool2d((None, 1))

        inter_channels = int(in_channels/4)
        self.conv1_1 = nn.Sequential(nn.Conv2d(in_channels, inter_channels, 1, bias=False),
                                norm_layer(inter_channels),
                                nn.ReLU(True))
        self.conv1_2 = nn.Sequential(nn.Conv2d(in_channels, inter_channels, 1, bias=False),
                                norm_layer(inter_channels),
                                nn.ReLU(True))
        self.conv2_0 = nn.Sequential(nn.Conv2d(inter_channels, inter_channels, 3, 1, 1, bias=False),
                                norm_layer(inter_channels))
        self.conv2_1 = nn.Sequential(nn.Conv2d(inter_channels, inter_channels, 3, 1, 1, bias=False),
                                norm_layer(inter_channels))
        self.conv2_2 = nn.Sequential(nn.Conv2d(inter_channels, inter_channels, 3, 1, 1, bias=False),
                                norm_layer(inter_channels))
        self.conv2_3 = nn.Sequential(nn.Conv2d(inter_channels, inter_channels, (1, 3), 1, (0, 1), bias=False),
                                norm_layer(inter_channels))
        self.conv2_4 = nn.Sequential(nn.Conv2d(inter_channels, inter_channels, (3, 1), 1, (1, 0), bias=False),
                                norm_layer(inter_channels))
        self.conv2_5 = nn.Sequential(nn.Conv2d(inter_channels, inter_channels, 3, 1, 1, bias=False),
                                norm_layer(inter_channels),
                                nn.ReLU(True))
        self.conv2_6 = nn.Sequential(nn.Conv2d(inter_channels, inter_channels, 3, 1, 1, bias=False),
                                norm_layer(inter_channels),
                                nn.ReLU(True))
        self.conv3 = nn.Sequential(nn.Conv2d(inter_channels*2, in_channels, 1, bias=False),
                                norm_layer(in_channels))
        # bilinear interpolate options
        self._up_kwargs = up_kwargs

    def forward(self, x):
        _, _, h, w = x.size()
        x1 = self.conv1_1(x)
        x2 = self.conv1_2(x)
        x2_1 = self.conv2_0(x1)
        x2_2 = F.interpolate(self.conv2_1(self.pool1(x1)), (h, w), **self._up_kwargs)
        x2_3 = F.interpolate(self.conv2_2(self.pool2(x1)), (h, w), **self._up_kwargs)
        x2_4 = F.interpolate(self.conv2_3(self.pool3(x2)), (h, w), **self._up_kwargs)
        x2_5 = F.interpolate(self.conv2_4(self.pool4(x2)), (h, w), **self._up_kwargs)
        x1 = self.conv2_5(F.relu_(x2_1 + x2_2 + x2_3))
        x2 = self.conv2_6(F.relu_(x2_5 + x2_4))
        out = self.conv3(torch.cat([x1, x2], dim=1))
        return F.relu_(x + out)

StripPooling结构图

八、C2PSA 和 PSABlock
C2PSA 模块是 YOLO11 中用于增强特征提取的一个高级模块,结合了 CSP (Cross Stage Partial) 结构和 PSA (Pyramid Squeeze Attention) 注意力机制,从而提升了多尺度特征提取能力。它主要用于复杂场景下的目标检测,特别是在处理多尺度物体时表现出色。
模块结构特点
- **CSP 结构:**C2PSA 模块继承了 CSP 的分段特征处理思想,特征经过一次 1x1 卷积后被分成两部分,一部分直接传递,另一部分经过 PSA 注意力模块处理,然后将两部分特征拼接,并经过另一个 1x1 卷积来恢复原始通道数。
- **PSA(Pyramid Squeeze Attention)机制:**PSA 机制通过多种卷积核(如 3x3、5x5、7x7 等)来提取多尺度特征。不同卷积核的卷积操作并行进行,之后将特征图拼接,并使用 SE (Squeeze-and-Excitation) 模块为特征通道加权。最后,通过 Softmax 生成的注意力权重应用到各个特征图上,从而实现通道逐点加权 (Channel-wise multiplication),提升对重要特征的关注度。
class C2PSA(nn.Module):
    def __init__(self, c1: int, c2: int, n: int = 1, e: float = 0.5):
        super().__init__()
        assert c1 == c2
        self.c = int(c1 * e)
        self.cv1 = Conv(c1, 2 * self.c, 1, 1)
        self.cv2 = Conv(2 * self.c, c1, 1)

        self.m = nn.Sequential(*(PSABlock(self.c, attn_ratio=0.5, num_heads=self.c // 64) for _ in range(n)))

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        a, b = self.cv1(x).split((self.c, self.c), dim=1)
        b = self.m(b)
        return self.cv2(torch.cat((a, b), 1))

class PSABlock(nn.Module):
    def __init__(self, c: int, attn_ratio: float = 0.5, num_heads: int = 4, shortcut: bool = True) -> None:
        super().__init__()

        self.attn = Attention(c, attn_ratio=attn_ratio, num_heads=num_heads)
        self.ffn = nn.Sequential(Conv(c, c * 2, 1), Conv(c * 2, c, 1, act=False))
        self.add = shortcut

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = x + self.attn(x) if self.add else self.attn(x)
        x = x + self.ffn(x) if self.add else self.ffn(x)
        return x


class Attention(nn.Module):
    def __init__(self, dim: int, num_heads: int = 8, attn_ratio: float = 0.5):
        super().__init__()
        self.num_heads = num_heads
        self.head_dim = dim // num_heads
        self.key_dim = int(self.head_dim * attn_ratio)
        self.scale = self.key_dim**-0.5
        nh_kd = self.key_dim * num_heads
        h = dim + nh_kd * 2
        self.qkv = Conv(dim, h, 1, act=False)
        self.proj = Conv(dim, dim, 1, act=False)
        self.pe = Conv(dim, dim, 3, 1, g=dim, act=False)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        B, C, H, W = x.shape
        N = H * W
        qkv = self.qkv(x)
        q, k, v = qkv.view(B, self.num_heads, self.key_dim * 2 + self.head_dim, N).split(
            [self.key_dim, self.key_dim, self.head_dim], dim=2
        )

        attn = (q.transpose(-2, -1) @ k) * self.scale
        attn = attn.softmax(dim=-1)
        x = (v @ attn.transpose(-2, -1)).view(B, C, H, W) + self.pe(v.reshape(B, C, H, W))
        x = self.proj(x)
        return x
C2PSA 和 PSABlock结构图

九、总结
-
Bottleneck是最基础的模块,用于特征提取和减少计算量。 -
C3是基础模块,包含三层卷积和多层瓶颈层,用于增强特征传递。 -
C3k在C3的基础上增加了卷积核大小的可配置性,使其更适合不同的特征提取需求。 -
C2f通过简化结构来加速处理,适合对计算速度有较高要求的场景。 -
C3k2结合了C3k和C2f的优势,提供了更高的灵活性和速度。
在某些特定情况下,这些模块是等价的:
- 当
C3k的卷积核大小k设置为3时,它在功能上与C3相等。此时,C3k提供了与C3相同的特征提取能力,但增加了卷积核大小的可配置性。 - 当
C3k2的C3k参数设置为False时,C3k2的功能与C2f相同。它在这种情况下只是在结构上提供了额外的灵活性,但并没有使用C3k层的优势。
这些模块的设计思路各有侧重,使用时可以根据具体任务的需求来选择合适的变种。例如,在需要快速处理和灵活特征提取的情况下,可以选择C3k2模块;而在需要保持基础结构的情况下,C3则是不错的选择。没有绝对的好与不好,只有适合还是不适合。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐
 58
 0
- 0


 已为社区贡献6条内容

所有评论(0)