第三章 感知机
第三章 感知机
1. 模型介绍和学习策略
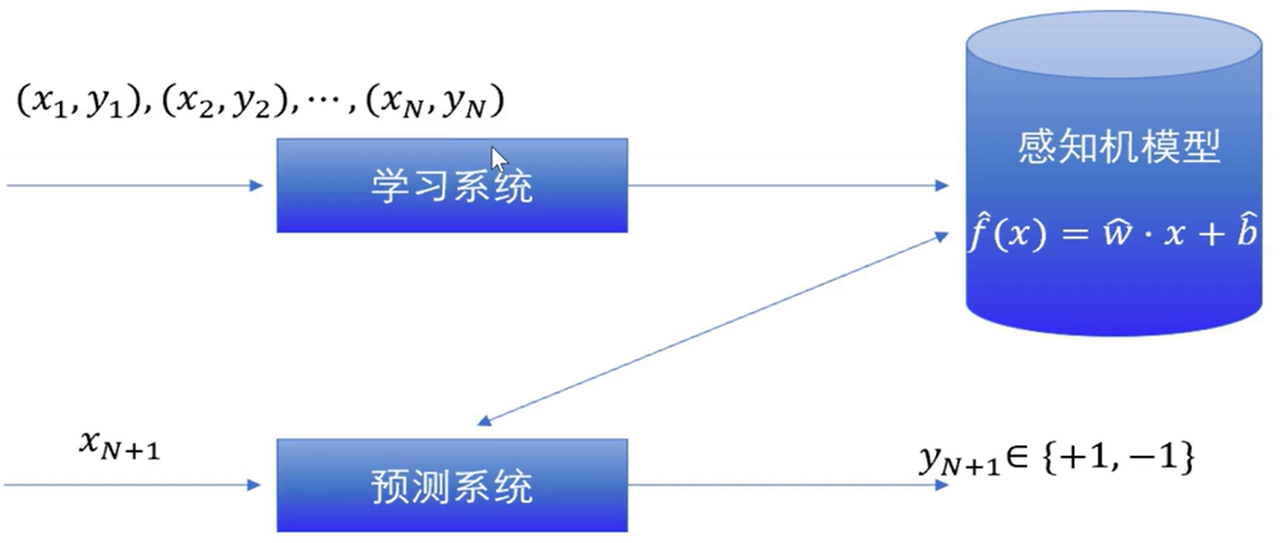
感知机(perceptron)是二类分类的线性分类模型,其输入为实例的特征向量,输出为实例的类别,取+1和−1二值。感知机对应于输入空间(特征空间)中将实例划分为正负两类的分离超平面,属于判别模型。
1.1 模型介绍
-
输入空间:X⊆Rn\mathcal{X}\subseteq R^nX⊆Rn; 输入: x=(x(1),x(2),...,x(n))T∈Xx=(x^{(1)},x^{(2)},...,x^{(n)})^T \in \mathcal{X}x=(x(1),x(2),...,x(n))T∈X
-
输出空间:Y={+1,−1}\mathcal{Y}=\{+1,-1\}Y={+1,−1}; 输出:y∈Yy \in \mathcal{Y}y∈Y
-
感知机:f(x)=sign(wx+b)={+1,wx+b≥0−1,wx+b<0f(x)=sign(wx+b) = \begin{cases} +1, wx+b \geq 0 \\ -1, wx+b \lt 0 \end{cases} f(x)=sign(wx+b)={+1,wx+b≥0−1,wx+b<0
其中,w=(w(1),w(2),...,w(n))T∈Rnw=(w^{(1)},w^{(2)},...,w^{(n)})^T \in R^nw=(w(1),w(2),...,w(n))T∈Rn称为权值(Weight),b∈Rb \in Rb∈R称为偏置(Bias),wxwxwx表示内积
wx=w(1)x(1)+w(2)x(2)+...+w(n)x(n)wx=w^{(1)}x^{(1)}+w^{(2)}x^{(2)}+...+w^{(n)}x^{(n)}wx=w(1)x(1)+w(2)x(2)+...+w(n)x(n) -
假设空间:F={f∣f(x)=wx+b}\mathcal{F}=\{f|f(x)=wx+b\}F={f∣f(x)=wx+b}
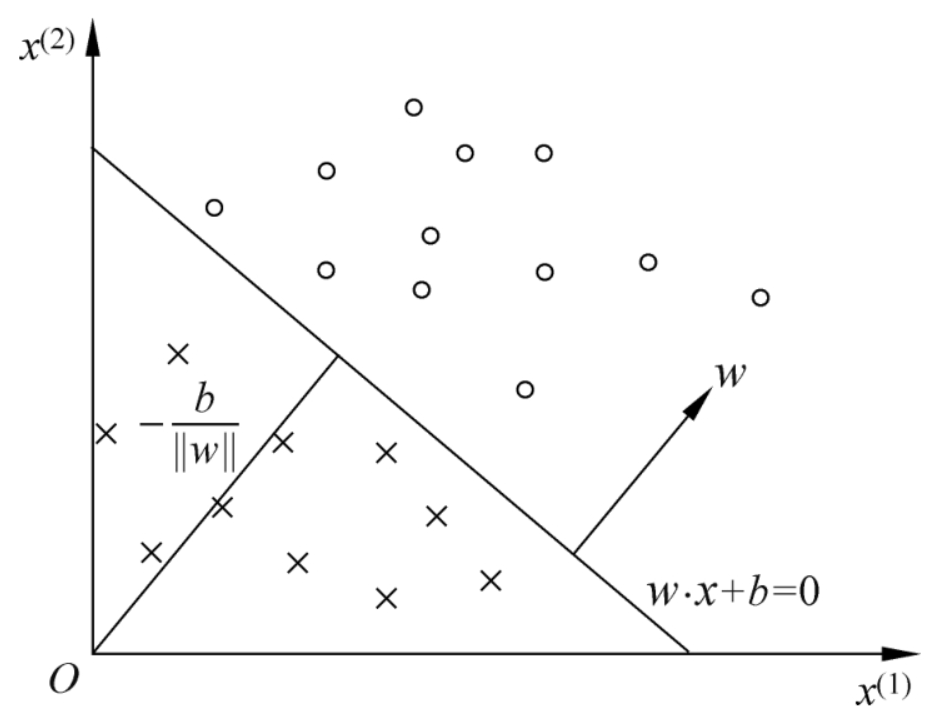
线性方程:wx+b=0wx+b=0wx+b=0
-
特征空间RnR^nRn中的一个超平面SSS。超平面就是比环境空间RnR^nRn少一维的子空间
-
法向量:www 垂直于超平面; 截距:bbb
-
−b∣∣w∣∣-\frac{b}{||w||}−∣∣w∣∣b表示原点到超平面之间的距离
感知机模型的流程图:
1.2 学习策略
1.2.1 条件
数据集的线性可分性
给定数据集:T={(x1,y1),(x2,y2),...,(xN,yN)}T=\{(x_1,y_1),(x_2,y_2),...,(x_N,y_N)\}T={(x1,y1),(x2,y2),...,(xN,yN)}
若存在某个超平面SSS : wx+b=0wx+b=0wx+b=0
能够将数据集的正负实例点完全正确的划分到超平面两侧,即
{yi=+1,wxi+b>0yi=−1,wxi+b<0\begin{cases} y_i=+1,wx_i+b>0 \\ y_i=-1,wx_i+b<0 \end{cases}{yi=+1,wxi+b>0yi=−1,wxi+b<0
那么,称TTT为线性可分数据集,否则为线性不可分
1.2.2 感知机学习策略
-
∀x0∈Rn\forall x_0 \in R^n∀x0∈Rn 到超平面SSS的距离:∣wx0+b∣∣∣w∣∣\frac{|wx_0+b|}{||w||}∣∣w∣∣∣wx0+b∣ ; 这可以由点到直线的距离公式得出,∣∣w∣∣||w||∣∣w∣∣为L2L_2L2范数
-
若x0x_0x0是正确分类点,则
∣wx0+b∣∣∣w∣∣={wx0+b∣∣w∣∣,y0=+1−wx0+b∣∣w∣∣,y0=−1\dfrac{|wx_0+b|}{||w||}= \begin{cases} \dfrac{wx_0+b}{||w||},y_0=+1 \\ -\dfrac{wx_0+b}{||w||},y_0=-1 \end{cases}∣∣w∣∣∣wx0+b∣=⎩⎨⎧∣∣w∣∣wx0+b,y0=+1−∣∣w∣∣wx0+b,y0=−1 -
若x0x_0x0是错误分类点,则
∣wx0+b∣∣∣w∣∣={−wx0+b∣∣w∣∣,y0=+1wx0+b∣∣w∣∣,y0=−1=−y0(wx0+b)∣∣w∣∣\dfrac{|wx_0+b|}{||w||}= \begin{cases} -\dfrac{wx_0+b}{||w||},y_0=+1\\ \dfrac{wx_0+b}{||w||},y_0=-1 \end{cases} =\dfrac{-y_0(wx_0+b)}{||w||}∣∣w∣∣∣wx0+b∣=⎩⎨⎧−∣∣w∣∣wx0+b,y0=+1∣∣w∣∣wx0+b,y0=−1=∣∣w∣∣−y0(wx0+b) -
误分类点xix_ixi到SSS的距离:−yi(wxi+b)∣∣w∣∣-\dfrac{y_i(wx_i+b)}{||w||}−∣∣w∣∣yi(wxi+b)
-
所有误分类点到SSS的距离:−∑xi∈Myi(wxi+b)∣∣w∣∣-\dfrac{\sum\limits_{x_i \in M}y_i(wx_i+b)}{||w||}−∣∣w∣∣xi∈M∑yi(wxi+b) ,其中MMM代表所有误分类点的集合
-
由于距离大于等于0,因此误分类点:−yi(wxi+b)≥0-y_i(wx_i+b) \geq0−yi(wxi+b)≥0,即yi(wxi+b)≤0y_i(wx_i+b) \leq 0yi(wxi+b)≤0表示样本被误分类
-
损失函数:L(w,b)=−∑xi∈Myi(wxi+b)L(w,b)=-\sum_{x_i\in M}y_i(wx_i+b)L(w,b)=−∑xi∈Myi(wxi+b)
2. 学习算法
2.1 原始形式
2.1.1 算法
-
损失函数: L(w,b)=−∑xi∈Myi(wxi+b)L(w,b)=-\sum_{x_i\in M}y_i(wx_i+b)L(w,b)=−∑xi∈Myi(wxi+b)
-
梯度:ΔwL(w,b)=−∑xi∈Myixi\begin{aligned} \Delta_wL(w,b)=-\sum_{x_i \in M}y_ix_i \end{aligned}ΔwL(w,b)=−xi∈M∑yixi ; ΔbL(w,b)=−∑xi∈Myi\Delta_bL(w,b)=-\sum_{x_i \in M} y_iΔbL(w,b)=−∑xi∈Myi
-
参数更新:
-
批量梯度下降法(Batch Gradient Descent):每次迭代时使用所有误分类点来进行参数更新:
w←w+η∑xi∈Myixiw \leftarrow w + \eta \sum_{x_i \in M}y_ix_iw←w+η∑xi∈Myixi; b←b+η∑xi∈Myib \leftarrow b +\eta \sum_{x_i \in M}y_ib←b+η∑xi∈Myi
其中,η(0≤η≤1)\eta(0\leq\eta\leq1)η(0≤η≤1)代表步长 -
随机梯度下降法(Stochastic Gradient Descent):每次随机选取一个误分类点进行参数更新:
w←w+ηyixiw \leftarrow w+\eta y_ix_iw←w+ηyixi ; b←b+ηyib \leftarrow b +\eta y_ib←b+ηyi -
小批量梯度下降法(Mini-batch Gradient Descent):每次迭代时从误分类点中随机选取一个小批量Mk(1<k<∣M∣)M_k(1<k<|M|)Mk(1<k<∣M∣),基于这个小批量中的样本计算梯度进行参数更新:
w←w+η∑xi∈Mkyixiw \leftarrow w + \eta\sum_{x_i \in M_k}y_ix_iw←w+η∑xi∈Mkyixi; b←b+η∑xi∈Mkyib \leftarrow b +\eta \sum_{x_i \in M_k}y_ib←b+η∑xi∈Mkyi -
MGD比BGD更高效,不需要扫描全部误分类点;
比SGD更稳定,梯度估计的方差较小,收敛过程更平滑
-
训练具体步骤:
-
输入:训练集T={(x1,y1),(x2,y2),...,(xN,yN)}T=\{(x_1,y_1),(x_2,y_2),...,(x_N,y_N)\}T={(x1,y1),(x2,y2),...,(xN,yN)}
其中,xi∈X⊆Rn,y∈Y={+1,−1}x_i \in \mathcal{X} \subseteq \R^n,y \in \mathcal{Y}=\{+1,-1\}xi∈X⊆Rn,y∈Y={+1,−1};步长η(0<η<1)\eta(0<\eta<1)η(0<η<1) -
输出:w,bw,bw,b; 感知机模型f(x)=sign(w⋅x+b)f(x) = sign(w\cdot x+b)f(x)=sign(w⋅x+b)
下面使用随机梯度下降法(SGD)进行训练:
-
选取初始值w0,b0w_0,b_0w0,b0
-
于训练集中随机选取(xi,yi)(x_i,y_i)(xi,yi)
-
若yi(wx+b)≤0y_i(wx+b)\leq 0yi(wx+b)≤0,样本被误分类,此时进行参数更新:
w←w+ηyixiw \leftarrow w+\eta y_ix_iw←w+ηyixi; b←b+ηyib \leftarrow b +\eta y_ib←b+ηyi -
转到2,直到训练集中没有误分类样本点
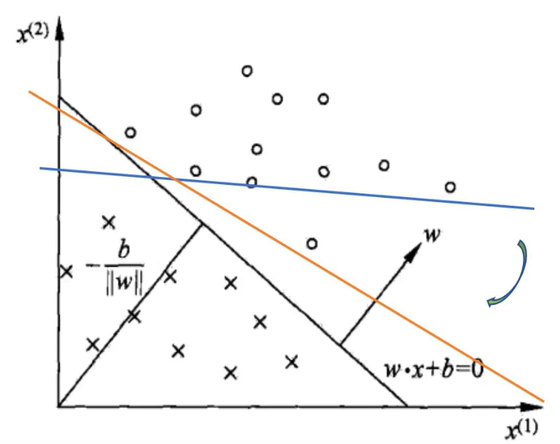
对于感知机模型,参数www决定分离超平面的旋转程度,参数bbb决定分离超平面的位移量。
2.1.2 例题
-
输入:训练集T={(x1,+1),(x2,+1),(x3,+1)}T=\{(x_1,+1),(x_2,+1),(x_3,+1)\}T={(x1,+1),(x2,+1),(x3,+1)}
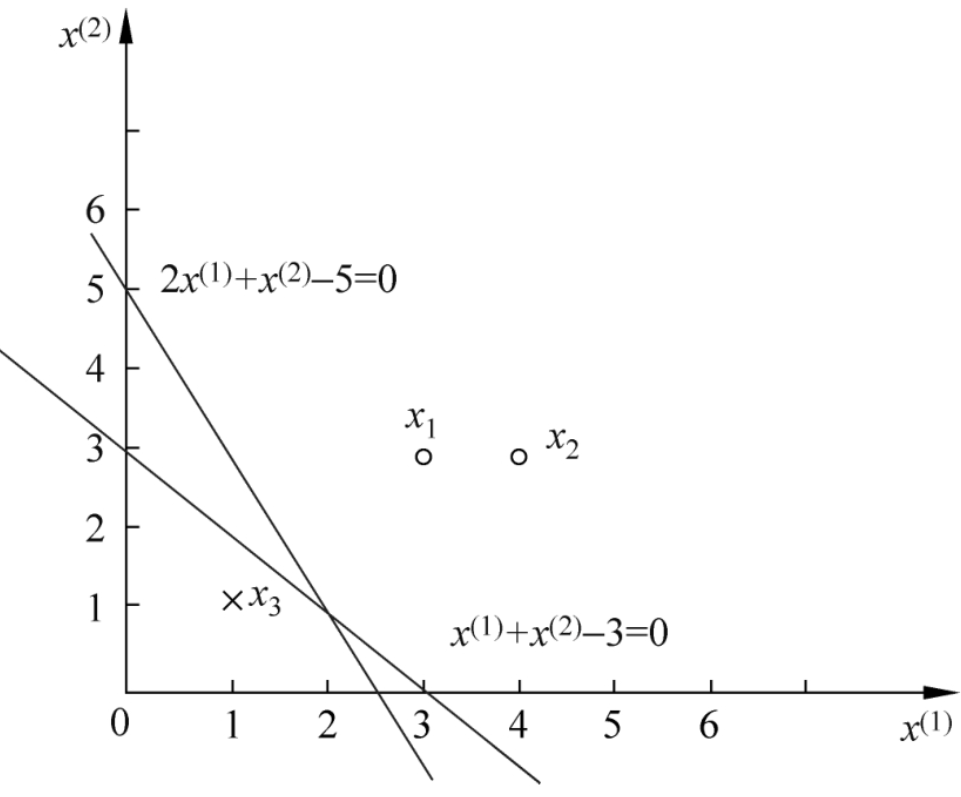
其中,x1=(3,3)T,x2=(4,3)T,x3=(1,1)Tx_1=(3,3)^T,x_2=(4,3)^T,x_3=(1,1)^Tx1=(3,3)T,x2=(4,3)T,x3=(1,1)T,设η=1\eta=1η=1 -
输出:w,bw,bw,b; 感知机模型f(x)=sign(w⋅x+b)f(x) = sign(w\cdot x+b)f(x)=sign(w⋅x+b)
- 学习问题:arg minw,bL(w,b)=arg minw,b[−∑xi∈Myi(w⋅xi+b)]\argmin_{w,b}L(w,b)=\argmin_{w,b}[-\sum_{x_i \in M}y_i(w\cdot x_i+b)]argminw,bL(w,b)=argminw,b[−∑xi∈Myi(w⋅xi+b)]
-
选取初始值w0=(0,0)T,b0=0w_0=(0,0)^T,b_0=0w0=(0,0)T,b0=0
-
对于点x1x_1x1有:y1(w0⋅x1+b0)=+1×((0,0)T⋅(3,3)T+0)=0y_1(w_0\cdot x_1+b_0)=+1\times((0,0)^T\cdot(3,3)^T+0)=0y1(w0⋅x1+b0)=+1×((0,0)T⋅(3,3)T+0)=0,为误分类点
-
更新参数:w1=w0+ηy1x1=(3,3)Tw_1=w_0+\eta y_1x_1=(3,3)^Tw1=w0+ηy1x1=(3,3)T,b1=b0+ηy1=1b_1=b_0+\eta y_1=1b1=b0+ηy1=1
-
模型:w1⋅x+b=3x(1)+3x(2)+1w_1\cdot x+b=3x^{(1)}+3x^{(2)}+1w1⋅x+b=3x(1)+3x(2)+1
-
-
对于点x1x_1x1有:y1(w1x1+b1)=+1×(3x1(1)+3x1(2)+1)=19>0y_1(w_1x_1+b_1)=+1\times(3x_1^{(1)}+3x_1^{(2)}+1)=19>0y1(w1x1+b1)=+1×(3x1(1)+3x1(2)+1)=19>0,样本正确分类
对于点x2x_2x2有:y2(w1⋅x2+b1)=+1×(3x2(1)+3x2(2)+1)=22>0y_2(w_1\cdot x_2+b_1)=+1 \times(3x_2^{(1)}+3x_2^{(2)}+1)=22>0y2(w1⋅x2+b1)=+1×(3x2(1)+3x2(2)+1)=22>0,样本正确分类
对于点x3x_3x3有:y3(w1⋅x3+b1)=+1×(3x3(1)+3x3(2)+1)=−7<0y_3(w_1\cdot x_3+b_1)=+1 \times(3x_3^{(1)}+3x_3^{(2)}+1)=-7<0y3(w1⋅x3+b1)=+1×(3x3(1)+3x3(2)+1)=−7<0,样本误分类-
更新参数: w2=w1+ηy3x3=(2,2)Tw_2=w_1+\eta y_3x_3=(2,2)^Tw2=w1+ηy3x3=(2,2)T,b2=b1+ηy3=0b_2=b_1+\eta y_3 =0b2=b1+ηy3=0
-
模型:w2⋅x+b2=2x(1)+2x(2)w_2\cdot x +b_2 = 2x^{(1)}+2x^{(2)}w2⋅x+b2=2x(1)+2x(2)
-
-
重复以上步骤,直到没有误分类点
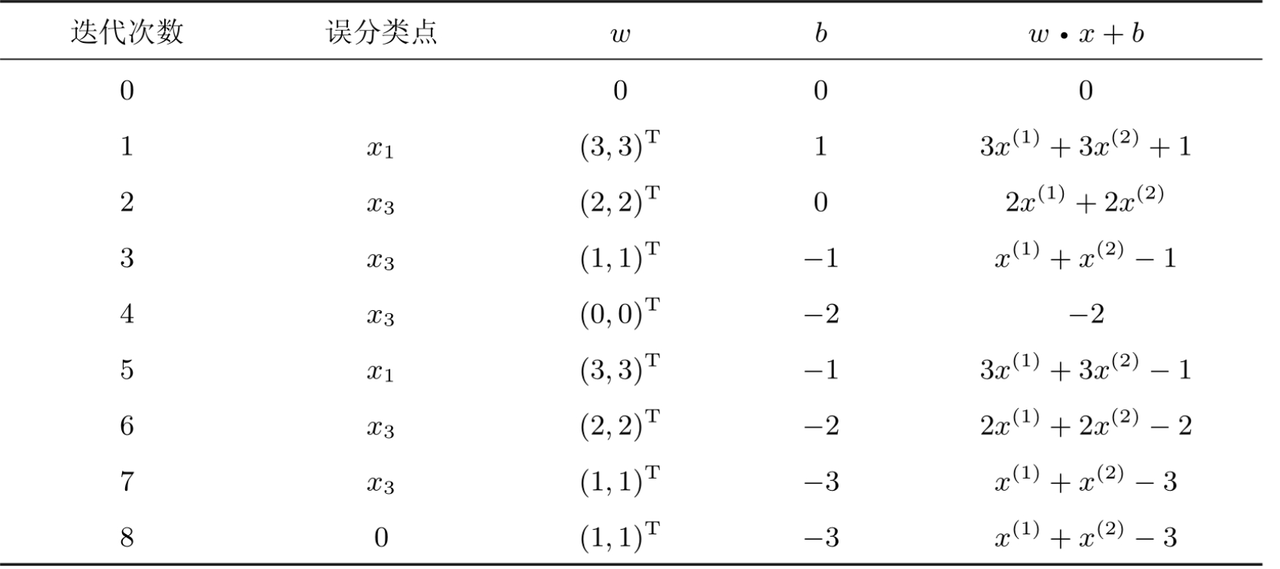
得到参数:w7=(1,1)Tw_7=(1,1)^Tw7=(1,1)T , b7=−3b_7=-3b7=−3
模型:w7⋅x+b7=x(1)+x(2)−3w_7\cdot x +b_7=x^{(1)}+x^{(2)}-3w7⋅x+b7=x(1)+x(2)−3
结果:
-
分离超平面: x(1)+x(2)−3=0x^{(1)}+x^{(2)}-3=0x(1)+x(2)−3=0
-
感知机模型:f(x)=sign(x(1)+x(2)−3)f(x)=sign(x^{(1)}+x^{(2)}-3)f(x)=sign(x(1)+x(2)−3)
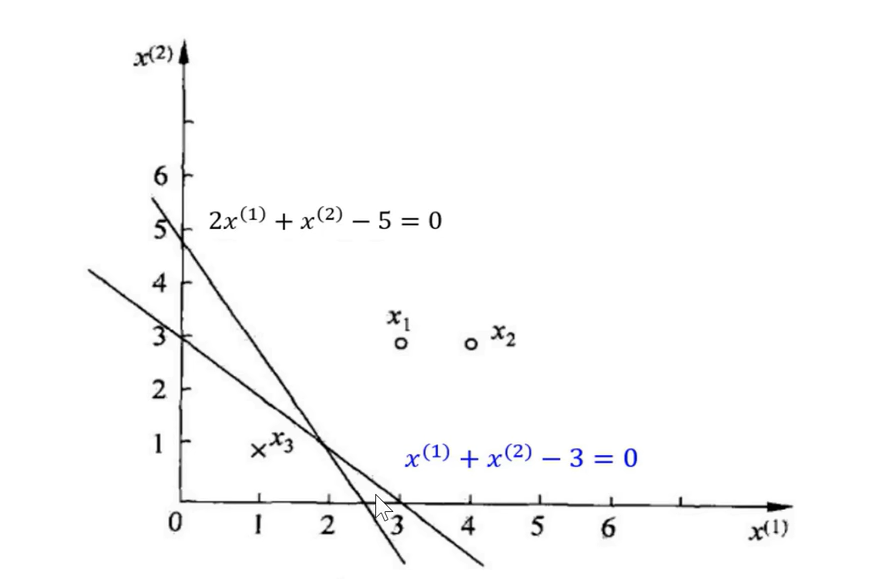
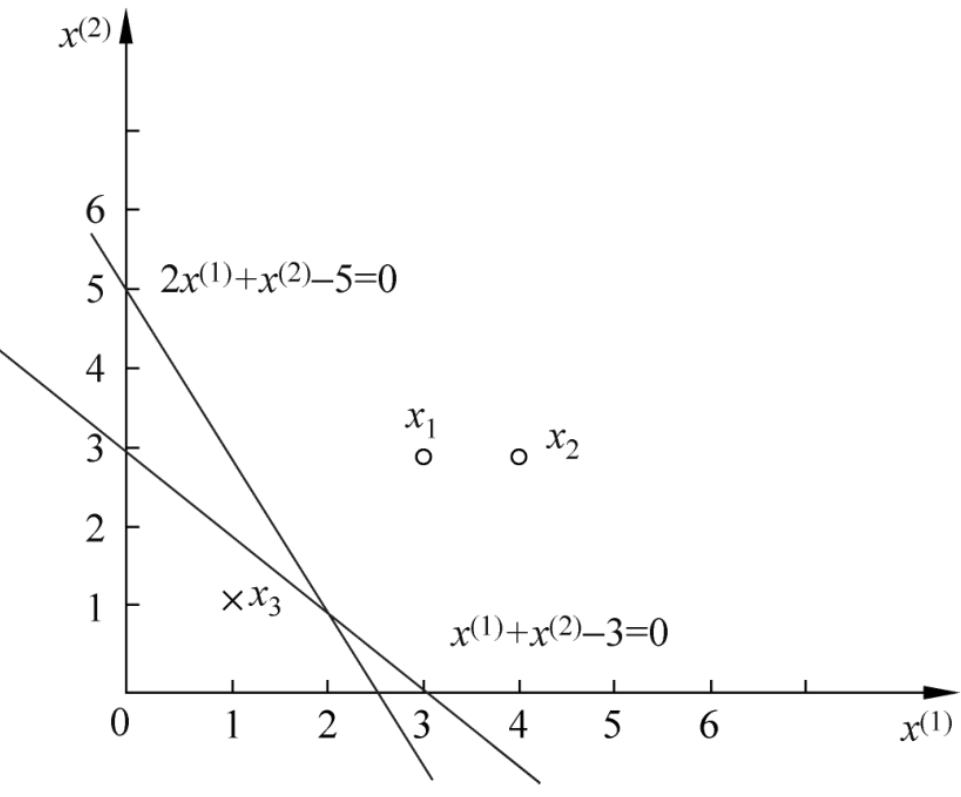
注: 若采取不同的顺序可能得到不同的分离超平面
-
若误分类点依次取x1,x3,x3,x3,x1,x3,x3x_1,x_3,x_3,x_3,x_1,x_3,x_3x1,x3,x3,x3,x1,x3,x3,可得分离超平面:x(1)+x(2)−3=0x^{(1)}+x^{(2)}-3=0x(1)+x(2)−3=0
-
若误分类点依次取x1,x3,x3,x3,x2,x3,x3,x3,x1,x3,x3x_1,x_3,x_3,x_3,x_2,x_3,x_3,x_3,x_1,x_3,x_3x1,x3,x3,x3,x2,x3,x3,x3,x1,x3,x3,可得分离超平面:2x(1)+x(2)−5=02x^{(1)}+x^{(2)}-5=02x(1)+x(2)−5=0
-
可知感知机学习算法由于采用不同的初值或选取不同的误分类点,解可以不同。
2.1.3 算法收敛性
对w,xw,xw,x进行增广扩充,记w^=(wT,b)T,x^=(xT,1)T\hat{w}=(w^T,b)^T,\hat{x}=(x^T,1)^Tw^=(wT,b)T,x^=(xT,1)T,则分离超平面可写为:w^⋅x^=0\hat{w}\cdot \hat{x}=0w^⋅x^=0
Novikoff
若训练集T={(x1,y1),(x2,y2),...,(xN,yN)}T=\{(x_1,y_1),(x_2,y_2),...,(x_N,y_N)\}T={(x1,y1),(x2,y2),...,(xN,yN)}线性可分,其中,xi∈X⊆Rn,y∈Y={+1,−1}x_i\in\mathcal{X} \subseteq \R^n,y\in \mathcal{Y}=\{+1,-1\}xi∈X⊆Rn,y∈Y={+1,−1}则:
(1)存在满足条件∣∣w^opt∣∣=1||\hat{w}_{opt}||=1∣∣w^opt∣∣=1的超平面w^opt⋅x^=0\hat{w}_{opt}\cdot \hat{x}=0w^opt⋅x^=0可将T完全正确分开;
且∃γ>0,\exist \gamma>0,∃γ>0,对于所有i=1,2,...,Ni=1,2,...,Ni=1,2,...,N,有yi(w^opt⋅x^)≥γy_i(\hat{w}_{opt}\cdot \hat{x}) \geq \gammayi(w^opt⋅x^)≥γ
(2)令R=max1≤i≤N∣∣xi^∣∣R=\max_{1\leq i \leq N}||\hat{x_i}||R=max1≤i≤N∣∣xi^∣∣,则感知机算法在T上的误分类次数k满足不等式:
k≤(Rγ)2k\leq (\dfrac{R}{\gamma})^2k≤(γR)2
第一条:
∵T\because T∵T线性可分
∴∃\therefore \exist∴∃超平面w^opt⋅x^=wopt⋅x+bopt=0\hat{w}_{opt}\cdot \hat{x}=w_{opt}\cdot x+b_{opt}=0w^opt⋅x^=wopt⋅x+bopt=0将T完全正确划分开(不妨令∣∣w^opt∣∣=1||\hat{w}_{opt}||=1∣∣w^opt∣∣=1)
那么,对有限的i=1,2,...,Ni=1,2,...,Ni=1,2,...,N均有yi(w^opt⋅x^i)=yi(wopt⋅xi+bopt)>0y_i(\hat{w}_{opt}\cdot \hat{x}_i)=y_i(w_{opt}\cdot x_i+b_{opt})>0yi(w^opt⋅x^i)=yi(wopt⋅xi+bopt)>0
记γ=mini{yi(wopt⋅xi+bopt)}\gamma=\min_{i}\{y_i(w_{opt}\cdot x_i+b_{opt})\}γ=mini{yi(wopt⋅xi+bopt)},则有yi(w^opt⋅x^i)=yi(wopt⋅xi+bopt)≥γy_i(\hat{w}_{opt}\cdot \hat{x}_i)=y_i(w_{opt}\cdot x_i+b_{opt})\geq\gammayi(w^opt⋅x^i)=yi(wopt⋅xi+bopt)≥γ
第二条:
假设w^0=0\hat{w}_0 = \mathbf{0}w^0=0,若实例被误分类,则更新权重。令w^k−1\hat{w}_{k-1}w^k−1为第k个误分类实例之前的扩充权重向量,即
w^k−1=(wk−1T,bk−1)\hat{w}_{k-1}=(w_{k-1}^T,b_{k-1})w^k−1=(wk−1T,bk−1)
若 yi(w^k−1⋅x^i)=yi(wk−1⋅xi+bk−1)≤0y_i(\hat{w}_{k-1}\cdot \hat{x}_i)=y_i(w_{k-1}\cdot x_i +b_{k-1})\leq0yi(w^k−1⋅x^i)=yi(wk−1⋅xi+bk−1)≤0,则(xi,yi)(x_i,y_i)(xi,yi)为第k个误分类实例,更新参数:
{wk←wk−1+ηyixibk←bk−1+ηyi⇒w^k=w^k−1+ηyix^i\begin{cases}
w_k \leftarrow w_{k-1}+\eta y_ix_i \\
b_k \leftarrow b_{k-1} + \eta y_i
\end{cases} \Rightarrow \hat{w}_{k}=\hat{w}_{k-1}+\eta y_i\hat{x}_i{wk←wk−1+ηyixibk←bk−1+ηyi⇒w^k=w^k−1+ηyix^i
推导不等式{w^k⋅w^opt≥kηγ∣∣w^k∣∣2≤kη2R2\begin{cases} \hat{w}_k \cdot \hat{w}_{opt} \geq k \eta \gamma \\ ||\hat{w}_k||^2 \leq k \eta^2 R^2 \end{cases}{w^k⋅w^opt≥kηγ∣∣w^k∣∣2≤kη2R2
w^k⋅w^opt=(w^k−1+ηyix^i)⋅w^opt=w^k−1⋅w^opt+ηyiw^opt⋅x^i≥w^k−1⋅w^opt+ηγ≥w^k−2⋅w^opt+2ηγ...≥w^0⋅w^opt+kηγ≥kηγ\begin{aligned} \hat{w}_k\cdot \hat{w}_{opt} &=(\hat{w}_{k-1}+\eta y_i\hat{x}_i)\cdot \hat{w}_{opt}\\ &=\hat{w}_{k-1}\cdot \hat{w}_{opt}+\eta y_i\hat{w}_{opt}\cdot \hat{x}_i \\ &\geq \hat{w}_{k-1}\cdot \hat{w}_{opt} +\eta \gamma \\ &\geq \hat{w}_{k-2}\cdot \hat{w}_{opt} +2\eta \gamma \\ &...\\ &\geq \hat{w}_0\cdot \hat{w}_{opt}+k\eta \gamma\\ &\geq k \eta \gamma \end{aligned}w^k⋅w^opt=(w^k−1+ηyix^i)⋅w^opt=w^k−1⋅w^opt+ηyiw^opt⋅x^i≥w^k−1⋅w^opt+ηγ≥w^k−2⋅w^opt+2ηγ...≥w^0⋅w^opt+kηγ≥kηγ
∣∣w^k∣∣2=∣∣w^k−1+ηyix^i∣∣2=∣∣w^k−1∣∣2+2ηyiw^k−1x^i+η2∣∣x^i∣∣2≤∣∣w^k−1∣∣2+η2∣∣x^i∣∣2≤∣∣w^k−2∣∣2+2η2R2...≤∣∣w^1∣∣2+(k−1)η2R2≤∣∣w^0∣∣2+kη2R2=kη2R2\begin{aligned} ||\hat{w}_k||^2&=||\hat{w}_{k-1}+\eta y_i \hat{x}_i||^2\\ &=||\hat{w}_{k-1}||^2+2\eta y_i\hat{w}_{k-1}\hat{x}_i +\eta^2||\hat{x}_i||^2\\ &\leq||\hat{w}_{k-1}||^2+\eta^2||\hat{x}_i||^2\\ &\leq ||\hat{w}_{k-2}||^2 +2\eta^2 R^2\\ &...\\&\leq ||\hat{w}_1||^2+(k-1)\eta^2R^2\\&\leq||\hat{w}_0||^2+k\eta^2R^2\\ &=k\eta^2R^2 \end{aligned}∣∣w^k∣∣2=∣∣w^k−1+ηyix^i∣∣2=∣∣w^k−1∣∣2+2ηyiw^k−1x^i+η2∣∣x^i∣∣2≤∣∣w^k−1∣∣2+η2∣∣x^i∣∣2≤∣∣w^k−2∣∣2+2η2R2...≤∣∣w^1∣∣2+(k−1)η2R2≤∣∣w^0∣∣2+kη2R2=kη2R2
结合两个不等式
{w^k⋅w^opt≥kηγ∣∣w^k∣∣2≤kη2R2⇒kηγ≤w^k⋅w^opt≤∣∣w^k∣∣∣∣w^opt∣∣≤kηR\begin{cases}
\hat{w}_k \cdot \hat{w}_{opt} \geq k \eta \gamma \\
||\hat{w}_k||^2 \leq k \eta^2 R^2
\end{cases}\Rightarrow k\eta\gamma\leq\hat{w}_k\cdot \hat{w}_{opt} \leq||\hat{w}_k||||\hat{w}_{opt}||\leq\sqrt{k}\eta R{w^k⋅w^opt≥kηγ∣∣w^k∣∣2≤kη2R2⇒kηγ≤w^k⋅w^opt≤∣∣w^k∣∣∣∣w^opt∣∣≤kηR
∴kηγ≤kηR⇒k2γ2≤kR2\therefore k\eta\gamma \leq \sqrt{k}\eta R \Rightarrow k^2\gamma^2 \leq k R^2∴kηγ≤kηR⇒k2γ2≤kR2
∴k≤(Rγ)2\therefore k \leq (\frac{R}{\gamma})^2∴k≤(γR)2
-
收敛性:k有上限,因此可以通过有限次搜索能够得到将数据集T完全分开的超平面
-
依赖性:通过不同初值或者迭代过程中误分类点顺序不同,可能得到不同分离超平面
-
对于线性不可分数据集T,算法不收敛,迭代结果会发生震荡
-
为得到唯一分离超平面,需增加条件约束
2.2 对偶形式
2.2.1 算法
-
原始形式中,若(xi,yi)(x_i,y_i)(xi,yi)为误分类点,参数更新如下:w←w+ηyixiw \leftarrow w +\eta y_ix_iw←w+ηyixi; b←b+ηyib \leftarrow b + \eta y_ib←b+ηyi
-
假设初始值w0=0,b0=0w_0=\mathbf{0},b_0=0w0=0,b0=0,对误分类点(xi,yi)(x_i,y_i)(xi,yi)通过上述公式更新参数
修改nin_ini次后,w,bw,bw,b的增量分别为αiyixi\alpha_iy_ix_iαiyixi和αiyi\alpha_iy_iαiyi,其中αi=niη\alpha_i=n_i\etaαi=niη
nin_ini代表第i个实例在参数更新中贡献的次数 -
最后学习到的参数:w=∑i=1Nαiyixiw=\sum_{i=1}^N\alpha_iy_ix_iw=∑i=1Nαiyixi; b=∑i=1Nαiyib=\sum_{i=1}^N\alpha_iy_ib=∑i=1Nαiyi
在原始算法的例子中:
加粗样式
更新次数:n1=2,n2=0,n3=5n_1=2,n_2=0,n_3=5n1=2,n2=0,n3=5,最后学习到的参数为:
w=α1y1x1+α3y3x3=(1,1)Tw=\alpha_1y_1x_1+\alpha_3y_3x_3=(1,1)^Tw=α1y1x1+α3y3x3=(1,1)T; b=α1y1+α3y3=−3b=\alpha_1y_1+\alpha_3y_3=-3b=α1y1+α3y3=−3
训练具体步骤:
-
输入:训练集T={(x1,y1),(x2,y2),...,(xN,yN)}T=\{(x_1,y_1),(x_2,y_2),...,(x_N,y_N)\}T={(x1,y1),(x2,y2),...,(xN,yN)}
其中,xi∈X⊆Rn,y∈Y={+1,−1}x_i \in \mathcal{X} \subseteq \R^n,y \in \mathcal{Y}=\{+1,-1\}xi∈X⊆Rn,y∈Y={+1,−1};步长η(0<η<1)\eta(0<\eta<1)η(0<η<1) -
输出:α,b;\alpha,b;α,b; 感知机模型f(x)=sign(∑j=1Nαjyjxj⋅x+b)f(x)=sign(\sum_{j=1}^N\alpha_jy_jx_j\cdot x+b)f(x)=sign(∑j=1Nαjyjxj⋅x+b),其中α=(α1,α2,...,αN)T\alpha=(\alpha_1,\alpha_2,...,\alpha_N)^Tα=(α1,α2,...,αN)T
-
选取初始值α<0>=(0,0,...,0)T\alpha^{<0>}=(0,0,...,0)^Tα<0>=(0,0,...,0)T,b<0>=0b^{<0>}=0b<0>=0
-
在训练集中随机选取数据(xi,yi)(x_i,y_i)(xi,yi)
-
若yi(∑j=1Nαjyjxj⋅xi+b)≤0y_i(\sum_{j=1}^N \alpha_jy_jx_j\cdot x_i+b)\leq 0yi(∑j=1Nαjyjxj⋅xi+b)≤0,则αi←αi+η\alpha_i \leftarrow \alpha_i+\etaαi←αi+η;b←b+ηyib \leftarrow b+\eta y_ib←b+ηyi
-
转到步骤2,直至训练集中没有误分类点
步骤3中的迭代条件:
yi(∑j=1Nαjyjxj⋅xi+b)=yi[(α1y1x1+α2y2x2+...+αNyNxN)⋅xi+b]=yi(α1y1x1xi+α2y2x2xi+...+αNyNxNxi+b)≤0\begin{aligned} y_i(\sum_{j=1}^N \alpha_jy_jx_j\cdot x_i+b)&=y_i[(\alpha_1y_1x_1+\alpha_2y_2x_2+...+\alpha_Ny_Nx_N)\cdot x_i+b]\\ &=y_i(\alpha_1y_1x_1x_i+\alpha_2y_2x_2x_i+...+\alpha_Ny_Nx_Nx_i+b)\\ &\leq0 \end{aligned}yi(j=1∑Nαjyjxj⋅xi+b)=yi[(α1y1x1+α2y2x2+...+αNyNxN)⋅xi+b]=yi(α1y1x1xi+α2y2x2xi+...+αNyNxNxi+b)≤0
Gram矩阵(用于存储xi⋅xjx_i\cdot x_jxi⋅xj的值减少计算开销):
G=[xi⋅xj]N×N=[x1⋅x1x1⋅x2...x1⋅xNx2⋅x1x2⋅x2...x2⋅xN............xN⋅x1xN⋅x2...xN⋅xN]G=[x_i\cdot x_j]_{N\times N}=\begin{bmatrix}
x_1\cdot x_1 & x_1\cdot x_2&...&x_1\cdot x_N \\
x_2\cdot x_1 & x_2\cdot x_2&...&x_2\cdot x_N \\
... &...&...&...\\
x_N\cdot x_1 & x_N\cdot x_2&...&x_N\cdot x_N \\
\end{bmatrix}G=[xi⋅xj]N×N=x1⋅x1x2⋅x1...xN⋅x1x1⋅x2x2⋅x2...xN⋅x2............x1⋅xNx2⋅xN...xN⋅xN
2.2.2 例题
使用原始形式中的例题:
-
输入:训练集T={(x1,+1),(x2,+1),(x3,+1)}T=\{(x_1,+1),(x_2,+1),(x_3,+1)\}T={(x1,+1),(x2,+1),(x3,+1)}
其中,x1=(3,3)T,x2=(4,3)T,x3=(1,1)Tx_1=(3,3)^T,x_2=(4,3)^T,x_3=(1,1)^Tx1=(3,3)T,x2=(4,3)T,x3=(1,1)T,设η=1\eta=1η=1 -
输出:α,b;\alpha,b;α,b; 感知机模型f(x)=sign(∑j=1Nαjyjxj⋅x+b)f(x)=sign(\sum_{j=1}^N\alpha_jy_jx_j\cdot x+b)f(x)=sign(∑j=1Nαjyjxj⋅x+b),其中α=(α1,α2,...,αN)T\alpha=(\alpha_1,\alpha_2,...,\alpha_N)^Tα=(α1,α2,...,αN)T
-
选取初始值α<0>=(0,0,0)T,b<0>=0\alpha^{<0>}=(0,0,0)^T,b^{<0>}=0α<0>=(0,0,0)T,b<0>=0
-
计算Gram矩阵:
G=[x1⋅x1x1⋅x2x1⋅x3x2⋅x1x2⋅x2x2⋅x3x3⋅x1x3⋅x2x3⋅x3]=[1821621257672]G =\begin{bmatrix} x_1\cdot x_1 & x_1\cdot x_2 &x_1\cdot x_3\\ x_2\cdot x_1 & x_2\cdot x_2 &x_2\cdot x_3\\ x_3\cdot x_1 & x_3\cdot x_2 &x_3\cdot x_3\\ \end{bmatrix}=\begin{bmatrix} 18&21&6\\ 21&25&7\\ 6&7&2 \end{bmatrix}G=x1⋅x1x2⋅x1x3⋅x1x1⋅x2x2⋅x2x3⋅x2x1⋅x3x2⋅x3x3⋅x3=1821621257672 -
误分类条件yi(∑j=1Nαjyjxj⋅xi+b)≤0y_i(\sum_{j=1}^N \alpha_jy_jx_j\cdot x_i+b)\leq 0yi(∑j=1Nαjyjxj⋅xi+b)≤0,参数更新:αi←αi+η\alpha_i \leftarrow \alpha_i+\etaαi←αi+η;b←b+ηyib \leftarrow b+\eta y_ib←b+ηyi
-
对于点x1x_1x1有:y1(∑j=1Nαj<0>yjxj⋅x1+b<0>)=0y_1(\sum_{j=1}^N\alpha_j^{<0>}y_jx_j\cdot x_1+b^{<0>})=0y1(∑j=1Nαj<0>yjxj⋅x1+b<0>)=0,样本误分类
- 更新参数: α1<1>=α1<0>+η=1,b<1>=b<0>+ηy1=1\alpha_1^{<1>}=\alpha_1^{<0>}+\eta=1,b^{<1>}=b^{<0>}+\eta y_1 =1α1<1>=α1<0>+η=1,b<1>=b<0>+ηy1=1
-
对于点x1x_1x1有:y1(∑j=1Nαj<1>yjxj⋅x1+b<1>)=y1(α1<1>y1x1⋅x1+b<1>)=19>0y_1(\sum_{j=1}^N\alpha_j^{<1>}y_jx_j\cdot x_1+b^{<1>})=y_1(\alpha_1^{<1>}y_1x_1\cdot x_1 +b^{<1>})=19>0y1(∑j=1Nαj<1>yjxj⋅x1+b<1>)=y1(α1<1>y1x1⋅x1+b<1>)=19>0,样本正确分类
对于点x2x_2x2有:y2(∑j=1Nαj<1>yjxj⋅x2+b<1>)=y2(α1<1>y1x1⋅x2+b<1>)=22>0y_2(\sum_{j=1}^N\alpha_j^{<1>}y_jx_j\cdot x_2+b^{<1>})=y_2(\alpha_1^{<1>}y_1x_1\cdot x_2 +b^{<1>})=22>0y2(∑j=1Nαj<1>yjxj⋅x2+b<1>)=y2(α1<1>y1x1⋅x2+b<1>)=22>0,样本正确分类
对于点x3x_3x3有:y3(∑j=1Nαj<1>yjxj⋅x3+b<1>)=y3(α1<1>y1x1⋅x3+b<1>)=−7<0y_3(\sum_{j=1}^N\alpha_j^{<1>}y_jx_j\cdot x_3+b^{<1>})=y_3(\alpha_1^{<1>}y_1x_1\cdot x_3 +b^{<1>})=-7<0y3(∑j=1Nαj<1>yjxj⋅x3+b<1>)=y3(α1<1>y1x1⋅x3+b<1>)=−7<0,样本误分类- 更新参数:α3<2>=α3<1>+η=1,b<2>=b<1>+ηy3=0\alpha_3^{<2>}=\alpha_3^{<1>}+\eta = 1,b^{<2>}=b^{<1>}+\eta y_3 =0α3<2>=α3<1>+η=1,b<2>=b<1>+ηy3=0
-
重复以上步骤,直到没有误分类点
-
得到参数:w<7>=2x1+0x2−5x3=(1,1)T,b<7>=−3w^{<7>}=2x_1+0x_2-5x_3=(1,1)^T,b^{<7>}=-3w<7>=2x1+0x2−5x3=(1,1)T,b<7>=−3
结果:-
分离超平面:x(1)+x(2)−3=0x^{(1)}+x^{(2)}-3=0x(1)+x(2)−3=0
-
感知机模型:f(x)=sign(x(1)+x(2)−3)f(x)=sign(x^{(1)}+x^{(2)}-3)f(x)=sign(x(1)+x(2)−3)
-

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐

 6
 0
- 0


 已为社区贡献5条内容

所有评论(0)