让 NotebookLM 给Claude Code 打工(使用篇)
一、从“接入工具”到“建立分工”
在上一篇《让 NotebookLM 给 Claude Code 打工(配置篇)》里,我已经完成了 NotebookLM skill 的安装与接入。但真正的问题并不是“能不能用”,而是“接进来之后,它到底在项目里负责什么”。如果这个分工不明确,NotebookLM 很容易沦为一个看起来很高级、实际却只会做总结的摆件。
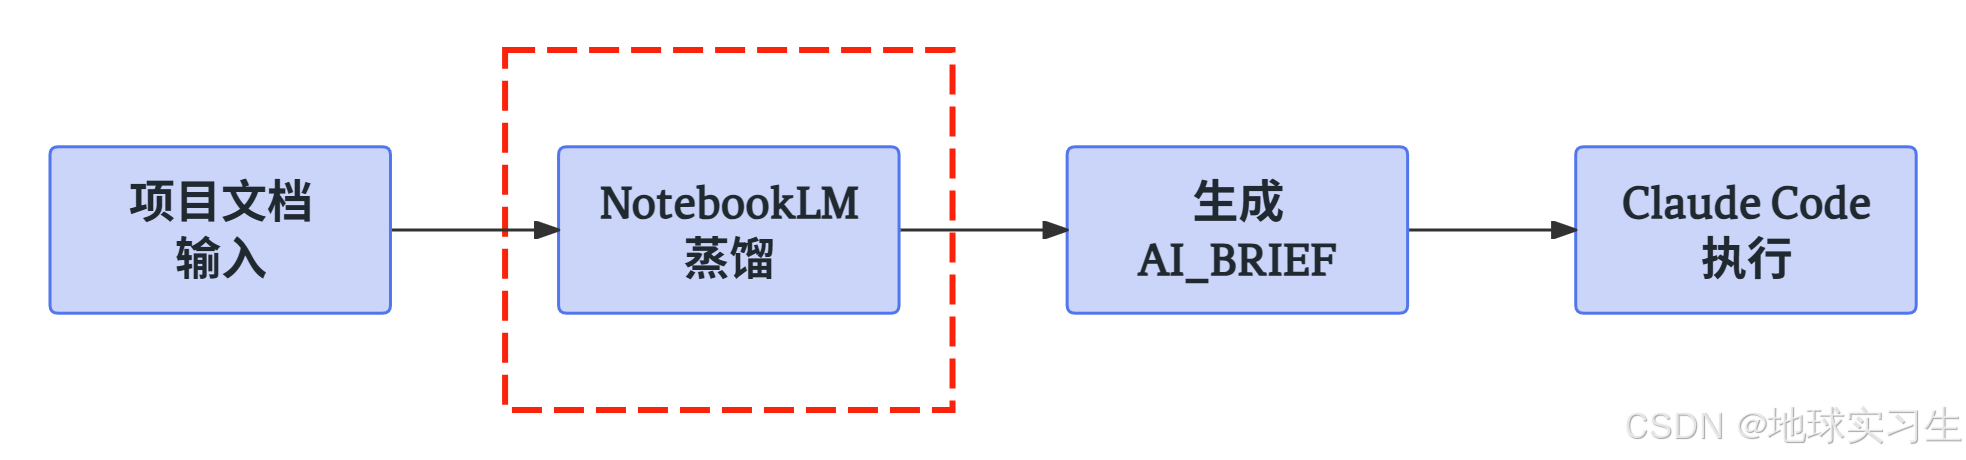
在我的这套工作流里,NotebookLM 不是写代码的,它更像是一个负责整理、归纳、交叉比对项目文档的“项目文档研究员”;而 Claude Code 则是最终读取结论、落地执行、修改工程文件的“动手工程师”。前者负责吃文档,后者负责干活。这样一来,两者就不再是重复劳动,而是形成了明确的上下游关系。一句话:
NotebookLM负责处理长文档上下文,Claude Code负责基于蒸馏后的结果进入工程执行。
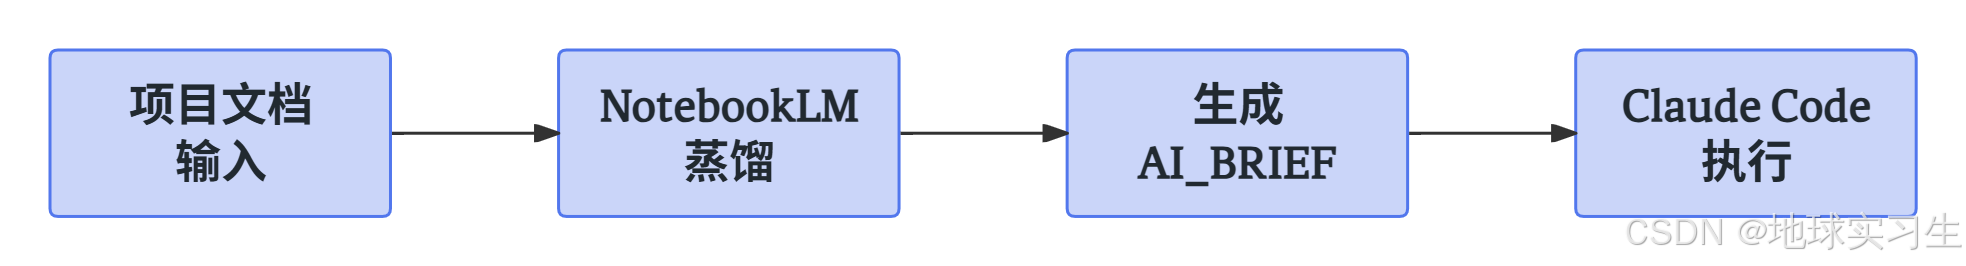
分工明确之后,接下来的问题就变成了:到底哪些文档应该交给 NotebookLM,哪些文档又不应该进入主知识库。
二、先整理文档,再搭项目知识库
在真正开始建 NotebookLM 项目知识库之前,我先碰到的不是命令问题,而是文档问题。以我目前的实际项目文件夹为例,文件夹里往往不只有 PRD、SPEC、TASK 这类正式文档,还会混着 README、调试记录、AI 协作规范,甚至还有一些已经过时的旧版本文件。如果这些内容不加区分地一起丢进 NotebookLM,最后得到的不是更强的推理能力,而是更混乱的上下文。
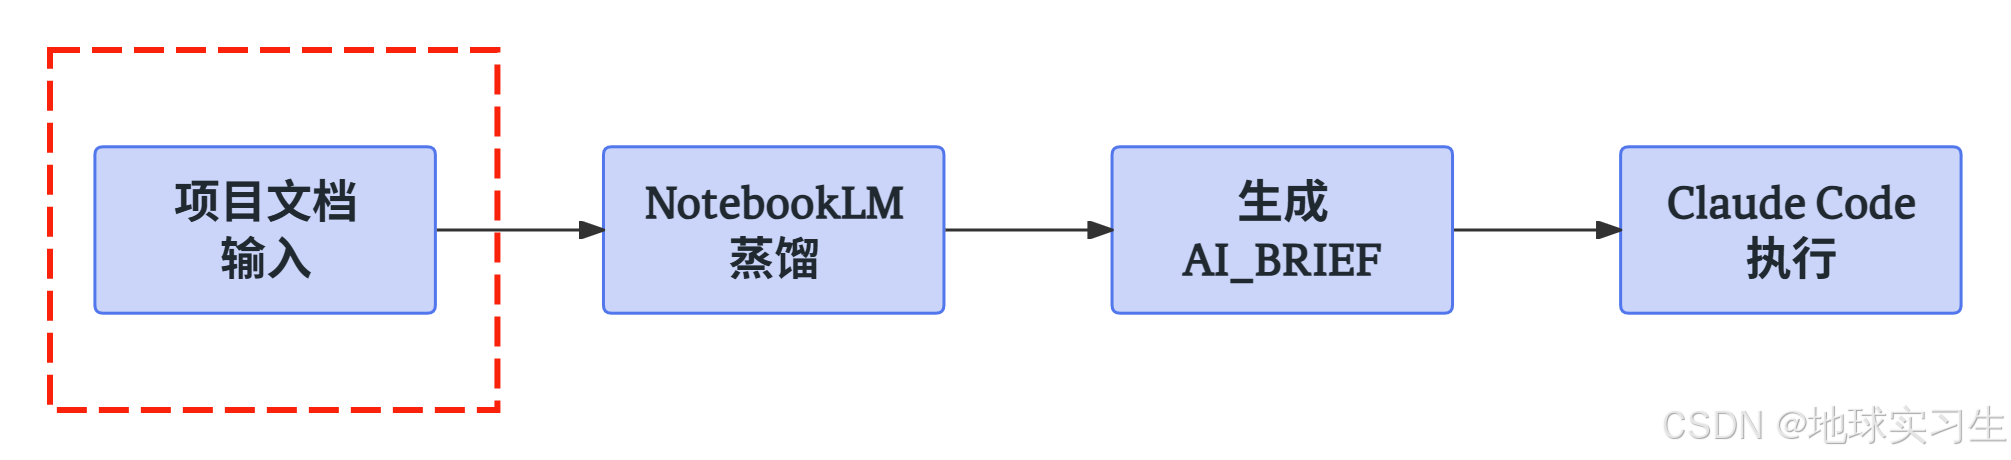
1. 哪些文档应该进入主知识库
- PRD / SPEC / PLAN / TASK
- PROJECT_STATUS
- ARCHITECTURE_DOGMA
- README
以上这些文档共同构成了项目的“事实层”。它们定义了需求、约束、进度和任务依赖,适合被 NotebookLM 作为主知识来源统一索引。
2. 哪些文档不适合进入主知识库
- CLAUDE.md 这类 AI 协作规范
- DEBUG.md 这类历史调试记录
- 已经废弃的旧版文档
CLAUDE.md 更像“Claude Code 的操作规程”,它不是项目知识本身;DEBUG.md 则更像历史病例库,适合单独处理,不适合污染主知识库。至于旧版文档,则必须尽量清除,避免出现多个版本同时存在导致的事实冲突。
3. 为什么一个主 Notebook 往往就够了
一开始Claude Code也建议过要不要按产品、架构、调试分成多个 notebook,但最后还是收敛成了一个主 notebook。原因很简单:
如果把需求、规格、架构红线和任务列表拆开,NotebookLM 很多有价值的跨文档比对能力反而发挥不出来。对于一个文档数量还不算夸张的中小项目来说,一个主 notebook 往往更利于形成统一上下文。
注意:这里我是踩过的坑,放上图,踩坑仅供参考
项目文档输入的选择
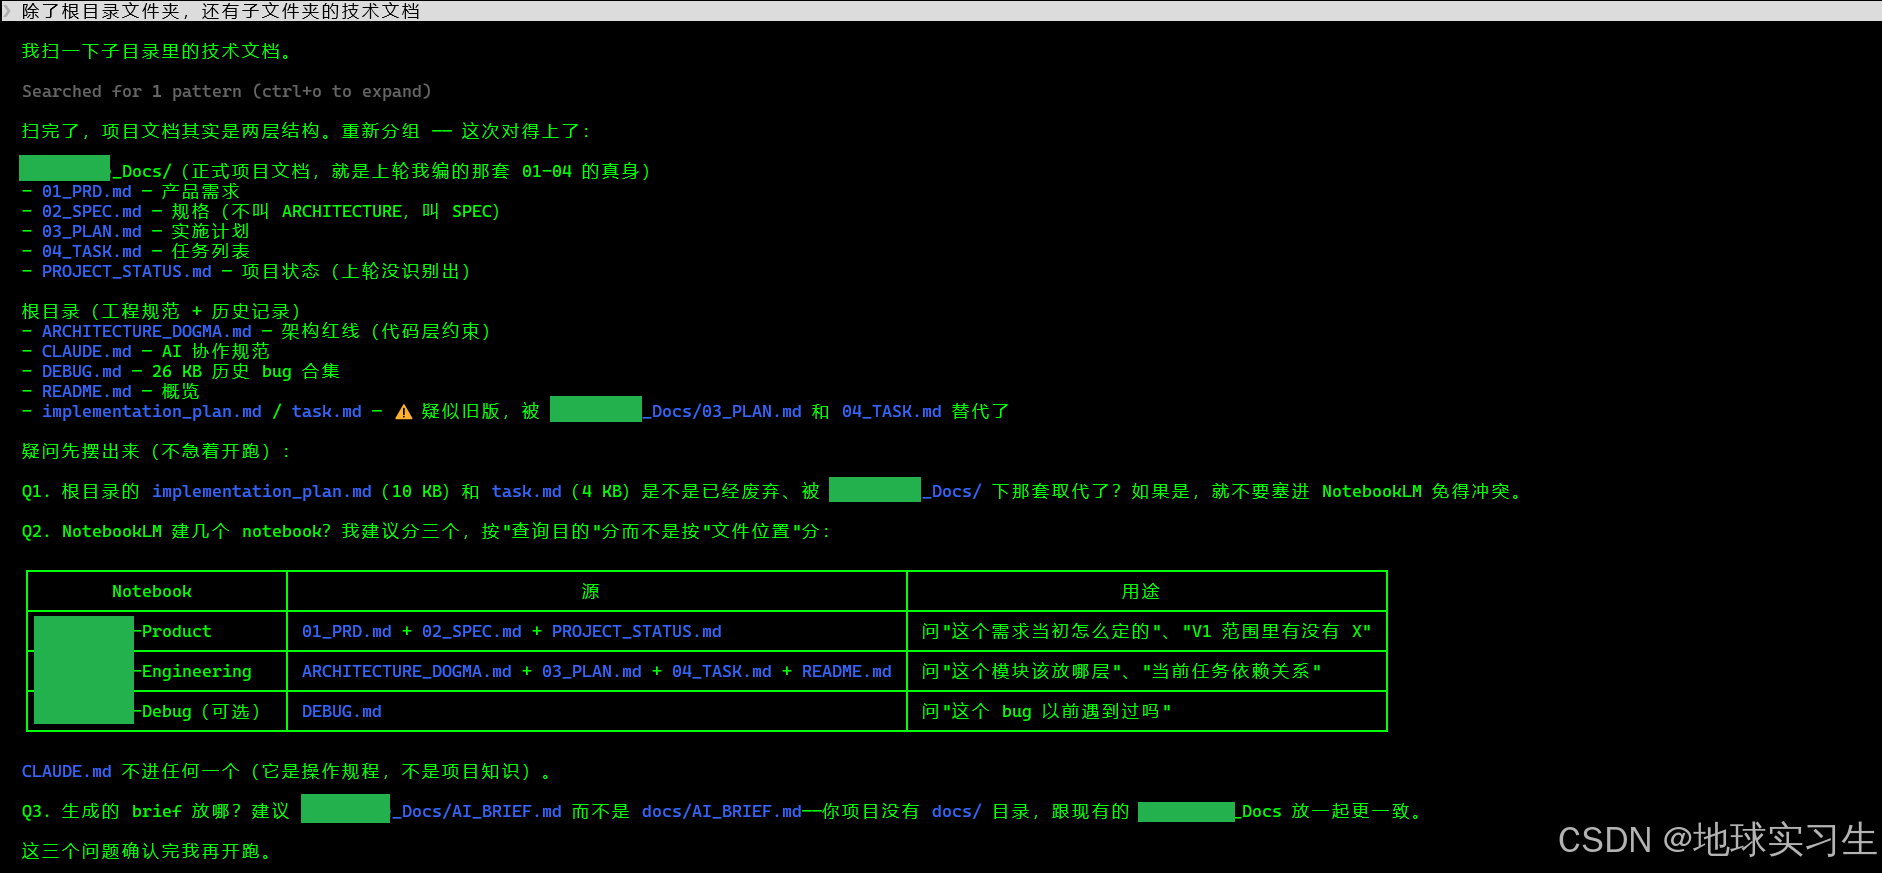
面对Claude code疑惑的三个问题,使用与别的AI chat模型(我这里是Gemini)得到的提示词进行回应,确认之后,接下来就是实打实的第三部分:让NotebookLM打工
- 旧文档的保留是否?
- NotebookLM的建多个库策略是否有必要?
- 生成 Brief 的存放位置?
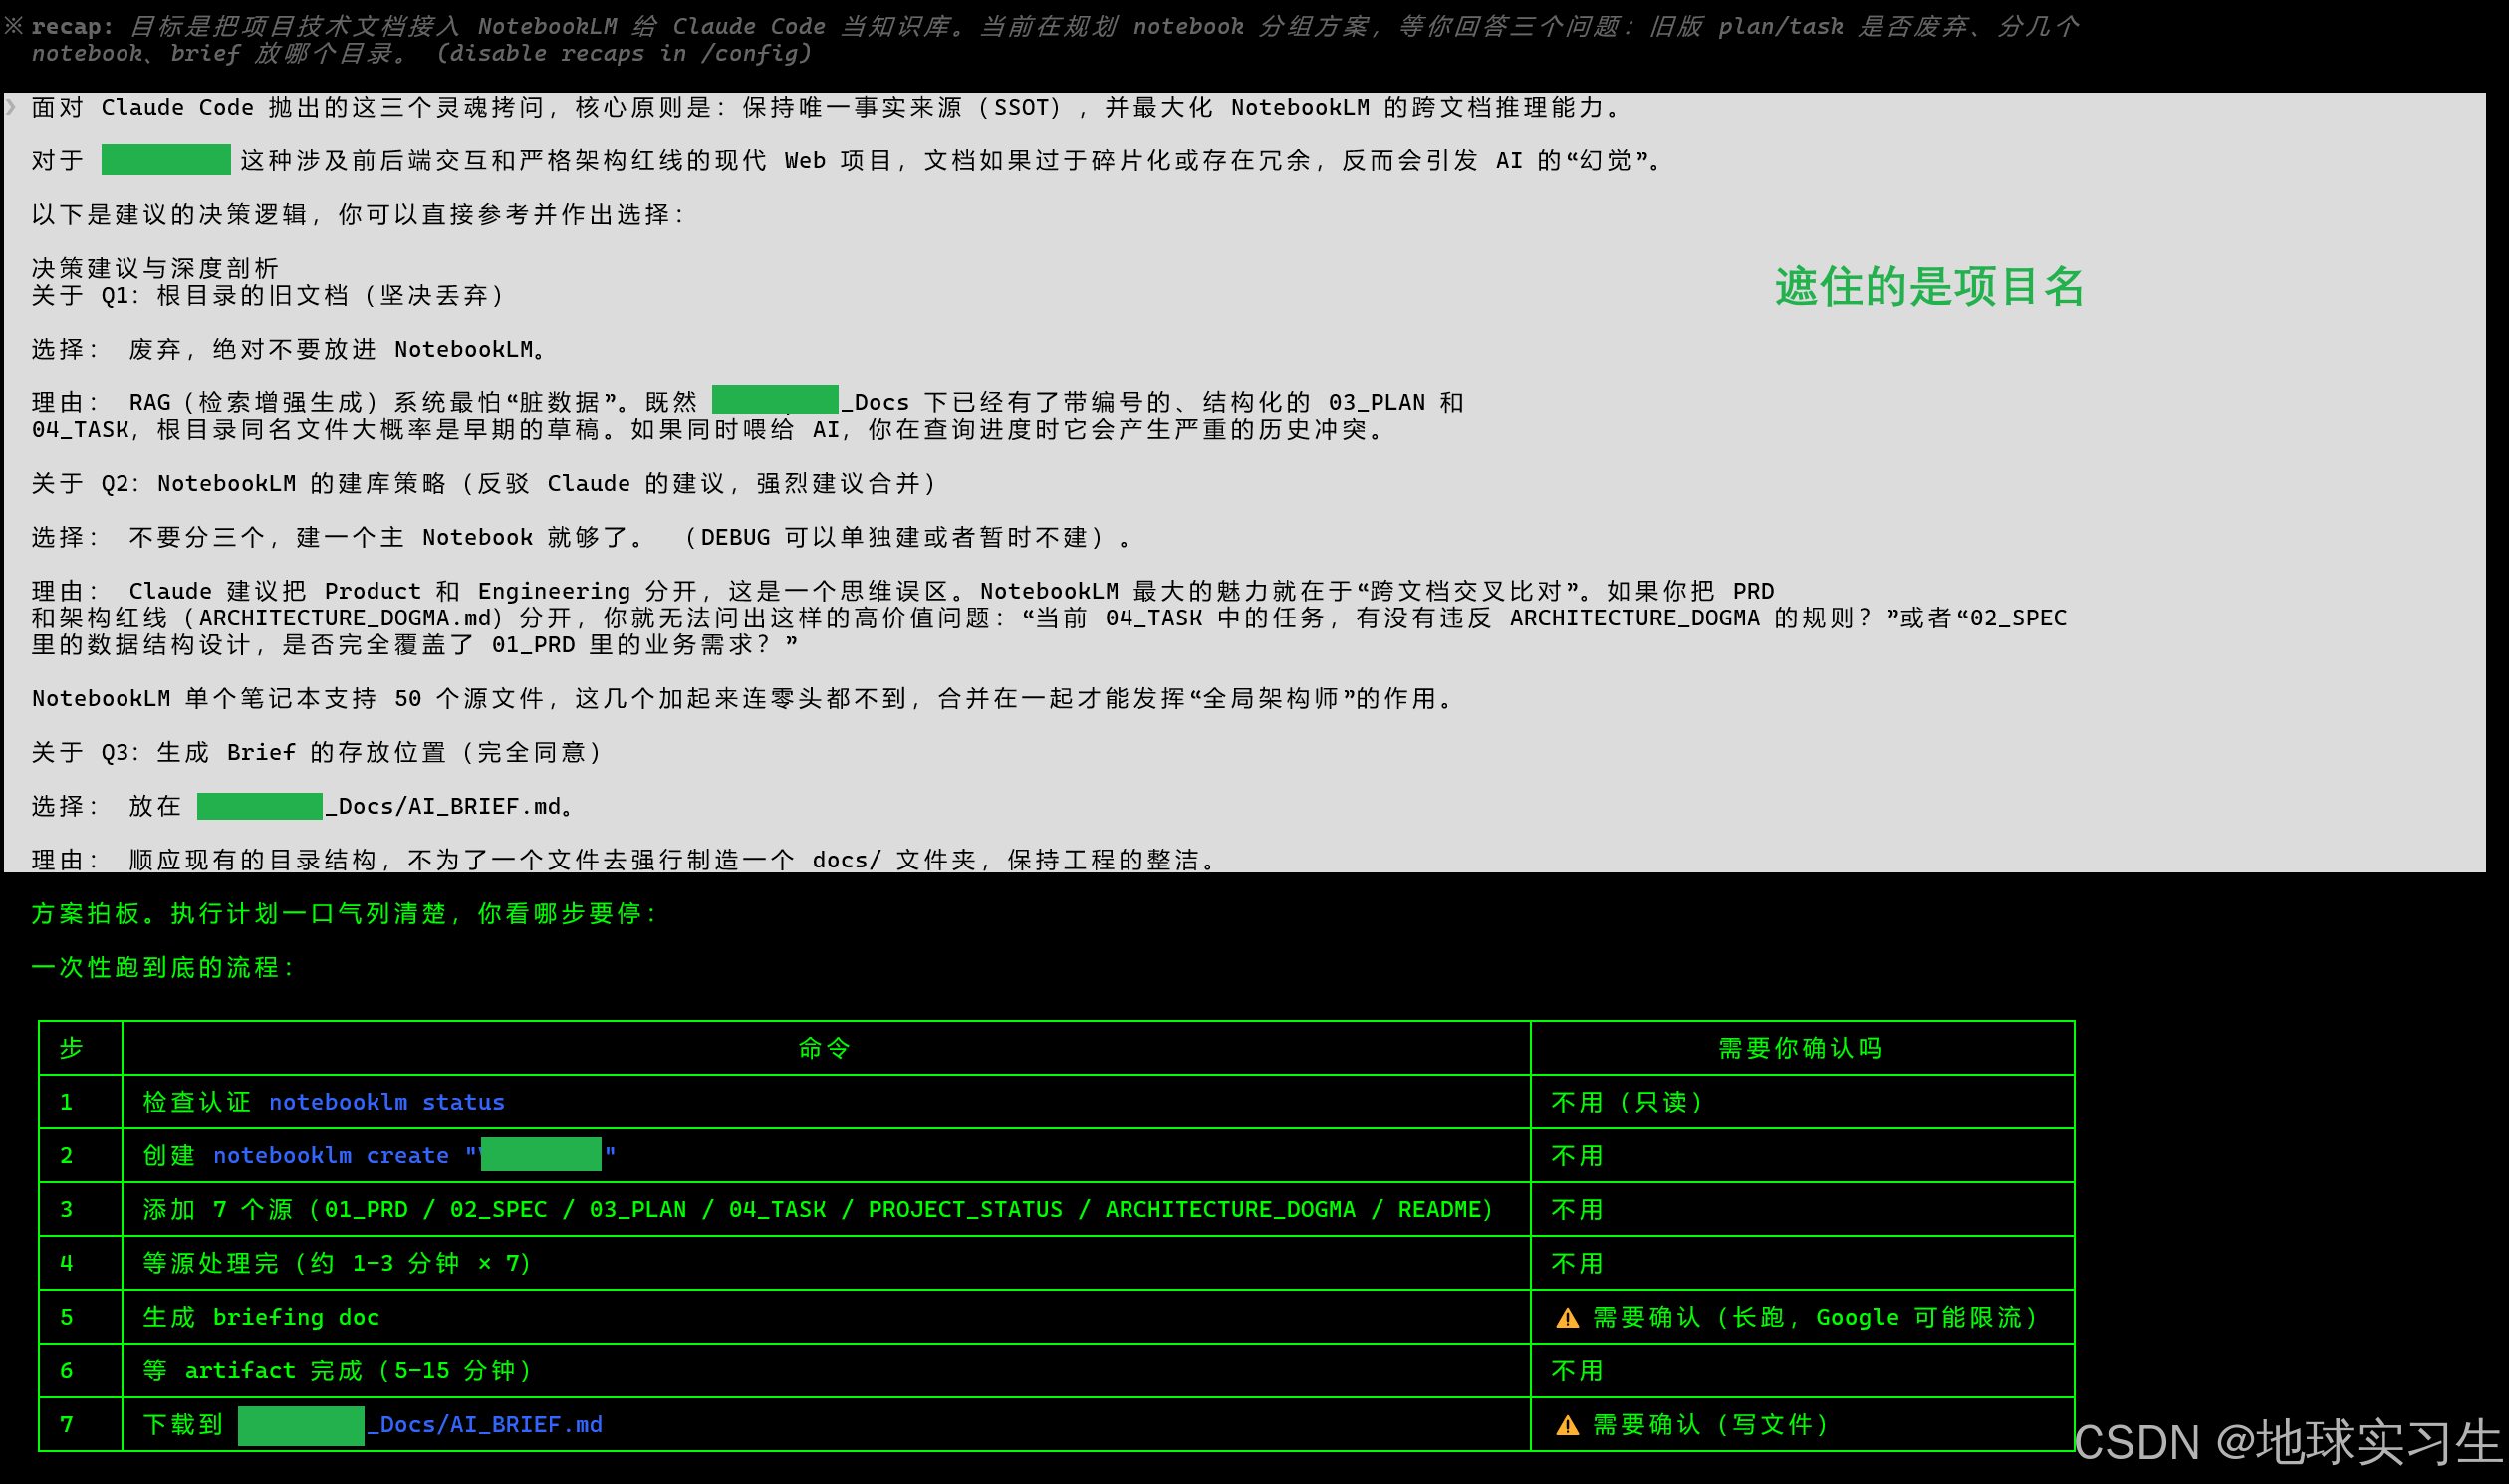
三、让 NotebookLM 开始打工:生成 AI_BRIEF
1.总的来说
Claude Code 虽然能直接读项目文档,但当文档变多之后,每次都从头读 PRD、SPEC、TASK,会消耗大量上下文。所以我们真正想要的,并不是让 Claude Code 每次都去翻原文档,而是让 NotebookLM 先把这些长文档蒸馏成一份专门给 AI 看的项目简报。这份简报就是 AI_BRIEF。这份 AI_BRIEF 不是给人写的项目介绍,而是给 Claude Code 建立全局上下文入口的。它需要覆盖业务目标、架构红线、当前进度、任务依赖这些最关键的信息,让 Claude Code 在正式改代码前,先建立一份相对稳定的项目认知。
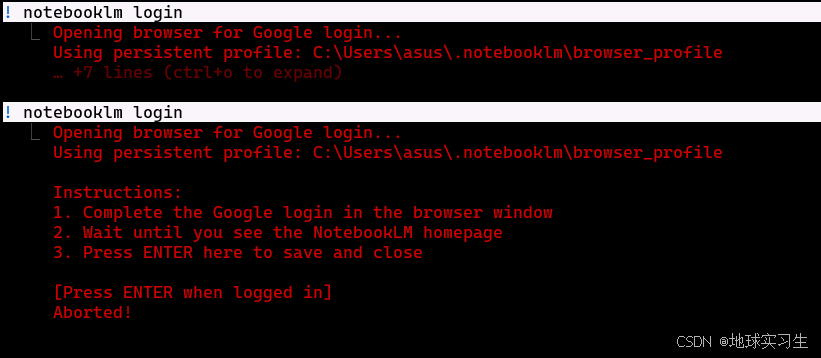
登录NotebookLM,这里不建议在原Claude Code窗口登录,而是另外开一个powershell终端登录,便于回车
2.原 Claude Code 窗口登录
在原Claude Code窗口登录:使用!notebooklm login会被ban掉,因为就算你看到了notebooklm界面,你仍然没办法回车
!notebooklm login
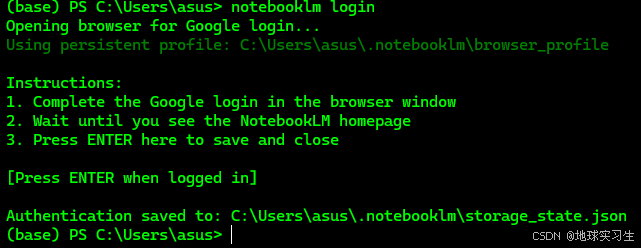
3.新 powershell 终端登录
在新powershell终端登录:使用notebooklm login,登录成功之后,记得回这个页面进行回车!!!
4. AI_BRIEF 生成
登录之后,其实这就已经让notebooklm与Claude code达成了某种协议,可以产出或者说蒸馏我们想要的这个AI_BRIEF。 登录之后,Claude code开始自动建库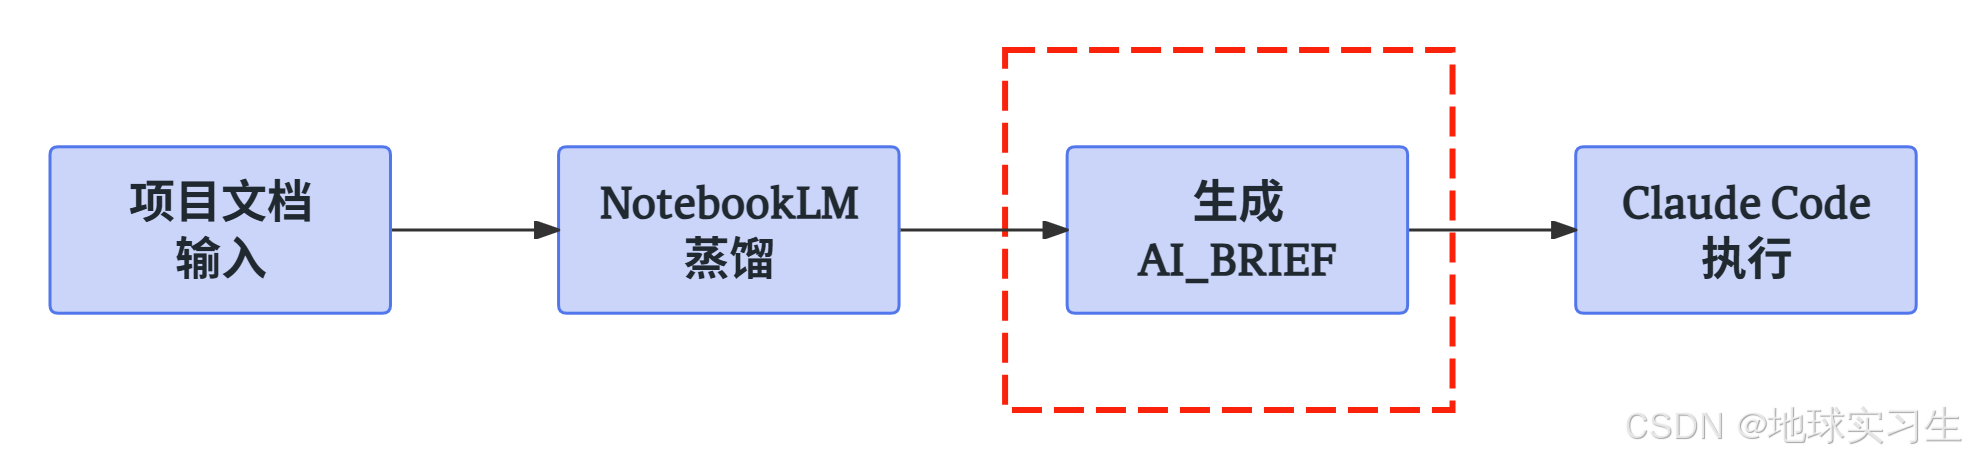
每次使用NotebookLM都要登录,我暂时还没解决这个问题,不过登录也只浪费一点时间😭
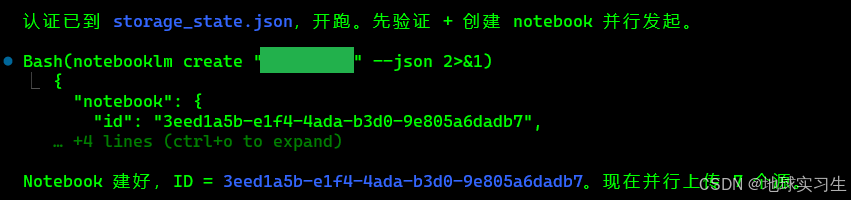
但依然会存在一些小坑,这里Claude code会自行解决,只是要与它一问一答的确认方案细节,整体比较顺畅,拿不准的方案选择可以为给其他AI chat避免让真正的骨干浪费太多Token,考虑到个人项目隐私,这里就不过多展示对话过程
不过还是要提一嘴,这部分bug主要集中在文档上传的过程:
Windows 中文环境下
notebooklmCLI 会被 GBK 编码坑到,得加PYTHONIOENCODING=utf-8;还有一种情况是 CLI 报错不一定真失败,先list --json看服务器真实状态;再比如preparing + UNKNOWN基本就是僵尸记录,要删掉重传。
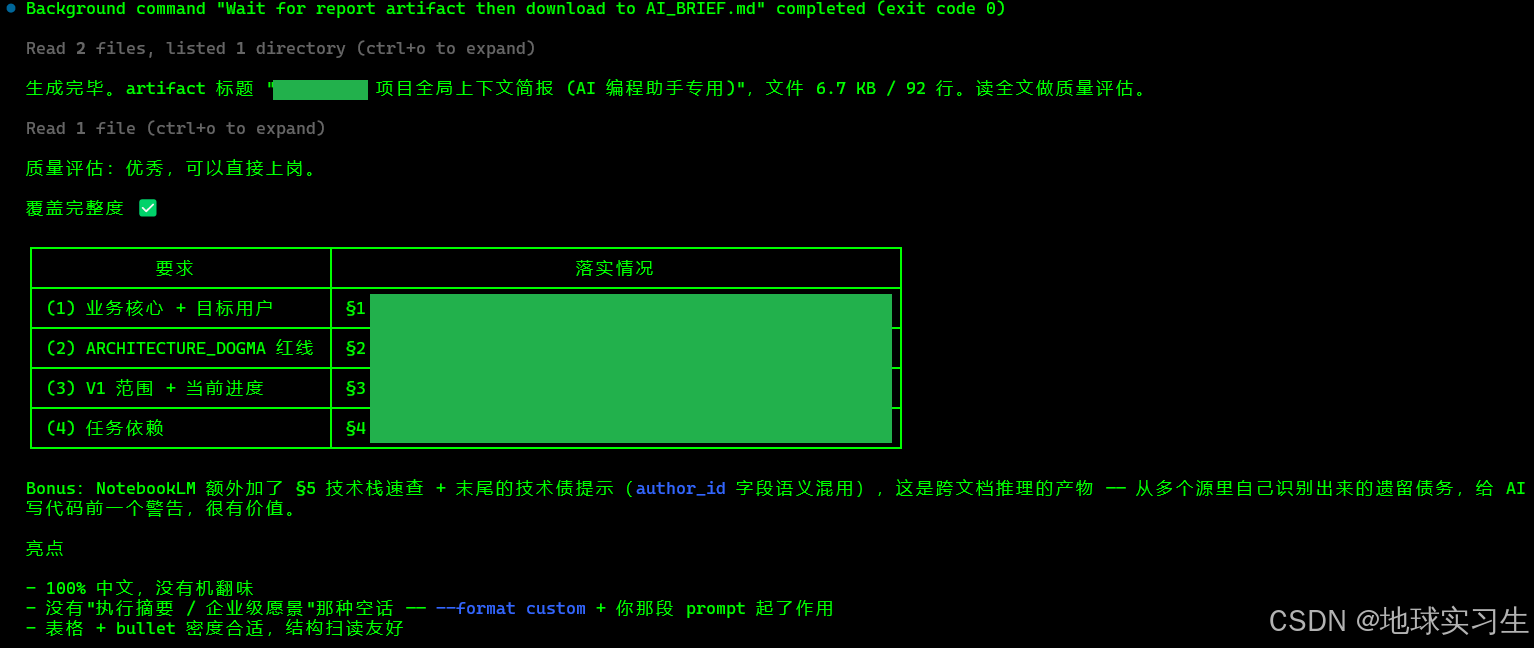
5. Claude Code 执行
直接对话,wish coding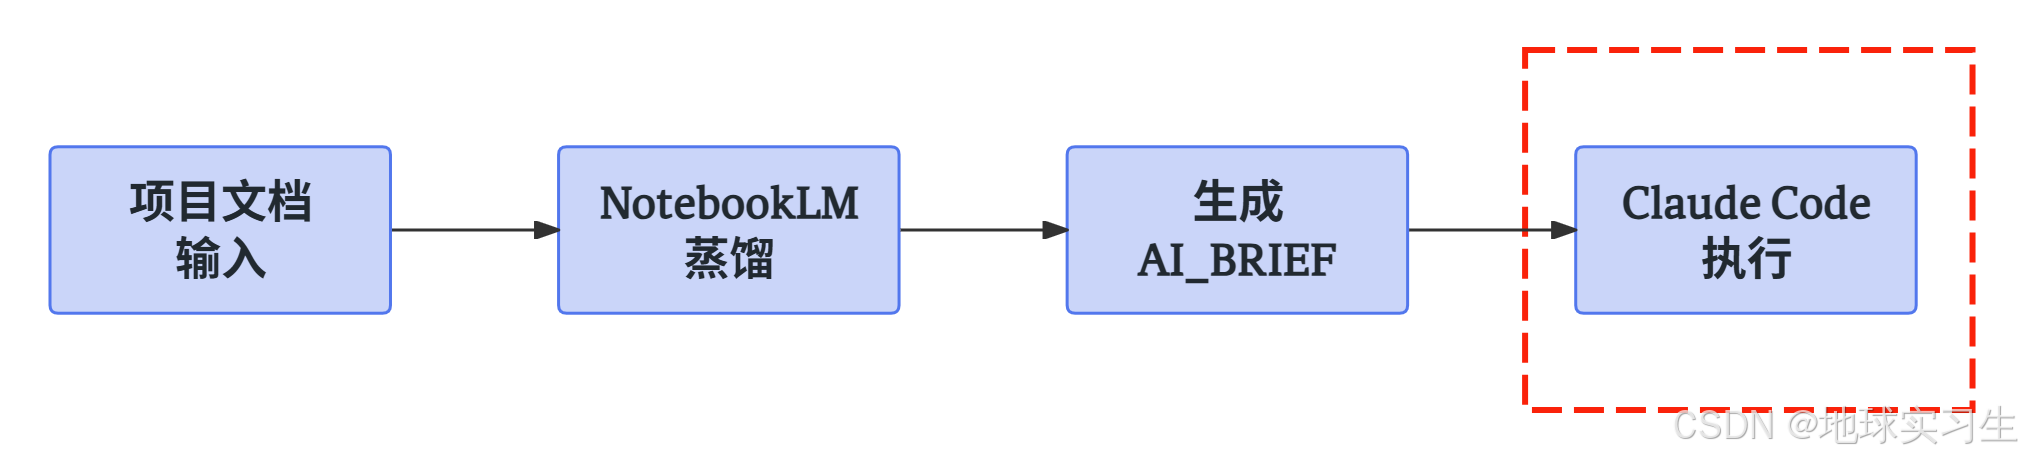
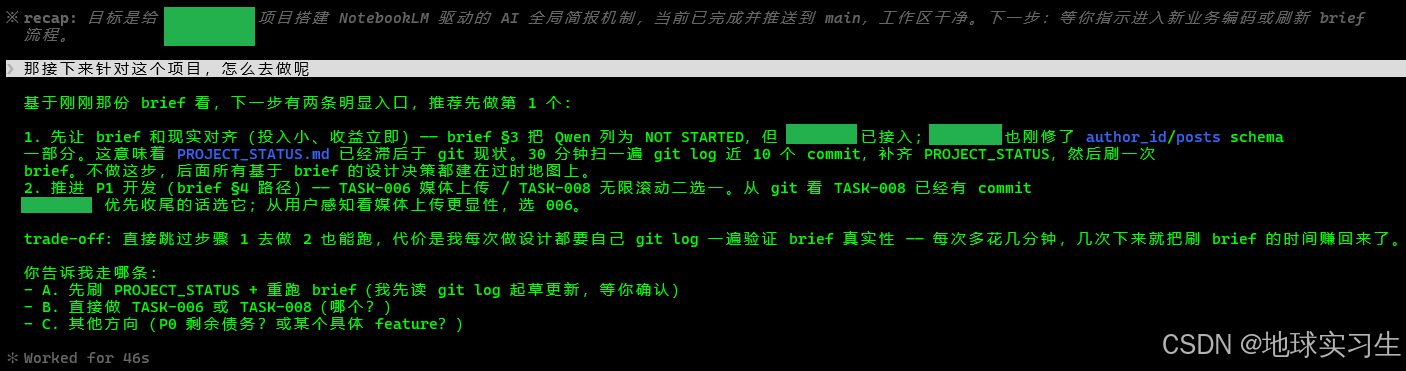
四、让这套机制长期可用
这里其实我有点虚,因为确实没做到长期那一阶段。不过,正如反脆弱里塔勒布把技术看成是一种经验,在我看来确实如此,技术不是“被证明正确的知识”,而是“被现实反复检验后还能工作的经验”。我还是要指出一下,我所做的维护和更新机制
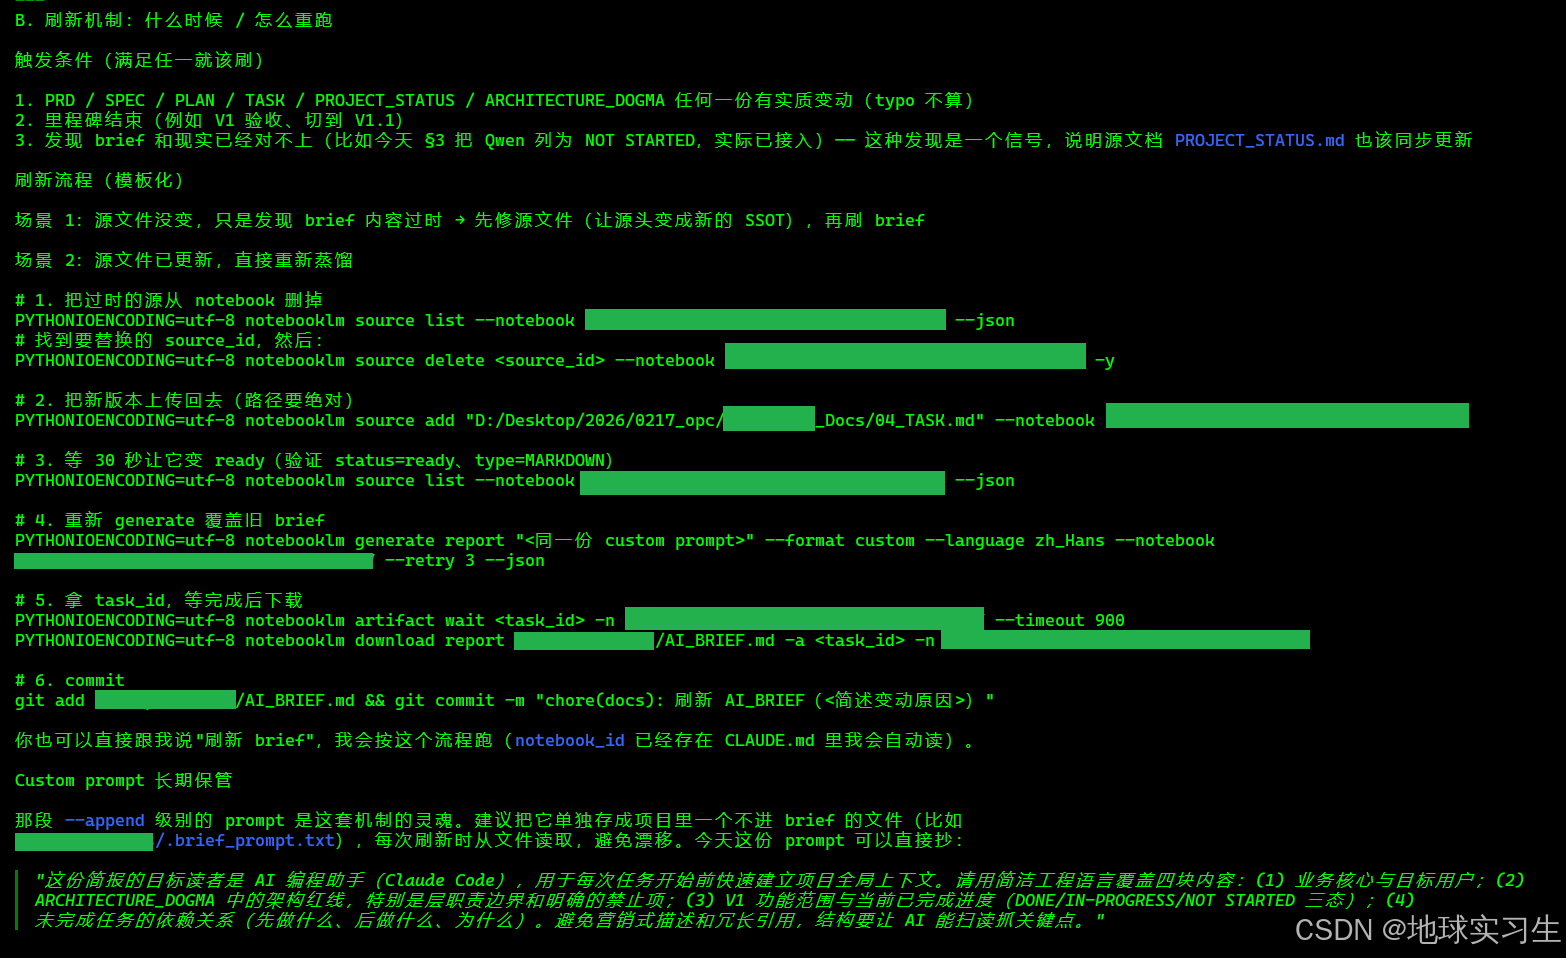
1. 源文档一变,Brief 就该刷新
AI_BRIEF 不是事实源,它只是事实源的蒸馏结果。所以真正需要维护的永远是源文档,而不是直接手改 brief。一旦源文档更新,就应该重新上传或刷新 NotebookLM 源,并重新生成AI_BRIEF。
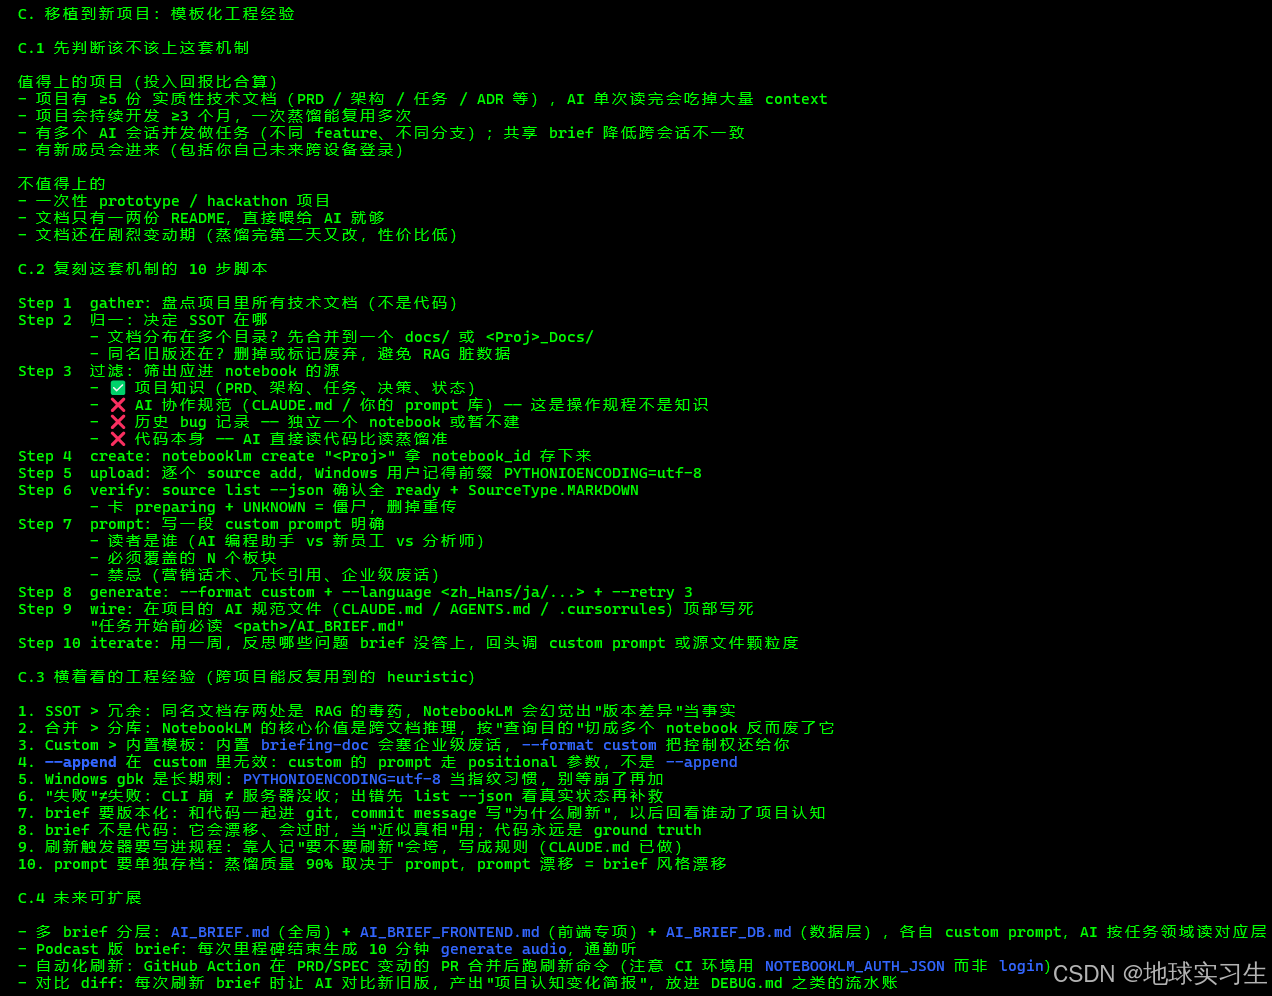
2. 如何把它迁移到别的项目里
复盘下来,我发现真正可复用的并不是某个具体命令,而是这套模式本身:
- 先筛项目文档,建立主知识库;
- 再通过自定义 prompt 生成 AI_BRIEF;
- 最后把 AI_BRIEF 接入 Claude Code 的前置流程。
这意味着以后无论是新的 Web 项目、研究原型还是个人工具项目,都可以沿用这一套思路,快速构建一个“文档蒸馏 + AI 执行”的协作闭环。到这里,NotebookLM 就不再只是一个辅助阅读工具,而是真正进入了工程链路,开始替 Claude Code 提前处理长文档上下文,承担起项目知识整理这份“脏活累活”。
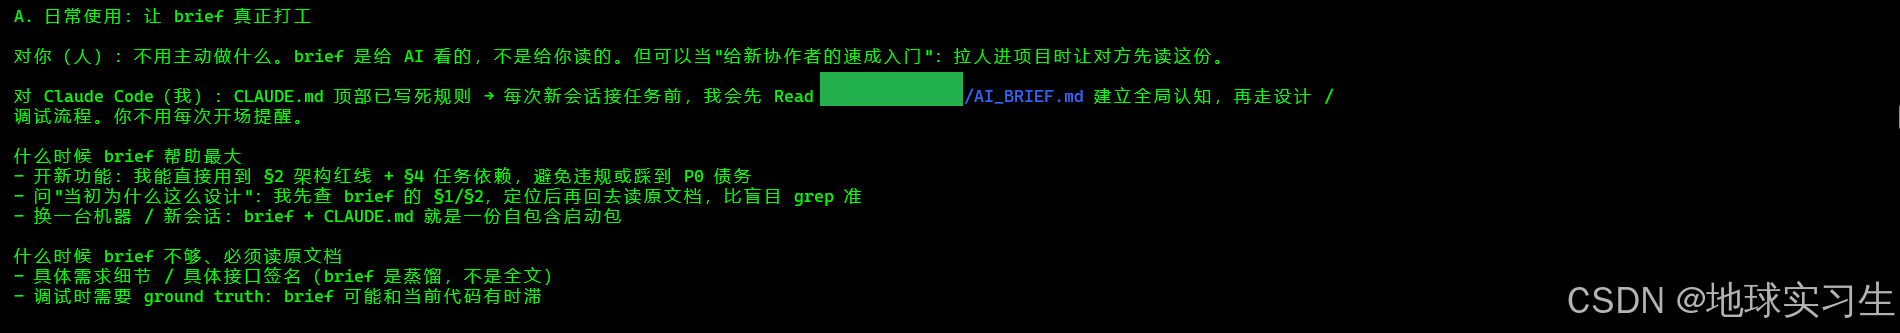
3. Claude Code的回答
我的prompt
告诉我怎么使用它、更新notebookLM、以及未来将这种机制应用别的项目里,打造成一种具备价值的工程经验
以下是他的回答,仅供参考,欢迎大家交流,下期更新GitHub上比较火的两个Claude Code skill
- Karpathy-Inspired Claude Code Skills
- Claude-Mem

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 9
 0
- 0


 已为社区贡献2条内容

所有评论(0)