SAM2跟踪总结5——疑问篇4
目录
2.1 IoU预测头(IoU Prediction Head)
2.3 超网络MLP(Output Hypernetworks MLPs)
问题3:MAE为何只处理25%可见patches?Mask Tokens如何重建75%区域?
专业理解:分布式表征(Distributed Representation)
2. SAM2 Memory Attention中的自注意力
5. 为什么输出叫"条件特征"(Conditional Features)
1. Token → Image:提示找到"可能的目标区域"
标准Cross-Attention的公式(实际SAM2的交叉注意力的key/value会将记忆的64维升维到256维,与图像的256维对齐)
核心结论:Query序列被改变,Key/Value序列不被改变
1. Token → Image Cross-Attention
2. Image → Token Cross-Attention
九、记忆要加 +4 Object Pointer Tokens,这个4是怎么来的?
1. 增强后的图像特征和Token特征:它们知道目标在哪吗?
图像特征 [B, 4096, 256] → [B, 32, 65536]
阶段1:TwoWayTransformer = "建立对应关系"
十一、token特征(B,9,256) 是一个可学习权重矩阵?
核心答案:可学习权重是输入,TwoWayTransformer输出是更新后的表示
一、前言
二、SAM2中的MLP是什么?有什么作用?
SAM2(Segment Anything Model 2)中的MLP(多层感知机)是模型架构中的关键组件,主要分布在Memory Attention和Mask Decoder等模块中。以下是详细的结构和功能解释:
1. Memory Attention中的MLP
在Memory Attention模块中,每个Transformer块包含:
自注意力(Self-attention)
交叉注意力(Cross-attention to memories)
MLP层
作用:对经过注意力机制处理后的特征进行非线性变换和特征增强,帮助模型融合当前帧特征与历史记忆特征。
2. Mask Decoder中的MLP
SAM2的Mask Decoder包含多个专门的MLP头,这是其最核心的MLP应用:
2.1 IoU预测头(IoU Prediction Head)
结构:多层MLP(通常是3层,使用ReLU激活)
输入:IoU token的输出特征(256维)
输出:预测的IoU分数(0-1之间),表示掩码质量的置信度
作用:让模型评估自己生成的分割掩码与真实目标的匹配程度,帮助用户选择最佳掩码
2.2 遮挡预测头(Occlusion Head)
这是SAM2相比SAM1新增的重要组件:
结构:独立的MLP层
输入:专门的object token(与mask token、IoU token并列)
输出:objectness分数(logits),判断当前帧中目标物体是否存在(是否被遮挡)
作用:处理视频中的遮挡情况。当物体被遮挡或移出画面时,分数会显示为负值,模型会结合记忆信息维持跟踪
2.3 超网络MLP(Output Hypernetworks MLPs)
这是SAM系列的核心创新机制:
结构:为每个mask token配备一个独立的3层MLP
输入:transformer输出的mask token(256维)
输出:32维的"超向量"(动态卷积核权重)
作用:
动态生成掩码头参数:不使用权值固定的卷积层,而是根据输入提示动态生成掩码分类器的权重
实现"一个模型,多个动态头部",适应不同提示的歧义性(如单点提示可能对应多个物体)
输出的32维向量分为三段:前8维编码前景强度,中间16维编码空间位置(上/下/左/右),后8维编码边缘细节
2.4 Object Pointer MLP
作用:将mask token(256维)映射为object pointer(物体指针)
用途:生成的object pointer存入Memory Bank,作为高层次的语义记忆向量,用于后续帧的交叉注意力检索
3. TwoWayTransformer中的标准MLP
在双向Transformer块内:
Python
复制
# 标准结构
self.mlp = MLPBlock(embedding_dim, mlp_dim, activation=GELU)
位置:位于token-to-image交叉注意力之后
作用:对token特征进行通道-wise的非线性变换,增强模型对提示语义的理解能力,并通过残差连接(Skip Connection)与原始特征相加
MLP的核心功能总结
表格
模块 MLP类型 核心功能 Memory Attention 标准前馈MLP 特征变换,融合记忆信息 IoU Head 3层MLP 预测掩码质量分数 Occlusion Head 3层MLP 预测物体是否存在(遮挡检测) Hypernetwork MLPs 动态参数生成 为每个mask生成专属的分割头权重 Object Pointer 投影MLP 生成记忆库中的语义指针 这些MLP共同支持了SAM2在视频分割中的实时性、遮挡处理能力和多掩码歧义消解能力。
三、图像编码器的架构及其与MAE、ViT的关系
SAM2中图像编码器的trunk和neck是什么?它跟MAE有什么关系?MAE又跟ViT有什么关系,图像编码器使得图像的每个像素点包含上下文信息,从图像整体上看是已经知道图像中有哪些前景的形状了吗?
1. SAM2图像编码器的Trunk和Neck结构
SAM2使用Hiera(Hierarchical Vision Transformer)作为图像编码器,采用经典的Trunk-Neck架构设计:
Trunk(主干网络)
架构:纯Transformer构成的分层编码器,包含4个阶段(Stages)
阶段配置(以Hiera-B+为例):
Stage 1: 112通道,2个block,stride 4
Stage 2: 224通道,3个block,stride 8
Stage 3: 448通道,16个block,stride 16(全局注意力)
Stage 4: 986通道,3个block,stride 32(全局注意力)
注意力机制:前两个阶段使用局部注意力(Local Attention),后两个阶段使用全局注意力(Global Attention)
Neck(特征融合颈部)
结构:采用Feature Pyramid Network (FPN) 架构
输入:融合Stage 3(stride 16)和Stage 4(stride 32)的特征
输出:生成最终的图像嵌入(Image Embeddings)
增强机制:Stage 1和Stage 2的低层特征(stride 4/8)通过skip connection送入Mask Decoder,辅助上采样层恢复细节
输入图像 (1024×1024)
    ↓
[Hiera Trunk]
    ↓
Stage1(stride4) ────────┐
Stage2(stride8) ────────┤→ 送入Mask Decoder辅助上采样
Stage3(stride16) ──┐    │
Stage4(stride32) ──┼─→ [FPN Neck] → 图像嵌入(64×64×256)
                   │
            全局注意力层
2. 与MAE的关系:预训练方式
SAM2图像编码器与MAE的关系是预训练初始化的关系:
MAE(Masked Autoencoder)是一种自监督预训练方法,而非架构
SAM2的Hiera编码器使用MAE预训练的权重进行初始化
预训练策略:在ImageNet等大规模图像数据集上,通过随机遮盖75%的图像块(patches),训练模型从剩余25%的可见块重建完整图像
这种预训练迫使编码器学习强大的空间上下文理解能力和视觉表征
3. MAE与ViT的关系:架构与方法的结合
MAE和ViT的关系是方法(Method)与架构(Architecture)的关系:
表格
组件 角色 说明 ViT 基础架构 将图像分割为patch,通过Transformer blocks处理 MAE 预训练方法 使用ViT作为编码器,配合轻量级解码器进行自监督学习 关系 组合 MAE必须使用ViT作为骨干网络,通过"遮盖-重建"任务学习特征 关键机制:
MAE采用不对称编码器-解码器设计:编码器是标准ViT(大),解码器是轻量级ViT(小,通常只有8层)
仅将未遮盖的patches(25%)送入编码器,大幅降低计算量
解码器通过可学习的mask tokens重建被遮盖的75%区域
4. 图像编码器是否"知道"前景形状?
这是一个关于特征表征本质的深层问题,需要分层理解:
局部层面:像素级上下文聚合
编码器输出的每个特征向量(对应原图16×16或32×32区域)确实包含上下文信息
通过自注意力机制,每个位置"看到"了图像其他区域的信息
但这种信息是隐式的、分布式的特征编码,不是显式的"知道这里有猫/狗"
全局层面:形状感知的局限性
编码器本身不进行分割决策:它只是提取通用视觉特征(边缘、纹理、语义模式)
没有显式前景形状:编码器输出的是特征图,不是分割掩码
形状感知发生在Decoder:只有当Prompt Encoder提供点/框提示后,Mask Decoder才结合图像特征生成具体的分割轮廓
MAE预训练的影响
MAE预训练让编码器具备强大的空间结构理解能力
通过重建被遮盖区域,编码器学会了推断遮挡背后的内容和物体边界
因此,虽然编码器不直接"知道"前景形状,但它编码的特征蕴含了可用于分割的丰富几何和语义信息
关键区分
图像编码器输出: 高级语义特征向量 (如: 256维向量表示"可能是猫耳朵的区域") ↓ Mask Decoder + 用户提示: 生成分割掩码 (显式轮廓: "这是猫的边界")总结:SAM2的图像编码器通过Hiera架构提取多尺度特征,经MAE预训练获得强大的视觉表征能力,但它只是特征提取器,不直接输出或知晓前景形状。形状的分割是在Mask Decoder中,结合用户提示和图像特征后完成的。
四、MAE、图像编码器与自注意力
对于3. MAE与ViT的关系:架构与方法的结合:为什么可以仅将未遮盖的patches(25%)送入编码器,大幅降低计算量?解码器通过可学习的mask tokens重建被遮盖的75%区域是啥意思?为什么? 对于4. 图像编码器是否"知道"前景形状:这种信息是隐式的、分布式的特征编码,不是显式的"知道这里有猫/狗",如何专业理解?又如何通俗理解?是不是说特征图里面的每个像素点包含了几何和语义信息,这些信息是基于这个像素点的上下文得出的,然而实际需要自注意力机制才能让每个像素点进行沟通,但是自注意力机制之后得到了什么呢?沟通之后是否已经初步知道这里有猫/狗了呢,那里有天空了呢? 还有“通过自注意力机制,每个位置"看到"了图像其他区域的信息”,这个注意力机制是指mask attention在交叉注意力之前的执行的自注意力吗?
问题3:MAE为何只处理25%可见patches?Mask Tokens如何重建75%区域?
为什么只送25%进编码器?
这是MAE的不对称设计核心,计算量降低的关键在于Transformer的二次复杂度:
复杂度公式:自注意力计算量为 O(N2⋅D) ,其中 N 是token数量,D 是维度
实际计算:假设图像分成196个patches(14×14)
标准ViT:处理全部196个 → 计算量 1962=38,416
MAE编码器:只处理49个可见patches(25%)→ 计算量 492=2,401
降低16倍计算量!
图像 (224×224)
    ↓ 分块 (16×16 patch)
196个patches [p1][p2][p3]...[p196]
    ↓ 随机遮盖75%
可见25%: [p2][p5][p8]... (49个) ──→ [Encoder: 12层Transformer] ──→ 特征向量 (49×768)
遮盖75%: [MASK][MASK]... (147个) ──→ 不参与编码!
Mask Tokens是什么?如何重建?
这是MAE的解码器机制:
概念 解释 Mask Token 一个可学习的向量(learnable embedding),不是图像内容,类似BERT的[MASK]标记 作用 作为"占位符",告诉解码器"这里需要重建一个patch" 重建过程 解码器通过交叉注意力,让mask token去"查询"编码器输出的可见patch特征,推断被遮盖区域的内容 具体流程:
# 1. 编码器只处理可见patches visible_features = encoder(visible_patches) # [49, 768] # 2. 构建解码器输入:可见特征 + Mask Tokens mask_tokens = repeat(learnable_mask_token, 'd -> n d', n=147) # [147, 768] decoder_input = concat([visible_features, mask_tokens]) # [196, 768] # 加上位置编码,恢复原始空间顺序 # 3. 解码器通过自注意力让mask tokens与visible tokens交互 full_features = decoder(decoder_input) # [196, 768] # 4. 投影回像素空间 reconstructed_pixels = head(full_features) # [196, 768] -> [196, 3×16×16]关键洞察:CrossMAE研究发现,mask token之间的自注意力其实不是必须的(注意力值仅0.39 vs 对可见token的注意力1.42),重建主要依赖编码器学到的全局表征而非解码器的patch间交互。
问题4:特征编码的"隐式知识"如何理解?
专业理解:分布式表征(Distributed Representation)
这是深度学习的基础概念,区别于符号化表征(Symbolic Representation):
表征类型 特点 类比 显式/符号化 离散、可解释、局部编码 "这是猫"(one-hot标签) 隐式/分布式 连续、不可直接解释、密集编码 256维向量,每个维度都参与表示"猫性" 关键机制:
每个特征维度都是"多语义"的:一个数值可能同时编码"毛茸茸"、"有耳朵"、"四条腿"等多种属性
概念通过模式叠加:"猫"不是某个神经元,而是特定256维向量的整体模式
上下文依赖:同一像素位置,在"猫在草地上"和"猫在沙发上"场景下,特征向量不同
通俗理解:像"气味指纹"而非"标签"
想象识别一杯咖啡:
显式知识:标签写着"拿铁咖啡"(离散符号)
隐式知识:你闻到的气味混合物——有奶香、咖啡苦、微甜,但没有哪个分子叫"拿铁"
每个气味分子(特征维度)都携带多种信息
只有组合起来才能识别"这是拿铁"
换个比例,可能就是卡布奇诺
图像编码器同理:
它输出的不是"这里有猫"的标签
而是"毛茸茸纹理 + 三角形耳朵形状 + 胡须纹理 + ..."的连续数值混合
这些数值本身不直接对应语义,但它们的组合模式可以被下游Decoder解读为"猫"
自注意力"沟通"后得到了什么?
不是"初步知道有猫",而是"建立了关联的证据图谱":
输入:图像patches(每个16×16像素区域) ↓ 初始状态:每个patch独立,只知道"我这有边缘/纹理/颜色" ↓ 自注意力层(多层堆叠): 第1层:局部关联 "我的边缘和旁边patch的边缘连续" 第2层:区域聚合 "这些连续边缘组成一个圆形" 第3层:语义涌现 "圆形+毛茸茸+有眼睛 → 可能是生物" ... 第12层:全局整合 "这是猫,它在沙发上,背景是窗户" ↓ 输出:每个位置的特征向量包含: - 局部外观信息(保留细节) + 全局位置信息(我在猫的耳朵上) + 语义上下文信息(周围是猫头,下面是猫身体)关键区分:
编码器:构建通用视觉表征(generic visual representation),适合各种下游任务
Decoder:执行特定任务(如分割),将通用表征转化为具体输出(掩码轮廓)
编码器不会"决定"这是猫,它只是准备好了一个丰富的特征空间,使得Decoder在给定提示(如"分割这个点")时,能够快速定位并分割出猫。
关于注意力机制的澄清
你问得很精准!需要区分两个不同的自注意力:
1. MAE编码器中的自注意力
位置:MAE的ViT编码器内部(SAM2的Hiera Trunk)
作用:让可见patches之间互相沟通,建立全局上下文
特点:只处理25%的patches,但通过这些patches推断全局结构
2. SAM2 Memory Attention中的自注意力
位置:Memory Attention模块(在Prompt Encoder和Mask Decoder之间)
作用:让当前帧特征与历史记忆特征融合
流程:
自注意力:当前帧token之间先互相沟通("我注意到这里有物体边缘")
交叉注意力:再与Memory Bank中的历史帧特征交互("这个边缘和上一帧的猫耳朵匹配")
3. Mask Decoder中的自注意力
位置:TwoWayTransformer内部
作用:让提示token(点/框)与图像token双向沟通
你提到的"mask attention在交叉注意力之前的自注意力",指的是Memory Attention模块的设计:
Memory Attention Layer:
    ├─ Self-Attention: 当前帧token之间先沟通
    ├─ Cross-Attention: 再与历史记忆沟通
    └─ MLP: 特征变换
这种分层注意力设计让SAM2能够:
先理解当前帧局部结构(自注意力)
再结合时序一致性(交叉注意力到memory)
最终生成分割掩码(送入Mask Decoder)
总结
问题 核心答案 MAE为何高效 编码器只处理25%patches,利用Transformer的 O(N2) 特性大幅降低计算 Mask Tokens 可学习的占位符,解码器通过它们"查询"可见特征重建被遮盖区域 隐式知识 分布式表征,像"气味指纹"而非"标签",需要Decoder解读 自注意力后 建立了全局关联,但未做语义决策,只是准备了可被Decoder使用的丰富特征 注意力类型 SAM2中有多个自注意力层,Memory Attention中的自注意力发生在与历史记忆交叉注意力之前
五、memory attention
SAM2的memory attention的交叉注意力是不是可以理解为用当前帧的图像特征去查询过去的记忆,这个过去的记忆比如说记忆池有6帧,那是每帧都存64维的记忆向量吗(不对,是64维的64x64分辨率的图像,即一帧记忆存的是[B, 64, 64, 64]展平成 [B, 4096, 64],6帧记忆可能是[B, 6x4096, 64],但是可能还要加4个用于记忆对象特征的token,即[B, 6x4096+4, 64],后续我得调试确认一下这个事),那交叉注意力是怎么做的呢?能列出维度是怎么相乘的吗?是跟每帧计算相似度吗?相当于我根据现在看到的画面去搜索记忆的画面中有没有出现过跟现在的画面最相似的地方是不是?但是据我所知,每一帧的记忆是由图像特征和掩码特征融合然后压缩到64维,如何理解用现在的图像特征去查询过去的“图像特征和掩码特征融合”这件事?还有就是为什么memory attention输出的叫做“条件特征”?
1. Memory Attention的基本理解
你的理解基本正确:Memory Attention确实是用当前帧的图像特征去查询过去的记忆。但这里的"查询"不是简单的图像相似度匹配,而是一个更复杂的条件化过程。
根据SAM 2论文,Memory Attention的作用是:
"condition the current frame features on the past frames features and predictions as well as on any new prompts"
2. 记忆的存储结构
关于记忆池的维度,需要澄清一点:记忆不是简单的64维向量,而是空间特征图(spatial feature maps)。
根据SAM 2架构描述:
图像编码器输出:
256 × 64 × 64的特征图(256通道,64×64空间分辨率)Memory Encoder将图像特征和掩码特征融合后,会压缩到64维(这是通道维度,不是整体维度)
最终存储在Memory Bank中的是空间特征图,维度为
64 × H' × W'具体计算流程:
1. 掩码下采样 → 与图像编码器输出融合(逐元素相加) 2. 通过轻量级卷积层融合信息 3. 输出投影到64通道所以"64维"指的是每个空间位置的通道维度,而不是整体向量的维度。
3. Memory Attention的维度计算
Memory Attention使用标准的Transformer Cross-Attention机制。维度计算如下:
假设:
当前帧图像特征(来自Image Encoder):
[B, 256, H, W]→ 展平为[B, N_curr, 256],其中N_curr = H × W记忆特征(来自Memory Bank):
[B, N_mem, 64],其中N_mem是记忆帧数 × 每帧空间位置数Object Pointer Tokens:
[B, N_ptr, D](轻量级语义向量)注意:论文提到Memory Attention会将维度从256降到128以对齐某些实现,但原始SAM 2中图像编码器输出256维,记忆编码器输出64维。
Cross-Attention计算:
Q = W^Q × Current_Frame_Features → [B, N_curr, d_k] K = W^K × Memory_Features → [B, N_mem, d_k] V = W^V × Memory_Features → [B, N_mem, d_k] Attention = softmax(Q × K^T / √d_k) × V → [B, N_curr, d_k]关键:不是"跟每帧计算相似度",而是当前帧的每个空间位置与记忆中所有空间位置计算注意力。这相当于"我现在看到的每个像素/区域,去搜索记忆中哪里出现过相似的像素/区域"。
4. 图像特征查询"图像+掩码融合特征"的理解
你的困惑很合理。这确实是一个不对称的设计:
组件 内容 作用 Query 当前帧纯图像特征(256维) "我现在看到了什么" Key/Value 历史帧的图像+掩码融合特征(64维) "过去在哪里看到了目标物体" 这种设计的关键在于:
查询侧(当前帧):只需要知道"我现在看到了什么",不需要掩码信息,因为当前帧的掩码还没预测出来
记忆侧(历史帧):存储的是"图像中哪里出现了目标物体"(通过掩码编码),这样当前帧可以定位到目标在记忆中的位置
维度对齐:通过投影矩阵
W^Q,W^K,W^V将不同维度的特征映射到相同的注意力空间d_k这类似于检索系统:你用当前的观察(Query)去检索历史记录(KV),历史记录中包含了"当时看到了什么+目标在哪里"的完整信息。
5. 为什么输出叫"条件特征"(Conditional Features)
输出被称为条件特征(Memory-Conditioned Features),原因在于:
"The mask decoder takes memory-conditioned image embeddings from the memory attention layer"
"条件"(Conditioned)的含义:
统计意义上的条件概率:特征分布被历史记忆所条件化,即
P(Feature|Memory)而非P(Feature)信息融合:原始图像特征通过Cross-Attention被"调制"(modulated)了:
如果记忆中显示目标在左上方,当前帧左上方区域的特征会被增强
这相当于将历史跟踪信息"注入"到当前帧特征中
与SAM的区别:SAM直接从Image Encoder输出到Mask Decoder;SAM 2则必须经过Memory Attention的条件化,使特征包含时序一致性信息
功能意义:这些特征现在不仅代表"当前帧的内容",还代表"在当前帧中继续跟踪目标所需的内容"——即被跟踪任务条件化的特征
总结表格
问题 答案 记忆存储 空间特征图 64 × H' × W',不是单纯64维向量注意力计算 当前帧所有位置 ↔ 记忆中所有位置的全连接注意力 查询-记忆不对称 Query是纯图像,KV是图像+掩码融合,通过投影对齐 "条件"含义 特征被历史记忆调制,包含时序跟踪信息 这种设计让SAM 2能够在保持实时性的同时,有效利用历史信息维持目标跟踪的时序一致性。
六、memory attention的维度变化
源码中的memory attention是怎么做的?维度变化是怎样?据我所知记忆好像是[B, 64, 64, 64] → [4096, B, 64],但是我不确定这是不是指一帧的记忆,如果记忆6帧的话,是咋样的维度,然后据我所知图像特征是[4096, B, 256]作为query,交叉注意力是怎么维度变化的。
Memory Attention 完整维度变化流程
1. 输入阶段(进入Memory Attention前)
来源 维度 说明 当前帧图像特征(Image Encoder输出) [B, 256, 64, 64]256通道,64×64空间分辨率 当前帧flatten后(作为Query) [B, 4096, 256]4096 = 64×64 6帧记忆(Memory Encoder输出) [B, 24576, 64]24576 = 64×64×6,每帧64通道 +4 Object Pointer Tokens [B, 4, 64]轻量级语义摘要token 记忆总维度(Key/Value来源) [B, 24580, 64]24580 = 4096×6 + 4
2. Cross Attention 内部维度变换
在
RoPEAttention中(num_heads=1):# 输入 query: [B, 4096, 256] # 当前帧图像特征 key: [B, 24580, 64] # 6帧记忆 + 4个object pointers value: [B, 24580, 64] # 同上投影层对齐维度:
投影矩阵 输入维度 输出维度 作用 W_q[256, 256][B, 4096, 256]Query保持256维 W_k[64, 256][B, 24580, 256]Key从64升到256 W_v[64, 256][B, 24580, 256]Value从64升到256 Attention计算:
# Q·K^T
scores = [B, 4096, 256] @ [B, 256, 24580]
       = [B, 4096, 24580]          # 注意力矩阵

# Softmax
attn_weights = softmax(scores / sqrt(256))  # [B, 4096, 24580]

# 加权求和
output = [B, 4096, 24580] @ [B, 24580, 256]
       = [B, 4096, 256]            # 条件化特征
3. 维度变化总结图
当前帧图像特征:          6帧记忆 + Object Pointers:
[B, 256, 64, 64]        [B, 6, 64, 64, 64]  (Memory Bank存储)
    ↓ flatten               ↓ flatten + concat
[B, 4096, 256]          [B, 24576, 64]
    │                       ↓ cat 4 obj_ptrs
    │                   [B, 24580, 64]
    │                       │
    │                       ↓ W_k, W_v 投影
    │                   [B, 24580, 256]
    ↓ W_q 投影              │
[B, 4096, 256] ←──────→ [B, 24580, 256]
    │                       │
    └────── Cross Attention ──┘
              ↓
    [B, 4096, 24580]  (Attention Map)
              ↓
    [B, 4096, 256]    (Memory-Conditioned Features)
              ↓
    Mask Decoder (预测当前帧掩码)
4. Attention Map的物理意义
[B, 4096, 24580]这个注意力矩阵的含义:
维度 物理意义 4096 当前帧的64×64个空间位置(Query位置) 24580 记忆中所有"参考位置"(Key位置) 24576 6帧历史帧的64×64空间位置 +4 4个Object Pointer Tokens(全局语义摘要) 每行表示:当前帧的某个像素/区域,去"查询"记忆中24580个位置,找出哪里最相似。这实现了用当前画面搜索历史画面的机制。
5. 为什么记忆是64维而图像是256维?
组件 维度 原因 图像特征 256维 Image Encoder需要丰富语义表示 记忆特征 64维 Memory Encoder压缩存储,节省Memory Bank空间 交叉注意力 统一256维 通过投影层对齐,让不同来源特征可比较 这种不对称设计(256→64→256)的trade-off:
存储效率:6帧记忆只需存
24576×64参数,而非24576×256计算开销:投影层轻量,Attention计算在统一空间进行
信息保真:Object Pointer Tokens(4个token)补偿压缩损失
为什么叫"条件特征"?
输出被称为Memory-Conditioned Features的原因是:
条件化(Conditioning)的数学含义:
原始图像特征
F_curr是无条件的:只包含"当前帧有什么"经过Memory Attention后
F_cond = P(F_curr | Memory)是有条件的:包含"在当前帧中,基于历史记忆,目标物体应该在哪里"注意力机制的本质:
每个当前帧位置的输出 = 加权求和的历史记忆特征
权重由当前帧与记忆的相似度决定(即"查询"结果)
这相当于将历史跟踪信息注入到当前帧特征中
与SAM的区别:
SAM:Image Encoder → Mask Decoder(单帧)
SAM2:Image Encoder → Memory Attention → Mask Decoder(时序条件化)
七、TwoWayTransformer
SAM2中解码器中的TwoWayTransformer经历了自注意力、token->image的交叉注意力,image->token的交叉注意力,最后又token->image的交叉注意力,我理解提示需要去查询图像中有什么,但为什么图像也要告诉提示哪里被查询了?最后又为什么提示又要去查一下图像? 这不符合直觉,直觉是提示查一次图像不就能映射到图像中的目标吗?
TwoWayTransformer的完整流程
根据SAM2源码和架构解析,TwoWayTransformer每层包含:
1. Token Self-Attention (Token之间交换信息) 2. Token → Image Cross-Attention (Token查询图像) 3. MLP (Token特征变换) 4. Image → Token Cross-Attention (图像查询Token)注意:SAM2的Mask Decoder在TwoWayTransformer之后还有一个额外的Token → Image Cross-Attention,但核心的双向设计在前两步。
为什么需要"图像告诉提示哪里被查询了"?
你的直觉(提示查一次图像就够了)在简单场景下成立,但在复杂分割场景下会失效:
1. Token → Image:提示找到"可能的目标区域"
# Token作为Query,图像作为Key/Value
attn = softmax(Token_Q @ Image_K^T)  # [N_token, 4096]
Token_updated = attn @ Image_V       # 聚合相关图像特征
这一步让提示token知道"图像中哪里与我相关"
但图像是静态的,还没有被"标记"哪里是目标
2. Image → Token:图像被"激活"目标区域
# 图像作为Query,更新后的Token作为Key/Value
attn = softmax(Image_Q @ Token_K^T)  # [4096, N_token]
Image_updated = attn @ Token_V       # 聚合提示信息
这一步让图像特征知道"我是目标区域"
相当于将提示的语义信息写回图像空间
关键类比:
Token→Image = 搜索("提示在找什么")
Image→Token = 标记("图像中被找到的地方被激活")
为什么最后还要Token→Image查一次?
SAM2在TwoWayTransformer最后又加了一层Token→Image Cross-Attention:
# 在TwoWayTransformer(2层)之后 self.final_attn_token_to_image = Attention(...)原因:
图像特征已被更新:经过Image→Token后,图像特征现在包含了"目标区域"的激活信息
Token需要再次确认:用更新后的Token去查询更新后的图像,获得更精确的目标定位
生成动态分类器:最终Token输出会通过MLP生成mask的"动态卷积核",需要与图像特征做逐点乘积
不符合直觉?看一个具体例子
假设输入是一个点提示(点击了狗的鼻子):
步骤 操作 效果 Self-Attn Token之间交互 输出token知道"我要找狗" Token→Image 提示查图像 发现鼻子区域最相关,但图像其他部分还不知道自己是狗的一部分 Image→Token 图像查提示 图像中鼻子附近区域被激活("我是目标的一部分"),但边界模糊 MLP Token变换 整合信息 Token→Image (final) 提示再次查图像 用更精确的语义去定位完整的狗轮廓 如果只查一次:
Token知道狗在哪里,但图像特征没有全局一致性
最终做逐点乘积时,图像中非目标区域可能仍有响应
双向注意力的本质:迭代精修
TwoWayTransformer的设计哲学是"双向迭代":
Token ←──────→ Image
   ↑              ↓
   └──────────────┘
     互相更新、互相约束
Token→Image:将语义意图(提示)映射到空间位置(图像)
Image→Token:将空间约束(图像结构)反馈给语义表示(Token)
这类似于EM算法的迭代过程:
E步:给定Token,估计图像中的目标区域
M步:给定目标区域,更新Token表示
总结:为什么不是"查一次就够"
你的直觉 实际设计 原因 提示查图像 → 直接出mask 提示↔图像↔提示 需要双向确认和迭代精修 单向信息流动 双向信息流动 图像特征需要被"激活",Token需要被"约束" 一次性定位 多次交互 处理模糊提示(单点可能对应多个物体) SAM2通过2层TwoWayTransformer(共4次Cross-Attention)实现这种迭代,最终再用一次Token→Image生成动态分类器。这种设计让模型能够处理提示歧义性(输出3个候选mask)和复杂边界(通过高分辨率skip connection精修)。
八、注意力机制都是查询向量发生改变吗?
注意力机制中"谁改变,谁不变"
标准Cross-Attention的公式(实际SAM2的交叉注意力的key/value会将记忆的64维升维到256维,与图像的256维对齐)
Q = X @ W_q # 来自Query输入(通常是目标序列) K = Y @ W_k # 来自Key输入(通常是源序列) V = Y @ W_v # 来自Value输入(通常是源序列) Attn = softmax(Q @ K^T / sqrt(d_k)) Output = Attn @ V # 这就是新的Query表示维度变化:
输入Query:
[B, N_q, d_q](如Token的256维)输入Key/Value:
[B, N_kv, d_kv](如图像的64维)输出:
[B, N_q, d_kv]或[B, N_q, d_model]
核心结论:Query序列被改变,Key/Value序列不被改变
组件 是否改变 作用 Query ✅ 改变 聚合了Key/Value的信息 Key ❌ 不改变 只提供"查询索引" Value ❌ 不改变 只提供"被聚合的内容"
具体到SAM2的场景
1. Token → Image Cross-Attention
# Token是Query,图像提供KV
Q = Token      # [B, N_token, 256]
K, V = Image   # [B, 4096, 64]

Token_new = softmax(Q@K^T) @ V   # [B, N_token, 64/256]
Token改变:获得了图像相关信息
图像不变:保持原样
2. Image → Token Cross-Attention
# 图像是Query,Token提供KV
Q = Image      # [B, 4096, 256]
K, V = Token   # [B, N_token, 256]

Image_new = softmax(Q@K^T) @ V   # [B, 4096, 256]
图像改变:获得了Token的语义信息
Token不变:保持原样
为什么叫"TwoWay"(双向)
你的困惑可能来自"双向"这个词。它不是指同时双向,而是指交替进行两个方向:
Layer 1: Token → Image (Token改变) Layer 2: Image → Token (图像改变) Layer 3: Token → Image (Token再次改变) ...每一层只有一个方向被更新,但通过多层堆叠实现双向信息融合。
类比理解
类比 Query Key/Value 输出 数据库查询 你的问题 数据库内容 你的理解更新了 搜索引擎 搜索词 网页索引 你的知识更新了 注意力 当前任务 上下文信息 任务表示更新了 Key/Value就像图书馆的书架——它们静静地待在那里提供信息,但不会被"改变"。Query就像读者——每次查询都会更新你的理解。
回到你的问题
"图像也要告诉提示哪里被查询了"
严格来说:
图像特征本身不改变(作为KV时)
但当图像作为Query时(Image→Token),它会被更新
所以TwoWayTransformer的设计是:
Token先查图像 → Token更新(知道目标在哪)
图像再查Token → 图像更新(被标记为目标区域)
这是一种交替更新策略,而不是同时双向。
九、记忆要加 +4 Object Pointer Tokens,这个4是怎么来的?
第六节中提到记忆要加 +4 Object Pointer Tokens,这个4是怎么来的?
# pos_list:(1,) ptrs_list:(torch.Size([B, 256]),)
# 沿dim=0堆叠对象指针,形状为[ptr_seq_len, B, C]
obj_ptrs = torch.stack(ptrs_list, dim=0)
# obj_ptrs: torch.Size([1, B, 256])
obj_pos = obj_ptrs.new_zeros(len(pos_list), B, self.mem_dim)
# obj_pos: torch.Size([1, B, 64])# 如果mem_dim < C,将每个指针拆分为(C // self.mem_dim)个token
# self.mem_dim:64 C:256
if self.mem_dim < C:
obj_ptrs = obj_ptrs.reshape(
-1, B, C // self.mem_dim, self.mem_dim
)
# obj_ptrs: torch.Size([1, B, 4, 64])obj_ptrs = obj_ptrs.permute(0, 2, 1, 3).flatten(0, 1)
# obj_ptrs: torch.Size([4, B, 64])obj_pos = obj_pos.repeat_interleave(C // self.mem_dim, dim=0)
# obj_pos: torch.Size([4, B, 64])
to_cat_memory.append(obj_ptrs)
# to_cat_memory:[
# torch.Size([4096, B, 64]),
# torch.Size([4, B, 64])
# ]
to_cat_memory_pos_embed.append(obj_pos)
# to_cat_memory_pos_embed:[
# torch.Size([4096, B, 64]),
# torch.Size([4, B, 64])
# ]
# obj_ptrs: torch.Size([4, B, 64])
num_obj_ptr_tokens = obj_ptrs.shape[0]
# num_obj_ptr_tokens: 4我有点不明白这里: obj_ptrs = obj_ptrs.reshape(
-1, B, C // self.mem_dim, self.mem_dim
)
为什么obj_ptrs是4个token是由256/64得到的?
核心原因:Memory Attention的维度对齐要求
回顾Memory Attention的输入要求:
输入 维度 说明 当前帧图像特征 [B, 4096, 256]Query来源,256维 记忆特征 [B, 24580, 64]Key/Value来源,64维 Object Pointer Tokens [B, 4, 64]必须对齐记忆的64维! 关键约束:Memory Attention中所有Key/Value必须统一维度(64维),因为:
记忆的Key/Value投影层
k_proj和v_proj期望输入是64维如果直接塞256维的obj_ptrs,投影层会报错
代码中的维度变换逻辑
初始状态
obj_ptrs = torch.stack(ptrs_list, dim=0)
# [1, B, 256]  ← 来自上一帧的轻量级语义向量,256维
问题:256 ≠ 64,无法直接拼接
记忆是64维,obj_ptrs是256维,维度不匹配:
to_cat_memory = [
    torch.Size([4096, B, 64]),   # 图像记忆
    torch.Size([1, B, 256])       # ❌ 维度不匹配,无法拼接!
]
解决方案:把256维"切"成4个64维token
# C = 256, self.mem_dim = 64 # C // self.mem_dim = 4 obj_ptrs = obj_ptrs.reshape(-1, B, C // self.mem_dim, self.mem_dim) # [1, B, 256] → [1, B, 4, 64] obj_ptrs = obj_ptrs.permute(0, 2, 1, 3).flatten(0, 1) # [1, B, 4, 64] → [4, B, 64] ← 现在可以拼接了!可视化:
原始obj_ptrs(1个token,256维):
[████████████████████████████████]  ← 256维

reshape后(4个token,各64维):
[████████][████████][████████][████████]  ← 4×64维 = 256维

permute+flatten后(序列维度展开):
Token1: [████████]  64维
Token2: [████████]  64维
Token3: [████████]  64维
Token4: [████████]  64维
     ↓
形状: [4, B, 64]
为什么要这样设计?而不是直接投影?
你可能会问:为什么不用线性层把256投影到64?这样不就1个token了吗?
原因1:信息保留
直接投影(256→64)会压缩/丢失信息
拆成4个token(256→4×64)保留全部信息,只是重新组织
原因2:Attention机制的特性
4个token可以分别关注不同的语义方面
在Cross-Attention中,4个token各自与图像特征交互,相当于多视角查询
原因3:与记忆的空间token对齐
记忆的空间token也是64维
Object Pointer作为"全局语义摘要",以相同维度参与Attention,保持特征空间一致性
最终拼接结果
to_cat_memory = [
    torch.Size([4096, B, 64]),   # 6帧图像记忆(64×64×6=24576,但这里是4096可能指单帧或已处理)
    torch.Size([4, B, 64])         # ✅ 4个object pointer tokens,64维,可拼接!
]

# 拼接后
# [4096+4, B, 64] = [4100, B, 64]
# 这就是你博客中看到的 [B, 4100, 64](转置后)
总结
问题 答案 为什么是4个token? 因为256/64=4,把高维语义拆成与记忆同维度的多个token 为什么不直接投影? 拆分会保留更多信息,且保持特征空间一致性 这4个token有特定含义吗? 没有显式定义,但Attention机制会自动学习它们的分工 这种设计是SAM2的一个工程巧思:在不增加额外参数的前提下,让高维的Object Pointer能够无缝融入低维的Memory Attention计算流。
十、超向量跟上采样后的图像特征相乘?
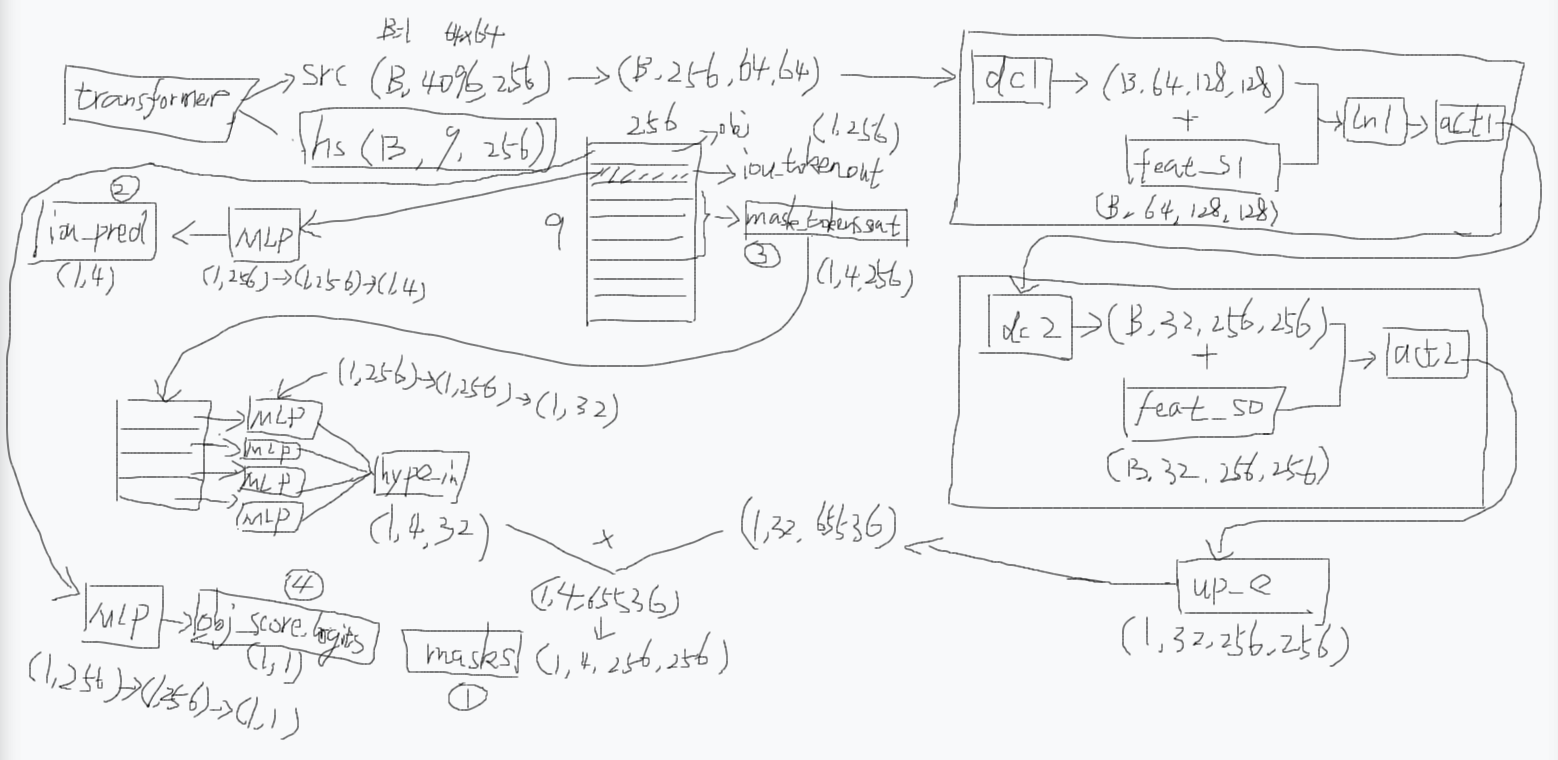
SAM2的mask decoder出来以后图像特征是(B,4096,256),token特征是(B,9,256) (1个obj,1个iou阈值,4个掩码,2个提示点+一个padding提示点),然后图像特征上采样到了(B,32,65536),4个掩码的token分别经过了MLP再聚合成超向量(1,4,32),最后超向量跟上采样后的图像相乘,得到掩码(1,4,65536),最终变成(1,4,256,256)。这个mask decoder出来的增强后的图像特征和toknen特征如何理解?它们是各自都已经知道目标在哪了吗?最后这个超向量跟上采样后的图像特征相乘又如何理解?为什么就能得到掩码了呢?
1. 增强后的图像特征和Token特征:它们知道目标在哪吗?
图像特征
[B, 4096, 256]→[B, 32, 65536]经过TwoWayTransformer后的状态:
属性 状态 说明 是否知道目标在哪 ✅ 是的,但隐式编码 每个空间位置的特征包含了"我是/不是目标"的信息 如何编码 特征向量方向/数值 目标区域的特征向量会指向相似的语义方向 是否直接输出掩码 ❌ 否 还需要解码成具体的空间掩码 关键理解:图像特征现在是一种"条件化"的embedding,类似于:
目标区域:特征向量 ≈ "前景语义方向"
背景区域:特征向量 ≈ "背景语义方向"
但这不是显式的0/1掩码,而是高维空间中的聚类
Token特征
[B, 9, 256]的组成
Token 作用 是否知道目标 1个IOU Token 预测掩码质量分数 知道,但输出是标量 1个Object Token 聚合目标语义 ✅ 知道,是目标的"语义摘要" 4个Mask Tokens 生成4个候选掩码 ✅ 知道,但各自侧重不同(整体/局部/边界等) 3个Prompt Tokens 编码用户输入 知道,但用于条件化而非直接输出 Token知道目标的方式:通过TwoWayTransformer与图像的双向交互,Token已经聚合了目标区域的图像特征。
2. "超向量"与图像相乘:动态卷积机制
这是SAM的核心创新,称为"动态卷积"(Dynamic Convolution)或"基于提示的分割"。
维度变化流程
Step 1: Mask Tokens经过MLP降维
    [B, 4, 256] --MLP--> [B, 4, 32]   (超向量)

Step 2: 图像特征上采样
    [B, 4096, 256] --上采样--> [B, 65536, 32]  或 [B, 32, 65536]
    (4096=64×64 → 65536=256×256, 256→32通道)

Step 3: 矩阵乘法(点积)
    超向量: [B, 4, 32]  @  图像: [B, 32, 65536]  (转置后)
    结果: [B, 4, 65536] → reshape → [B, 4, 256, 256]
为什么"相乘"就能得到掩码?
关键理解:这是"语义相似度"计算
# 伪代码 for each mask_token in [B, 4, 32]: for each pixel in [B, 65536, 32]: similarity = dot_product(mask_token, pixel_feature) # 相似度越高 → 该像素属于这个掩码的概率越高物理意义:
组件 角色 类比 Mask Token (32维) "目标语义过滤器" 像"狗检测器"的权重向量 图像特征 (32维/像素) "像素语义描述" 像每个像素的"内容向量" 点积结果 "匹配分数" 像"这个像素有多像狗"的分数 为什么32维?
256维的Token包含丰富信息(位置、形状、语义)
MLP压缩到32维,提取出最核心的"掩码生成"信息
这32维可以看作4个不同的"目标检测器"(对应4个候选掩码)
3. 整个过程的直觉解释
阶段1:TwoWayTransformer = "建立对应关系"
Token告诉图像:"我在找这样的目标"
图像告诉Token:"这些区域符合你的描述"
结果:图像特征被"调制",目标区域特征增强
阶段2:上采样 = "高分辨率定位"
64×64的特征图 → 256×256
保持语义信息,但获得空间精度
阶段3:超向量相乘 = "动态分类"
传统CNN:固定卷积核检测固定模式
SAM:为每个提示动态生成卷积核(Mask Token → MLP → 32维向量)
这个"动态核"与图像做逐点相关,得到激活图
为什么叫"超向量"?
它不是固定参数,而是根据提示实时计算的
包含了"当前要分割什么"的全部信息
与图像特征相乘 = 用提示语义去"筛选"图像像素
4. 4个候选掩码的生成逻辑
# 4个Mask Token各自生成不同的超向量 mask_token_0 --MLP--> 超向量0 # 可能侧重:整体目标 mask_token_1 --MLP--> 超向量1 # 可能侧重:主要部分 mask_token_2 --MLP--> 超向量2 # 可能侧重:边界细节 mask_token_3 --MLP--> 超向量3 # 可能侧重:排除干扰 # 分别与图像相乘,得到4个不同的相似度图 # 这就是为什么SAM能输出3个候选掩码(取前3个)训练时的监督:4个掩码与GT计算损失,最好的那个回传梯度,其他也学习但权重不同。
总结:特征"知道"了什么
特征 知道的内容 如何"告诉"掩码生成 增强图像特征 每个像素是前景/背景的概率(隐式编码在高维特征方向) 提供"像素语义描述"给点积计算 Mask Token 目标的语义类别和粗略位置(通过Attention聚合) 生成"动态卷积核"筛选像素 相乘结果 显式的空间激活图(0-1概率) 直接就是掩码预测 一句话理解:TwoWayTransformer让图像和提示"对齐了语义空间",最后的相乘是在这个对齐后的空间里做相似度检索,找出"最像提示所指目标"的像素区域。
十一、token特征(B,9,256) 是一个可学习权重矩阵?
我记得这个token特征(B,9,256) 是一个可学习权重矩阵对吧?也就是它的权重是随着用户的提示变化的,但是为什么它又同时是TwoWayTransformer的输出之一呢?如何理解两者的关系?
核心答案:可学习权重是输入,TwoWayTransformer输出是更新后的表示
它们不是同一个东西,而是"初始化值" → "经过交互后的值"的关系。
具体流程拆解
1. 可学习权重的创建(初始化阶段)
根据SAM2源码:
# MaskDecoder.__init__ 中定义 self.iou_token = nn.Embedding(1, transformer_dim) # [1, 256] self.mask_tokens = nn.Embedding(num_mask_tokens, transformer_dim) # [4, 256]关键点:
这些是nn.Embedding,是可学习的参数
训练开始时随机初始化
它们的作用是提供"初始查询向量",类似于DETR中的object queries
2. 输入TwoWayTransformer前的准备
# 在forward中 iou_token = self.iou_token.weight # [1, 256] mask_tokens = self.mask_tokens.weight # [4, 256] # 与prompt tokens拼接 tokens = torch.cat([iou_token, mask_tokens, prompt_tokens], dim=0) # [9, 256] # 扩展batch维度 → [B, 9, 256]此时:
tokens[0]:IOU token的初始值
tokens[1:5]:4个mask token的初始值
tokens[5:]:用户提示编码(非学习得到)3. TwoWayTransformer的处理
# TwoWayTransformer(2层)处理 tokens, image = self.transformer(tokens, image_embeddings)内部发生了什么:
# Layer 1: Token Self-Attention tokens = self.self_attn(tokens) # Token之间交换信息 # Layer 1: Token → Image Cross-Attention tokens = self.cross_attn_token_to_image(tokens, image) # Token查询图像 # Layer 1: Image → Token Cross-Attention image = self.cross_attn_image_to_token(image, tokens) # 图像查询Token # Layer 2: 重复上述过程... # 最终输出Token output_tokens = tokens # [B, 9, 256]关键:输出
tokens≠ 初始self.iou_token.weight
如何理解两者的关系?
阶段 名称 角色 是否可学习 输入 iou_token.weight先验/初始猜测 ✅ 是 输出 output_tokens[:,0,:]后验/条件化表示 ❌ 不是(是计算结果) 类比理解:
可学习权重 = 学生的"基础知识"(长期记忆,通过训练获得) TwoWayTransformer = "考试时的推理过程"(结合题目信息实时计算) 输出Token = "考试答案"(针对当前题目的具体回答)具体关系:
# 简化示意
output_iou_token = f(iou_token.weight, image_features, prompt_tokens)

# f = TwoWayTransformer
# 包含:Self-Attn + Cross-Attn(Image) + Cross-Attn(Token) + FFN
为什么需要可学习权重?
根据SAM论文和实现:
提供归纳偏置:告诉模型"要输出什么类型的表示"
IOU token学习预测质量分数
Mask tokens学习生成不同尺度的掩码
处理提示歧义性:4个mask token对应不同解释
整体目标 / 局部区域 / 边界细节 / 其他
与Prompt结合:用户提示通过Cross-Attention"调制"这些初始猜测
训练过程:
# 前向
iou_token_init = self.iou_token.weight  # 可学习
output_tokens = transformer(...)        # 计算图
iou_pred = mlp(output_tokens[:,0])      # 预测IOU

# 反向
loss.backward()
# 梯度同时更新:
# 1. iou_token.weight(初始值)
# 2. transformer参数(交互方式)
# 3. mlp参数(预测头)
总结
你的问题 答案 Token特征是可学习权重吗? 输入时是( nn.Embedding),输出时不是两者如何统一? 可学习权重提供初始值,TwoWayTransformer基于图像和提示更新它们 为什么能处理不同提示? 可学习权重是共享的初始化,具体输出依赖于当前提示和图像 这类似于Transformer中的位置编码:也是可学习的,但会与输入序列相加以提供位置信息,最终输出是融合后的结果。
十二、位置编码的选择
SAM2中什么时候用了sin-cos的位置编码,什么时候用了RoPE旋转位置编码,为什么有使用不同位置编码的需求?如何知道什么时候该使用什么位置编码?
SAM2中的位置编码使用情况
1. 两种位置编码的具体使用场景
SAM2在架构的不同部分使用了不同的位置编码:
组件 位置编码类型 具体用途 Image Encoder (Hiera) Sin-Cos绝对位置编码 对图像patch的空间位置进行编码 Memory Attention 2D RoPE旋转位置编码 在自注意力和交叉注意力层中编码空间位置关系 Memory Encoder Sin-Cos位置编码 对mask memory进行位置编码 时间维度 Sin-Cos位置编码 对N个最近帧的记忆嵌入时间位置信息 2. 为什么需要不同的位置编码?
根据SAM2论文和相关分析,这种设计选择基于以下原因:
Image Encoder使用Sin-Cos的原因:
Hiera编码器采用窗口化的绝对位置编码(windowed absolute positional embeddings)
为了效率,去除了相对位置偏置(RPB),改用全局位置编码的插值来跨越窗口
Sin-Cos编码简单高效,适合处理固定分辨率的图像特征
Memory Attention使用2D RoPE的原因:
相对位置感知:RoPE天然编码token之间的相对位置关系,而不是绝对位置
连续性处理:Memory Attention需要处理来自不同帧的特征,这些特征在空间上可能有复杂的对应关系
效率优势:论文中提到使用2D-RoPE可以在高分辨率(1024)下配合FlashAttention-2获得显著的速度提升
空间对齐:RoPE通过旋转矩阵保持向量模不变,更适合处理跨帧的空间对齐问题
时间位置编码使用Sin-Cos的原因:
只对N个最近帧的记忆嵌入时间位置
不对提示帧(prompted frames)嵌入时间位置,因为训练信号稀疏,难以泛化到推理时时间范围差异大的情况
3. 如何选择位置编码?
根据SAM2的设计原则和位置编码的特性,可以总结以下选择指南:
场景 推荐编码 理由 固定空间结构(如图像编码器) Sin-COS 简单、与FlashAttention兼容、适合固定分辨率 需要相对位置关系(如跨帧注意力) RoPE 天然编码相对位置、保持向量模不变、外推能力强 多维度位置(2D图像+时间) 2D-RoPE + Sin-COS RoPE处理空间,Sin-COS处理时间维度 长序列外推 RoPE 相对位置编码对序列长度变化更鲁棒 与现有高效注意力库兼容 RoPE 现代实现(如FlashAttention)对RoPE支持更好 4. SAM2中的具体实现细节
根据论文:
Memory Attention使用L=4 层Transformer块
在自注意力和交叉注意力层中都使用2D空间RoPE
Object pointer tokens不使用RoPE,因为它们没有特定的空间对应关系
除了正弦绝对位置编码外,还叠加使用2D-RoPE
5. 性能对比
论文中的消融实验(Table 11)显示:
配置 速度 SA-23 mIoU 2D-RoPE in mem. attn. (默认) 1.00× 59.7 RPB in img. enc. + 2D-RoPE 0.93× 60.0 无RoPE 1.04× 59.9 这表明:
去除Image Encoder中的RPB并使用2D-RoPE在Memory Attention中,可以在保持性能的同时获得速度提升
在1024分辨率下,2D-RoPE与无RoPE基线的速度差距变得更小
总结
SAM2的设计体现了因地制宜的原则:
Sin-COS用于需要简单绝对位置编码的场景(图像编码器、时间编码)
RoPE用于需要精细相对位置建模的场景(Memory Attention中的空间关系)
选择位置编码时,应考虑:是否需要相对位置关系、序列长度变化、与高效注意力实现的兼容性,以及具体任务的时空特性。
十二、如何通俗理解两种位置编码以及它们的区别和联系是什么?
用最通俗的方式来理解,可以把这两种位置编码想象成不同的"位置导航系统":
一句话概括
Sin-Cos:给每个位置发一张"绝对地址门牌号"(这是第5号位)
RoPE:告诉模型"两点之间相距多远"(A在B左边3个单位)
形象比喻:快递员送货
Sin-Cos编码(绝对地址)
想象你住在一个长条形的宿舍楼,每个房间门口贴着门牌号:
101房间、102房间、103房间...
快递员看到"103"就知道你要送到第3间房
问题:如果这栋楼突然扩建了(序列变长),新房间104、105快递员可能不认识,因为训练时只见过1-100号
RoPE编码(相对距离)
RoPE相当于给快递员一张"雷达地图":
不告诉你具体门牌号,而是告诉你"目标在你前方5米处"
不管你从101出发还是从501出发,"前方5米"的含义是一样的
优势:楼扩建到1000层也没问题,因为只看相对距离
从数学角度简单看
Sin-Cos:给位置打"指纹"
# 每个位置pos都有一个独特的编码
位置5的编码 = [sin(5/10000^(0/512)), cos(5/10000^(0/512)), ...]
位置6的编码 = [sin(6/10000^(0/512)), cos(6/10000^(0/512)), ...]
就像给每个座位贴一个独特的条形码,模型通过识别条形码知道"这是第几个位置"。
RoPE:旋转魔法
# 不是加法,而是旋转
Query向量 @ 位置旋转矩阵 = 旋转后的Query
Key向量 @ 位置旋转矩阵 = 旋转后的Key

# 两个向量相乘时,位置信息自然体现在夹角中
Attention分数 = (旋转后Q) · (旋转后K)
就像把向量当成时钟的指针,根据位置给它旋转一定角度。两个向量的角度差,就代表了它们的相对距离。
核心区别对比表
维度 Sin-Cos RoPE 编码对象 绝对位置(第5位) 相对位置(相隔3位) 计算方式 加到词向量上 旋转词向量 外推能力 弱(没见过100位就处理不好) 强(只关心距离) 长度限制 需要预定义max_length 理论上无限 长文本表现 性能下降明显 保持较好
它们的联系
本质上,两者都利用了正弦/余弦函数的周期性:
Sin-Cos:直接用sin/cos函数生成位置编码向量
RoPE:用旋转矩阵(其元素也是sin/cos)对向量进行变换
就像:
Sin-Cos是把sin/cos当成"门牌号的墨水"
RoPE是把sin/cos当成"旋转的齿轮"
数学本质:RoPE可以看作是一种"乘法型"的Sin-Cos编码,而传统Sin-Cos是"加法型"的。
为什么SAM2两者都用?
回到你的SAM2问题:
模块 使用编码 原因 Image Encoder Sin-Cos 图像尺寸固定,不需要外推,计算简单 Memory Attention RoPE 需要处理不同帧之间的空间关系,强调"物体移动了多少",用相对位置更自然 通俗理解:
处理单张图时(Image Encoder):就像查地图找固定地址,用门牌号(Sin-Cos)够用了
处理视频帧间关系时(Memory Attention):就像追踪移动物体,更关心"它从哪移动到哪"(相对距离),用RoPE更合适
一句话总结
Sin-Cos是"坐标定位",RoPE是"距离感知"。前者适合固定场景,后者适合需要理解相对关系的场景。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐
 9
 0
- 0


 已为社区贡献41条内容

所有评论(0)