登录社区云,与社区用户共同成长
邀请您加入社区
本文详解 vLLM 在 AMD Instinct GPU 上的部署与调优策略。从环境权限配置、PyTorch 源码编译到关键启动参数设置,全面解析如何平衡性能与稳定性。通过实战案例展示显存管理与并发优化技巧,助开发者高效构建大模型推理服务。
本文详解 vLLM 在 AMD Instinct GPU 上的优化配置,解决显存溢出难题。通过调整 gpu-memory-utilization 预留缓冲、优化 block-size 适应不同序列场景,以及利用 FP8 量化大幅降低显存占用,帮助开发者在 ROCm 环境下实现大模型推理的稳定高效运行。
本文详解 AMD 显卡部署大模型全流程,聚焦 ROCm 7.x 与 vLLM 环境搭建。从权限配置、驱动验证到 PyTorch 源码编译,提供关键避坑指南,助开发者高效运行推理服务,释放 GPU 算力潜能。
国产大模型正在构建"模型+算力+框架"的全栈自主化能力。对于开发者来说,现在是一个好时机——你可以用相对低的成本,在一个世界级的开源模型上做实验。你如何看待MoE架构vs Dense架构的未来?在你的实际业务场景中,更看重模型规模还是推理效率?欢迎在评论区分享你的实测数据。MiniMax M3, 大模型部署, MoE架构, vLLM, 国产大模型。
DeepSeek-V4延续了前代混合专家(MoE)架构,总参数量约为236B,但每个token仅激活约21B参数,从而在保持极高推理效率的同时,大幅降低显存占用。官方提供了BF16原始权重和INT8/INT4量化版本,最低只需24GB显存即可运行。此外,模型原生支持128K上下文窗口,非常适合长文档理解、代码生成等场景。本地部署的优势包括:数据不出域、零网络延迟、完全可定制的生成策略、以及避免AP
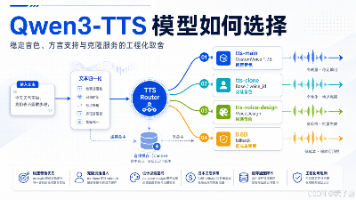
Qwen3-TTS 是阿里巴巴 2025 年 12 月发布的语音合成模型家族,主打"自研 12Hz 语音编码器 + 端到端多码本架构 + 双轨流式架构",端到端合成延迟最低可达 97ms,并支持以自然语言指令控制发声风格和情绪。模型家族包含 1.7B-CustomVoice(固定音色主服务)、1.7B-Base(声音克隆与微调)、1.7B-VoiceDesign(自然语言描述生成候选音色)、0.6