KingbaseES 流复制主备与 JDBC 读写分离实战
KingbaseES 流复制主备与 JDBC 读写分离实战
之前线上有个业务突然火了一阵子,读请求翻了三四倍,主库 CPU 直接拉满。当时加了两台备机做读写分离,十来分钟就缓解了。其实这套东西搭起来不难,就是细节多,第一次配容易卡。这里把完整流程记一下,一台机器用不同端口跑一主一备,再配通 JDBC 读写分离,所有命令都在 KingbaseES V9 上实测过。
物理流复制说白了就是 WAL 日志从主库源源不断推到备库,备库重放之后数据和主库一致。默认是异步的,主库提交不等备库,备库可能落后几毫秒;要求零丢失就开同步,主库提交会等备库落盘。读写分离放在 JDBC 驱动层,驱动识别 SQL,写发主库、读按负载率分发到备库,业务代码不用改。挺优雅的。
环境先说清楚:主库 54321,备库 54322,都在 /opt/kingbase 下面,数据目录分别叫 data 和 data_standby。
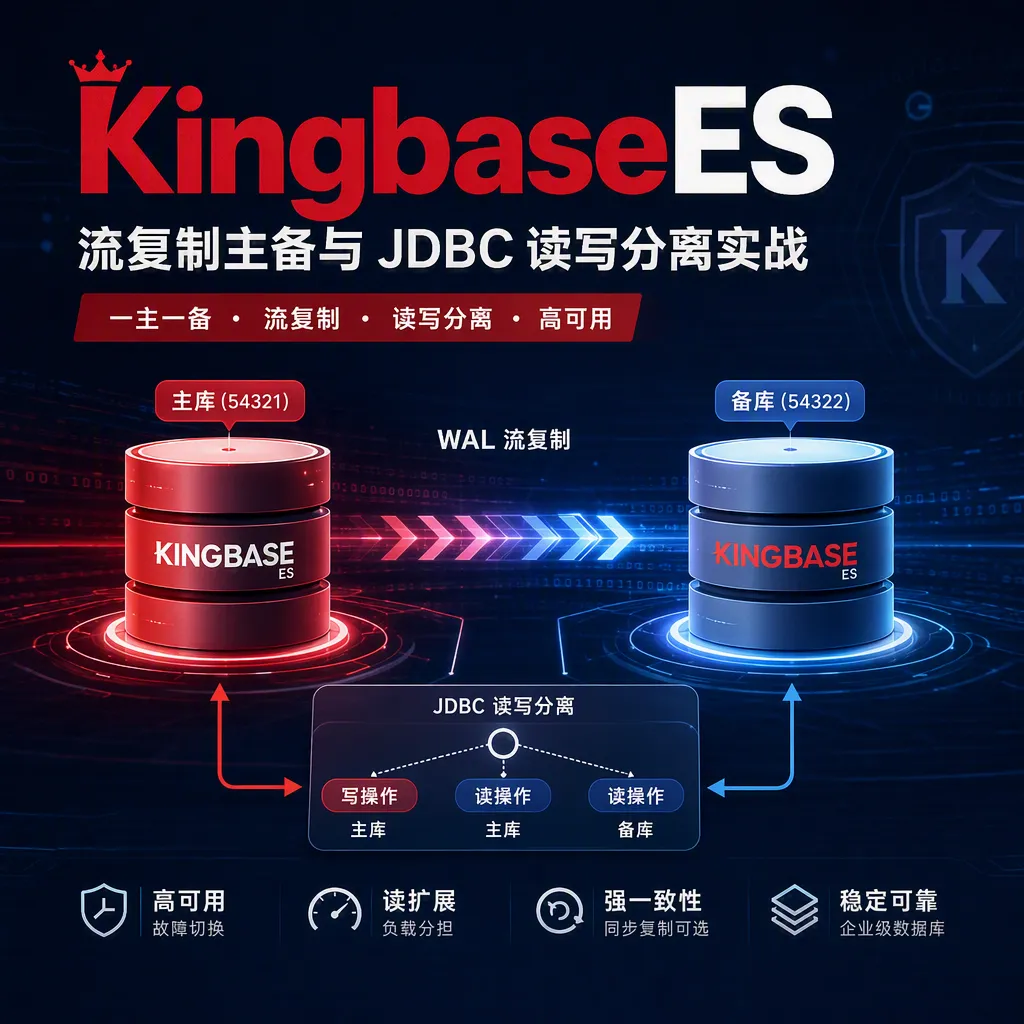
主库先把复制参数打开
改 kingbase.conf:
wal_level = replica
max_wal_senders = 10
max_replication_slots = 10
wal_keep_size = 1GB
listen_addresses = '*'
wal_level=replica 是流复制的最低要求,再低不行;max_wal_senders 不够的话备库直接连不上;wal_keep_size 留 1GB 防止备库短暂断连后追不上主库的 WAL。
然后 sys_hba.conf 放行复制连接。这里要建一个专用的复制用户 repl,别用超级用户干这活:
host replication repl 127.0.0.1/32 md5
建这个用户,关键是得带 REPLICATION 属性和登录权限:
CREATE ROLE repl WITH REPLICATION LOGIN PASSWORD 'Repl@2026';
这几样改完得重启主库,不是 reload 能搞定的,因为 wal_level 这类参数是重启级。
用 sys_basebackup 拉起备库
备库的数据从哪来?直接从主库拷一份过来,用的就是 sys_basebackup。它走复制协议做基础备份,关键是 -R 参数——会自动在备库目录生成 standby.signal 文件,并把连接信息写进 kingbase.auto.conf,省去手敲的麻烦,手敲容易漏字段。
sys_basebackup -h 127.0.0.1 -p 54321 -U repl \
  -D /opt/kingbase/data_standby -Fp -Xs -P -R
-Xs 是流方式并行传 WAL,最稳,不会因为主库 WAL 被回收了导致备份失败;-Fp 普通文件格式,拉完直接能起库,不用额外解包。拉完看一眼 data_standby/kingbase.auto.conf,里面应该已经有 primary_conninfo 那行了:
primary_conninfo = 'host=127.0.0.1 port=54321 user=repl ...'
接着改备库端口避免和主库冲突,在 kingbase.conf 里把 port 设成 54322。然后启动备库:
sys_ctl -D /opt/kingbase/data_standby start
这里有个小坑。sys_basebackup 拉过来的 kingbase.conf 是从主库拷的,里面 port 还是 54321,不改的话备库起不来,端口冲突。另外 shared_buffers 这类参数如果主备机内存不一样,备库这边也要调一下,别傻乎乎照搬。
验证主备真的在同步
起库之后别急着走,先确认数据真的在同步。主库这边查复制状态:
SELECT pid, usename, application_name, state,
       pg_current_wal_lsn() AS cur_lsn,
       sent_lsn, replay_lsn
FROM sys_stat_replication;
能看到一条 state=streaming 的记录就说明备库连上了。但看到 streaming 只是说链路通了,数据有没有真同步过来还得实打实测。我在主库建张表插一行,然后去备库查——查得到才算真的通了。这一步别省,我见过链路是通的但备库 replay 卡住的情况,看状态根本发现不了。
备库查自己的角色,确认确实是备库身份:
SELECT pg_is_in_recovery(); -- 返回 t 表示当前是备库
想要零丢失就开同步复制
异步够用的话这节跳过就行。要强一致的话,主库 kingbase.conf 加一行:
synchronous_standby_names = 'standby1'
这里的 standby1 是备库连接时带的 application_name,得在备库的 primary_conninfo 里对应上。sys_basebackup 自动生成的 primary_conninfo 默认没带这个,要手动加一句 application_name=standby1,否则主库认不出来,提交会一直挂着等。
设成同步后主库每次提交都会等 standby1 把 WAL 落盘才返回。好处是零丢失,代价是备库宕机的时候主库写操作会被卡住,等备库恢复。所以生产上一般不这么玩,常配两个备机用 FIRST 1 (standby1, standby2)——只要有一个备机同步成功就行,不至于一个备机挂了把主库写也拖死。
改完 sys_ctl reload 主库就生效了,这个不用重启。
JDBC 读写分离怎么配
数据库侧主备跑通了,应用侧靠 JDBC 驱动分发。原理是驱动识别 SQL 语义,写语句发主库,读语句按负载率分到备库。连接串里打开 USEDISPATCH,把备机地址和节点名交给驱动就行:
jdbc:kingbase8://127.0.0.1:54321/testdb?USEDISPATCH=true&SLAVE_ADD=127.0.0.1&SLAVE_PORT=54322&nodeList=node1,node2&HOSTLOADRATE=50
几个参数说一下。USEDISPATCH=true 就是开启读写分离,不开就是普通单机连接。SLAVE_ADD 和 SLAVE_PORT 是备机地址和端口,多个备机用逗号隔开。nodeList 是节点名列表,第一个是主(node1),后面是备(node2),和地址一一对应,顺序别搞错。HOSTLOADRATE=50 是主机承担 50% 的读,剩下 50% 轮询分到备机。
驱动默认的分发逻辑是:INSERT/UPDATE/DELETE 和事务内的读都走主库,纯 SELECT 按负载率甩到备机。这个默认策略大多数场景够用。但如果业务要求刚写入的数据立刻能读到——比如下单之后马上查订单——异步备可能有延迟,这时候可以设 readListStrategy=2,让读只发主机和同步备机,牺牲一点扩展性换一致性。
还有一个低级错误我见过好几次:把主端口写成备机端口。URL 里 //host:port 那一段必须是主库地址,备机只在 SLAVE_ADD 和 SLAVE_PORT 里给。写反了驱动还是能连上,但分发逻辑全乱,排查起来特别费劲。
踩过的几个坑
备库起不来报连不上主库。 先查主库 sys_hba.conf 有没有放行 replication 类型的连接,repl 用户有没有 REPLICATION 属性。这两样漏一个都连不上,报错信息还不太直观,第一次配很容易懵。
max_wal_senders 太小。 备库直接连不上,报错信息大概意思是"too many walsenders"。按备库数量留够余量,一般设 10 够用了。
sys_basebackup 不用 -R。 这个坑我踩过。不用 -R 的话就得手动改 primary_conninfo 和建 standby.signal 文件,漏了哪一样备库会当主库起来,两套数据分叉,后续修复特别麻烦。能自动生成就别手敲。
同步复制下备库全挂了。 主库写操作直接挂起等待,整个业务停摆。生产环境务必配多备加 FIRST N 策略,至少留一个备机兜底。单备同步复制在备机故障时就是定时炸弹。
读写分离读不到刚写的数据。 这是异步备正常的复制延迟,不是 bug。要强一致就用 readListStrategy=2,或者把关键的读操作放进事务里——事务内的读默认发主库,不走备机。
JDBC 节点名对不上。 nodeList 的顺序必须和 SLAVE_ADD/SLAVE_PORT 一一对应,第一个永远是主。顺序错了分发就乱了,看着没问题实际读全打到主库上,备机闲着。
最后说两句
一主一备流复制加 JDBC 读写分离,是 KingbaseES 高可用和读扩展最基础也最实用的组合。主库宕了可以升备库顶上,读高峰甩给备机,单机瓶颈一下就打开了。后面要更省心可以上 KCluster 做自动故障切换,但底层的流复制和读写分离逻辑是不变的。建议先把这套手动搭一遍,理解透了再上集群管理工具,不然 KCluster 报错了都不知道该查哪。
我们那次业务流量突涨,就是靠这套顶过去的。备机加上之后 CPU 压力直接下来,主库终于能喘口气了。后来又做了故障切换演练,模拟主库宕机手动提升备库,流程跑顺了才敢上 KCluster 自动切换。这种东西,没演练过就上生产,心里真没底。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 9
 0
- 0


 已为社区贡献2条内容

所有评论(0)