Java中的Set
在阅读本文之前,建议读者优先阅读专栏内前面的文章。
目录
前言
本文主要介绍与Java中的Set相关的一系列内容。
一、Set类的说明:
Set与Map主要的不同有两点,首先Set是继承自Collection的接口类,其次Set中只存储了Key。官方关于Set的文档说明如下:Set (Java Platform SE 8 )
我们在这里先用TreeSet来演示,首先我们可以先来看下它常见的一些方法:
| 方法 | 解释 |
|---|---|
| boolean add(E e) | 添加元素,但重复元素不会被添加成功 |
| void clear() | 清空集合 |
| boolean contains(Object o) | 判断o是否在集合中 |
| Iterator<E> iterator() | 返回迭代器 |
| boolean remove(Object o) | 删除集合中的o |
| int size() | 返回set中元素的个数 |
| boolean isEmpty() | 检测set是否为空,空返回true,否则返回false |
| Object[] toArray() | 将set中的元素转换为数组返回 |
| boolean containsAll(Collection<?> c) | 集合c中的元素是否在set中全部存在,是返回true,否则返回false |
| boolean addAll(Collection<? extends E> c) | 将集合c中的元素添加到set中,可以达到去重的效果 |
我们还是从头到尾来分别进行测试,首先还是先看看add方法和contains方法,我们键入如下的代码:
import java.util.*;

public class Main {

    public static void main(String[] args) {
        TreeSet<String> set = new TreeSet<>();
        set.add("abcd");
        set.add("hello");
        set.add("world");

        System.out.println(set.contains("abcd"));
    }
}
其运行结果如下:
这两个方法很简单易懂,这里就不多做赘述了。下一个方法是iterator方法,它可以返回一个迭代器给我们。在这里我们其实可以发现,我们上篇文章中说到的map是没有和这类似的方法的。原因其实也很简单,我们还是搬出我们之前用过很多次的那张图来看看:
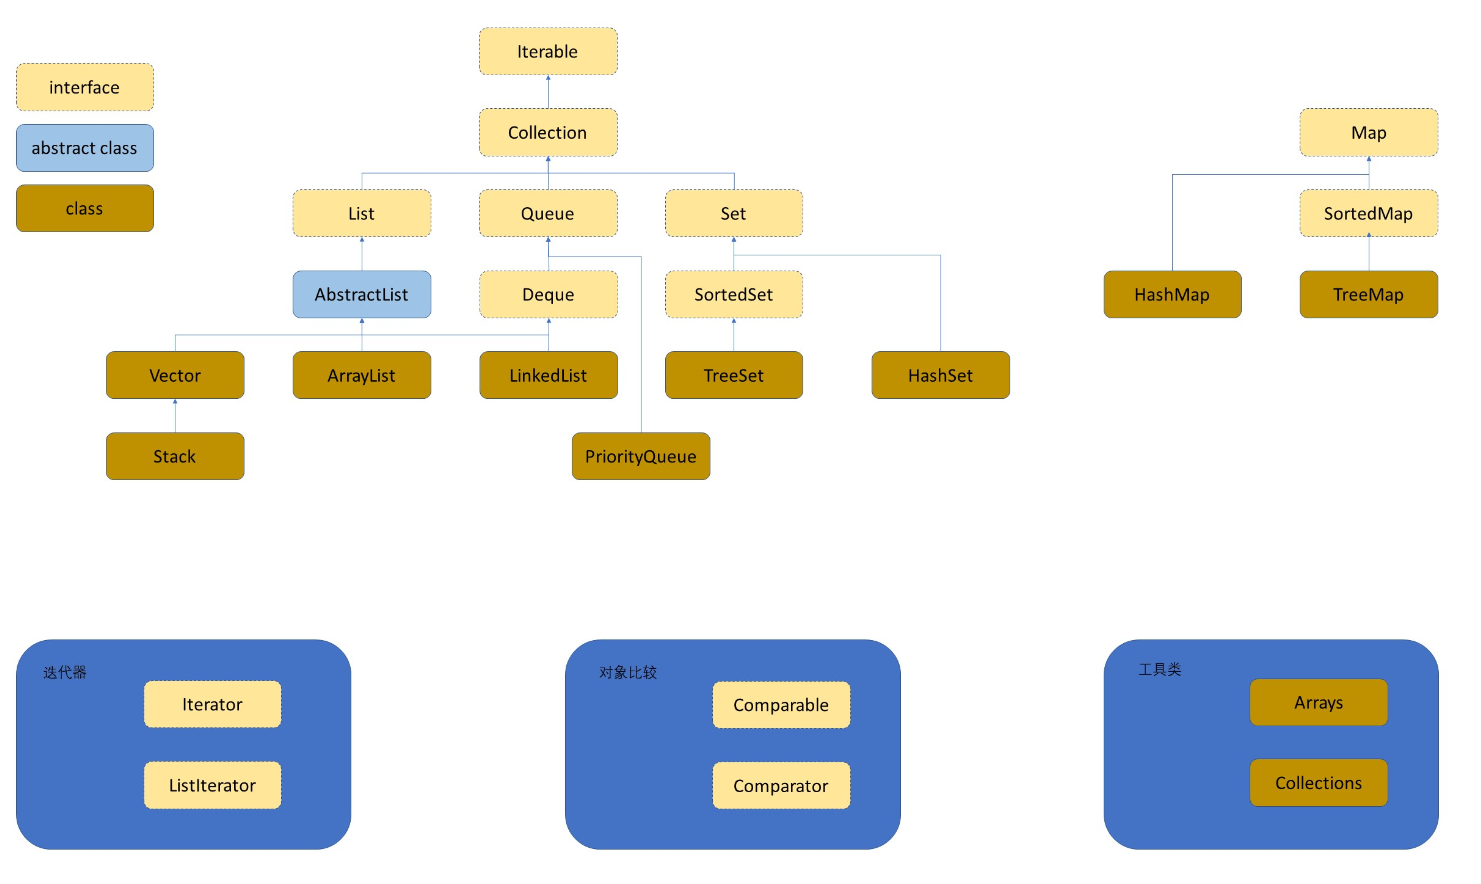
我们可以看到,map是独立于Iterable接口之外的,所以它无法实现迭代器遍历。而我们现在说的这个set则不同,是实现的上面的Iterable接口的,所以可以去使用迭代器。那么我们如果说一定要使用迭代器遍历map中元素的话,就需要借助上篇文章中提到的把map转为set的方法,进而使用迭代器。我们在这里仅仅展示set中使用迭代器的代码:
import java.util.*;

public class Main {

    public static void main(String[] args) {
        TreeSet<String> set = new TreeSet<>();
        set.add("abcd");
        set.add("hello");
        set.add("world");

        Iterator<String> it = set.iterator();
        while (it.hasNext()) {
            System.out.println(it.next() + " ");
        }
    }
}
其运行结果如下:
下面的这些方法我们就不多做演示了,它们要么很简单,要么就是在我们上篇文章中讲过极其类似的,所以如果有什么疑问的话,可以去上篇文章去看看。我们需要注意的是最后一个addAll方法,说明里介绍它有去重的效果,这是因为set不允许存储相同的元素。这和map中的存储略有不同,因为我们的键值对中的V是可以重复的,但是其中的K是不能重复的。那么二者间是不是会有什么联系呢?
答案是是的。我们可以先看看TreeSet的无参构造方法的源码:
    /**
     * Constructs a new, empty tree set, sorted according to the
     * natural ordering of its elements.  All elements inserted into
     * the set must implement the {@link Comparable} interface.
     * Furthermore, all such elements must be <i>mutually
     * comparable</i>: {@code e1.compareTo(e2)} must not throw a
     * {@code ClassCastException} for any elements {@code e1} and
     * {@code e2} in the set.  If the user attempts to add an element
     * to the set that violates this constraint (for example, the user
     * attempts to add a string element to a set whose elements are
     * integers), the {@code add} call will throw a
     * {@code ClassCastException}.
     */
    public TreeSet() {
        this(new TreeMap<>());
    }
我们在这里可以发现,它竟然是调用了一个参数是TreeMap的构造方法。也就是说,它竟然是基于TreeMap实现的,我们再来看看TreeSet这个构造方法的源码:
    /**
     * Constructs a set backed by the specified navigable map.
     */
    TreeSet(NavigableMap<E,Object> m) {
        this.m = m;
    }
我们发现这里面有个m对象,这个对象又是什么?我们定位一下:
    /**
     * The backing map.
     */
    private transient NavigableMap<E,Object> m;
这里面有个新的东西是NavigableMap,我们继续转到它的定义看看它又是什么?我们可以看到它实际上拓展了SortedMap接口:
public interface NavigableMap<K,V> extends SortedMap<K,V>而当我们转到SortedMap接口时,我们会发现它又拓展了Map接口:
public interface SortedMap<K,V> extends Map<K,V> 所以说原来TreeSet的底层实现是TreeMap。但是这时候会有一个问题,我们这个TreeMap在add的时候可是有两个参数的啊,这个TreeSet怎么就只有一个参数啊?我们接下来去看一下这个add的源码:
    /**
     * Adds the specified element to this set if it is not already present.
     * More formally, adds the specified element {@code e} to this set if
     * the set contains no element {@code e2} such that
     * {@code Objects.equals(e, e2)}.
     * If this set already contains the element, the call leaves the set
     * unchanged and returns {@code false}.
     *
     * @param e element to be added to this set
     * @return {@code true} if this set did not already contain the specified
     *         element
     * @throws ClassCastException if the specified object cannot be compared
     *         with the elements currently in this set
     * @throws NullPointerException if the specified element is null
     *         and this set uses natural ordering, or its comparator
     *         does not permit null elements
     */
    public boolean add(E e) {
        return m.put(e, PRESENT)==null;
    }
原来我们在调用TreeSet的add方法时,本质上其实是去调用TreeMap中的add方法,并且不管放入什么元素,我们这个键值对的V部分都是放了一个叫PRESENT的东西。那这个PRESENT又是什么东西?我们转过去看一下:
    // Dummy value to associate with an Object in the backing Map
    private static final Object PRESENT = new Object();
所以这个东西就是一个Object类实例化出的一个对象而已。这也就解释了TreeMap中的K和TreeSet中元素的一些相似性的来由。
关于Set和TreeSet需要注意的部分可以总结为如下几点,首先Set是继承自Collection的一个接口类;其次Set中只存储了key,并且要求key一定要唯一;然后TreeSet的底层是使用Map来实现的,其使用key与Object的一个默认对象作为键值对插入到Map中的;并且Set最大的功能就是对集合中的元素进行去重;此外,实现Set接口的常用类有TreeSet和HashSet,还有一个LinkedHashSet,LinkedHashSet是在HashSet的基础上维护了一个双向链表来记录元素的插入次序;接着Set中的Key不能修改,如果要修改,先将原来的删除掉,然后再重新插入;最后TreeSet中不能插入null的key,HashSet可以。
HashSet在文章后部分会讲到,我们先在这里大致讲下TreeSet和HashSet的区别:
| Set底层结构 | TreeSet | HashSet |
|---|---|---|
| 底层结构 | 红黑树 | 哈希桶 |
| 插入/删除/查找时间复杂度 | O(logN) | O(1) |
| 是否有序 | 关于Key有序 | 不一定有序 |
| 线程安全 | 不安全 | 不安全 |
| 插入/删除/查找区别 | 按照红黑树的特性来进行插入和删除 | 先计算key哈希地址,然后进行插入和删除 |
| 比较与覆写 | key必须能够比较,否则会抛出ClassCastException异常 | 自定义类型需要覆写equals和hashCode方法 |
| 应用场景 | 需要Key有序场景下 | Key是否有序不关心,需要更高的时间性能 |
二、哈希表:
顺序结构以及平衡树中,元素关键码与其存储位置之间没有对应的关系,因此在查找一个元素时,必须要经过关键码的多次比较。顺序查找时间复杂度为O(N),平衡树中为树的高度,即O(logN),搜索的效率取决于搜索过程中元素的比较次数。
比较理想的搜索方法就是可以不经过任何比较,一次直接从表中得到要搜索的元素。 如果构造一种存储结构,通过某种函数(hashFunc)使元素的存储位置与它的关键码之间能够建立一一映射的关系,那么在查找时通过该函数可以很快找到该元素。
当向该结构中插入元素时,根据待插入元素的关键码,以此函数计算出该元素的存储位置并按此位置进行存放;搜索元素时,对元素的关键码进行同样的计算,把求得的函数值当做元素的存储位置,在结构中按此位置取元素比较,若关键码相等,则搜索成功。该方式即为哈希(散列)方法,哈希方法中使用的转换函数称为哈希(散列)函数,构造出来的结构称为哈希表(Hash Table,或者称散列表)。
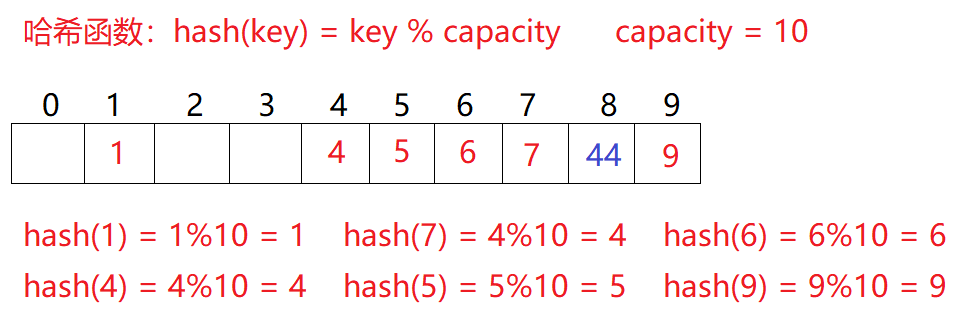
比如说我们把哈希函数设置为hash(key) = key % capacity,capacity为存储元素底层空间总的大小。那么我们就可以看见下面这种的例子,用该方法进行搜索不必进行多次关键码的比较,因此搜索的速度比较快。
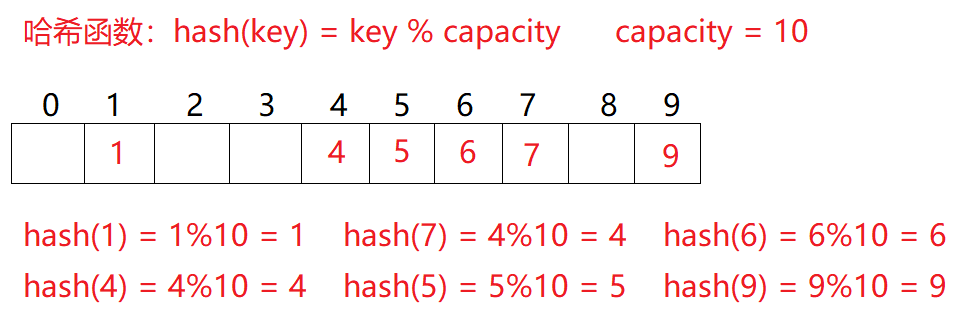
但是哈希表无可避免的一个问题就是哈希冲突。什么是哈希冲突呢?举个例子,在上面这个图的基础上,如果我们插入一个44元素,此时它就会与原来的元素4分到同一个位置,此时就发生了哈希碰撞。所以说,对于两个数据元素的关键字ki和kj(i != j),有ki!=kj,但有:Hash(ki) == Hash(kj),也即不同关键字通过相同哈希哈数计算出相同的哈希地址,该种现象称为哈希冲突或哈希碰撞。同时,我们把具有不同关键码而具有相同哈希地址的数据元素称为同义词。
既然有发生冲突的可能,那么我们应该如何避免它发生呢?首先,我们需要明确一点,由于我们哈希表底层数组的容量往往是小于实际要存储的关键字的数量的,这就导致一个问题,冲突的发生是必然的,但我们能做的应该是尽量的降低冲突率。
引起哈希冲突的一个原因可能是哈希函数设计不够合理。 哈希函数设计原则是哈希函数的定义域必须包括需要存储的全部关键码,而如果散列表允许有m个地址时,其值域必须在0到m-1之间;并且哈希函数计算出来的地址能均匀分布在整个空间中;最后哈希函数应该比较简单。
我们常见的哈希函数有如下的几种常见设计方法:
最常用的就是直接定址法。我们取关键字的某个线性函数为散列地址,Hash(Key) = A*Key + B。它的优点就是简单均匀,但是缺点是需要事先知道关键字的分布情况。它的使用场景是适合查找比较小且连续的情况。
领一个比较常用的就是除留余数法。我们先设散列表中允许的地址数为m,取一个不大于m,但最接近或者等于m的质数p作为除数,按照哈希函数Hash(key) = key% p(p<=m),将关键码转换成哈希地址。
下一种就是平方取中法。假设关键字为1234,对它平方就是1522756,抽取中间的3位227作为哈希地址; 再比如关键字为4321,对它平方就是18671041,抽取中间的3位671(或710)作为哈希地址。平方取中法比较适合不知道关键字的分布,而位数又不是很大的情况。
然后是折叠法。它是将关键字从左到右分割成位数相等的几部分(最后一部分位数可以短些),然后将这几部分叠加求和,并按散列表表长,取后几位作为散列地址。折叠法适合事先不需要知道关键字的分布,关键字位数比较多的情况。
下一个是随机数法。我们选择一个随机函数,取关键字的随机函数值为它的哈希地址,即H(key) = random(key),其中random为随机数函数。通常应用于关键字长度不等时采用此法。
最后则是数学分析法,设有n个d位数,每一位可能有r种不同的符号,这r种不同的符号在各位上出现的频率不一定相同,可能在某些位上分布比较均匀,每种符号出现的机会均等,在某些位上分布不均匀只有某几种符号经常出现。可根据散列表的大小,选择其中各种符号分布均匀的若干位作为散列地址。
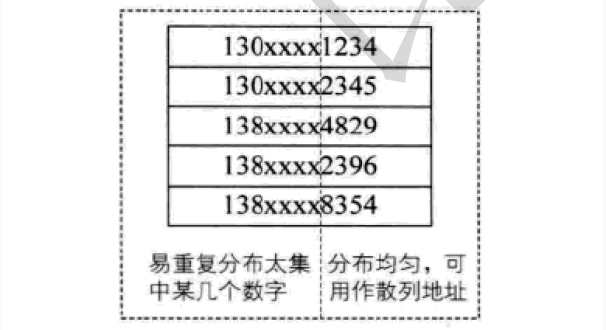
假设要存储某家公司员工登记表,如果用手机号作为关键字,那么极有可能前7位都是相同的,那么我们可以选择后面的四位作为散列地址,如果这样的抽取工作还容易出现冲突,还可以对抽取出来的数字进行反转(如1234改成4321)、右环位移(如1234改成4123)、左环移位、前两数与后两数叠加(如1234改成12+34=46)等方法。
数字分析法通常适合处理关键字位数比较大的情况,以及如果事先知道关键字的分布且关键字的若干位分布较均匀的情况。还是需要强调一下,哈希函数设计的越精妙,产生哈希冲突的可能性就越低,但是无法避免哈希冲突。
我们除了可以设计巧妙地哈希函数,还可以通过负载因子去调节。那么什么是负载因子呢?
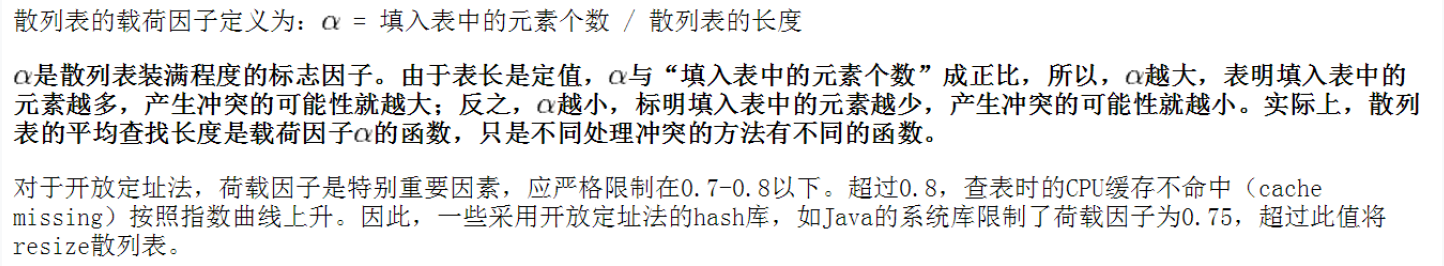
我们可以粗略地演示一下负载因子和冲突率的关系:
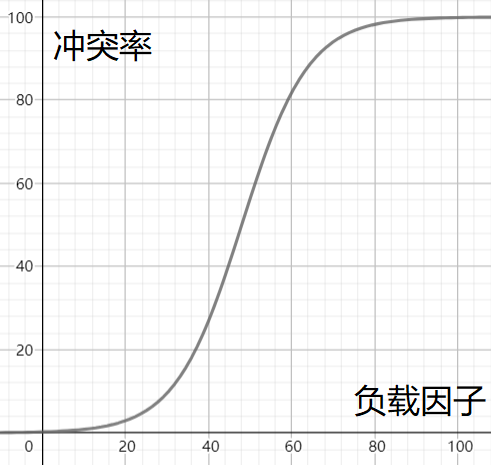
所以当冲突率达到一个无法忍受的程度时,我们需要通过降低负载因子来变相的降低冲突率。已知哈希表中已有的关键字个数是不可变的,那我们能调整的就只有哈希表中的数组的大小。
解决哈希冲突两种常见的方法是闭散列和开散列。闭散列也叫开放定址法,当发生哈希冲突时,如果哈希表未被装满,说明在哈希表中必然还有空位置,那么可以把key存放到冲突位置中的下一个空位置中去。那如何寻找下一个空位置呢?
第一种方法叫做线性探测,比如上面的场景,现在需要插入元素44,先通过哈希函数计算哈希地址,下标为4,因此44理论上应该插在该位置,但是该位置已经放了值为4的元素,即发生哈希冲突。线性探测就会从发生冲突的位置开始,依次向后探测,直到寻找到下一个空位置为止。我们会通过哈希函数获取待插入元素在哈希表中的位置,如果该位置中没有元素则直接插入新元素,如果该位置中有元素发生哈希冲突,使用线性探测找到下一个空位置,插入新元素。
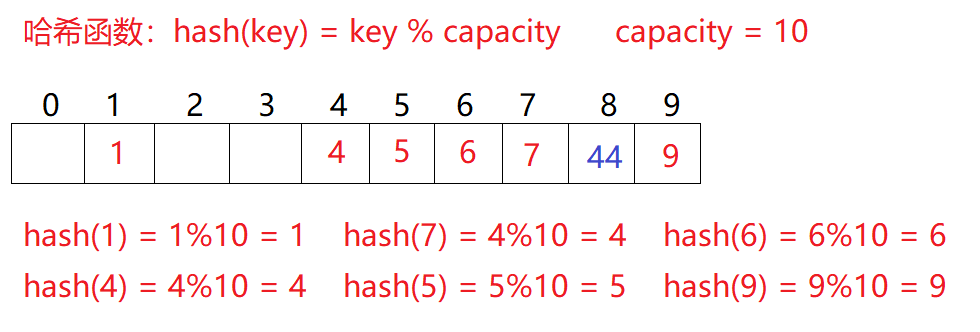
但是需要注意,采用闭散列处理哈希冲突时,不能随便物理删除哈希表中已有的元素,若直接删除元素会影响其他元素的搜索。比如删除元素4,如果直接删除掉,44查找起来可能会受影响。因此线性探测采用标记的伪删除法来删除一个元素。
第二种方法是二次探测。线性探测的缺陷是产生冲突的数据堆积在一块,这与其找下一个空位置有关系,因为找空位置的方式就是挨着往后逐个去找,因此二次探测为了避免该问题,找下一个空位置的方法为:
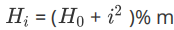
或者是这种:
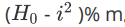
其中i = 1,2,3…, 是通过散列函数Hash(x)对元素的关键码 key 进行计算得到的位置,m是表的大小。 对于上面的情况中如果要插入44,产生冲突,使用解决后的情况为下面这张图。
研究表明,当表的长度为质数且表装载因子a不超过0.5时,新的表项一定能够插入,而且任何一个位置都不会被探查两次。因此只要表中有一半的空位置,就不会存在表满的问题。在搜索时可以不考虑表装满的情况,但在插入时必须确保表的装载因子a不超过0.5,如果超出必须考虑增容。因此比散列最大的缺陷就是空间利用率比较低,这也是哈希的缺陷。
而开散列法又叫链地址法(开链法),首先对关键码集合用散列函数计算散列地址,具有相同地址的关键码归于同一子集合,每一个子集合称为一个桶,各个桶中的元素通过一个单链表链接起来,各链表的头结点存储在哈希表中。
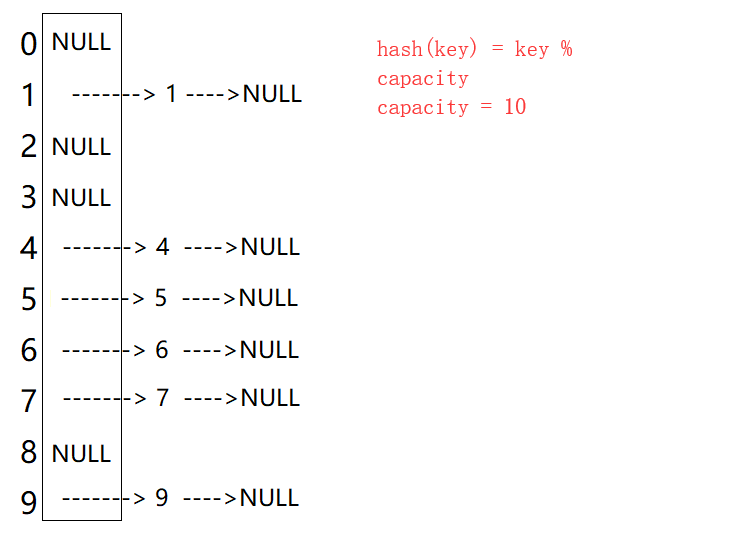
从上图可以看出,开散列中每个桶中放的都是发生哈希冲突的元素。所以开散列可以认为是把一个在大集合中的搜索问题转化为在小集合中做搜索了。那如果冲突严重,就意味着小集合的搜索性能其实也时不佳的,这个时候我们就可以将这个所谓的小集合搜索问题继续进行转化,例如可以每个桶的背后是另一个哈希表,或者每个桶的背后是一棵搜索树。
在Java中的HashMap其实也是使用数组+链表的形式实现的,但是有个很特殊的点就是链表在特定的情况下会变成红黑树。这个判定的条件就是当数组长度超过64并且链表长度超过了8。
虽然哈希表一直在和冲突做斗争,但在实际使用过程中,我们认为哈希表的冲突率是不高的,冲突个数是可控的,也就是每个桶中的链表的长度是一个常数,所以,通常意义下,我们认为哈希表的插入/删除/查找时间复杂度是O(1) 。
对于哈希表和Java类集的关系,我们可以做出下面的总结。 首先HashMap和HashSet是Java中利用哈希表实现的Map和Set;其次Java中使用的是哈希桶方式解决冲突的;并且Java会在冲突链表长度大于一定阈值后,将链表转变为搜索树(红黑树);最后,Java中计算哈希值实际上是调用的类的hashCode方法,进行key的相等性比较是调用key的equals方法。所以如果要用自定义类作为HashMap的key或者HashSet的值,必须覆写hashCode和equals方法,而且要做到equals相等的对象,hashCode一定是一致的。
接下来我们就按照这种链地址法来自行尝试实现一个哈希表。通过我们上面的分析,其实可以很容易想到,我们只需要实现一个链表数组就可以了。这个哈希表存放的就是每个链表的头节点。读者可先自行思考如何去实现,我这里给出我的代码:
public class HashBuck {
    static class Node{
        public int val;
        public int key;
        public Node next;

        public Node(int val, int key){
            this.val = val;
            this.key = key;
        }
    }

    public Node[] array = new Node[10];
    public int usedSize;
}
我们首先要去进行实现的就是在表内实现插入数据,为了方便我在这里使用头插的方式去实现,当然尾插也是可以的,并且哈希函数我们就是用取模的那种。这个实现完全使用我们之前写过的方法,所以我不多做说明。读者可以自行实现,我这里给出我的代码:
    public void push(int key, int val){
        int index = key % array.length;
        Node cur = array[index];
        while(cur != null){
            if(cur.key == key){
                cur.val = val;
                break;
            }
            cur = cur.next;
        }
        Node node = new Node(key, val);
        node.next = array[index];
        array[index] = node;
        usedSize++;
    }
但是如果我们出于现实考虑的话,我们的哈希表是需要负载因子这个指标来衡量的,所以必要的计算负载因子的方法和相应的扩容就是必要的。但是我们这里需要先考虑一个问题,如果说扩容的话,我们应该扩谁?答案当然就是数组。但是如果数组扩容的话,我们直接用如下的代码可以吗:
array = Arrays.copyOf(array, 2 * array.length);答案是不可以。这是为什么?因为如果我们真的这么做的话,会出现一个问题。比如说原先表长为10的时候我们键值为4和14的两个节点都会进入下表为4的链表。担当我们扩容之后,有可能表长就比14大了,此时14再去取模的话就会和原来的余数不同,此时就必须要换到正确的位置了。也就是说,为了保证扩容之后程序的正确,我们必须在扩容后遍历元素进行重新分配。总体来说,我们有如下的代码:
    public static final double DEFAULT_LOAD_FACTOR = 0.75f;

    public void push(int key, int val){
        int index = key % array.length;
        Node cur = array[index];
        while(cur != null){
            if(cur.key == key){
                cur.val = val;
                break;
            }
            cur = cur.next;
        }
        Node node = new Node(key, val);
        node.next = array[index];
        array[index] = node;
        usedSize++;
        if(doLoadFactor() >= DEFAULT_LOAD_FACTOR){
            resize();
        }
    }

    private void resize(){
        Node[] newArray = new Node[array.length * 2];
        for(int i = 0; i < array.length; i++){
            Node cur = array[i];
            while(cur != null){
                int newIndex = cur.key % newArray.length;
                Node curN = cur.next;
                cur.next = newArray[newIndex];
                newArray[newIndex] = cur;
                cur = curN;
            }
        }
        array = newArray;
    }

    private double doLoadFactor(){
        return usedSize * 1.0 / array.length;
    }
我们可以用如下代码进行测试:
public class Main {
    public static void main(String[] args) {
        HashBuck hashBuck = new HashBuck();
        hashBuck.push(1,9);
        hashBuck.push(11,9);
        hashBuck.push(14,9);
        hashBuck.push(4,9);
        hashBuck.push(2,9);
        hashBuck.push(15,9);
        hashBuck.push(6,9);
        hashBuck.push(5,9);
    }
}
给最后一行加断点,之后进行调试,我们会有如下的结果:
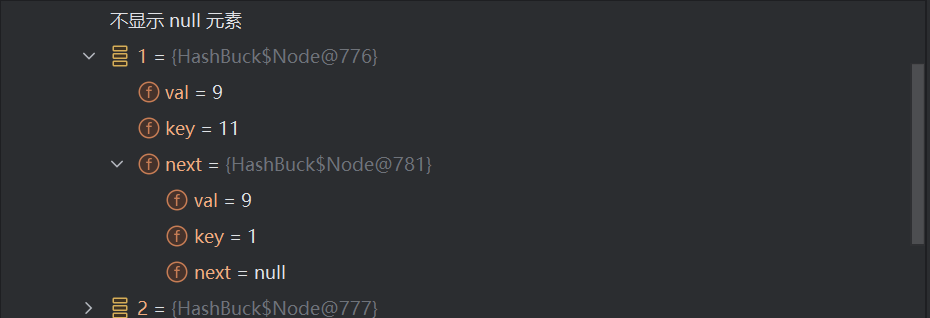
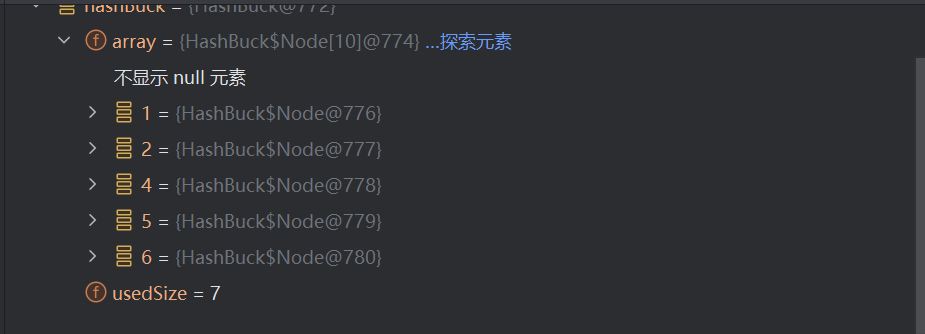
我们看一下此时运行断点所在的语句是什么情况:
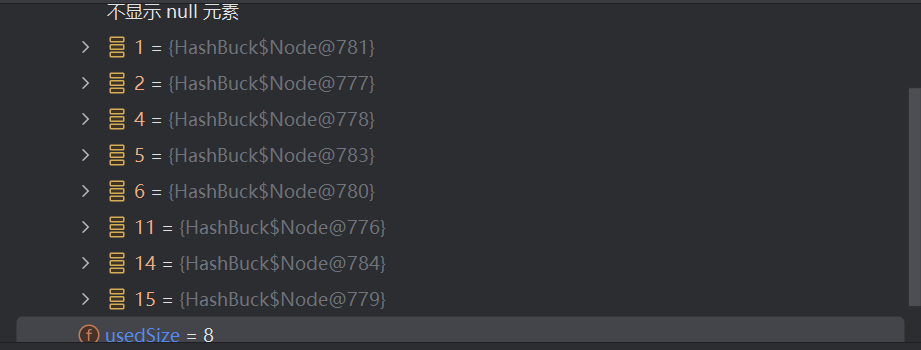
此时说明已经扩容成功了,并且键值也分配到了正确的位置。接下来我们就写一下获取元素的方法,这个也比较简单,读者可以自行实现,我这里给出我的代码:
    public int getVal(int key, int val){
        int index = key % array.length;
        Node cur = array[index];
        while(cur != null){
            if(cur.key == key){
                return cur.val;
            }
            cur = cur.next;
        }
        return -1;
    }
我们将测试代码修改为如下形式:
public class Main {
    public static void main(String[] args) {
        HashBuck hashBuck = new HashBuck();
        hashBuck.push(1,1);
        hashBuck.push(11,11);
        hashBuck.push(14,14);
        hashBuck.push(4,4);
        hashBuck.push(2,2);
        hashBuck.push(15,15);
        hashBuck.push(6,6);
        hashBuck.push(5,5);

        System.out.println(hashBuck.getVal(11));
    }
}
其运行结果如下:
相对来说我们上面实现的哈希桶其实有一个局限性,就是我们这里的key它是一个整型,这也就意味着他可以参加运算。但是如果说我们是用于引用类型的话,我们该如何操作呢?所以我们再度进行一个关于泛型的实现。读者可以直接看我的代码,这里不多做说明:
public class HashBuck2<K, V>{

    static class Node<K, V> {
        public K key;
        public V val;
        public Node<K, V> next;

        public Node(K key, V val) {
            this.key = key;
            this.val = val;
        }
    }

    public Node<K, V>[] array = (Node<K, V>[]) new Node[10];
    public int usedSize;

    public static final double DEFAULT_LOAD_FACTOR = 0.75f;

    public void push(K key, V val){
        int hashcode = key.hashCode();
        int index = hashcode % array.length;

        Node<K, V> cur = array[index];
        while(cur != null){
            if(cur.key.equals(key)){
                cur.val = val;
                return;
            }
            cur = cur.next;
        }
        Node<K, V> node = new Node<>(key, val);

        node.next = array[index];
        array[index] = node;
        usedSize++;
    }

    public V getVal(K key){
        int hashcode = key.hashCode();
        int index = hashcode % array.length;

        Node<K, V> cur = array[index];
        while(cur != null){
            if(cur.key.equals(key)){
                return cur.val;
            }
            cur = cur.next;
        }
        return null;
    }

}
我们使用如下测试代码:
import java.util.Objects;

class Person{
    public String id;

    public Person(String id){
        this.id = id;
    }

    @Override
    public boolean equals(Object o) {
        if (o == null || getClass() != o.getClass()) return false;
        Person person = (Person) o;
        return Objects.equals(id, person.id);
    }

    @Override
    public int hashCode() {
        return Objects.hashCode(id);
    }
}
public class Main {

    public static void main(String[] args) {
        Person person1 = new Person("1234");
        Person person2 = new Person("1234");

        System.out.println(person1.hashCode());
        System.out.println(person2.hashCode());

        System.out.println(person1.equals(person2));

    }
}
其运行结果如下:
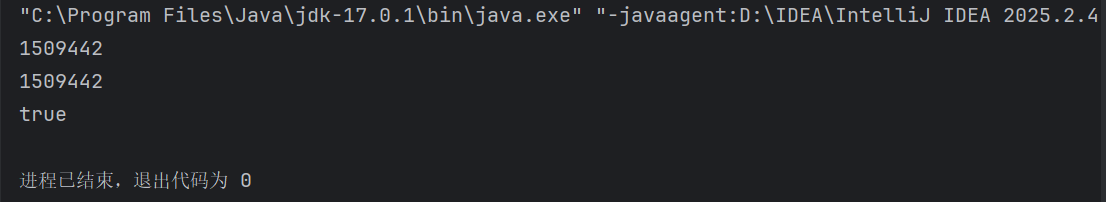
在这里建议读者如果以后读者自行实现一个类之后,最好把toString、hashCode还有equals这些方法都通过IDEA的生成功能实现重写,以满足实际的需求。
三、OJ测试题:
第一道测试题链接如下:136. 只出现一次的数字 - 力扣(LeetCode)
这道题的思路很简单,就是通过集合的去重来实现解决问题。读者可先自行尝试,我这里给出我的代码:
class Solution {
    public int singleNumber(int[] nums) {
        HashSet<Integer> set = new HashSet<>();
        for(int i = 0; i < nums.length; i++){
            if(set.contains(nums[i])){
                set.remove(nums[i]);
            }else{
                set.add(nums[i]);
            }
        }
        for(int i = 0; i < nums.length; i++){
            if(set.contains(nums[i])){
                return nums[i];
            }
        }
        return -1;
    }
}
第二道题测试链接如下:138. 随机链表的复制 - 力扣(LeetCode)
我的思路就是采用HashMap建立原节点和新节点之间的映射关系,从而完成带随机指针链表的深拷贝。整体思路可以分为两步。
第一步,先遍历原链表,根据每一个原节点创建一个值相同的新节点,并将二者放入哈希表中。哈希表中的key是原链表中的节点,value是对应创建出来的新节点。经过这一步之后,所有节点本身都已经被复制出来了,但是新节点之间的next和random指针关系还没有建立。
第二步,再次遍历原链表,根据原链表中每个节点的next和random指向关系,去哈希表中找到对应的新节点,然后给复制节点的next和random赋值。例如,原节点cur的next指向cur.next,那么新节点map.get(cur)的next就应该指向map.get(cur.next);原节点cur的random指向cur.random,那么新节点map.get(cur)的random就应该指向map.get(cur.random)。这样就能保证新链表中的指针关系和原链表完全一致,同时不会指向原链表中的节点。
我的代码如下:
/*
// Definition for a Node.
class Node {
    int val;
    Node next;
    Node random;

    public Node(int val) {
        this.val = val;
        this.next = null;
        this.random = null;
    }
}
*/

class Solution {
    public Node copyRandomList(Node head) {
        HashMap<Node, Node> map = new HashMap<>();
        Node cur = head;
        while(cur != null){
            map.put(cur, new Node(cur.val));
            cur = cur.next;
        }
        cur = head;
        Node newHead = map.get(head);
        while(cur != null){
            map.get(cur).next = map.get(cur.next);
            map.get(cur).random = map.get(cur.random);
            cur = cur.next;
        }
        return newHead;
    }
}
第三道题目测试链接如下:771. 宝石与石头 - 力扣(LeetCode)
这道题的思路相对来说比较简单,我这里不多做说明,读者可自行实现,我这里给出我的代码:
class Solution {
    public int numJewelsInStones(String jewels, String stones) {
        HashSet<Character> set = new HashSet<>();
        for(int i = 0; i < jewels.length(); i++){
            set.add(jewels.charAt(i));
        }
        int num = 0;
        for(int i = 0; i < stones.length(); i++){
            if(set.contains(stones.charAt(i))){
                num++;
            }
        }
        return num;
    }
}
第四道题目测试链接如下:旧键盘 (20)__牛客网
这道题的核心思路是通过对比应该输入的字符串和实际输入的字符串来找出坏掉的按键。由于题目要求英文字母统一输出大写,并且同一个字母键不区分大小写,所以代码一开始先把两个字符串都转换成大写,这样后续比较时就不会受到大小写影响。接着,使用一个HashSet保存实际输入字符串中出现过的所有字符,因为HashSet可以快速判断某个字符是否存在。然后再按照顺序遍历应该输入的字符串,如果某个字符没有出现在实际输入的字符集合中,就说明这个字符对应的按键可能坏掉了。但是题目还要求每个坏键只输出一次,所以代码又使用了另一个HashSet来记录已经输出过的坏键,防止重复打印。这样一来,只有当某个字符既没有出现在实际输入结果中,又没有被输出过时,才会将它作为坏键输出。由于遍历的是原本应该输入的字符串,所以坏键的输出顺序自然就是它们在原字符串中第一次出现的顺序。我的代码如下:
import java.util.Scanner;
import java.util.HashSet;

// 注意类名必须为 Main, 不要有任何 package xxx 信息
public class Main {
    public static void main(String[] args) {
        Scanner in = new Scanner(System.in);
        String a = in.next();
        String b = in.next();
        func(a, b);
    }

    public static void func(String a, String b){
        a = a.toUpperCase();
        b = b.toUpperCase();
        HashSet<Character> set = new HashSet<>();
        for(int i = 0; i < b.length(); i++){
            char ch = b.charAt(i);
            set.add(ch);
        }
        HashSet<Character> setb = new HashSet<>();
        for(int i = 0; i < a.length(); i++){
            char ch = a.charAt(i);
            if(!set.contains(ch) && !setb.contains(ch)){
                setb.add(ch);
                System.out.print(ch);
            }
        }
    }
}
第五道题目测试链接如下:692. 前K个高频单词 - 力扣(LeetCode)
我们整体思路是先用哈希表统计每个单词出现的次数,再用一个大小为k的小根堆维护当前出现频率最高的k个单词。首先,代码遍历words数组,把每个单词作为key,把它出现的次数作为value存入HashMap中。如果某个单词第一次出现,就放入次数1;如果之前已经出现过,就在原有次数的基础上加1。这样处理完之后,map中就保存了每个单词及其对应的出现频率。
接下来,创建一个优先级队列PriorityQueue,也就是小根堆,用来保存当前排名前k的单词。这里最关键的是比较器的设计,如果两个单词出现次数不同,那么出现次数少的优先级更高,会排在堆顶;如果两个单词出现次数相同,那么字典序更大的单词优先级更高,也会排在堆顶。这样设计的目的,是让堆顶始终保存当前k个候选单词中最差的那个单词。因为题目要求最终结果按照出现次数从高到低排序,如果次数相同,则字典序小的排在前面,所以在维护前k个单词时,出现次数少的单词应该优先被淘汰;当出现次数相同时,字典序更大的单词也应该优先被淘汰。因此,这个小根堆的堆顶就是当前最应该被替换掉的元素。
随后,遍历哈希表中的每一个键值对。如果堆中的元素数量还没有达到k,就直接把当前单词加入堆中;如果堆的大小已经等于k,就拿当前单词和堆顶元素比较。如果当前单词出现次数更多,说明它比堆顶元素更应该进入前k,于是弹出堆顶并加入当前单词;如果当前单词和堆顶元素出现次数相同,但当前单词的字典序更小,也说明当前单词排名更靠前,同样需要替换堆顶。遍历结束后,堆中剩下的就是出现频率最高的k个单词。由于小根堆每次弹出的是当前堆中排名相对靠后的元素,所以直接依次poll得到的顺序是从低到高的,并不是题目要求的顺序。因此最后把这些单词加入list后,使用Collections.reverse(list)进行反转,得到最终按照频率从高到低,频率相同按字典序从小到大的结果。
我的代码如下:
class Solution {
    public List<String> topKFrequent(String[] words, int k) {
        HashMap<String, Integer> map = new HashMap<>();
        for(String word : words){
            if(map.get(word) == null){
                map.put(word, 1);
            }else{
                int val = map.get(word);
                map.put(word, val + 1);
            }
        }

        PriorityQueue<Map.Entry<String, Integer>> minHeap = new PriorityQueue<>(new Comparator<Map.Entry<String, Integer>>(){
            public int compare(Map.Entry<String, Integer> o1, Map.Entry<String, Integer> o2){
                if(o1.getValue().compareTo(o2.getValue()) == 0){
                    return o2.getKey().compareTo(o1.getKey());
                }
                return o1.getValue().compareTo(o2.getValue());
            }
        });
        for(Map.Entry<String, Integer> entry : map.entrySet()){
            if(minHeap.size() < k){
                minHeap.offer(entry);
            }else{
                Map.Entry<String, Integer> top = minHeap.peek();
                if(top.getValue().compareTo(entry.getValue()) < 0){
                    minHeap.poll();
                    minHeap.offer(entry);
                }else if(top.getValue().compareTo(entry.getValue()) == 0){
                    if(top.getKey().compareTo(entry.getKey()) > 0){
                        minHeap.poll();
                        minHeap.offer(entry);
                    }
                }
            }
        }
        ArrayList<String> list = new ArrayList<>();
        for(int i = 0; i < k; i++){
            Map.Entry<String, Integer> tmp = minHeap.poll();
            list.add(tmp.getKey());
        }
        Collections.reverse(list);
        return list;
    }
}
总结
本文系统介绍了Java中的Set接口及其实现类,重点分析了TreeSet和HashSet的底层实现机制与区别。TreeSet基于TreeMap实现,使用红黑树结构保证元素有序性,插入/查找时间复杂度为O(logN);HashSet基于哈希表实现,通过哈希函数快速定位元素,平均时间复杂度为O(1)。文章深入探讨了哈希表原理,包括哈希函数设计、冲突解决方法(开放定址法和链地址法),并通过代码示例实现了一个简易哈希表。最后通过5个LeetCode/牛客网题目展示Set和Map的实际应用场景,包括查找唯一元素、深拷贝链表、统计词频等典型问题解决方案。特别强调了自定义类作为HashSet元素或HashMap键时需要正确重写hashCode和equals方法的重要性。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 9
 0
- 0


 已为社区贡献14条内容

所有评论(0)