Bright Data Web Scraping 指南:使用 API 采集 Instagram 与 TikTok KOL 数据,构建海外社媒营销情报系统
一、出海团队的 KOL 数据困局
海外增长团队真正缺少的不是更多 KOL 名单,而是一套能够持续获取、分析和筛选社媒数据的基础设施。当人工整理 Instagram 和 TikTok 数据无法支撑规模化营销时,Web Scraping API 可以帮助团队自动构建实时 KOL 数据管道。
真正的问题不是"找不到 KOL",而是没有批量、结构化的数据去科学筛选 KOL。凭感觉选网红,踩坑率极高——粉丝数看起来漂亮,实际互动率只有 0.3%;博主内容风格对了,但最近 60 天几乎不更新;垂类对了,但评论区全是水军。
这篇文章要解决的,就是这个问题:用 Bright Data 的 Web Scraper API,采集 Instagram 和 TikTok 公开页面数据,并转换为结构化 Web Data,再配合一套评分模型,输出可落地执行的 KOL 候选名单。 全程代码开源,文末附 GitHub 仓库地址。
想快速验证 Instagram 和 TikTok 数据采集效果?立即体验 Bright Data Web Scraper API,使用结构化数据接口构建你的 KOL 分析流程。
二、为什么是 Bright Data?
处理社媒数据采集,通常有三条路:
| 方案 | 优势 | 问题 |
| 平台官方 API | 官方合规 | 字段极残缺,TikTok API 尤其严格,配额极低 |
| 自建爬虫 | 灵活可控 | 需持续维护反爬对抗,Cloudflare / 指纹检测成本高 |
| 传统第三方数据 | 开箱即用 | 数据新鲜度差,字段固定,通常按年订阅价格高 |
Bright Data 是全球最大的合规网络数据基础设施平台。Bright Data Scraper API 通过代理基础设施、浏览器环境和数据解析能力,帮助开发者处理复杂的数据访问场景,以标准化 JSON 实时交付数据。调用一个 HTTP 接口即可拿到完整字段,后续无需自行维护基础设施。
本文用到的两个数据采集器:
-
Instagram Profile Scraper(
dataset_id: gd_l1vikfch901nx3by4):实时返回 followers、posts_count、avg_engagement、biography、is_verified 等 30+ 字段 -
TikTok Profile Scraper(
dataset_id: gd_l1villgoiiidt09ci):实时返回 followers、likes、videos_count、awg_engagement_rate、is_verified、biography 等核心字段
三、环境准备
3.1 注册账号并获取 API Key
前往 www.bright.cn 注册账号,新用户可获得免费测试额度。登录后进入控制台:
-
左侧导航点击 爬取器
-
进入 Scrapers marketplace,搜索 Instagram Profile 和 TikTok Profile
-
右上角点击账号头像 → Settings → API Tokens 生成 Token
3.2 项目目录结构
kol-intelligence/
├── scrapers/
│   ├── base_scraper.py       # 基类:封装 Scraper API 调用逻辑
│   ├── instagram_scraper.py
│   └── tiktok_scraper.py
├── models/
│   └── kol_scorer.py         # KOL 三维评分模型
├── data/
│   ├── raw/                  # 原始 JSON
│   └── processed/            # 评分后 CSV
├── notebooks/
│   └── kol_analysis.ipynb    # 可视化分析
├── config.yaml
├── main.py
└── requirements.txt
3.3 安装依赖
pip install requests pandas numpy matplotlib seaborn pyyaml四、核心原理:Scraper API 工作流程
Bright Data Scraper API 使用 /datasets/v3/scrape 端点,同步实时返回,无需轮询:
POST https://api.brightdata.com/datasets/v3/scrape?dataset_id=xxx¬ify=false&include_errors=true
Body: {"input": [{"url": "https://www.instagram.com/hindash/"}, ...], "limit_per_input": null}它在云端帮你完成以下工作:
-
通过住宅 IP 代理向目标平台发起请求
-
处理动态页面渲染、验证码挑战和访问限制场景
-
提取关键字段,以结构化 JSON 返回
五、Instagram KOL 数据采集
5.1 基类:封装 Scraper API
# scrapers/base_scraper.pyimport requests, json, logging
from pathlib import Path
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

class BaseScraper:
    SCRAPE_URL = "https://api.brightdata.com/datasets/v3/scrape"def __init__(self, api_key: str, dataset_id: str):
        self.dataset_id = dataset_id
        self.headers = {
            "Authorization": f"Bearer {api_key}",
            "Content-Type": "application/json",
        }
        session = requests.Session()
        retry = Retry(total=3, backoff_factor=2, status_forcelist=[429,500,502,503,504])
        session.mount("https://", HTTPAdapter(max_retries=retry))
        self.session = session
        self.log = logging.getLogger(self.__class__.__name__)

    def scrape(self, urls: list, output_path: str,
               extra_fields: dict = None, limit_per_input: int = None) -> list:
        inputs = []
        for u in urls:
            item = {"url": u}
            if extra_fields:
                item.update(extra_fields)
            inputs.append(item)

        resp = self.session.post(
            self.SCRAPE_URL,
            headers=self.headers,
            params={"dataset_id": self.dataset_id,
                    "notify": "false", "include_errors": "true"},
            json={"input": inputs, "limit_per_input": limit_per_input},
            timeout=120,
        )
        resp.raise_for_status()
        records = self._parse(resp.text)

        Path(output_path).parent.mkdir(parents=True, exist_ok=True)
        Path(output_path).write_text(
            json.dumps(records, ensure_ascii=False, indent=2), encoding="utf-8")
        self.log.info("采集完成:%d 条 → %s", len(records), output_path)
        return records

    def _parse(self, text: str) -> list:
        text = text.strip()
        try:
            r = json.loads(text)
            return r if isinstance(r, list) else [r]
        except json.JSONDecodeError:
            pass# NDJSON 逐段解析(兼容含换行的 biography 字段)
        records, decoder, pos = [], json.JSONDecoder(), 0while pos < len(text):
            while pos < len(text) and text[pos] in ' \t\r\n':
                pos += 1if pos >= len(text):
                breaktry:
                obj, pos = decoder.raw_decode(text, pos)
                records.append(obj)
            except json.JSONDecodeError:
                pos += 1return records
5.2 Instagram 采集器
# scrapers/instagram_scraper.pyfrom .base_scraper import BaseScraper

class InstagramScraper(BaseScraper):
    DATASET_ID = "gd_l1vikfch901nx3by4"def __init__(self, api_key: str):
        super().__init__(api_key, self.DATASET_ID)

    def collect(self, usernames: list, output_path: str) -> list:
        urls = [f"https://www.instagram.com/{u.lstrip('@')}/" for u in usernames]
        return self.scrape(urls, output_path)
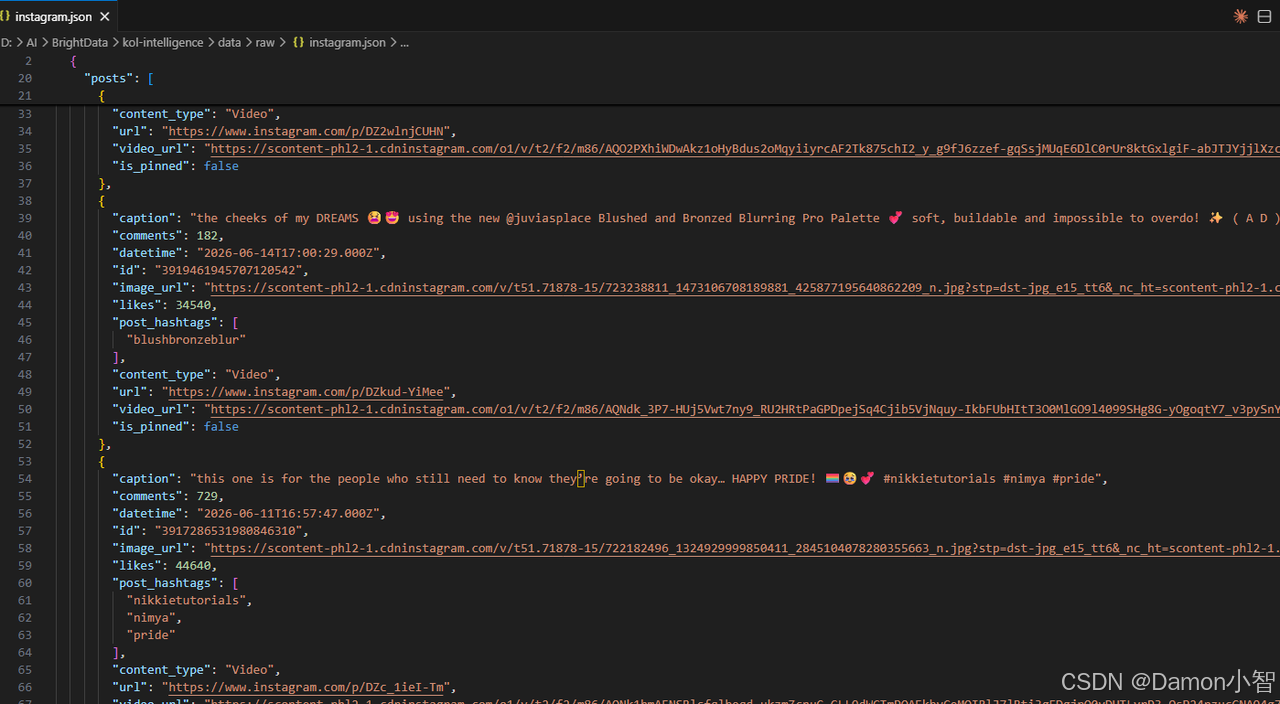
实测采集 10 个美妆 KOL 仅需约 10 秒,返回真实数据如下:
{"account": "hindash","followers": 1550734,"posts_count": 2258,"avg_engagement": 0.0016,"is_verified": true,"biography": "Artist, Founder and CEO of Hindash Cosmetics","is_business_account": true,"following": 312}采集截图:
六、TikTok KOL 数据采集
TikTok 官方 Research API 申请门槛极高,数据字段也极为有限。Bright Data 的 TikTok Scraper API 通过代理基础设施和浏览器环境,支持采集 TikTok 公开主页数据,payload 中额外携带 country 字段以支持定向采集:
# scrapers/tiktok_scraper.pyfrom .base_scraper import BaseScraper

class TikTokScraper(BaseScraper):
    DATASET_ID = "gd_l1villgoiiidt09ci"def __init__(self, api_key: str):
        super().__init__(api_key, self.DATASET_ID)

    def collect(self, usernames: list, output_path: str, country: str = "") -> list:
        urls = [f"https://www.tiktok.com/@{u.lstrip('@')}" for u in usernames]
        return self.scrape(urls, output_path, extra_fields={"country": country})
TikTok 返回的核心字段包括 followers、likes(总获赞数)、videos_count、awg_engagement_rate(互动率)、is_verified、biography。其中 awg_engagement_rate 是 TikTok 独有的高价值字段,直接反映内容质量。
已经有采集脚本,但不想长期维护代理、IP 轮换和数据访问基础设施?Bright Data Web Scraper API 可以帮助团队将数据采集流程产品化。
七、KOL 三维评分模型
拿到原始数据后,核心工作是从采集结果中筛出真正值得合作的 KOL。这里构建一个三维加权模型,Instagram 和 TikTok 分别使用不同的互动率阈值(两个平台的行业基准差异显著):
7.1 评分维度与权重
| 维度 | 满分 | Instagram 阈值 | TikTok 阈值 |
| 粉丝量级 | 30 | 1M+=30, 500K+=26, 100K+=22, 10K+=14 | 同左 |
| 互动率 | 50 | ≥3%=50, ≥1%=42, ≥0.3%=34, ≥0.1%=22 | ≥8%=50, ≥5%=42, ≥3%=34, ≥1%=22 |
| 内容活跃度 | 20 | posts_count / 5,上限 20 | videos_count / 5,上限 20 |
Instagram 品牌号均值互动率约 0.05–0.5%,与 TikTok 的 3–8% 差距悬殊,必须分平台设阈值。
7.2 评分实现
# models/kol_scorer.py(核心逻辑)from dataclasses import dataclass

@dataclassclass KOLScore:
    username: str
    platform: str
    followers: int
    engagement_rate: float
    total_score: float
    tier: str        # S / A / B / C
    is_verified: bool
    bio_snippet: strdef score_kol(profile: dict, platform: str) -> KOLScore:
    if platform == "instagram":
        followers = int(profile.get("followers", 0) or 0)
        er = float(profile.get("avg_engagement", 0) or 0) * 100
        posts = int(profile.get("posts_count", 0) or 0)
        username = profile.get("account", "")
        is_verified = bool(profile.get("is_verified", False))
        bio = str(profile.get("biography", "") or "")
    else:  # tiktok
        followers = int(profile.get("followers", 0) or 0)
        er = float(profile.get("awg_engagement_rate", 0) or 0) * 100
        posts = int(profile.get("videos_count", 0) or 0)
        username = profile.get("nickname", "")
        is_verified = bool(profile.get("is_verified", False))
        bio = str(profile.get("biography", "") or "")

    f_score = _follower_score(followers)
    e_score = _engagement_score(er, platform)
    a_score = min(posts / 5.0, 20.0)
    total   = f_score + e_score + a_score

    return KOLScore(
        username=username, platform=platform, followers=followers,
        engagement_rate=round(er, 3), total_score=round(total, 2),
        tier=_tier(total), is_verified=is_verified, bio_snippet=bio[:60]
    )
7.3 真实采集结果 Top 10
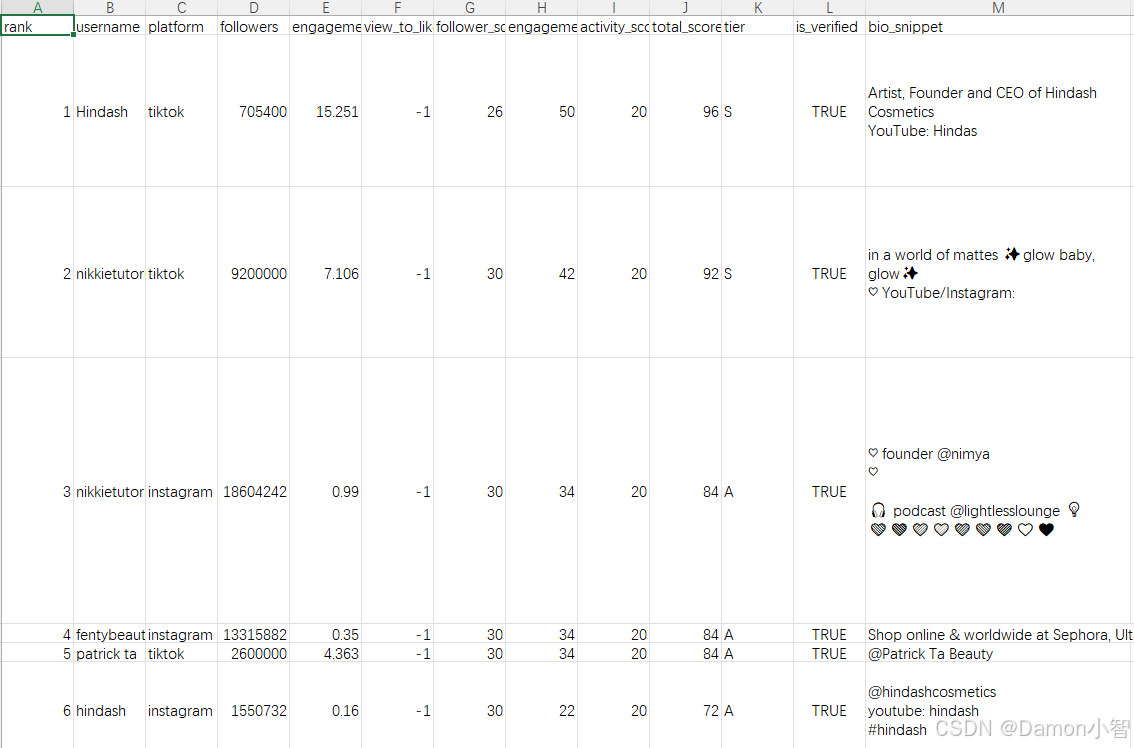
对 20 个美妆垂类账号(10 Instagram + 10 TikTok)实测评分结果:
| 排名 | 账号 | 平台 | 粉丝数 | 互动率 | 综合分 | 等级 |
| 1 | Hindash | TikTok | 70.5 万 | 15.25% | 96 | S |
| 2 | nikkietutorials | TikTok | 920 万 | 7.11% | 92 | S |
| 3 | nikkietutorials | 1860 万 | 0.99% | 84 | A | |
| 4 | fentybeauty | 1331 万 | 0.35% | 84 | A | |
| 5 | patrick ta | TikTok | 260 万 | 4.36% | 84 | A |
| 6 | hindash | 155 万 | 0.16% | 72 | A | |
| 7 | bretmanrock | TikTok | 1950 万 | 1.53% | 72 | A |
| 8 | hudabeauty | 5609 万 | 0.07% | 58 | B | |
| 9 | makeupbymario | 1384 万 | 0.06% | 58 | B | |
| 10 | GLAMZILLA | TikTok | 280 万 | 0.86% | 58 | B |
八、数据可视化
对采集结果可视化,直观展示 KOL 分布规律:
import matplotlib.pyplot as plt, seaborn as sns
import matplotlib.font_manager as fm

fm._load_fontmanager(try_read_cache=False)  # 重建字体缓存
sns.set_theme(style="whitegrid")
plt.rcParams["font.sans-serif"] = ["SimHei"]  # 注意:必须在 set_theme 之后设置
plt.rcParams["axes.unicode_minus"] = False
等级分布 + 互动率直方图:

粉丝数 vs 互动率全景图:

从图中可以看出:
-
TikTok 腰部 KOL(70–260 万粉)互动率显著高于头部,Hindash(70.5万粉,互动率 15.25%)远超 bretmanrock(1950 万粉,互动率 1.53%)
-
Instagram 品牌号互动率普遍低于 1%,但粉丝体量大,适合曝光型合作而非转化型合作
-
S/A 级 KOL 集中在左上角(低粉高互动),是性价比最高的合作对象
九、主程序串联
# main.pyimport yaml
from scrapers.instagram_scraper import InstagramScraper
from scrapers.tiktok_scraper import TikTokScraper
from models.kol_scorer import batch_score, merge_platforms

cfg = yaml.safe_load(open("config.yaml", encoding="utf-8"))
key = cfg["bright_data"]["api_key"]

ig = InstagramScraper(key)
ig.collect(cfg["targets"]["instagram"], "data/raw/instagram.json")

tt = TikTokScraper(key)
tt.collect(cfg["targets"]["tiktok"], "data/raw/tiktok.json")

df_ig = batch_score("data/raw/instagram.json", platform="instagram")
df_tt = batch_score("data/raw/tiktok.json", platform="tiktok")
combined = merge_platforms(df_ig, df_tt)
combined.to_csv("data/processed/all_kol_ranked.csv", encoding="utf-8-sig")
一键运行,约 1 分钟完成 20 个账号的采集 + 评分 + 跨平台排名输出:
python main.py输出 Excel 如下:
十、总结
这套方案的核心价值在于:把原本需要 2 天人工整理的 KOL 初筛工作,压缩到 1 分钟内自动完成。
-
Bright Data Web Scraper API 通过代理基础设施和数据解析能力,帮助团队处理复杂的数据访问场景,调用方式与普通 HTTP 请求无异
-
评分模型针对 Instagram 和 TikTok 的行业基准分别设置阈值,避免跨平台比较失真
-
输出的 CSV 可直接导入品牌 Brief,S/A 级名单即为优先接洽对象
本文所有代码已开源,包含完整采集模块 + 评分模型 + Notebook + 示例数据:
GitHub 仓库:https://github.com/LiuGuangzhi/kol-intelligence
下载后填入
config.yaml中的 API Key,运行python main.py即可复现本文全部结果。
从人工搜索 KOL,到自动化社媒数据分析,下一步是建立属于你的 Web Data Pipeline。开始使用 Bright Data,将 Instagram、TikTok 等公开数据转化为可执行的营销洞察。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 8
 0
- 0


 已为社区贡献23条内容

所有评论(0)