【保姆级教程】Dify工作流终极指南:从入门到精通(附案例)
前言: 很多朋友在尝试构建复杂的AI应用时,常常会感觉像在搭一个巨大的乐高城堡,却缺少一份清晰的图纸。今天,这篇教程就是你的“图纸”。我将带你系统地学习Dify平台的工作流编排,从最基础的节点、变量,到完整的五阶段实施框架,让你彻底告别“手足无措”,真正实现从想法到高效、可扩展AI应用的落地。
一、核心概念解析
在开始编排之前,我们必须先弄懂工作流的“基本零件”。
1. 节点(Node)
-
定义:
工作流的基本单元,通过连接不同功能节点实现流程自动化。
-
核心节点:
-
开始节点:
定义工作流启动参数(如输入文件、API密钥)。
-
结束节点:
标记工作流终止(仅Workflow类型)。
-
回复节点:
Chatflow中用于输出内容(支持流式输出)。
2. 变量(Variable)
-
系统变量:
全局预设参数(如
sys.user_id、sys.files)。 -
环境变量:
保护敏感信息(如API密钥),全局只读。
-
会话变量:
多轮对话中临时存储数据(如用户偏好),可读写。
3. 工作流类型
- Chatflow:
-
场景:
对话类任务(客服、语义搜索)。
-
特性:
支持多轮交互、内置Memory、流式输出。
- Workflow:
-
场景:
自动化批处理(翻译、数据分析)。
-
特性:
无Memory、线性执行、以End节点终止。
互动一下: 大家在实际项目中,更多地是使用Chatflow还是Workflow呢?欢迎在评论区分享你的应用场景!
深度阅读:
Dify的一些关键概念
Dify中的变量
二、节点、模型、插件能力详解
Dify的强大之处在于其丰富的“工具箱”。了解每个工具的用途,才能游刃有余。
1. 核心节点功能表
| 节点名称 | 类型 | 功能描述 |
|---|---|---|
| 开始 (Start) | 核心节点 | 定义工作流启动的初始参数,作为流程起点。 |
| 结束 (End) | 核心节点 | 定义工作流结束的最终输出内容,作为流程终点。 |
| 回复 (Answer) | 核心节点 | 定义Chatflow中的回复内容,直接输出给用户。 |
| 大语言模型 (LLM) | AI/模型节点 | 调用大语言模型处理自然语言任务(如生成、推理)。 |
| 知识检索 | 数据处理 | 从知识库中检索与用户问题相关的文本内容。 |
| 问题分类 | AI/模型节点 | 通过LLM对用户输入进行分类,匹配预定义分类标签。 |
| 条件分支 (IF/ELSE) | 控制流节点 | 根据条件判断将流程拆分为两个分支。 |
| 代码执行 (Code) | 数据处理 | 运行Python/NodeJS代码实现自定义逻辑。 |
| 模板转换 (Template) | 数据处理 | 使用Jinja2模板语言动态生成文本。 |
| 变量聚合 | 数据处理 | 合并多路分支的变量输出,统一传递给下游节点。 |
| 参数提取器 | 数据处理 | 从自然语言或上下文中提取结构化参数。 |
| 迭代 (Iteration) | 控制流节点 | 对列表对象逐项执行操作,直至处理完所有元素。 |
| HTTP请求 | 外部交互 | 通过HTTP协议发送请求,获取外部数据或触发服务。 |
| 工具 (Tools) | 外部交互 | 调用内置工具、自定义工具或子工作流。 |
| 变量赋值 | 数据处理 | 将固定值或计算结果写入可写变量。 |
| 循环 (Loop) | 控制流节点 | 重复执行任务直至满足退出条件。 |
2. 模型分类及能力
Dify集成了丰富的模型,不同的模型适用于不同的战场。
-
系统推理模型:
负责大脑中枢,进行理解、生成和推理。如GPT系列、Claude系列、文心一言、通义千问等。
-
Embedding模型:
文本/图像的“翻译官”,将其转化为机器能理解的向量。
-
Rerank模型:
搜索结果的“精炼师”,提升检索相关性。
-
语音转文字模型:
实现“耳听为实”,进行高准确率的语音识别。
3. 插件(工具)及能力
插件让你的AI应用拥有“十八般武艺”,能联网、会画图、能计算。Dify最新版已上线插件市场 (Marketplace),极大地扩展了能力边界。
-
谷歌搜索/维基百科:
让AI拥有实时信息检索能力。
-
DALL-E/Stable Diffusion:
赋予AI绘画创作的能力。
-
网页抓取:
自动获取指定网页的数据。
-
WolframAlpha:
强大的科学计算和知识问答引擎。
-
…等等,市场还在不断丰富中。
互动一下: 除了官方插件,你还用代码节点或HTTP请求封装过哪些好用的第三方工具?来评论区给大伙种种草!
三、五阶段实施框架详解
这套框架是我总结的“武功秘籍”,遵循这五个步骤,再复杂的流程也能被清晰地构建出来。
- 阶段1:需求分析与目标定义
-
明确业务场景:
是做对话客服(Chatflow),还是数据批处理(Workflow)?
-
定义核心目标:
比如,“文章智能分析系统”需要完成爬取→初评→翻译→总结。
-
设计输入输出:
输入是URL还是文件?输出是JSON还是文本?
- 阶段2:工作流设计与模块化拆分
-
节点技术选型:
根据第一步的目标,从上面的节点库中挑选合适的“零件”。
-
模块化设计原则:
将复杂流程拆解为独立的子任务(如“票据类型识别”与“具体票据解析”分离),便于维护和复用。
- 阶段3:模型与工具集成
-
模型选型与调优:
多模态用Qwen-VL,长文本生成用GPT-4。别忘了用提示词IDE优化你的Prompt!
-
外部服务接入:
通过HTTP请求节点配置API密钥,接入外部服务。
- 阶段4:测试与迭代优化
-
单节点调试:
利用日志追踪功能,检查每个节点的输入输出是否符合预期。
-
性能优化:
思考能否并行处理,能否通过数据分片减少单次负载。
-
容错与异常处理:
用IF/ELSE分支处理异常情况,让你的工作流更健壮。
- 阶段5:部署与维护
-
发布方式:
可以封装为可复用的工具,也可以部署为API集成到现有系统中。
-
本地化部署:
通过Docker搭建私有环境,保障数据隐私。
-
持续监控:
跟踪API调用成本、响应时间,定期迭代优化。
四、最佳实践与案例
理论结合实践,才能融会贯通。
-
复用标准化模板:
将成熟的工作流导出为JSON配置,实现跨项目复用。
-
混合应用模式:
结合Agent与工作流,让Agent负责动态决策,工作流执行固定流程。
-
CLI与API集成:
通过命令行参数触发不同分支,实现更灵活的调用。
五、注意事项
-
数据安全:
API密钥等敏感信息,务必使用Dify的环境变量进行管理。
-
成本控制:
密切监控模型调用次数,对于简单任务,优先考虑使用性能足够且成本更低的开源模型。
这篇文章是不是你的“及时雨”?
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇
一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书
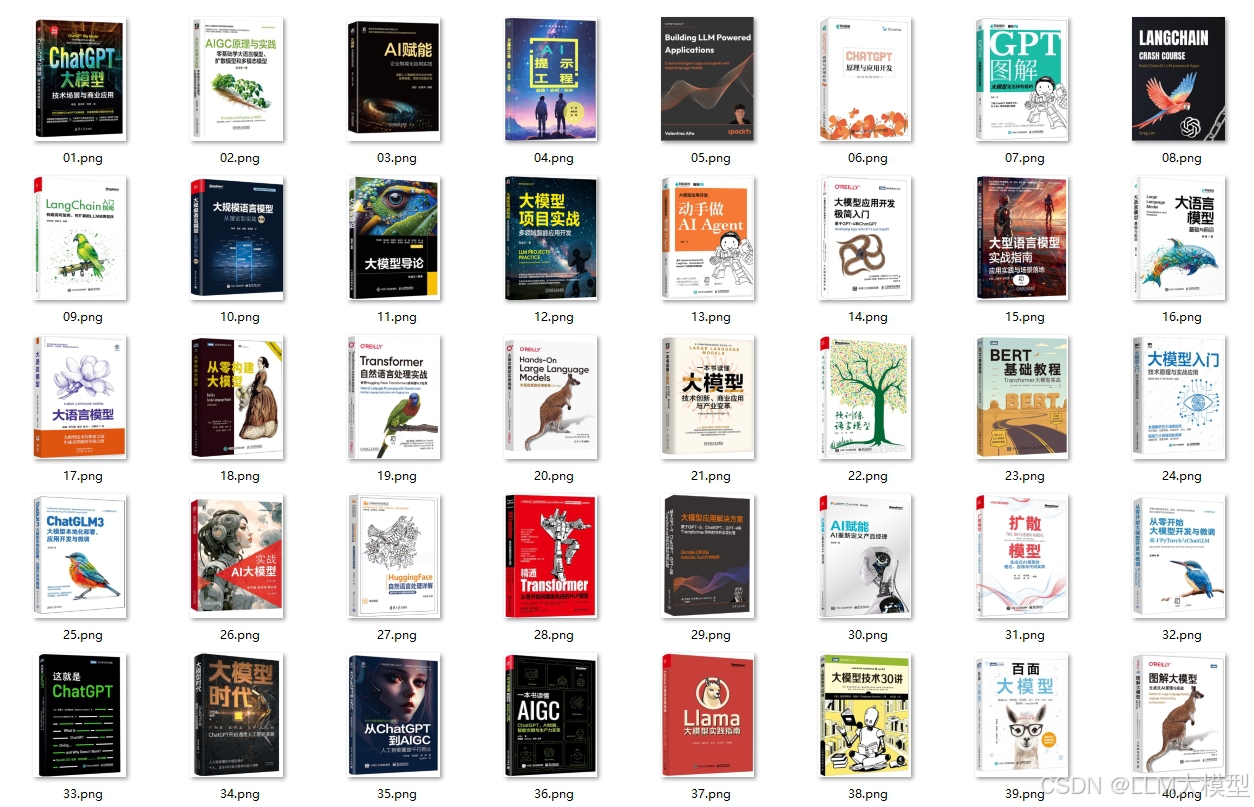
2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
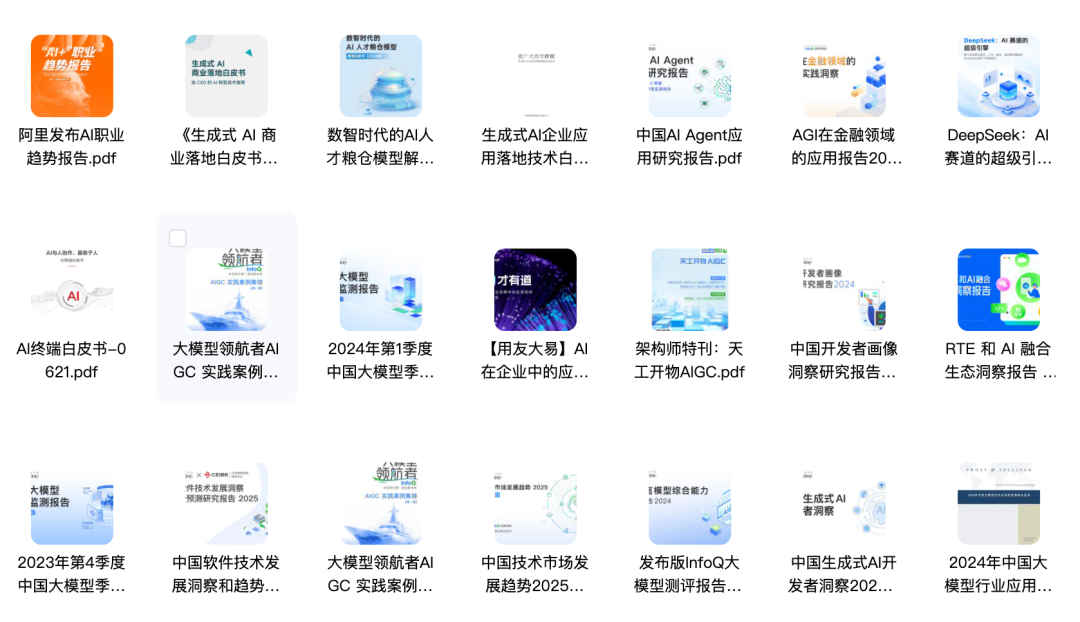
- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
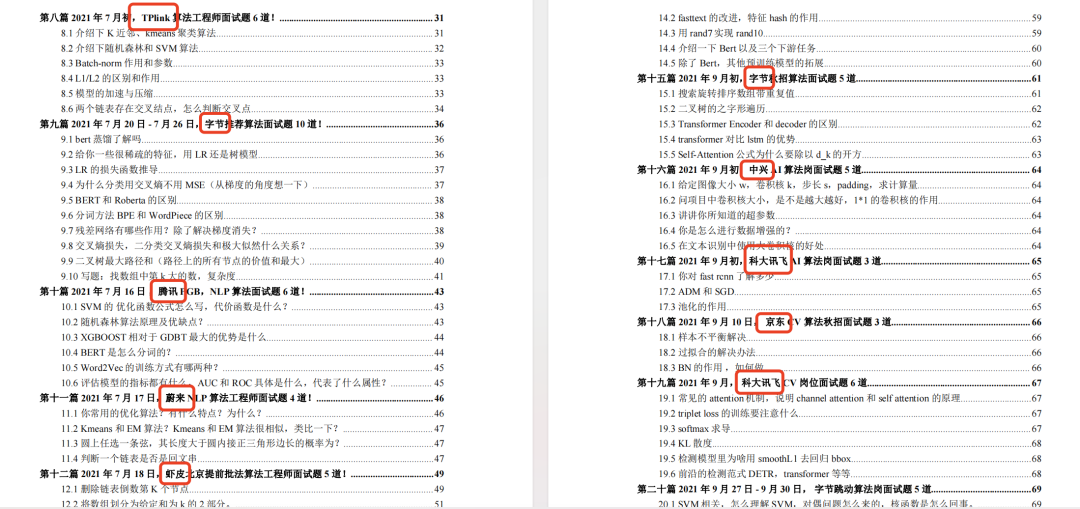
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
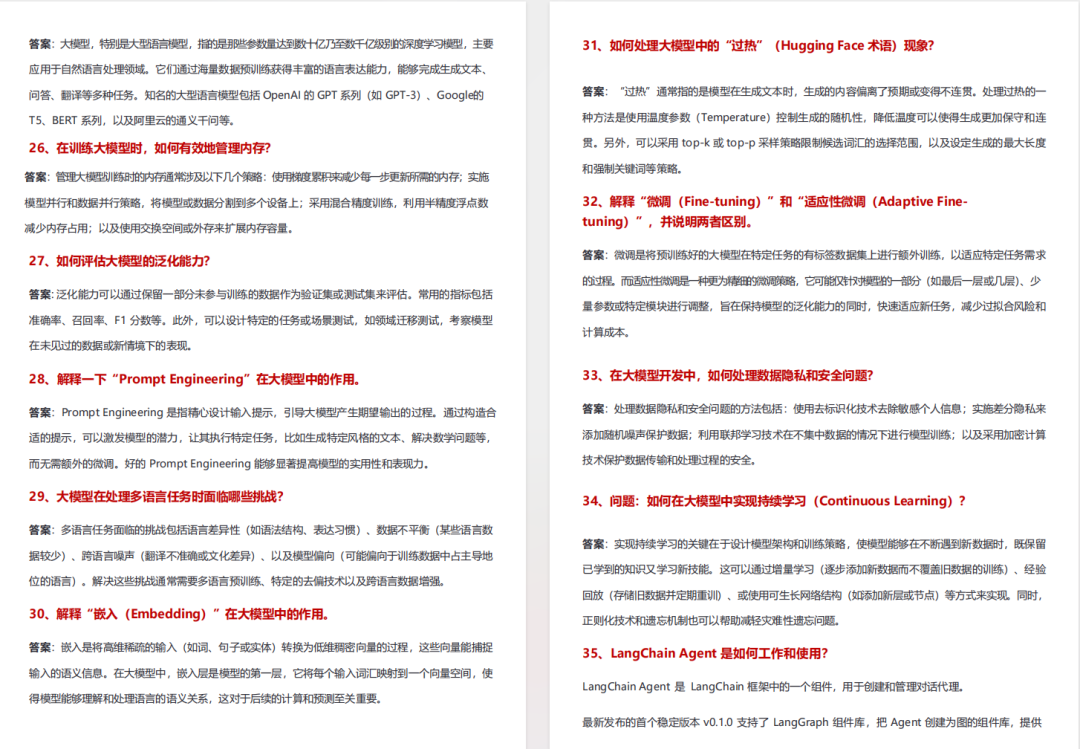
2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
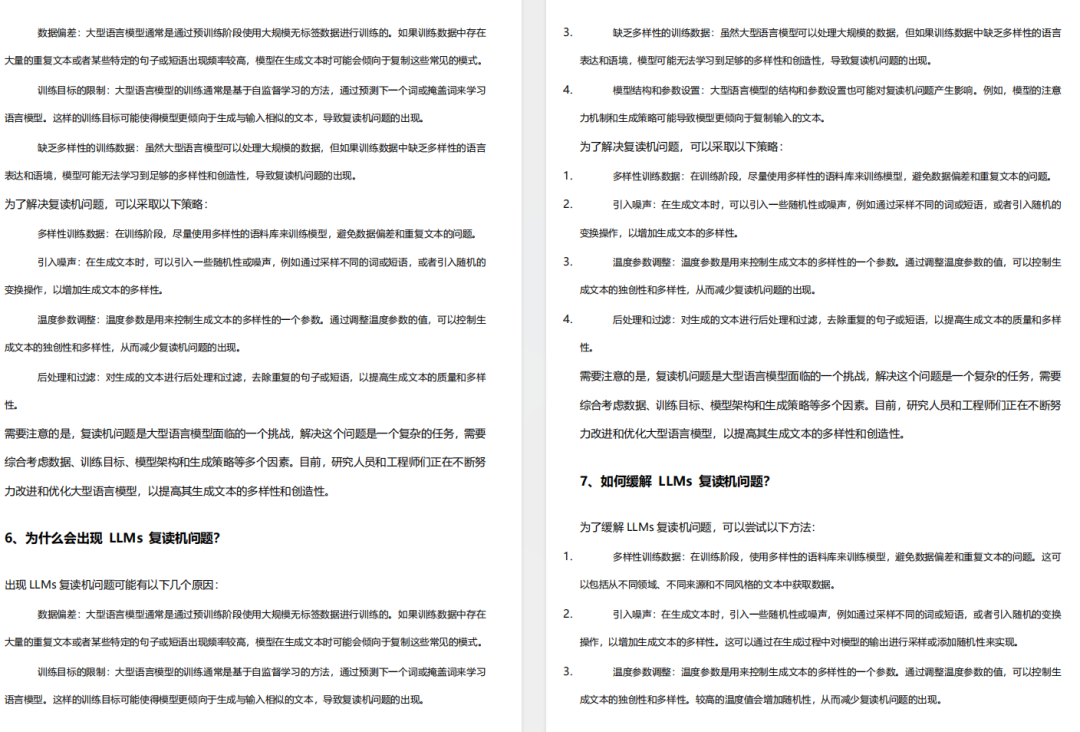
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:
三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
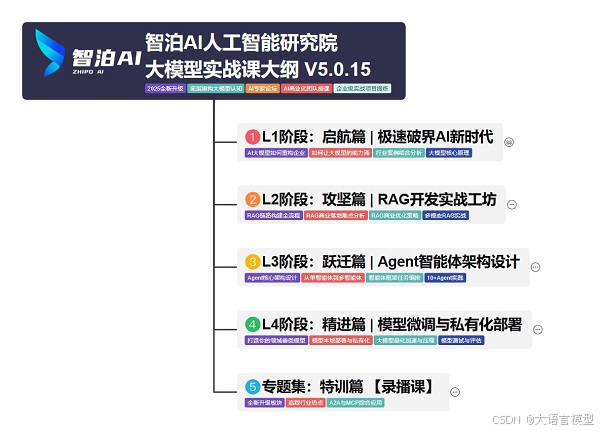
路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
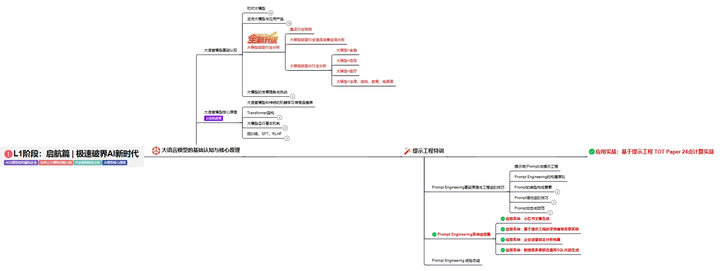
L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
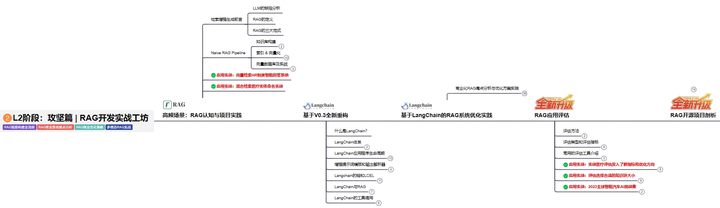
L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
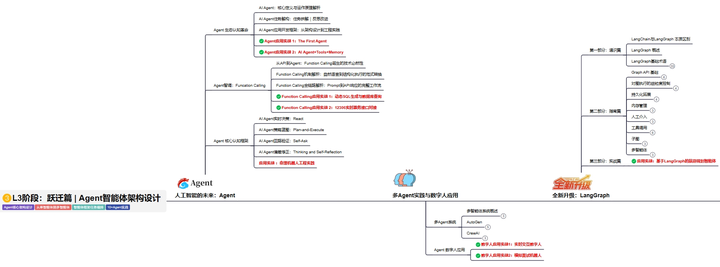
L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
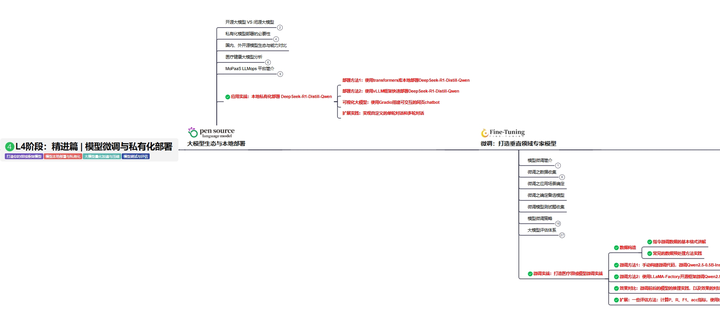
L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
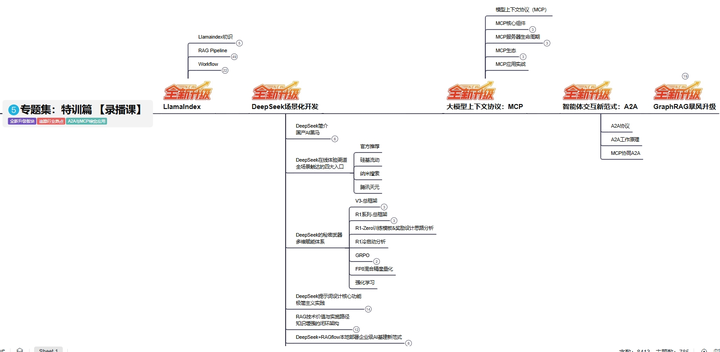
L5阶段:专题集丨特训篇 【录播课】
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 16
 0
- 0


 已为社区贡献65条内容

所有评论(0)