【自用】YOLOv8网络结构详解
前言知识可以看我的上一篇笔记,先理解一下卷积和池化的含义。【自用】卷积神经网络卷积运算和池化运算-CSDN博客
目录
YOLOv8网络结构框架
此处附上在各个教程中广为流传的结构图,这也是从别的博主那扒下来的。
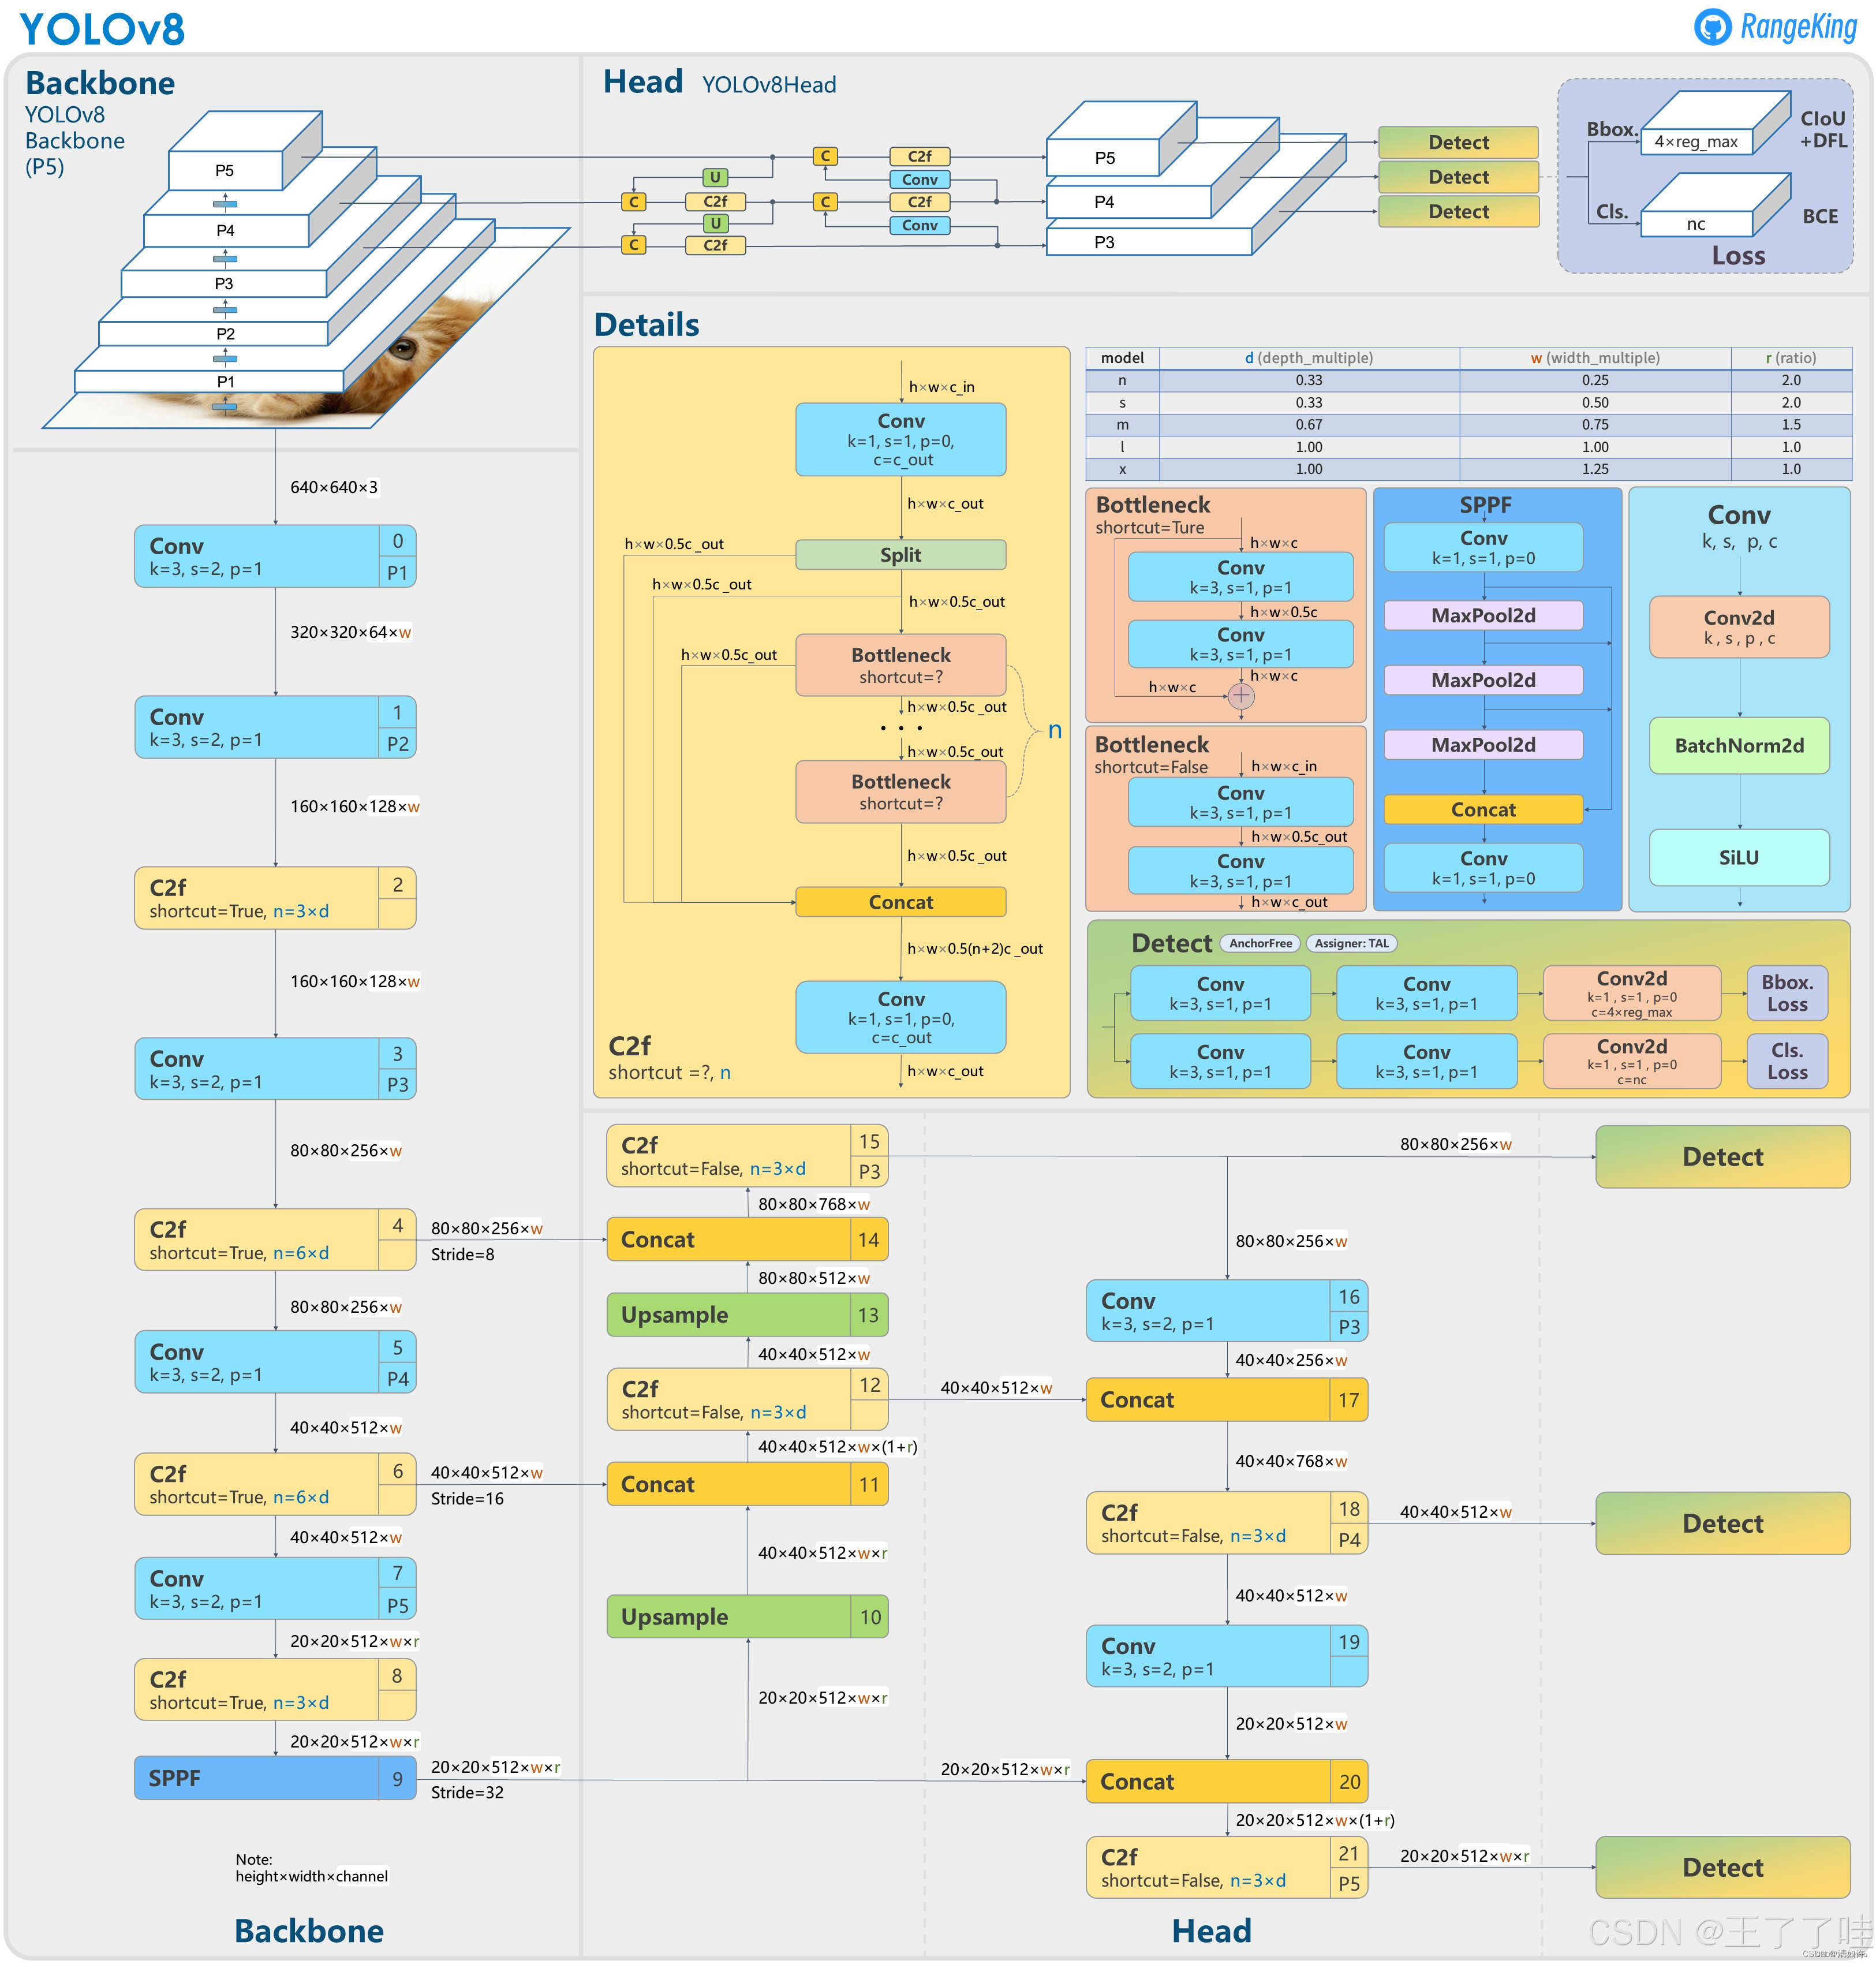
图1-1
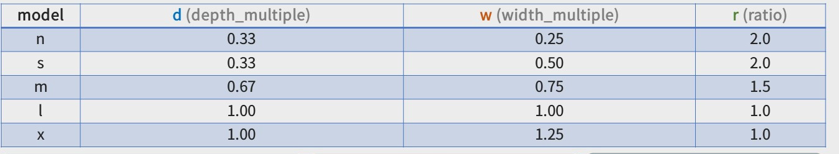
模型分类表
在上图的右上部分可以看见一个表格这个表格中的n,s,m,l,x指的是YOLOv8不同规模不同大小的模型。按照模型大小(参数数量)和性能排序:
- n:Nano(纳米级)→ 最小模型,参数最少,速度最快
- s:Small(小模型)→ 轻量模型,平衡速度与精度
- m:Medium(中模型)→ 中等规模,精度较高
- l:Large(大模型)→ 大规模,精度高
- x:Xtra-large(超大模型)→ 最大模型,精度最高,但速度最慢
表格中的d(depth_multiple)、w(width_multiple)、r(ratio)是YOLOv8模型缩放的三大核心参数,分别控制网络深度、网络宽度和锚框比例。
1. d(depth_multiple):深度乘数,调整网络的深度(即层的数量),控制模型的特征提取能力(深度越深,特征提取越复杂,精度越高,但速度越慢)。比如图中Backbone的第一个C2f中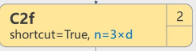 有n=3*d,代表这个C2f中Battleneck的数量
n = k × d计算(k为基础Bottleneck数量,d为深度乘数)。例如:C2f模块的基础Bottleneck数量为3(如n=3×d);s版本的d=0.33,则实际Bottleneck数量为3×0.33≈1(取整);x版本的d=1.0,则实际Bottleneck数量为3×1.0=3(保持基础深度)。即d越大模型程度越深
2.w(width_multiple):宽度乘数,调整网络的宽度(即卷积层的通道数),控制模型的特征表达能力(宽度越宽,通道数越多,特征越丰富,精度越高,但速度越慢)。YOLOv8中所有卷积层的输出通道数 由c = c_base × w计算(c_base为基础通道数,w为宽度乘数)。例如:第一层Conv层的基础通道数为64(如64×w);若s版本的w=0.5,则实际通道数为64×0.5=32;若x版本的w=1.25,则实际通道数为64×1.25=80(扩展宽度)。
3. r(ratio):锚框比例,调整锚框(Anchor)的宽高比,控制模型对不同形状目标的适应能力(如细长目标 vs 正方形目标)。r=2.0意味着目标框的宽:高=2:1(或高:宽=2:1),适合细长目标。接下来都以YOLOv8s的d,w,r举例。
表1-1
金字塔
在这幅图中首先映入眼帘的是左上角的金字塔结构。这个结构一共分为五层P1-P5,其中P1代表最高分辨率特征图,P5代表是最低分辨率特征图。其尺寸(分辨率)和通道数遵循以下规律:
尺寸递减:每经过一次下采样(Stride=2的卷积或池化),特征图尺寸减半(如640×640→320×320→160×160→80×80→40×40640×640→320×320→160×160→80×80→40×40);通道数递增:每经过一次特征提取(如Conv2d或C2f模块),通道数翻倍或按比例增加(如3→64→128→256→512→10243→64→128→256→512→1024,以YOLOv8-s版为例)。
因此不同层会产生不同的特征图以适配不同大小的目标,其特征差异是:
1.浅层特征图(P2∼P3P2∼P3:高分辨率,低语义)分辨率高:如P2=320×320P2=320×320、P3=160×160P3=160×160,保留了原始图像的细节信息(如小目标的边缘、纹理、颜色);通道数少:如P2=64P2=64、P3=128P3=128,语义信息较浅(仅能识别简单特征,如“边缘”“角落”);适配目标:小目标(如行人的脸、远处的路标),因为小目标的像素占比小,需要高分辨率才能捕捉到其细节。
2.深层特征图(P4∼P5P4∼P5:低分辨率,高语义)分辨率低:如P4=80×80P4=80×80、P5=40×40P5=40×40,经过多次下采样后,细节信息丢失(小目标的像素可能被合并为几个特征点);通道数多:如P4=256P4=256、P5=512P5=512,语义信息丰富(能识别复杂特征,如“猫的耳朵”“汽车的轮子”“人的轮廓”);适配目标:大目标(如汽车、建筑物),因为大目标的像素占比大,需要深层语义信息才能正确分类。
Backbone

在金字塔的下面紧接着就是Backbone,它一共有10层,其中最为关键的是C2f和SPPF
Conv层
可以观察到除第一个Conv外,每经过一个Conv,输出的特征图的大小就越小,通道就越多。而经过C2f后输入输出的大小并不会发生变化。在Conv层,输入的原始图片或者特征图进去之后先是经过卷积Conv2d特征提取与尺寸/通道变换,再经过批量归一化处理BathNorm2d用来加速网络训练并稳定模型,具体可以参考这篇博客深入解析 PyTorch 的 BatchNorm2d:原理与实现 - crazypigf - 博客园
最后经过激活函数层SiLU使网络能够学习复杂的非线性关系。
C2f层
假设该层的参数配置为:输入通道c1=128;输出通道c2=64(c_out=64);e=0.5(Split后的通道比例);n=2(2个Bottleneck,对应YOLOv8-s版n=6*d=6*0.33≈2)
流程拆解(结合代码和参数):
1x1卷积调整通道:
输入x(batch×128×h×w)通过self.cv1(1x1卷积)->输出cv1_x(batch×(128×0.5)=64×h×w)通道数从128调整到64
Split分支:
->将cv1_x64通道)Split成2个32通道的分支(0.5×64=32),得到y = [y0, y1]. y0:shortcut分支(32通道,直接保留原始特征); y1:Bottleneck分支(32通道,进入特征提取)
Bottleneck堆叠:
self.m是2个Bottleneck的列表(n=2),每个Bottleneck的输入/输出通道数均为32(保持通道一致)。
第一个Bottleneck(m)处理y[-1](即y1,32通道),输出m0_y1(32通道),并添加到y中→ y = [y0, y1, m0_y1];
第二个Bottleneck(m)处理y[-1](即m0_y1,32通道),输出m1_m0_y1(32通道),并添加到y中→ y = [y0, y1, m0_y1, m1_m0_y1]。
Concat融合特征: 将y中的所有元素(共2+n=4个)在通道维度拼接(torch.cat(y, 1)): y0(32通道)+ y1(32通道)+ m0_y1(32通道)+ m1_m0_y1(32通道)→ 总通道数=32×4=128。 1x1卷积统一通道:
拼接后的特征图(128通道)通过self.cv2(1x1卷积),输出cv2_y→ 通道数从128调整回c2=64(保持输出通道一致)。
SPPF层
SPPF层的结构可概括为: 输入 → 1×1卷积(降维)→ 三次MaxPool2d(多尺度池化)→ Concat(特征融合)→ 1×1卷积(通道调整)→ 输出
1. 第一步:1×1卷积(降维,对应图片中的「Conv k=1」)
作用:将输入通道数从512降至256(降维),减少后续池化层的计算量;同时保持特征图尺寸不变(20×20)。
图片对应:输入为h×w×c_in(20×20×512),输出为h×w×c_(20×20×256)。
2. 第二步:三次MaxPool2d(多尺度池化,对应图片中的「MaxPool2d×3」)
作用:三次池化的池化核大小相同(5×5),但感受野依次递增(5×5 → 9×9 → 13×13)。这是因为连续池化的感受野计算为: 第n次池化的感受野 = 前一次感受野 + (池化核大小-1)×前一次步长乘积(步长为1,故每次增加4)。 例如:第一次池化感受野=5,第二次=5+4=9,第三次=9+4=13。保持特征图尺寸不变(20×20):通过padding=k//2(5//2=2)和stride=1,图片对应:三个MaxPool2d的输入均为前一次的输出(20×20×256),输出均为20×20×256(尺寸不变)。
3. 第三步:Concat(特征融合,对应图片中的「Concat」)
作用:将未池化的特征(cv1输出,保留原始细节)与三次池化的特征(不同感受野,捕捉不同大小目标)在通道维度拼接,融合多尺度信息。通道变化:256×4 = 1024(c_×4),尺寸仍为20×20。图片对应:输入为4个h×w×c_(20×20×256)的特征图,输出为h×w×4c_(20×20×1024)。
4. 第四步:1×1卷积(通道调整,对应图片中的「Conv k=1」)
作用:将拼接后的1024通道调整回512通道(与输入通道数一致),保持特征图尺寸不变(20×20)。图片对应:输入为h×w×4c_(20×20×1024),输出为h×w×c2(20×20×512)。
SPPF融合了原始细节(未池化)和三个不同感受野(5×5、9×9、13×13)的特征,能兼顾小目标(小感受野)和大目标(大感受野)的检测
C2f和SPPF在Backbone中的作用
C2f层是Backbone的主要特征提取模块,重复多次,逐步将原始像素转换为深层语义特征(如从“红色像素”到“猫的耳朵”)。举例:YOLOv8-s版的第一个C2f层提取“边缘特征”,第二个提取“纹理特征”,第三个提取“物体部件特征”,依此类推。
SPPF层:「多尺度特征融合器」SPPF层是Backbone的最后一步,将C2f层提取的深层语义特征与多尺度感受野特征融合,为SPPF层提供兼顾不同大小目标的特征(如小目标的边缘细节+大目标的全局语义)。举例:SPPF处理后的特征图,既可以检测“小目标(如行人的脸)”(依赖小感受野的细节特征),也可以检测“大目标(如汽车)”(依赖大感受野的语义特征)。
简单来说就是SPPF将C2f提取的特征融合起来,使得可以兼顾大小不同目标的识别。
Head层
Head层分为三个部分,第一步是多尺度特征融合—解决不同大小目标难以兼顾问题,第二步是三个解耦头,第三步是输出检测框。
多尺度特征融合
Backbone输出的P3/P4/P5特征图(对应不同stride:8/16/32)分别适合检测小目标(P3,80x80,stride=8)、中目标(P4,40x40,stride=16)、大目标(P5,20x20,stride=32)。但单一尺度的特征图无法兼顾所有目标,因此需要融合多尺度特征。
融合过程功能是融合深层语义特征(P5,大感受野,适合大目标)和浅层细节特征(P3,小感受野,适合小目标);
使每个尺度的特征图都包含多尺度信息(如P3融合特征图既包含小目标的细节,也包含大目标的语义
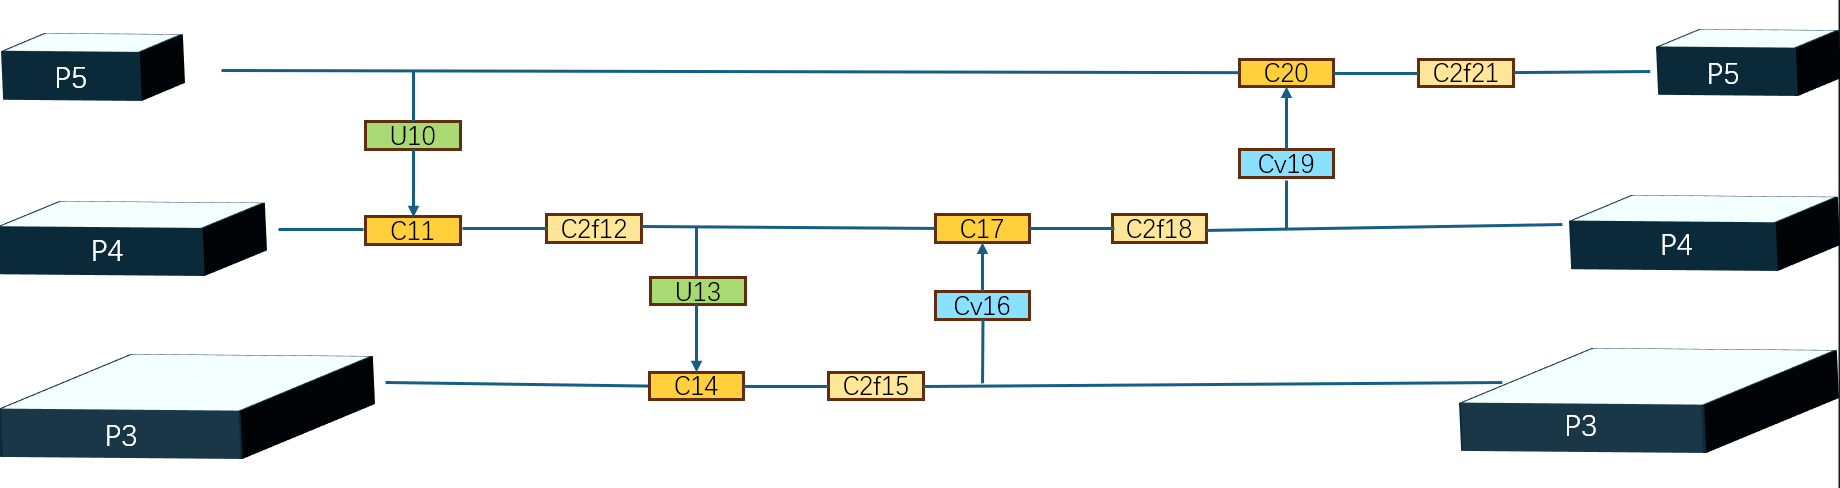
融合流程:
P5→P4融合:P5(20x20x1024)通过Upsample(上采样)放大到40x40,与Backbone的P4(40x40x512)Concat(拼接)(通道维度合并,如1024+512=1536),然后经过C2f模块(shortcut=False,n=3xd)提取融合特征,得到P4融合特征图(40x40x512)。
P4→P3融合:P4融合特征图(40x40x512)通过Upsample放大到80x80,与Backbone的P3(80x80x256)Concat(512+256=768),再经过C2f模块提取特征,得到P3融合特征图(80x80x256)。
解耦头
解耦头Detect有三个,分别是分类分支(Cls),回归分支(Reg)和置信度分支(Obj)。可以这样理解:三个解耦头都获得了融合后的多尺度特征图,只不过三者的侧重点不一样。我们使用YOLO进行目标检测后,会在预测图片中看见一个检测框,目标名称和置信度,这就是三个解耦头分别工作给出的结果。
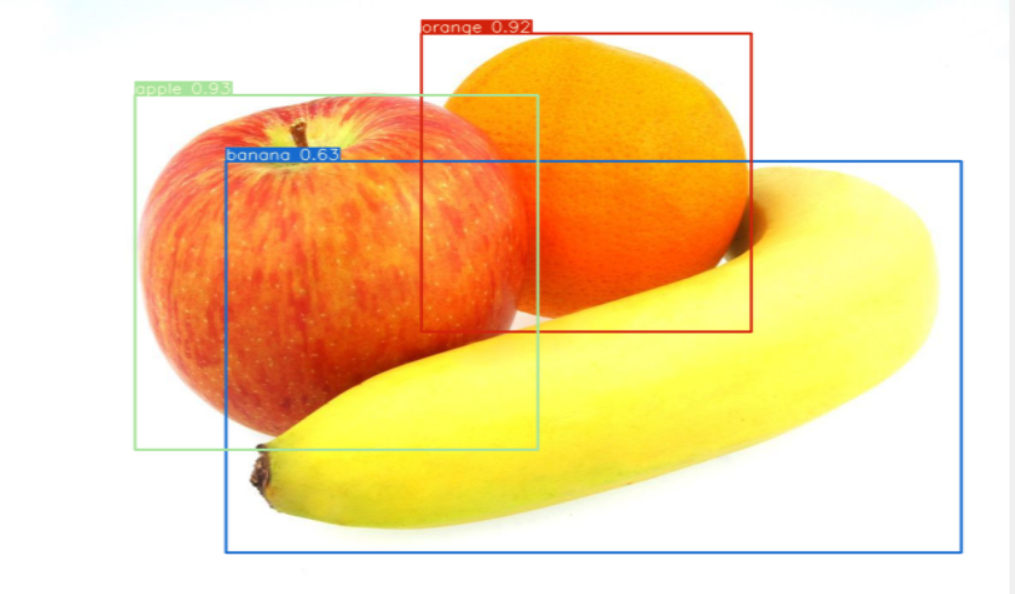
生成检测框
检测框的信息包括
- x_center/y_center:边界框中心点坐标(相对于图像左上角);
- width/height:边界框的宽高;
- confidence:框内存在目标的概率(Obj分支输出);
- class1_prob:目标属于类别1的概率(Cls分支输出)。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 39
 0
- 0


 已为社区贡献1条内容

所有评论(0)