时间序列模型——ARIMA模型
1.ARIMA模型介绍
ARIMA模型(Autoregressive Integrated Moving Average)模型,即自回归积分滑动平均模型,是时间序列分析中最常用的模型之一。它结合了自回归(AR)和滑动平均(MA)两种方法,并加入了差分(I)的概念,以使非平稳时间序列数据变得平稳,从而进行有效的预测。
ARIMA模型通常表示为:ARIMA(p,d,q),其中p,d,q为三个主要参数。
p:自回归项(AR)
d:差分次数(I)
q:移动平均项(MA)
其中,差分次数d是用于处理非平稳序列,通过一阶或者二阶差分等,来消除时间序列中的趋势特征或季节特征。
2.ARIMA模型数学表达式
上文我们提到ARIMA模型结合了AR模型以及MA模型两种方法。因此,在介绍ARIMA模型数学表达式前,我们先回顾一下AR、MA这两个模型。
2.1.AR(自回归)模型
AR模型的数学模型表达式为:
其中,是自回归系数,
是误差项,
是常数。
2.2.MA(移动平均)模型
MA模型的数学模型表达式为:
其中,是移动平均系数,
是当前时刻的随机误差,
是时间序列均值或期望。
2.3ARMA(自回归移动平均)模型
ARMA模型的数学模型表达式为:
引入延迟算子B后,可以将ARMA(p,q)模型简化为:
其中,为p阶自回归系数多项式,
为q阶移动平均系数多项式。
2.4ARIMA模型
将上述AR模型、MA模型与差分法相结合,我们就可以得到ARIMA(p,d,q)模型。ARIMA模型的数学模型表达式为:
其中,;
为自回归系数多项式;
为移动平均系数多项式。
3.ARIMA模型建模过程
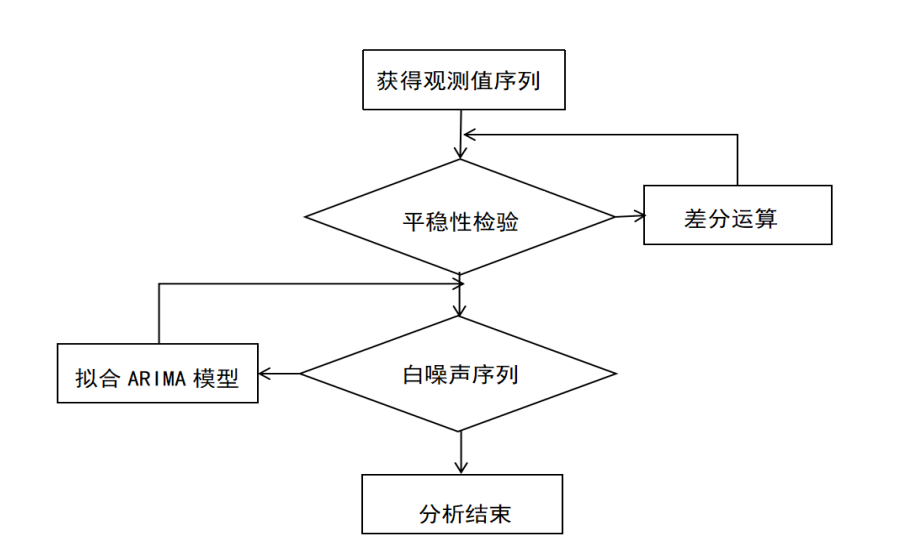
3.1ARIMA模型建模流程图
3.2ARIMA模型建模步骤
3.2.1平稳性检验
将已有的数据进行平稳性检验,判断其是否为平稳序列。
3.2.2差分处理
序列进行平稳性检验后,若序列为平稳序列,则进行下一步建模流程;若序列为非平稳序列,则需要将序列进行差分处理,直至序列为平稳序列。
3.2.3模型识别
对平稳序列(原序列或差分后的序列)进行ACF和PACF检验,通过ACF图和PACF图,初步确定ARIMA模型的p和q。
3.2.4模型拟合
估计模型参数,选择最优模型
3.2.5模型检验
检验残差是否为白噪声序列,若残差序列不为白噪声序列,则需要重新进行模型识别;若残差序列为白噪声序列,则进行模型预测。
3.2.6模型预测
用拟合好的ARIMA模型,进行未来期数预测。
4.R语言实现ARIMA模型
1.平稳性检验。在实际应用过程中,我们往往对于实验所用的数据不知道其是否平稳,因此,在选择适当的模型之前,我们需要对数据进行初步的观察并检验其平稳性。我们将利用ggplot2库对数据进行可视化处理对其进行初步观察;利用tseries库对原始序列进行ADF(单位根)检验,代码如下:
# 安装所需包
install.packages(c("forecast", "tseries", "ggplot2"))
library(forecast)   # 用于时间序列预测和ARIMA模型
library(tseries)    # 用于平稳性检验
library(ggplot2)    # 用于数据可视化
# 读取数据
data <- read.csv("data.csv", header = T,sep=',')
data <- na.omit(data)
# 将数据转换为时间序列对象
data$date <- as.Date(data$time)
# 按日期排序(确保数据按时间顺序排列)
data <- data[order(data$date), ]
# 将数据转换为时间序列对象
ts_data <- ts(data$value,
              start = c(as.numeric(format(min(data$date), "%Y")),
                        as.numeric(format(min(data$date), "%j"))),
              frequency = 365)

# 可视化原始时间序列
ggplot() +
  geom_line(aes(x = time(data$date), y = as.numeric(data$value))) +
  labs(title = "原始时间序列图", x = "日期", y = "收盘价") +
  theme_minimal()
# 进行ADF单位根检验(原假设:序列非平稳)
adf_test <- adf.test(ts_data)
print(adf_test)
这段代码首先安装并调用了可视化以及平稳性检验所需的库,然后把数据转换为了时间序列对象,确保接下来所使用的数据是时间序列数据,接着将原始数据进行可视化处理,观察其初步形态分布,最后进行了ADF检验。
若运行此代码,应该可以得到以下类似的图形:
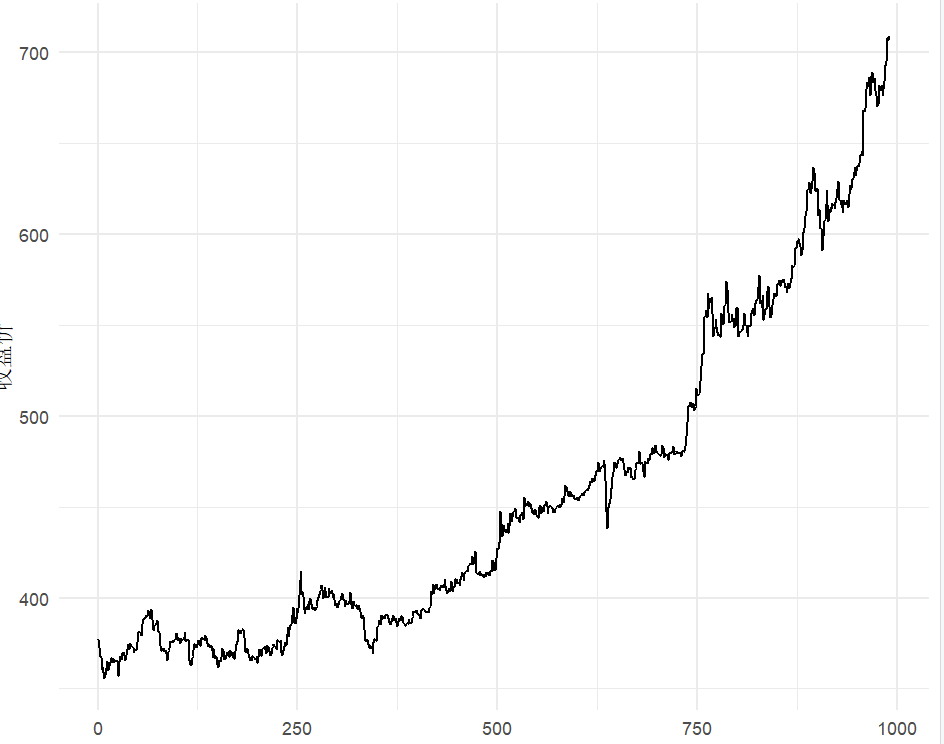
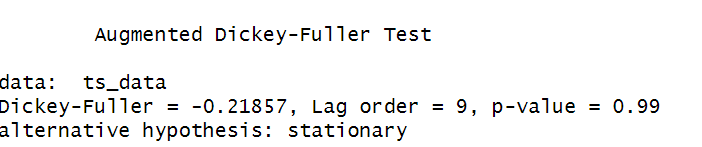
从上述图像以及单位根检验结果,我们可以看出来本例选择的数据序列是不平稳的。接下来,我们就可以更进一步的体会到利用差分可以将不平稳序列转为平稳序列的过程,代码如下:
if (adf_test$p.value > 0.05) {
  cat("\n结论:序列非平稳,需要进行差分处理\n")
  # 进行一阶差分
  ts_diff1 <- diff(ts_data, differences = 1)
  # 对一阶差分后的序列进行ADF检验
  adf_test_diff1 <- adf.test(ts_diff1)
  cat("\n一阶差分后的ADF检验结果:\n")
  print(adf_test_diff1)

  # 若一阶差分后仍非平稳,则进行二阶差分
  if (adf_test_diff1$p.value > 0.05) {
    ts_diff2 <- diff(ts_data, differences = 2)
    adf_test_diff2 <- adf.test(ts_diff2)
    cat("\n二阶差分后的ADF检验结果:\n")
    print(adf_test_diff2)

    # 选择合适的差分次数d
    if (adf_test_diff2$p.value <= 0.05) {
      d <- 2
      ts_stationary <- ts_diff2
      cat("\n选择二阶差分,d=2\n")
    }
  } else {
    d <- 1
    ts_stationary <- ts_diff1
    cat("\n选择一阶差分,d=1\n")
  }

  # 可视化差分后的序列
  autoplot(ts_stationary) +
    labs(title = paste0(d, "阶差分后的序列"), x = "时间", y = "值") +
    theme_minimal()
} else {
  # 若序列已平稳,则不需要差分
  d <- 0
  ts_stationary <- ts_data
  cat("\n结论:序列已平稳,不需要差分处理,d=0\n")
}
这段代码运用if条件句,来判断原始序列从不平稳变成平稳序列需要的差分次数,并选择合适的差分次数,避免过度差分。此外,还将差分后的平稳序列进行了可视化。
如果运行此代码,应该可以得到如下类似的图形:

通过上述图形,我们可以看的原本不平稳的序列变成了平稳序列,接下来我们就可以利用ACF和PACF进行ARIMA模型的初步模型选择。代码如下:
# 绘制ACF和PACF图,判断p和q的可能取值
acf(ts_stationary, main = "差分后序列的ACF图", na.action = na.omit)
pacf(ts_stationary, main = "差分后序列的PACF图", na.action = na.omit)
我们执行完此代码,就可以很直观的看到ACF和PACF的图形:
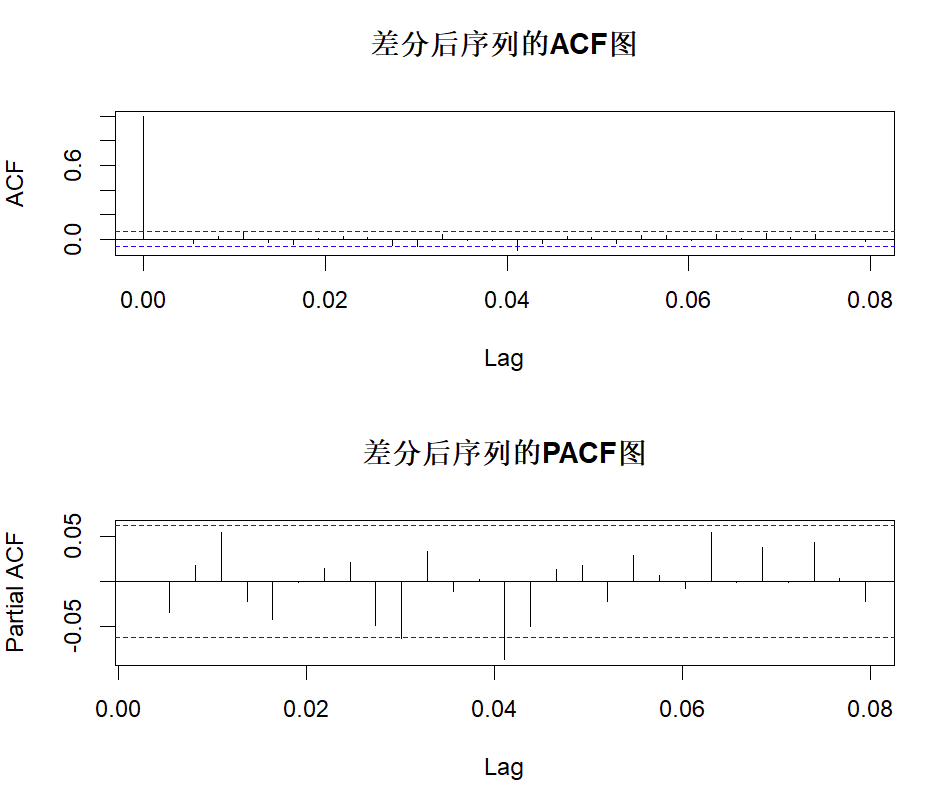
通过ACF图和PACF图的截尾和拖尾特性,就可以初步尝试去确定ARIMA模型中的参数p,q,并构建相应的ARIMA(p,d,q)模型。模型拟合代码如下 :
# 根据ACF和PACF图的截尾特性,我们尝试几个可能的模型
p <- 2  # AR参数
q <- 2  # MA参数
# 拟合ARIMA模型
arima_model <- Arima(ts_data, order = c(p, d, q))
# 打印模型
print(arima_model)
根据具体的实际情况,只需更改p,q的参数,以及AIC、BIC的值,就可以选择较为合适的ARIMA模型。选择完合适的模型,我们就需要对残差进行检验,判断残差是否为白噪声并根据检验结果做出进一步的操作,对残差进行检验的代码如下:
# 残差提取
residuals <- residuals(arima_model)
# Ljung-Box检验(原假设:残差为白噪声)
lb_test <- Box.test(residuals, type = "Ljung-Box")
cat("\nLjung-Box检验结果:\n")
print(lb_test)
if (lb_test$p.value > 0.05) {
  cat("结论:残差为白噪声,模型拟合良好\n")
} else {
  cat("结论:残差不是白噪声,模型需要改进\n")
}
通过运行上述代码,就可以得到残差序列是不是白噪声序列的具体结果。若残差序列是白噪声序列我们就可以进行下一步的预测过程,代码如下:
# 预测未来10期的数据
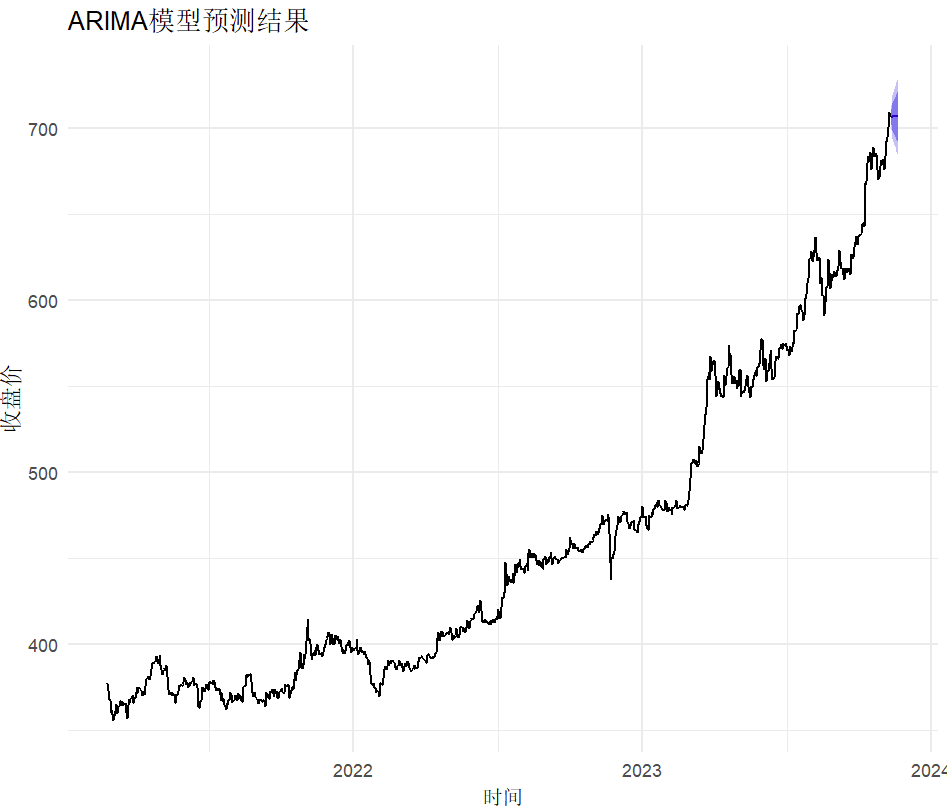
forecast_result <- forecast(arima_model, h = 10)
print(forecast_result)

# 可视化预测结果
autoplot(forecast_result) +
  labs(title = "ARIMA模型预测结果", x = "时间", y = "收盘价") +
  theme_minimal()
此代码对未来10期的数据进行了预测,并进一步将预测结果进行了可视化处理。如果运行代码可以得到类似的图形:
5.总结
本文从实际应用的角度介绍了ARIMA模型以及模型中AR,I,MA三部分如何组成ARIMA模型。文章以数学模型为起点,展现了AR模型、MA模型、ARMA模型到ARIMA模型的演变过程,并通过实例展示了如何选择ARIMA(p,d,q)模型中的三个参数,并确定合适的模型进行未来若干期的预测。
最后,感谢您能阅读此篇文章!若本文对您有所帮助,别忘了给我点赞哈,这将是我持续创作的动力。您有任何疑问欢迎在评论区进行指点,我会尽力回答并接受您的指正。作为一名时间序列的初学者,未来我会尽所能分享更多关于时间序列方面的知识。
期待未来与您一起学习、进步!

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 41
 0
- 0


 已为社区贡献1条内容

所有评论(0)