常见的PLC浮点数字节序转换方法
变量的字节序
在 PLC 中,寄存器的长度通常为 16 bit,常见的数据类型有 16bit、32bit长度的
对于 32 bit 长度的数据,比如浮点型(在西门子、Codesys 中称为REAL型),由于长度较长,在不同平台、使用不同协议进行数据传输时,双方传输的数据的字节排布的方式有可能不同,举例如下:
- 设按照 IEEE754 标准,从高字节到低字节的一个浮点数为:
A B C D - 则不同厂商对以上数据的存储方式可能有 4 种:
ABCD、CDAB、BADC、DCBA
因此,不同厂商、设备之间若使用浮点数进行数据交换,有可能要做数据转换,转换的本质是改变不同字节的排列顺序,因此又称为【字节序转换】
常见的字节序转换方法
现成的字节交换指令 + 类型转换指令
如汇川、西门子、三菱都提供了SWAP指令,此指令可实现同一个寄存器高低字节的交换
(下图引自大佬的文章:https://blog.csdn.net/qq_42983533/article/details/125691077)
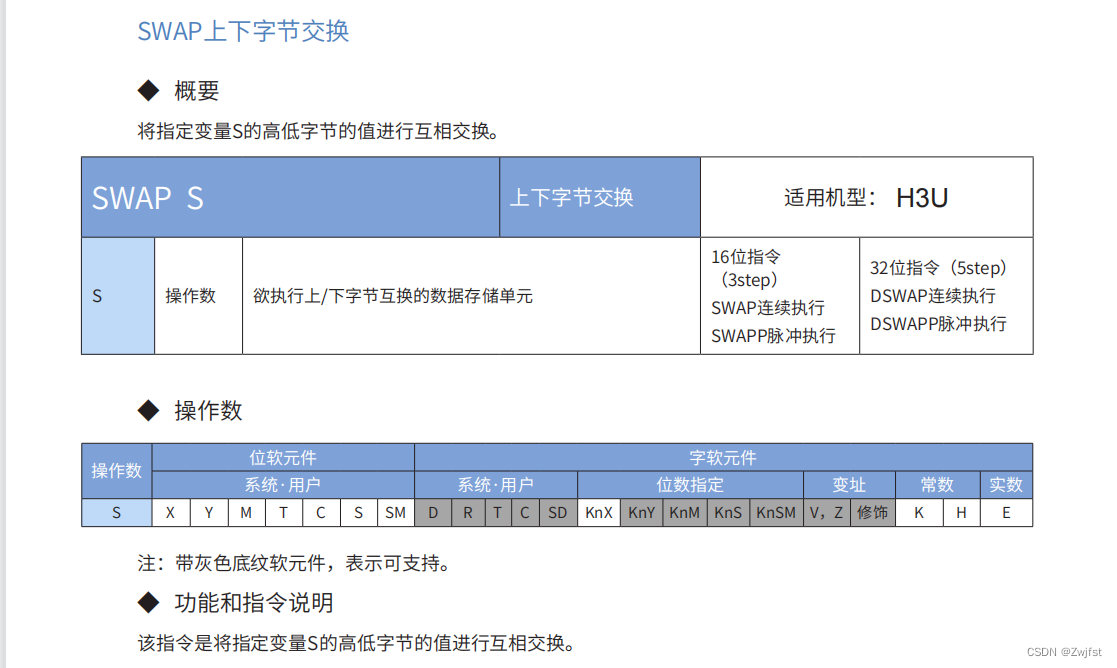
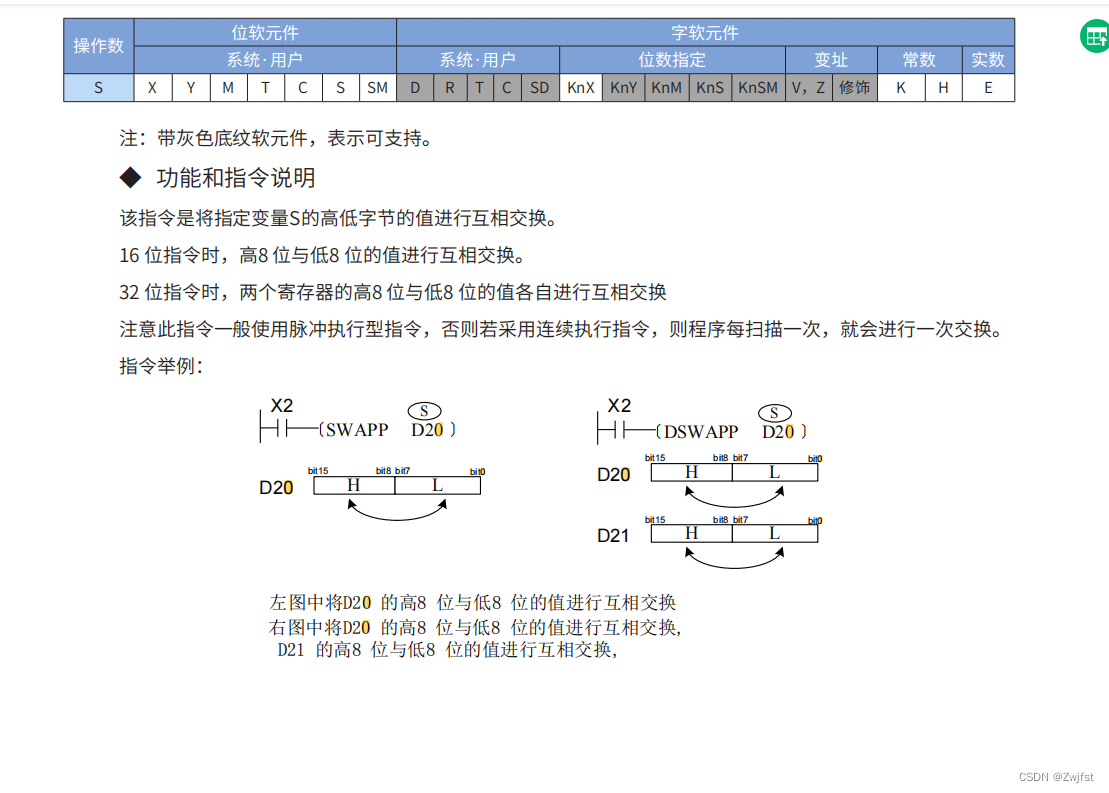
下图引自西门子指令文档
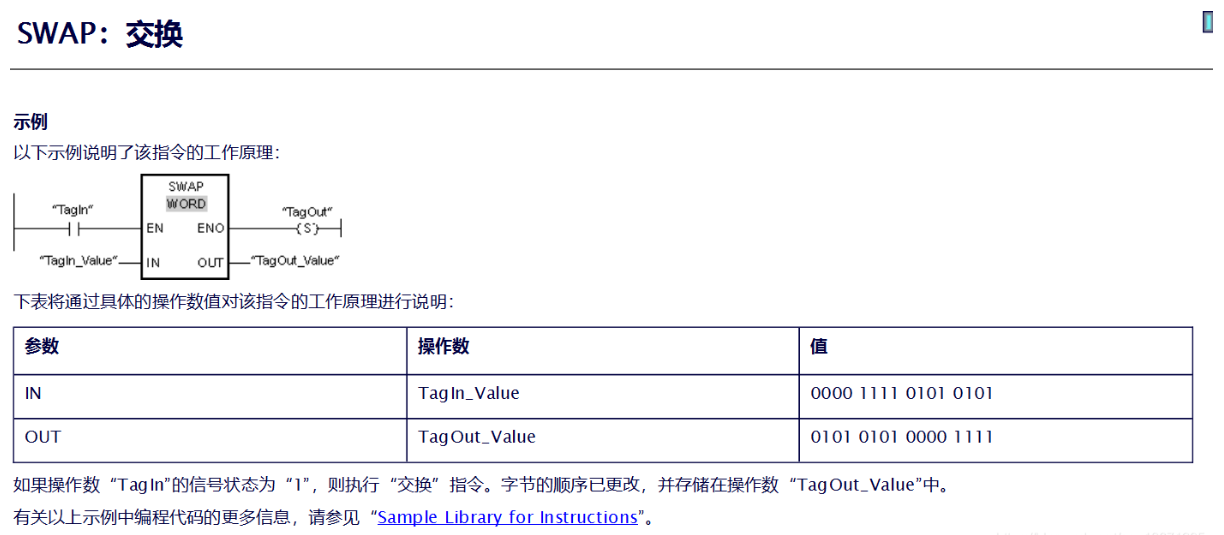
总体逻辑
REAL 变量输入 --1–> WORD 类型数组 --2–> 交换字节的 WORD 类型数组 --3–> REAL 类型输出
- 1:使用系统的数据类型转换函数,将 REAL 型变量转换为 WORD 类型数组
- 2:使用上面介绍的
SWAP指令,交换每个 WORD 中的字节 - 3:使用系统的数据类型转换函数,将 WORD 型数组转回 REAL 型变量
部分厂商直接提供了相关的指令,比如:
-
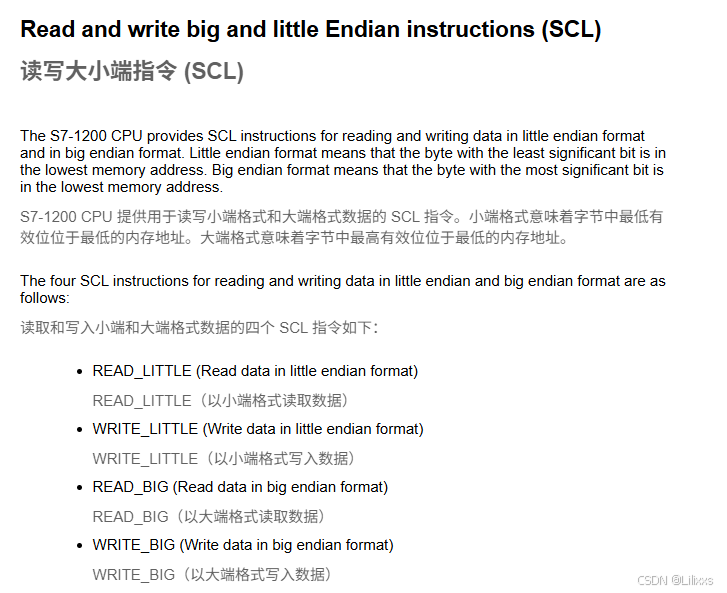
西门子博途高版本提供的一系列大端/小端读写指令:
READ_LITTLE/WRITE_LITTLE/READ_BIG/WRITE_BIG介绍见:https://support.industry.siemens.com/cs/mdm/109759862?c=81971440011&lc=en-AF
-
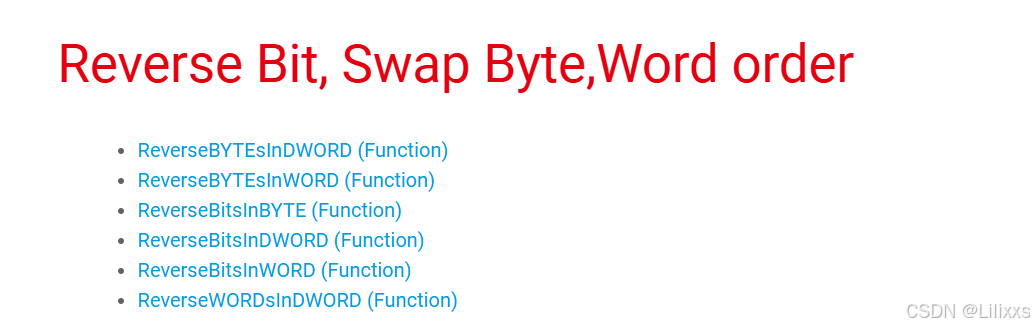
Codesys 的 Memory 库中提供的 (倍福、欧姆龙、汇川、信捷、禾川等只要能能导入 Codesys 的 CAA_Memory 库就可使用)
介绍见:https://content.helpme-codesys.com/en/libs/CAA%20Memory/Current/CAA_Memory/Reverse-Bit-Swap-ByteWord-order/fld-Reverse-Bit-Swap-ByteWord-order.html
Byte 数组/结构体 AT 映射 Float 直接操作
- 参考这位大佬的文章:http://www.ymmfa.com/read-gktid-1643979.html
- 还有这个更详细的介绍:https://mp.weixin.qq.com/s/L_BnS_UFF0A1KvaxXmzarA
关键是编程软件要支持构造直接指向 REAL 型变量的 Byte [] 数组 或 UDT结构体
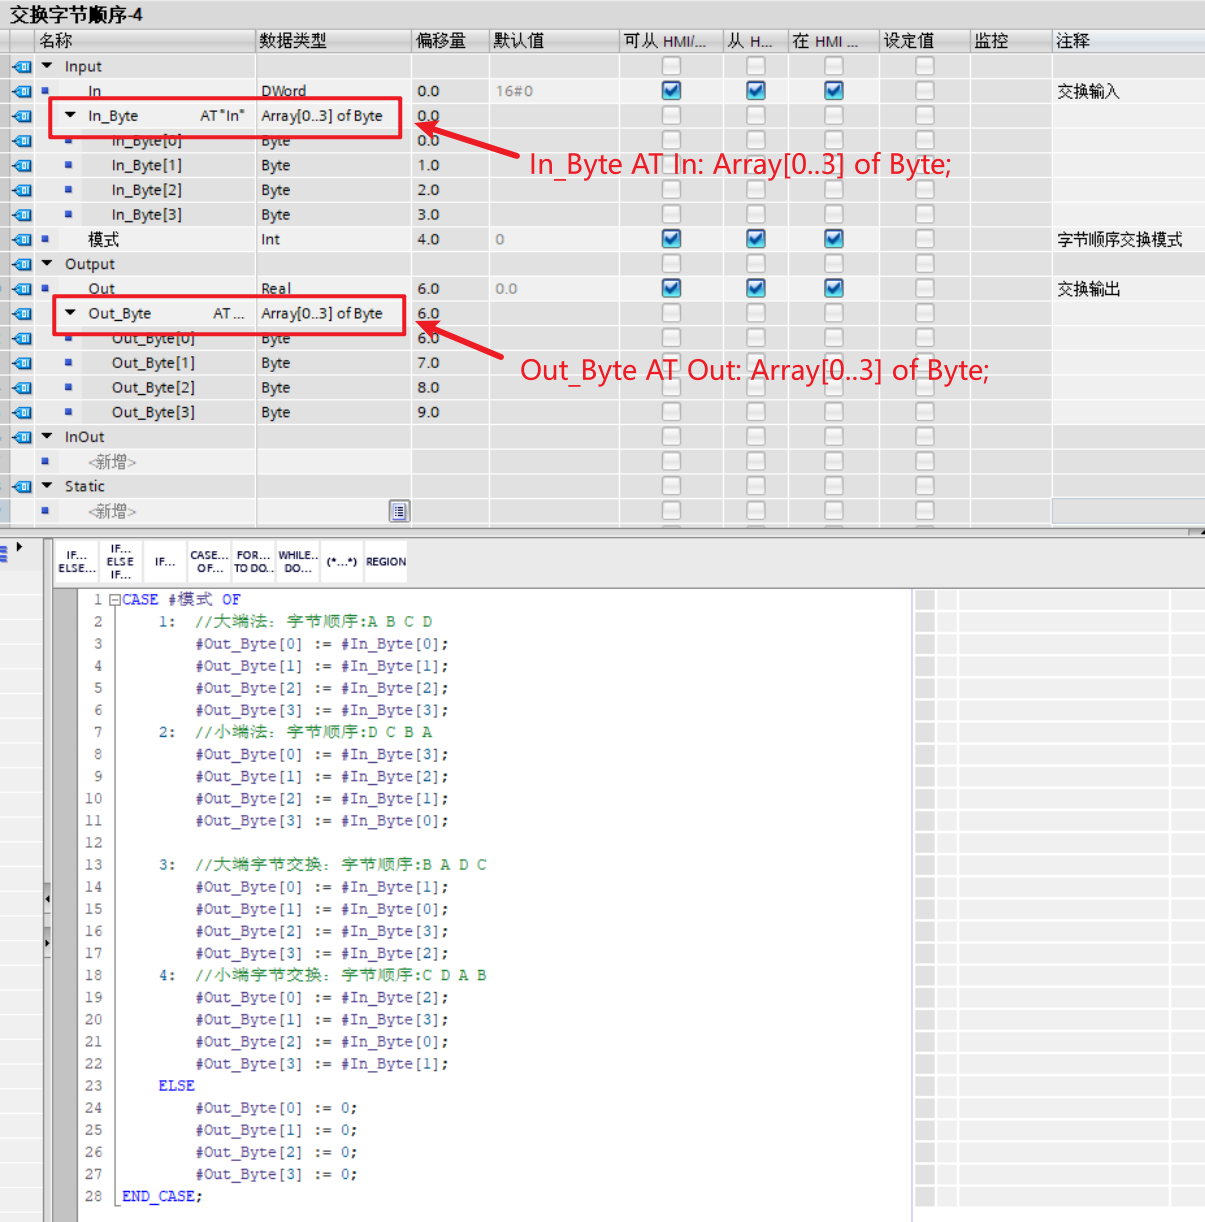
PCS7、博途均支持以上写法
CodeSyS 的 AT指令不支持映射到输入变量和输出变量,所以这样写有问题

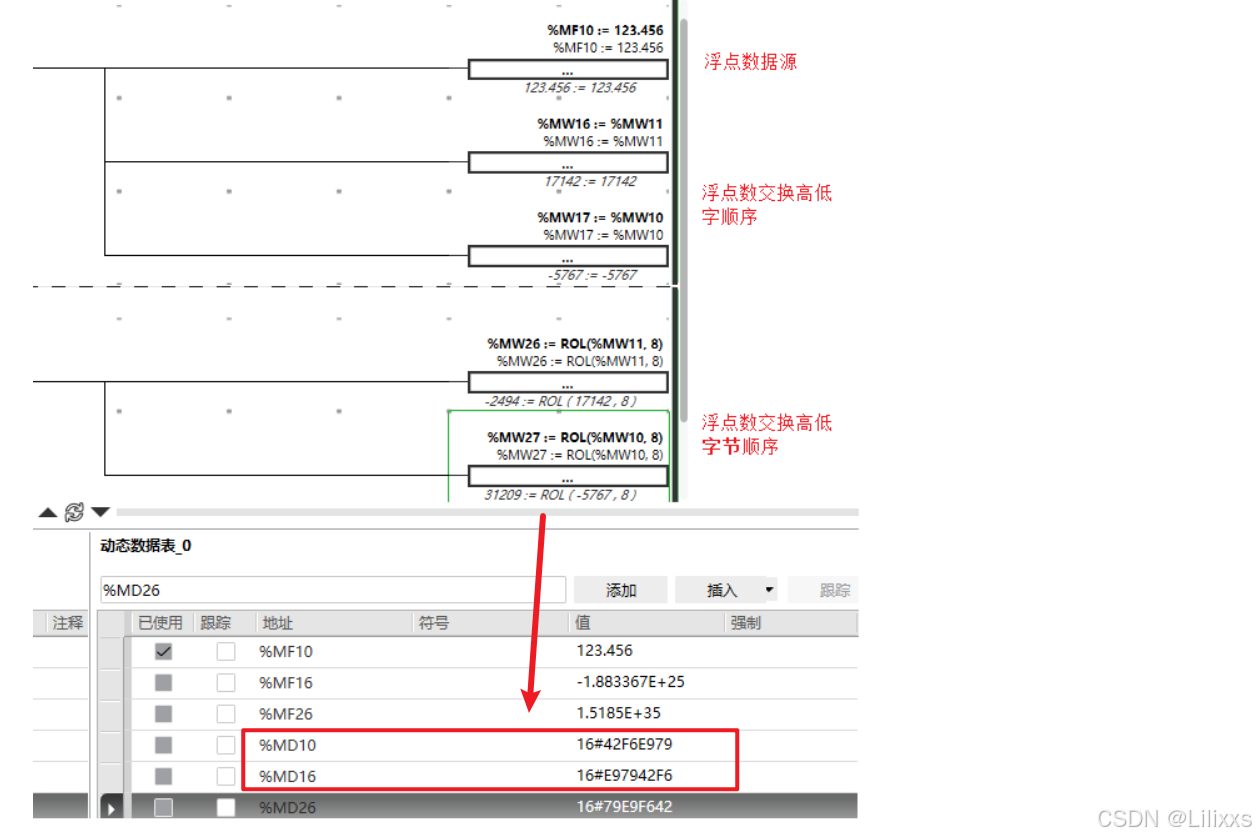
循环左移 + 类型转换
- 高低字转换:通过按字交叉赋值实现
- 高低字节转换:在 WORD 中使用【循环左移 ROL 】实现(循环左移 8 位 = 每个字交换高低字节)
比如以下的文档:https://www.schneider-electric.cn/zh/faqs/FA414474/
图片摘自上面的网页
封装程序的入参风格
若自己搭建一个功能块,对数据进行大小端转换处理,有两种输入参数的风格

- 指定处理模式:入参通常为 2 个:待处理数据 +
MODE引脚MODE引脚通常为INT型 /STRING型变量,指定要对数据的进行的处理模式- 如指定
MODE=1234、MODE=“ABCD”
- 指定处理操作:入参通常为 3 个:待处理数据 +
ByteSwap引脚 +WordSwap引脚ByteSwap引脚为BOOL型,指定是否对一个 Word 中的高低 Byte 进行交换WordSwap引脚也为BOOL型,指定是否对高低 Word 进行交换
个人倾向于使用 指定处理操作 的入参风格,理由如下:
- 指定处理操作的引脚清晰,在写程序时给人的感觉比较直观,看参数就知道会进行什么操作
- 指定处理操作的输入引脚类型为
BOOL类型,可省略程序中对输入值进行值域范围的校验,程序实现简单、可靠、高效

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐


 4
 0
- 0


 已为社区贡献3条内容

所有评论(0)