一文看懂Qwen3本地部署的配置要求,不知道部署哪个版本的小伙伴看过来!
在开始说显存占用之前,我们先要了解一些基础信息和概念。
模型规模
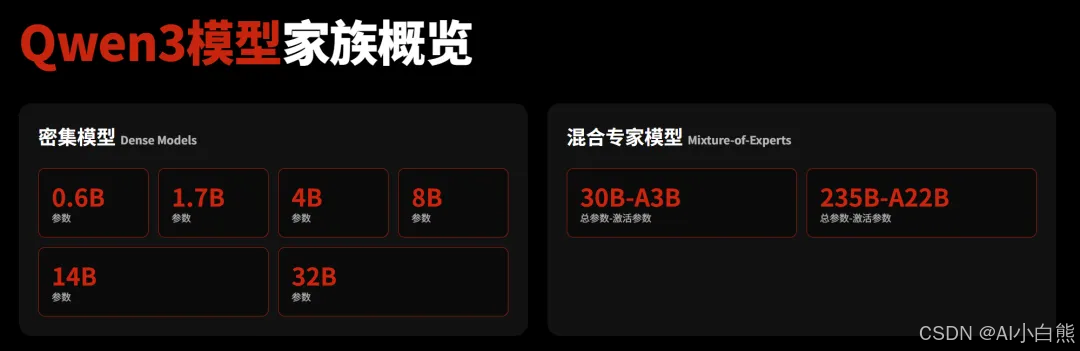
本次Qwen3系列开源模型一共发布了8个不同尺寸,尺寸越大,显存占用越高。
8个模型中有6个Dense(密集)模型,2个MoE(混合专家)模型。密集模型在推理过程中会激活所有参数,而 MoE 模型则采用稀疏激活策略,每次前向传递只激活一部分专家参数,在有限的计算预算下性能更高。
量化权重
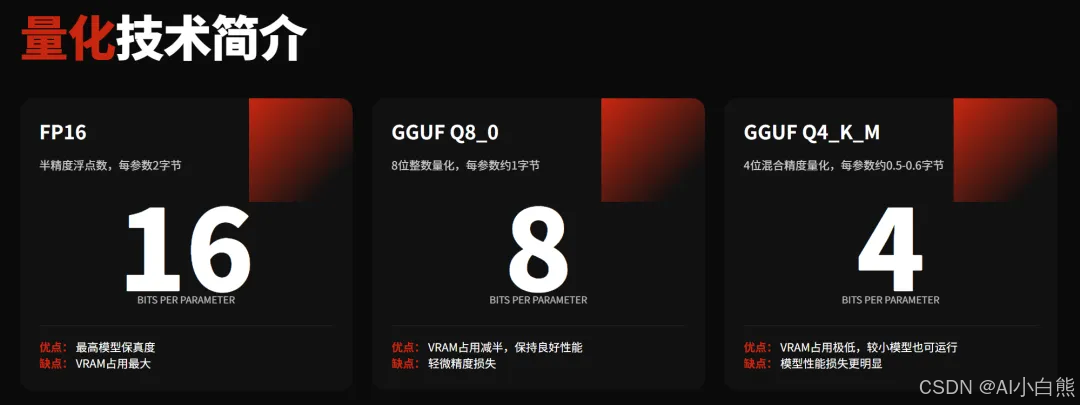
量化是指降低模型权重的数值精度,以显著减少显存占用和存储空间并可能提高推理速度的技术。未量化的模型显存占用非常高,很难本地部署。
本地部署起来最方便的Ollama,提供了三种量化权重的Qwen3模型,分别是Q4_K_M(默认)、Q8_0和FP16。
KV缓存
KV缓存是大语言模型推理过程中的一个重要技术概念。简单来说,如果没有KV缓存,每生成一个新token,整个序列的注意力都要重新计算,一次生成过程的计算量将呈指数增长。而有了KV缓存,则只需要计算新token的向量再与缓存交互即可,大大减少了计算量。
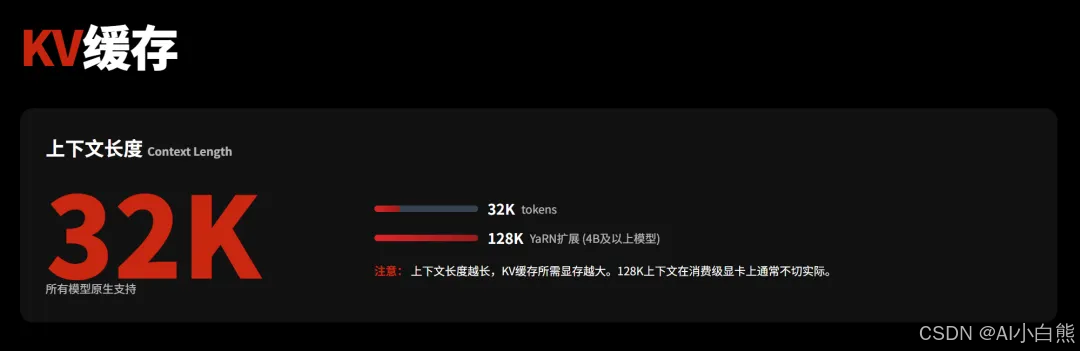
KV缓存是让大语言模型实用化的关键技术,但也是显存消耗的主要来源之一。KV缓存的大小随上下文长度线性增长,上下文越长,显存占用越高。
Qwen3系列模型原生上下文长度32K,4B及以上尺寸可扩展至128K。但这个上下文长度对消费级显卡来说不太现实,一般高端显卡(24GB+)可能只能处理8K-16K的上下文。
了解了上面三个基本信息和概念,接下来就要说到显存了。
显存占用
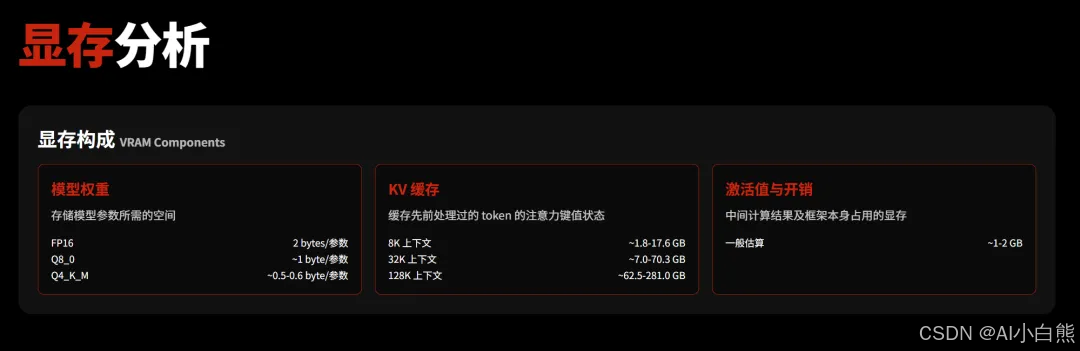
本地部署运行大语言模型,显存占用的构成主要来源于三部分:模型权重(包括参数规模和量化)、KV缓存、激活值与开销。
模型权重就是存储/加载模型参数所需的空间,取决于模型的参数量和使用的数值精度(即量化级别)。例如,一个 140 亿参数的模型,如果使用 FP16(半精度浮点数,每个参数 2 字节)存储,大约需要 28GB 显存。
KV缓存与以序列长度(上下文长度)、批处理大小(Batch Size)、模型维度(层数、隐藏层大小)以及缓存精度(不必与模型权重精度相同,通常为FP16 精度)等多个因素密切相关,可以按照公式VRAMkvcache≈2×层数×隐藏层维度×序列长度×批处理大小×每个值的字节数进行估算,这里就不做展开了。
激活值与开销即推理过程中中间计算结果(激活值)以及运行框架(如 CUDA 核函数、驱动程序、操作系统等)自身占用的显存,一般也就1-2G左右。
对于Qwen3系列模型,可以直接查看下面这个表格,表格中上下文长度统一按照8K计算。
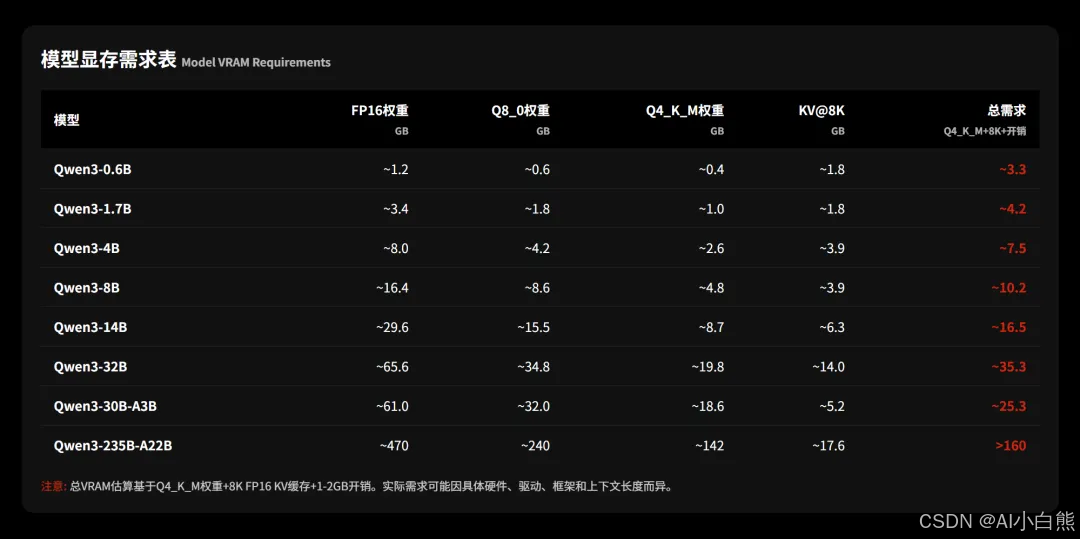
例如,部署Q4_K_M的Qwen3-32B模型,所需要的显存大概为约19.8G(模型权重)+约14G(8K上下文KV缓存)+约1~2G(开销),一共大约35.3G。
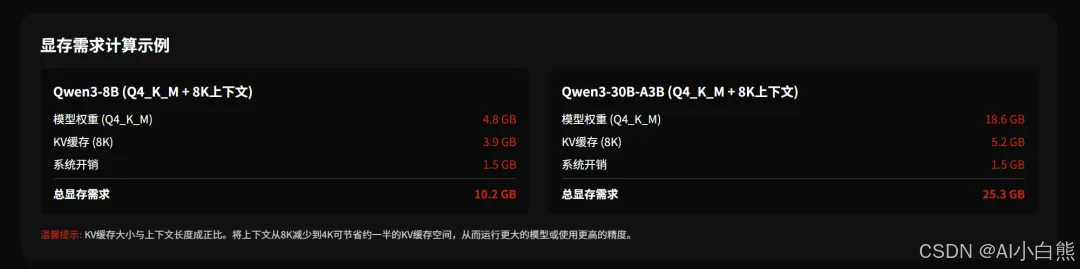
当然,提前防杠一下。在实际使用过程中,上下文是根据实际情况变化并逐渐累积的,并不是一开始就直接占用掉大概14G的空间,所以即便没有达到表格中写的总需求,也并不代表一点也不能用。
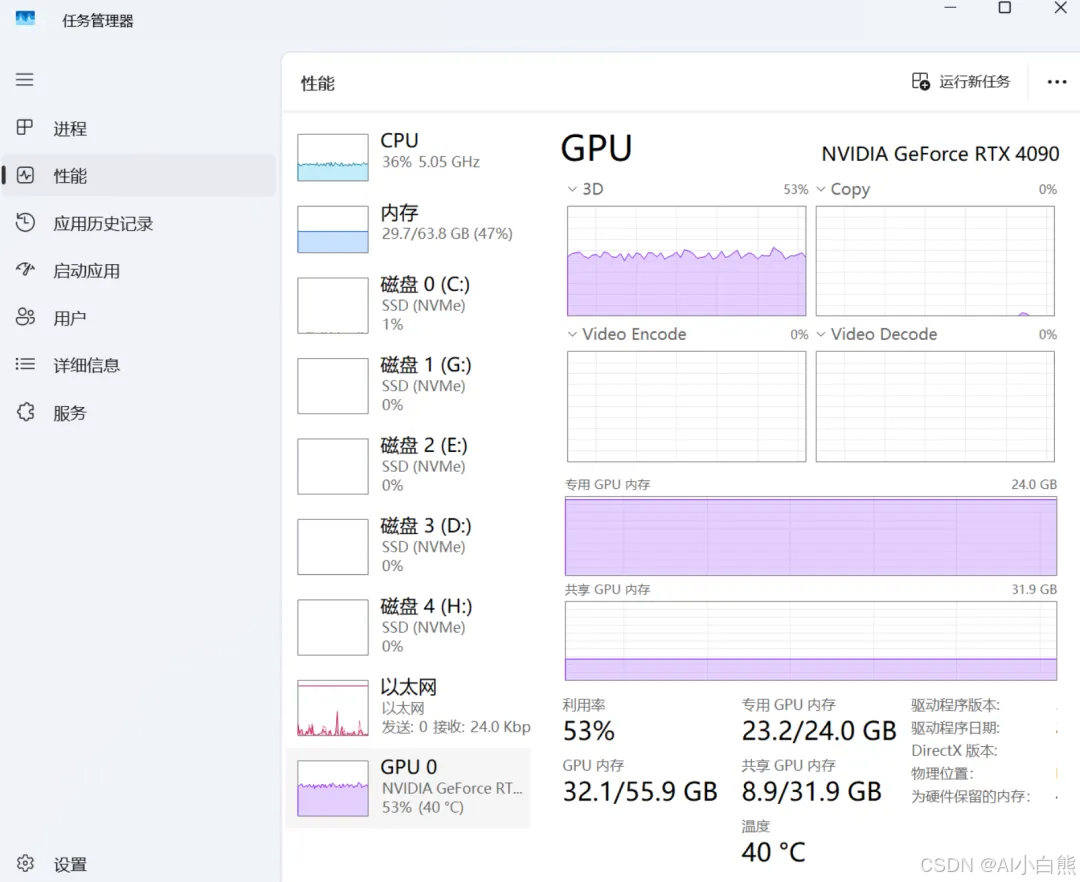
但是,如果你本地部署完大模型,刚开始执行一个简单小任务就是下面这种显存拉满的状态,那大概率可以判断它后面很难支持复杂任务,最好换成尺寸更小的模型或者低精度量化模型。
另外,对于混合专家模型,需要单独补充说明一下。在显存占用方面,它和密集模型并没有太大区别,装入显存时依旧需要为全部参数分配显存空间,但因为只有一部分参数被激活并参与实际计算,推理速度会比同等显存占用的密集模型快得多。装入显存时,看总参数量;运行速度时,看激活参数量。
消费级显卡兼容
典型的消费级显卡和模型的兼容可以查看下面这张图:
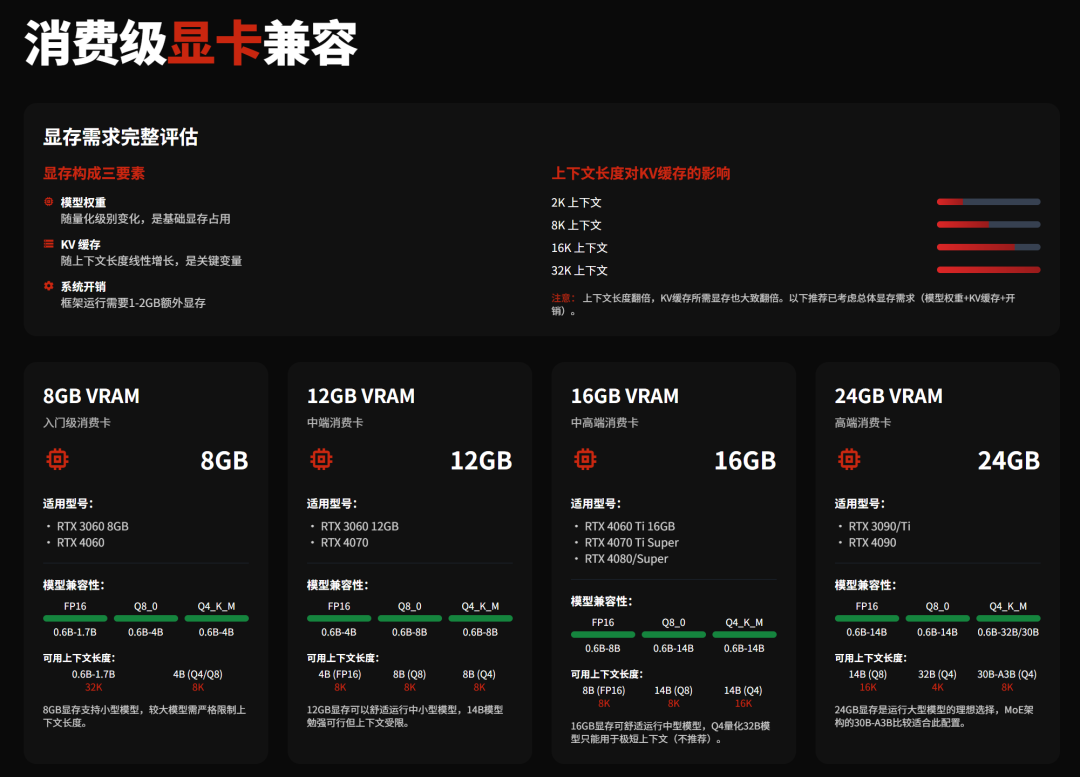
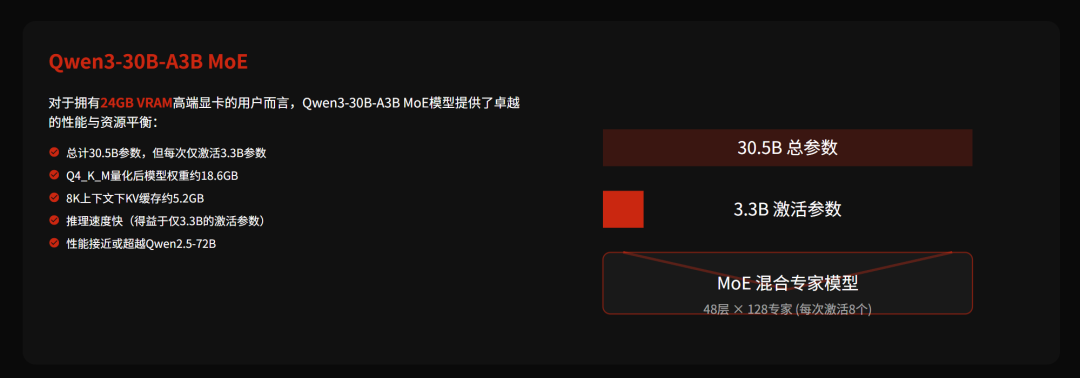
理论上,对于24G显存的高端显卡来说,跟Q4_K_M量化的Qwen3-30B-A3B在显存占用上十分契合。如果你使用3090/4090,可以优先测试一下这个模型。
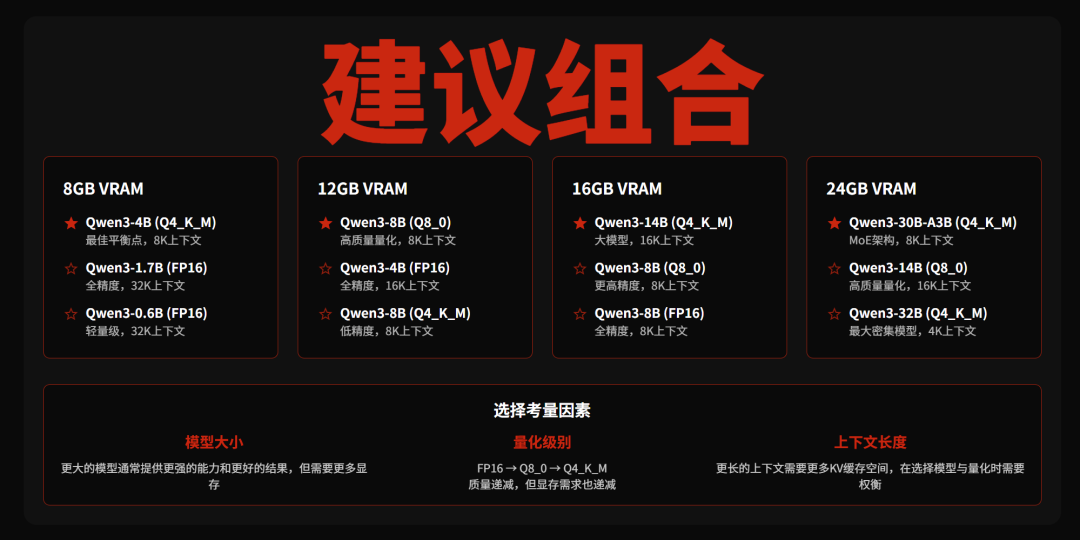
从参数综合来看,不同配置对本地部署Qwen3模型的选择可以参考这张图:
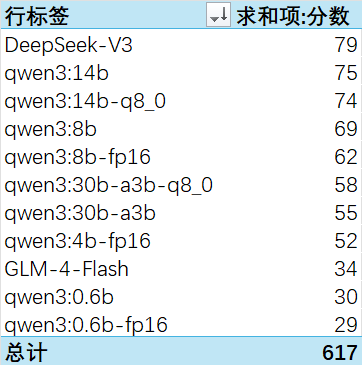
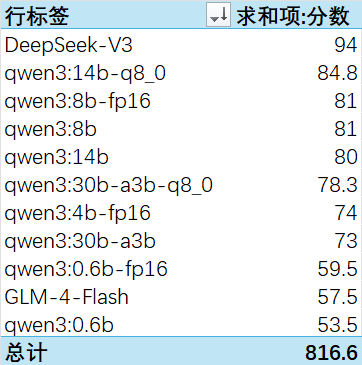
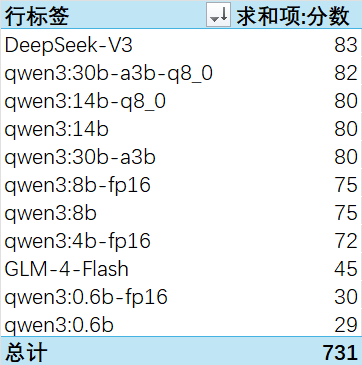
不同尺寸&量化权重Qwen3实际测试
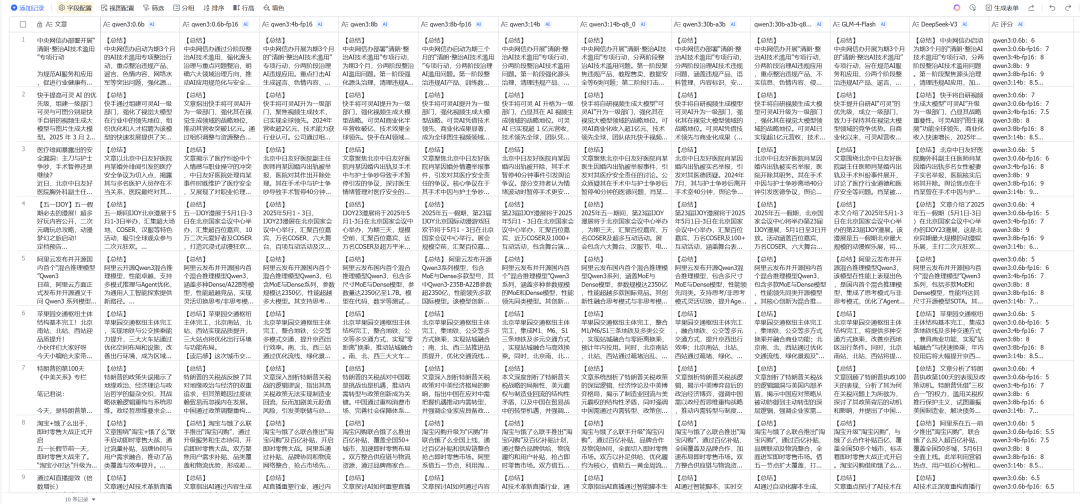
文案项目:
总结项目:
弱智吧项目:
综合打分:
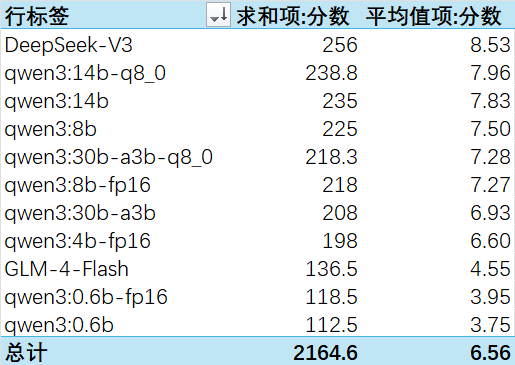
这三个项目中,综合评分依旧是全量DeepSeek-V3(硅基流动API)最高;因为加入了0.6B小模型,上篇测试中综合评分最低的GLM-4-Flash提升到倒数第三,但0.6B模型跟其他模型的差距并没有预想那么大;中间模型各位可自行参考。
测试详细内容见:https://ilovezhiwai.feishu.cn/wiki/TboCwTXPVi4vQqkHucuc7Dq4nkI
结合这几个我自己相对高频场景下的测试结果和理论数据,我个人最终会倾向选择Qwen3-14B (Q8_0)。
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
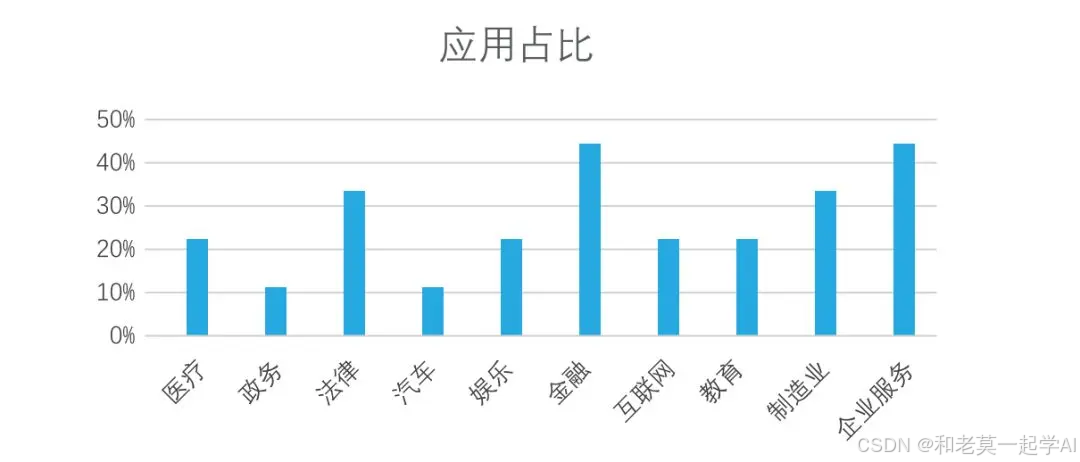
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
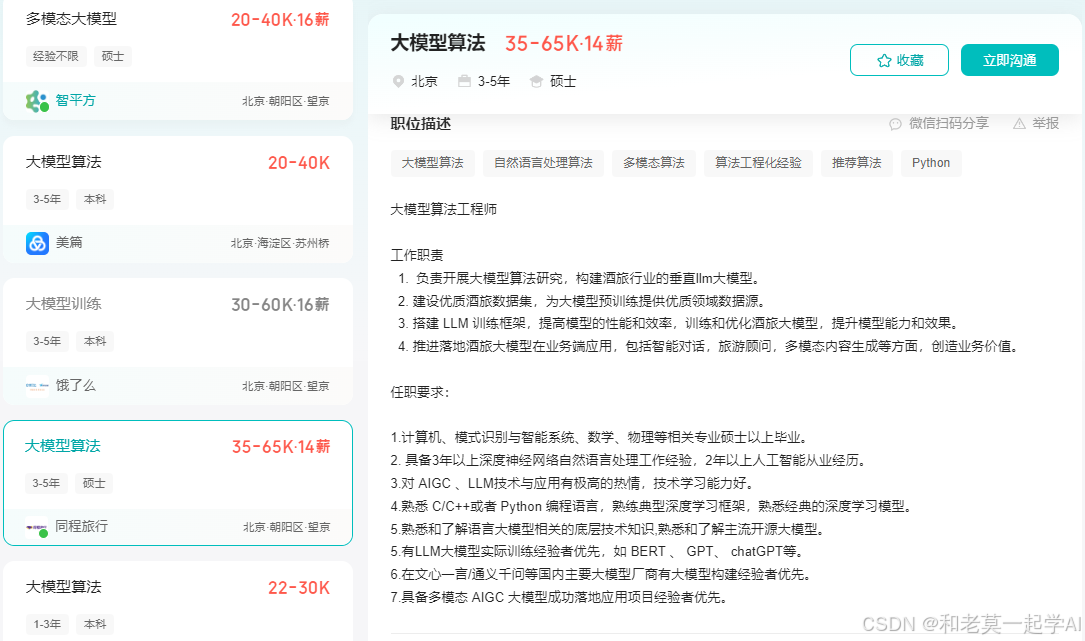
随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:
人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
如果你真的想学习大模型,请不要去网上找那些零零碎碎的教程,真的很难学懂!你可以根据我这个学习路线和系统资料,制定一套学习计划,只要你肯花时间沉下心去学习,它们一定能帮到你!
大模型全套学习资料领取
这里我整理了一份AI大模型入门到进阶全套学习包,包含学习路线+实战案例+视频+书籍PDF+面试题+DeepSeek部署包和技巧,需要的小伙伴文在下方免费领取哦,真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
部分资料展示
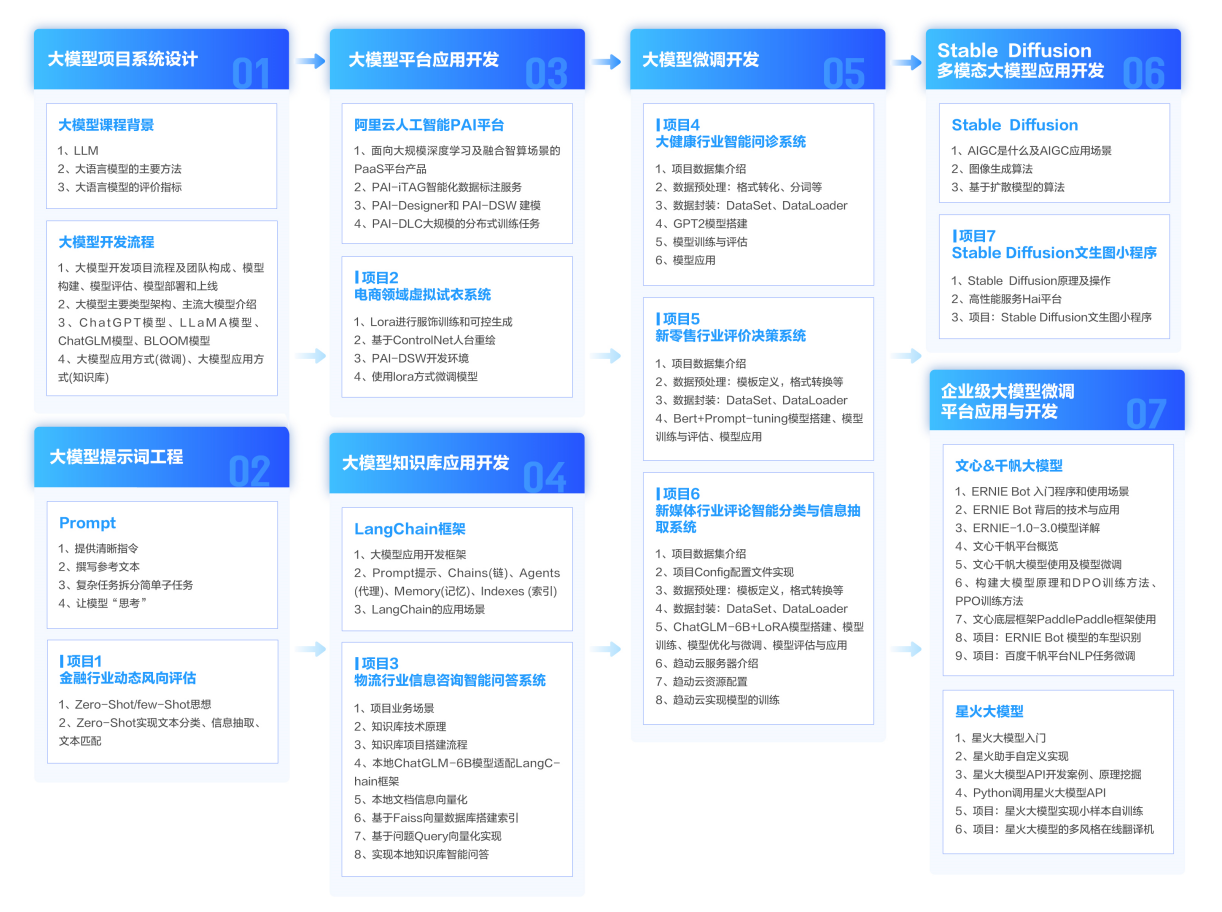
一、 AI大模型学习路线图
整个学习分为7个阶段

二、AI大模型实战案例
涵盖AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,皆可用。


三、视频和书籍PDF合集
从入门到进阶这里都有,跟着老师学习事半功倍。


四、LLM面试题


五、AI产品经理面试题

六、deepseek部署包+技巧大全

😝朋友们如果有需要的话,可以V扫描下方二维码联系领取~

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 11
 0
- 0


 已为社区贡献79条内容

所有评论(0)