【Stata学习笔记】Stata入门+代码
在本篇文章中,我将总结Stata基础知识官方教程,帮助大家快速掌握这些技能。
Stata版本:Stata16
开始之前:前些天发现了一个很不错的人工智能学习网站,通俗易懂,风趣幽默,在这里分享给大家,点击 https://www.captainbed.cn/zm 就可以进入到网站学习啦~~
Stata基础
命令基础
* 1. 查看当前工作目录
* 这个命令显示当前的工作目录路径,帮助你了解Stata在哪个文件夹中操作。
pwd

* 2. 更改工作目录
* 如果你想切换到其他目录,可以使用cd命令,后面跟上你想切换到的目录路径。
cd c:\temp

* 3. 列出当前目录中的文件
* 使用ls命令列出当前工作目录下的所有文件。如果你使用的是Windows,命令是dir。如果你使用的是Mac或Linux,则可以使用ls。
ls

* 4. 打开Stata自带的数据集
* Stata自带了一些数据集,你可以通过sysuse命令加载。例如,打开auto.dta数据集(1978年的汽车数据)。
sysuse auto.dta

* 5. 查看数据集的基本信息
* 使用describe命令查看数据集的基本信息,包括变量的名称、类型、格式等。
describe

* 6. 保存数据集
* 你可以通过save命令将当前的数据集保存到本地硬盘。这里保存为myauto.dta。
save myauto.dta

* 7. 如果文件已存在,使用replace选项覆盖文件
* 如果已经存在同名文件并希望覆盖,可以在save命令后加上replace选项。
save myauto.dta, replace

* 8. 清除当前数据集
* 如果你需要清除内存中的数据集,可以使用clear命令。注意,这个命令会删除当前打开的数据集。
clear

* 9. 重新加载数据集
* 使用use命令加载已保存的数据集,例如加载myauto.dta。
use myauto.dta

* 10. 如果想加载新数据集并清除现有数据,可以使用clear选项
* 使用use命令并加上clear选项来清除当前数据集并加载新的数据集。
use myauto.dta, clear
寻求帮助
* 1. 使用 help 命令
* 当你不确定某个命令的用途时,使用 help 命令可以查看该命令的帮助文件。
* 示例:查看 probit 命令的帮助文件。
help probit

* 2. 使用 search 命令
* 如果你想查找关于某个主题或命令的相关信息,可以使用 search 命令。
* 示例:搜索关于 "probit regression" 的所有相关资源(帮助文件、文章、视频等)。
search probit regression

* 3. 限制搜索范围
* 如果你只想查看 Stata PDF 手册中的相关内容,可以使用 manual 选项来限制搜索结果。
* 示例:仅搜索 Stata PDF 手册中的关于 "probit regression" 的内容。
search probit regression, manual

* 4. 查找其他学习资源
* 如果你想查看 Stata 的其他学习资源和支持信息,可以使用 help resources 命令。
* 示例:查看 Stata 相关的学习资源,如书籍、培训课程、论坛等。
help resources
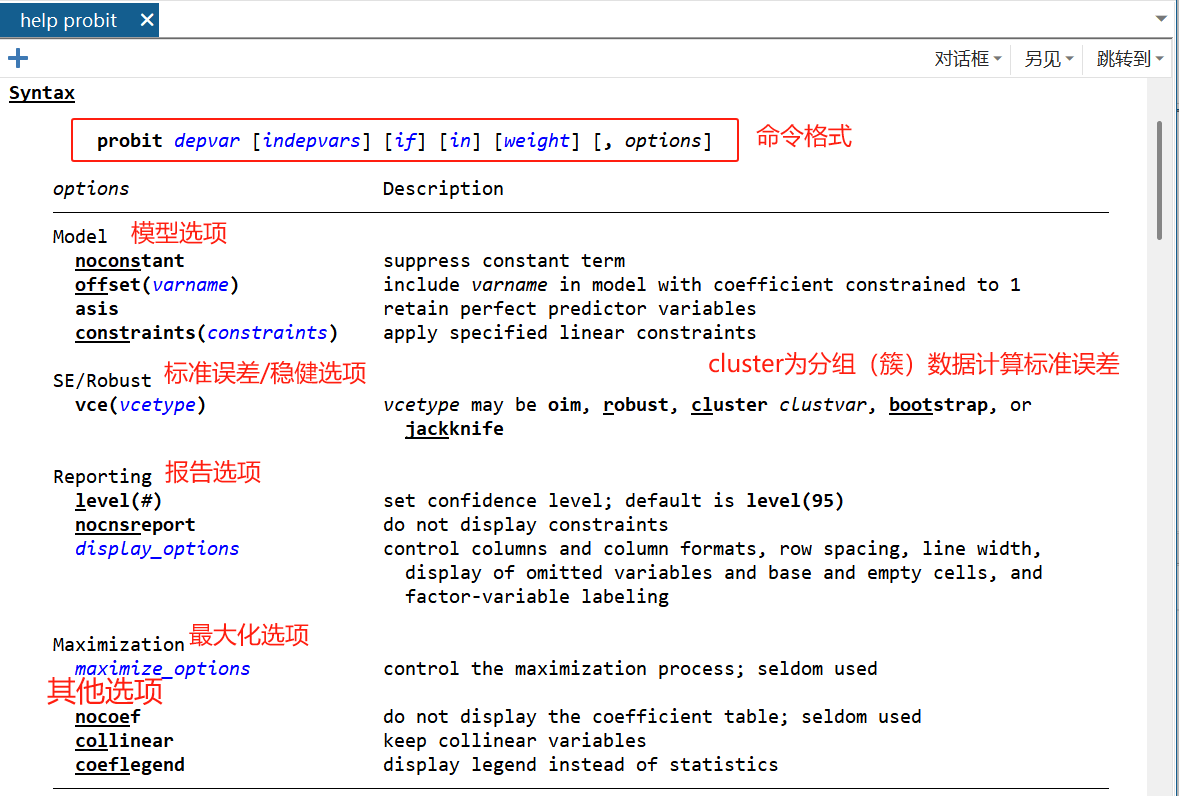
stata自带的数据集
* 1. 查看已安装的示例数据集
* 使用 help dta_examples 命令查看 Stata 中已安装的所有示例数据集。
help dta_examples

* 2. 查看数据集的描述
* 使用 sysdescribe 命令查看指定数据集的描述信息。
* 示例:查看 auto.dta 数据集的内容。
sysdescribe auto.dta

* 3. 加载 Stata 内置数据集
* 使用 sysuse 命令加载 Stata 内置的示例数据集。以下命令加载 auto.dta 数据集。
sysuse auto

* 4. 从 Stata 官网加载数据集
* 使用 webuse 命令从 Stata 官网下载并加载数据集。以下命令加载 apple.dta 数据集。
* 注意:需要互联网连接。
webuse apple, clear

* 5. 查看在线数据集的描述
* 使用 webdescribe 命令查看指定在线数据集的描述信息。
* 示例:查看 apple.dta 数据集的内容。
webdescribe apple
打开部分数据集
通过使用 use 命令中的 if 和 in 选项,以及对变量和观察值进行筛选,Stata 允许你灵活地加载数据集的部分内容。这样可以避免不必要的内存占用,并且更高效地进行数据分析。
* 1. 查看数据集的描述信息
describe using nhanes2l.dta

* 2. 加载部分变量
use diabetes agegrp bmi using nhanes2l

* 3. 加载前1000个观察值
use diabetes agegrp bmi using nhanes2l in 1/1000

* 4. 根据条件加载数据(例如:仅加载region == 1的数据)
use region diabetes agegrp bmi using nhanes2l if region == 1

* 5. 保存部分数据集
save nhanes2l_partial.dta
导入、导出数据
从 Microsoft Excel 导入和导出数据
* 1. 加载示例数据集
sysuse auto

* 2. 将数据导出到 Excel 文件
export excel myauto, sheet(auto) firstrow(variables)

* 3. 查看当前目录中的文件,确认是否保存成功
ls

* 4. 清空当前数据
clear

* 5. 导入 Excel 文件
import excel myauto, sheet(auto) firstrow

* 6. 查看导入的数据
describe

* 7. 保存导入的数据为 Stata 格式
save myauto,replace
从 Microsoft Excel 复制并粘贴数据
* 1. 加载示例数据集
sysuse auto

* 2. 将数据导出到 Excel 文件
export excel myauto, sheet(auto) firstrow(variables)

* 3. 清空当前数据
clear

* 4. 打开数据编辑器
edit

* 5. 在 Excel 中复制数据,粘贴到 Stata 数据编辑器中
* 注意:在 Excel 中选择数据并粘贴到 Stata 时,确保选择 "Treat first row as variable names"

* 6. 保存数据为 Stata 格式
save myauto
导入和导出CSV
使用 import delimited 和 export delimited 命令
* 1. 加载示例数据集
sysuse auto,clear

* 2. 将数据导出为 CSV 文件
export delimited myauto.csv

* 3. 查看当前目录中的文件,确认文件是否导出成功
ls

* 4. 清空当前数据
clear

* 5. 从 CSV 文件导入数据
import delimited myauto.csv

* 6. 查看导入的数据
describe

* 7. 保存数据为 Stata 格式
save myauto,replace
手动输入数据
使用input命令手动输入数据。使用 str12 指定变量类型为字符串,最大长度为 12 个字符。对于数值型变量,可以不指定类型。
clear

* 2. 输入第一个变量(name)
input str12 name
  Ringo
  John
  Paul
  George
end

* 3. 执行命令并查看数据
list

* 4. 清空数据并添加第二个变量(birthyear)
clear
input str12 name birthyear
  Ringo 1940
  John 1940
  Paul 1942
  George 1943
end

* 5. 添加第三个变量(instrument)
clear
input str12 name birthyear str12 instrument
  Ringo 1940 "drums"
  John 1940 "guitar"
  Paul 1942 "bass guitar"
  George 1943 "guitar"
end

* 6. 使用全名和乐器数据
clear
input str12 name birthyear str12 instrument
  "Ringo Watts" 1940 "drums"
  "John Jagger" 1940 "guitar"
  "Paul Wyman" 1942 "bass guitar"
  "George Richard" 1943 "guitar"
end

* 7. 保存数据
save mydata
从网站导入数据
官方教程里是使用import sasxport5。但我这边是只要涉及从网站导入数据,均不成功。可以访问网址把数据下载到本地。
* 1. 使用 import sasxport5 命令从 URL 导入数据
import sasxport5 https://wwwn.cdc.gov/Nchs/Nhanes/2015-2016/DEMO_I.XPT

* 2. 使用 describe 命令查看导入的数据
describe

* 3. 保存数据为 Stata 格式
save mynhanes
导入美联储经济数据 (FRED)
获取了密匙,但没成功,报错I/O error。先记录一下。
* 1. 设置 FRED API 密钥
set fredkey 4de8f68f55fa3fa64e4f17321114381c

* 2. 搜索 FRED 数据
fredsearch us dollar yen exchange rate monthly

* 3. 导入数据
import fred EXJPUS

* 4. 查看数据
describe

* 5. 查看前五行数据
list in 1/5

* 6. 按日期范围导入数据
import fred EXJPUS, daterange(1980-1-1 2000-1-1) clear

* 7. 查看元数据
char list

* 8. 设置时间序列
tsset daten

* 9. 绘制时间序列图
tsline EXJPUS

* 10. 保存数据
save EXJPUS
数据管理
给变量添加标签
在 Stata 中,可以使用 label var 命令为变量添加标签,标签可以描述变量的含义或单位,以便在报告中更清晰地展示数据。
* 1. 加载示例数据集
use rawdata.dta, clear

* 2. 查看数据集的描述信息
describe

* 3. 为变量添加标签
label var age "Age (years)"
label var dob "Date of Birth"

* 4. 再次查看数据,以确认标签
describe

* 5. 保存数据集
save mydata,replace
为分类变量的值添加标签
通过为每个分类值定义标签,变量的数值会变得更加易于理解。
* 1. 加载示例数据集
use rawdata.dta, clear

* 2. 查看 sex 变量的分布
tabulate sex

* 3. 定义分类变量的标签
label define sexlabel 0 "Male" 1 "Female"

* 4. 查看标签定义
label list sexlabel

* 5. 将标签应用到变量
label values sex sexlabel

* 6. 再次查看 sex 变量,确认标签
tabulate sex

* 7. 保存数据集
save mydata, replace
自定义变量的显示格式
在处理数字和日期数据时,通过自定义显示格式,可以使数据显示更加简洁易读,同时保留数据的精度。
* 1. 加载示例数据集
use rawdata.dta, clear

* 2. 查看数据集的描述信息
describe

* 3. 列出前 10 个 weight 变量的观测值
list weight in 1/10

* 4. 自定义 weight 变量的显示格式
* %6.0f表示该变量的显示宽度为 6,并且不显示小数位(即显示为整数)。
format %6.0f weight

* 5. 再次查看 weight 变量的前 10 个观测值
list weight in 1/10

* 6. 保存修改后的数据集
save mydata, replace
对数值数据进行舍入
* 1. 加载示例数据集
use rawdata.dta, clear

* 2. 查看数据集的描述信息
describe

* 3. 四舍五入到小数点后一位
generate weight1 = round(weight, 0.1)

* 4. 四舍五入到最接近的整数
generate weight0 = round(weight, 1.0)

* 5. 使用 floor 函数向下取整
generate weightf = floor(weight)

* 6. 使用 ceiling 函数向上取整
generate weightc = ceil(weight)

* 7. 查看结果
list weight weight1 weight0 weightf weightc in 1/5

* 8. 保存数据
save mydata, replace
字符串数据和数字数据互相转换
* 1. 加载示例数据集
use rawdata.dta, clear

* 2. 查看 chol 变量的前 5 个观测值
list chol in 1/5

* 3. 描述 chol 变量,确认它是字符串类型
describe chol

* 4. 将字符串变量 chol 转换为数字型变量 choln
destring chol, gen(choln)

* 5. 查看转换后的结果
list chol choln in 1/5

* 6. 再次描述数据,确认 choln 变量的数据类型
describe chol choln

* 7. 使用 summarize 检查统计数据
summarize chol choln

* 8. 将数字型变量 choln 转换为字符串变量 chols
tostring choln, gen(chols)

* 9. 查看转换后的结果
list chol choln chols in 1/5

* 10. 保存数据集
save mydata, replace
将分类字符串数据转换为数字数据
通过 encode 命令,可以将字符串类型的分类数据转换为数字变量;而decode命令可以将数字变量转换为有标签的字符串数据。
* 1. 加载示例数据集
use rawdata.dta, clear

* 2. 查看 race 变量的频数分布
tabulate race

* 3. 使用 encode 将字符串变量 race 转换为数字变量 racen
encode race, gen(racen)

* 4. 查看 race 和 racen 变量的交叉频数
tabulate race racen

* 5. 查看前 5 个观测值
list race racen in 1/5

* 6. 查看变量类型
describe race racen

* 7. 查看 racen 变量的标签
label list racen

* 8. 使用 decode 将数字变量 racen 转换为字符串变量 races
decode racen, gen(races)

* 9. 查看转换后的结果
describe race racen races
list race racen races in 1/5


* 10. 保存数据集
save mydata, replace
将数字转换为缺失值
通过 mvdecode 命令,Stata 使我们能够将数据中不可能的数值(如 -99)转换为缺失值(.)。此外,使用 missing() 和 !missing() 函数可以帮助我们方便地处理和过滤缺失数据,以确保数据分析的准确性。
* 1. 加载示例数据集
use rawdata.dta, clear

* 2. 查看变量描述
describe

* 3. 查看汇总统计
summarize

* 4. 查看 dbp 变量的前 5 条记录
list dbp in 1/5

* 5. 使用 mvdecode 将 -99 转换为缺失值
mvdecode dbp, mv(-99)

* 6. 再次查看前 5 条记录,确认转换结果
list dbp in 1/5

* 7. 使用 summarize 查看 dbp 变量的汇总统计
summarize dbp

* 8. 使用 missing() 查看缺失值
list dbp if missing(dbp)

* 9. 使用 !missing() 查看非缺失值
list dbp in 1/5 if !missing(dbp)

* 10. 使用条件查询时排除缺失值
count if dbp > 100
count if dbp > 100 & !missing(dbp)


* 11. 保存数据集
save mydata, replace
创建新变量
通过 generate 和 replace 命令,你可以根据现有变量进行运算并创建新的变量。例如,计算 BMI 可以通过先将身高转换为米,然后用身高和体重来创建 BMI 变量。
* 1. 加载示例数据集
use rawdata.dta, clear

* 2. 查看变量描述
describe

* 3. 生成新变量 heightm(身高的米数)
generate heightm = height / 100

* 4. 计算 BMI
generate bmi = weight / heightm^2

* 5. 查看前 5 条记录
list weight height heightm bmi in 1/5

* 6. 查看 bmi 的汇总统计
summarize bmi

* 7. 一步完成 BMI 计算
generate bmi2 = weight / (height / 100)^2

* 8. 查看两个 BMI 变量的汇总统计
summarize bmi bmi2

* 9. 使用 replace 修改已有变量(替换值)
replace bmi2 = weight / (height / 100)^2

* 10. 保存数据集
save mydata, replace
根据连续变量创建分类变量
recode 命令将连续变量转换为分类变量,支持对范围进行分组并分配标签。
bysort 命令按分组显示汇总统计。
label list 显示分类变量的标签定义,便于理解。
* 1. 加载示例数据集
use rawdata.dta, clear

* 2. 查看变量描述
describe

* 3. 查看 sbp 的汇总统计
summarize sbp

* 4. 创建二分类变量 hisbp(<=120 和 >120)
recode sbp (min/120 = 0) (120/max = 1), gen(hisbp)

* 5. 按 hisbp 分类查看 sbp 的汇总统计
bysort hisbp: summarize sbp

* 6. 创建带有标签的变量 hisbp2
recode sbp (min/120 = 0 "<=120") (120/max = 1 ">120"), gen(hisbp2)

* 7. 查看带标签的变量
list sbp hisbp hisbp2 in 507/511

* 8. 创建多分类变量 hisbp3
recode sbp (min/100 = 1 "<=100") ///
            (100/129 = 2 "100-120") ///
            (120/max = 3 ">120"), gen(hisbp3)


* 9. 保存数据集
save mydata, replace
根据存储为字符串的日期创建日期变量
将字符串形式的日期转换为 Stata 的日期格式,进而进行日期计算和分析。Stata16中使用age()函数报错,记录一下。
* 1. 加载示例数据集
use rawdata.dta, clear

* 2. 查看变量描述
describe

* 3. 查看 dob 变量的前几条数据
list dob in 1/5

* 4. 使用 date() 函数将字符串日期转化为日期格式
generate daten = date(dob, "MDY")

* 5. 设置日期显示格式
format daten %tdMonth_DD,_CCYY

* 6. 查看格式化后的日期
list dob daten in 1/5

* 7. 使用 age() 函数计算年龄
generate age2000 = age(daten, date("1/1/2000", "MDY"))
* 报错:unknown function age()

* 8. 查看年龄计算结果
list dob daten age2000 in 1/5

* 9. 保存数据集
save mydata, replace
便捷命令
风险比率和风险差异计算器
csi 命令在 Stata 中用于计算基于 2x2 列联表的风险比(Risk Ratio)、风险差(Risk Difference)、赔率比(Odds Ratio)等关联度量。
12 = 暴露组的病例数
16 = 非暴露组的病例数
55 = 暴露组的非病例数
125 = 非暴露组的非病例数
csi 12 16 55 125
* 使用 exact 选项可以提供 Fisher 精确检验的 1 阶和 2 阶 p 值。or 选项用于计算 赔率比(Odds Ratio)
csi 12 16 55 125, exact or
比值比(Odds-ratio)计算器
* 计算赔率比和风险比
* 12:暴露组病例的数量(Exposed Cases)
* 16:非暴露组病例的数量(Unexposed Cases)
* 55:暴露组非病例的数量(Exposed Non-cases)
* 125:非暴露组非病例的数量(Unexposed Non-cases)
cci 12 16 55 125
* 精确计算(Fisher's Exact Test),适用于小样本数据
cci 12 16 55 125, exact
* 计算Woolf或Cornfield近似置信区间
cci 12 16 55 125, woolf
cci 12 16 55 125, cornfield
发病率(Incidence-rate)比计算器
* 41:暴露组中的病例数(Exposed Cases)
* 15:非暴露组中的病例数(Unexposed Cases)
* 28010:暴露组的总人年数(Exposed Person-years)
* 19017:非暴露组的总人年数(Unexposed Person-years)
iri 41 15 28010 19017
双样本 t 检验计算器
当我们没有原始数据,只有汇总统计数据时,可能需要使用双样本t检验来测试两个样本均值是否相等。在Stata中,我们可以使用 ttesti 命令进行双样本t检验,该命令后跟六个数字:
样本1的观察数:例如20
样本1的均值:例如20
样本1的标准差:例如5
样本2的观察数:例如32
样本2的均值:例如15
样本2的标准差:例如4
* 标准的双样本t检验,假设两个组的方差相等。
ttesti 20 20 5 32 15 4
* 假设方差不等的t检验
ttesti 20 20 5 32 15 4, unequal
* Welch近似是另一种处理方差不等的方式
ttesti 20 20 5 32 15 4, welch
* 改变置信区间的置信度
ttesti 20 20 5 32 15 4, level(90)
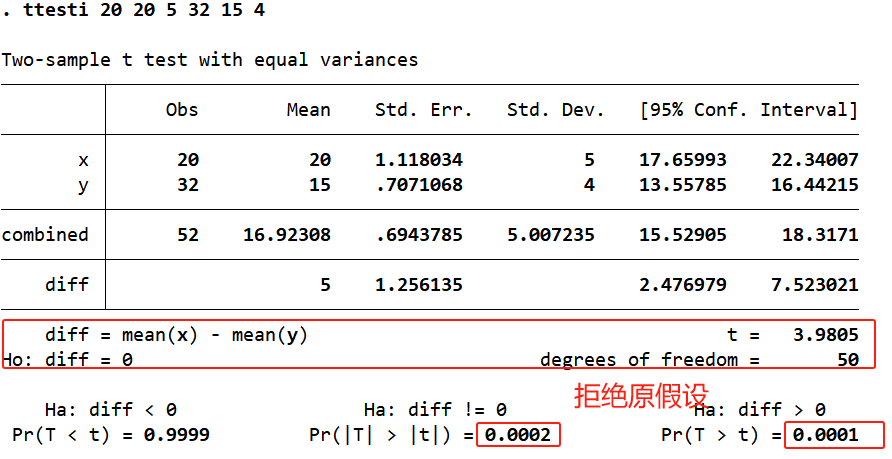
还有单样本检验
回归建模和结果可视化
简单线性回归
* 加载 Stata 自带的数据集 (第二次全国健康和营养调查数据)
* 这里我下载到本地
use nhanes2l,clear

* 绘制散点图,显示 bmi 和 age 的关系
twoway scatter bmi age

* 进行简单线性回归,分析 bmi 和 age 的关系
regress bmi age

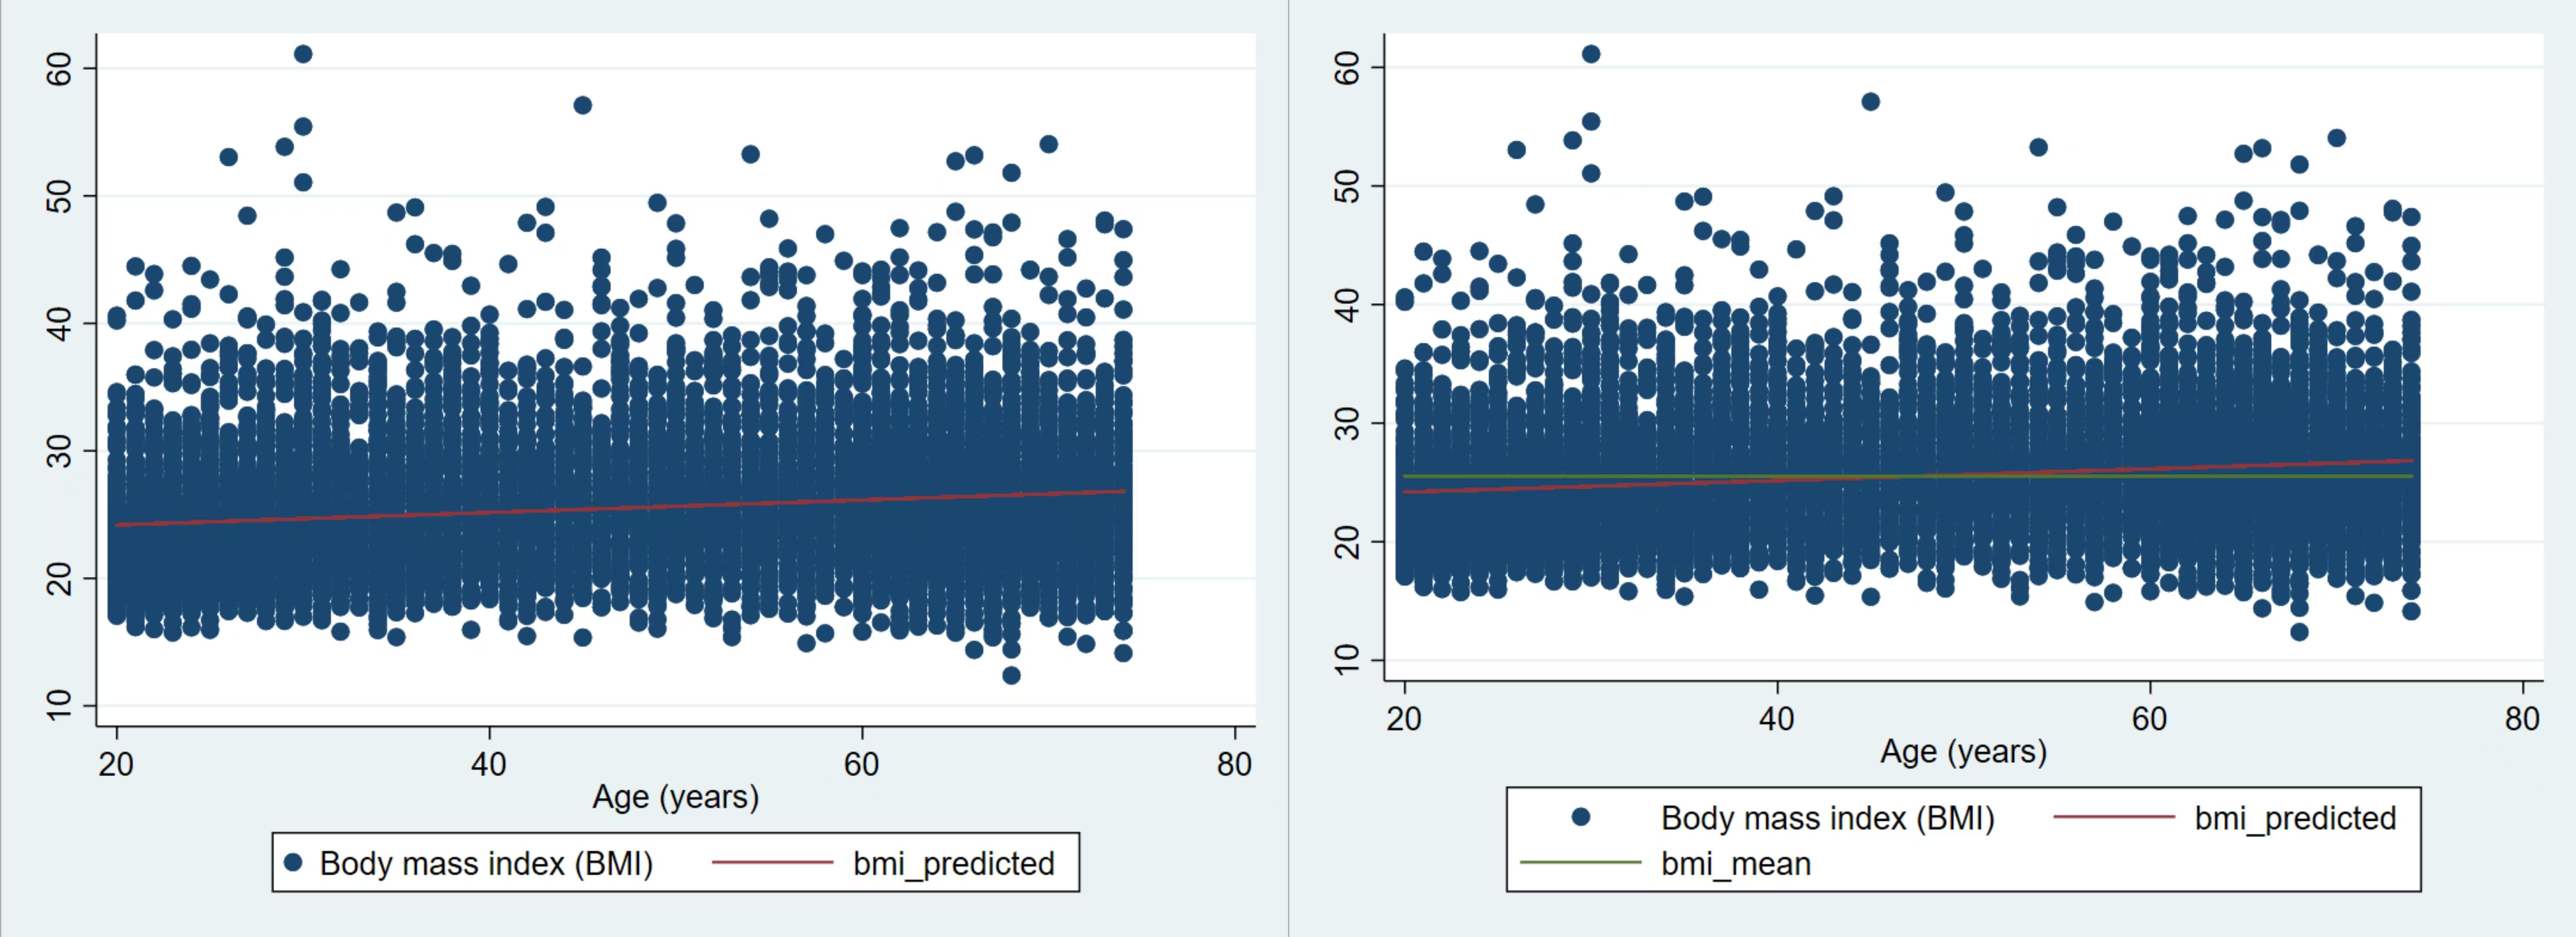
* 使用回归输出结果生成一个预测的 bmi 变量(回归线)
generate double bmi_predicted = 23.21209 + 0.0488762 * age

* 绘制散点图与回归线的图形,展示结果
twoway (scatter bmi age) (line bmi_predicted age)

* 使用 egen 创建 bmi_mean 变量,计算 bmi 的均值
egen double bmi_mean = mean(bmi)

* 绘制含有回归线和 bmi 平均线的图形
twoway (scatter bmi age) (line bmi_predicted age) (line bmi_mean age)

* 计算回归模型中总平方和、残差平方和和模型平方和
generate double ss_total = (bmi - bmi_mean)^2
generate double ss_residual = (bmi - bmi_predicted)^2
generate double ss_model = (bmi_predicted - bmi_mean)^2

* 显示 ss_total、ss_residual 和 ss_model 的总和
table, statistic(total ss_total) nformat(%16.3f  total)
table, statistic(total ss_residual) nformat(%16.3f  total)
table, statistic(total ss_model) nformat(%16.3f  total)
* 报错 varlist required

* 手动计算并显示回归模型的 R-squared
display "R-squared = " 7327.24496 / 250024.162

* 手动计算回归模型的 Root MSE(均方根误差)
display "Root MSE = " sqrt(23.4512433)

* 手动计算 t 值
display "t = " (0.0488762 - 0) / .0027651

* 计算 p 值 (双侧 t 检验)
display "P>|t| = " 2*ttail(10350, abs(17.68))

* 计算 95% 置信区间的上下限
display "Lower 95% CI bound = " .0488762 - invt(10350, 0.975) * .0027651
display "Upper 95% CI bound = " .0488762 + invt(10350, 0.975) * .0027651
下面左图中的线是回归线。
因子变量符号
* 加载 Stata 自带的数据集(第二次全国健康和营养调查数据)
use nhanes2l, clear

* 查看变量的描述信息
describe bpsystol hlthstat diabetes age bmi

* 查看变量的统计摘要
summarize bpsystol hlthstat diabetes age bmi

* 查看 hlthstat 的标签(健康状态)
label list hlth

* 生成模型:以 hlthstat(健康状态)为自变量进行回归分析,使用因子变量符号 i. 来处理分类变量
regress bpsystol i.hlthstat

* 查看回归结果的解释:系数代表不同健康状态组的 systolic blood pressure(血压)差异
* 例如,系数为 2.98 表示“Very good”组与“Excellent”组的 systolic blood pressure 差异为 2.98 mmHg

* 选择不同的参考类别,假设我们选择 hlthstat 类别 5 ("Poor") 为参考类别
regress bpsystol ib(5).hlthstat

* 使用 tabulate 查看各健康状态类别的样本量
tabulate hlthstat

* 使用 ib(frequent) 选择类别中样本量最大的类别作为参考类别(此处为 "Good")
regress bpsystol ib(frequent).hlthstat

* 使用 ib(none) 去除截距项,并且显示每个类别的均值(不使用参考类别)
regress bpsystol ib(none).hlthstat, noconstant

* 处理二元变量(例如 diabetes),使用因子变量符号 i. 来表示分类变量
regress bpsystol i.diabetes

* 选择“非糖尿病”作为参考类别,并运行回归分析
regress bpsystol ib(1).diabetes

* 使用 noconstant 去除截距项,并查看回归系数
regress bpsystol ib(none).diabetes, noconstant

* 处理连续变量与分类变量的交互效应:将 age(年龄)作为连续变量,与 diabetes(糖尿病)进行交互作用
regress bpsystol i.diabetes##c.age

* 处理更高阶交互效应:同时考虑 hlthstat 和 diabetes 与 age 的交互作用
regress bpsystol i.hlthstat##i.diabetes##c.age

* 使用括号语法(i.(hlthstat diabetes))来同时考虑 hlthstat 和 diabetes 的交互作用与 age 的交互效应
regress bpsystol i.(hlthstat diabetes)##c.age

* 处理连续变量与连续变量的交互效应,添加age^2
regress bpsystol c.age##c.age
因子变量符号 i.:通过 i.hlthstat 处理 hlthstat 作为一个分类变量,Stata 自动为每个类别生成虚拟变量(indicator variables),并使用最小的类别作为参考类别。
选择参考类别:使用 ib(#) 来设置一个特定的类别为参考类别,# 是类别的编号,例如 ib(5) 选择“Poor”作为参考类别。
交互作用:使用 ## 来指定两个变量的主效应及交互效应。
二元预测变量的边距和边距图
* 加载数据集并查看变量描述
use nhanes2l, clear  // 加载示例数据集
describe bpsystol diabetes  // 查看变量描述

* 查看变量的摘要统计
summarize bpsystol diabetes  // 查看 systolic blood pressure (bpsystol) 和 diabetes 的摘要统计

* 拟合一个线性回归模型,使用二元预测变量 diabetes 预测 bpsystol
regress bpsystol i.diabetes
/*
   使用 i.diabetes 将 diabetes 作为分类变量处理,并进行回归分析。
   输出中可以看到,diabetes 变量的系数为 16.56328,表示有糖尿病的人的预计收缩压比没有糖尿病的人高 16.56 mmHg。
*/

* 计算没有糖尿病和有糖尿病的预测收缩压
display "E(SBP | no diabetes) = " 130.088 + 16.56328 * 0  // 没有糖尿病时的预测收缩压
display "E(SBP | diabetes) = " 130.088 + 16.56328 * 1  // 有糖尿病时的预测收缩压

* 使用 margins 命令估计每组的期望收缩压(SBP)
margins diabetes
/*
   margins 命令计算 diabetes 变量的每个类别的预测值(没有糖尿病和有糖尿病)。
   输出包括每个类别的预测值、标准误差、t 值、p 值以及 95% 置信区间。
*/

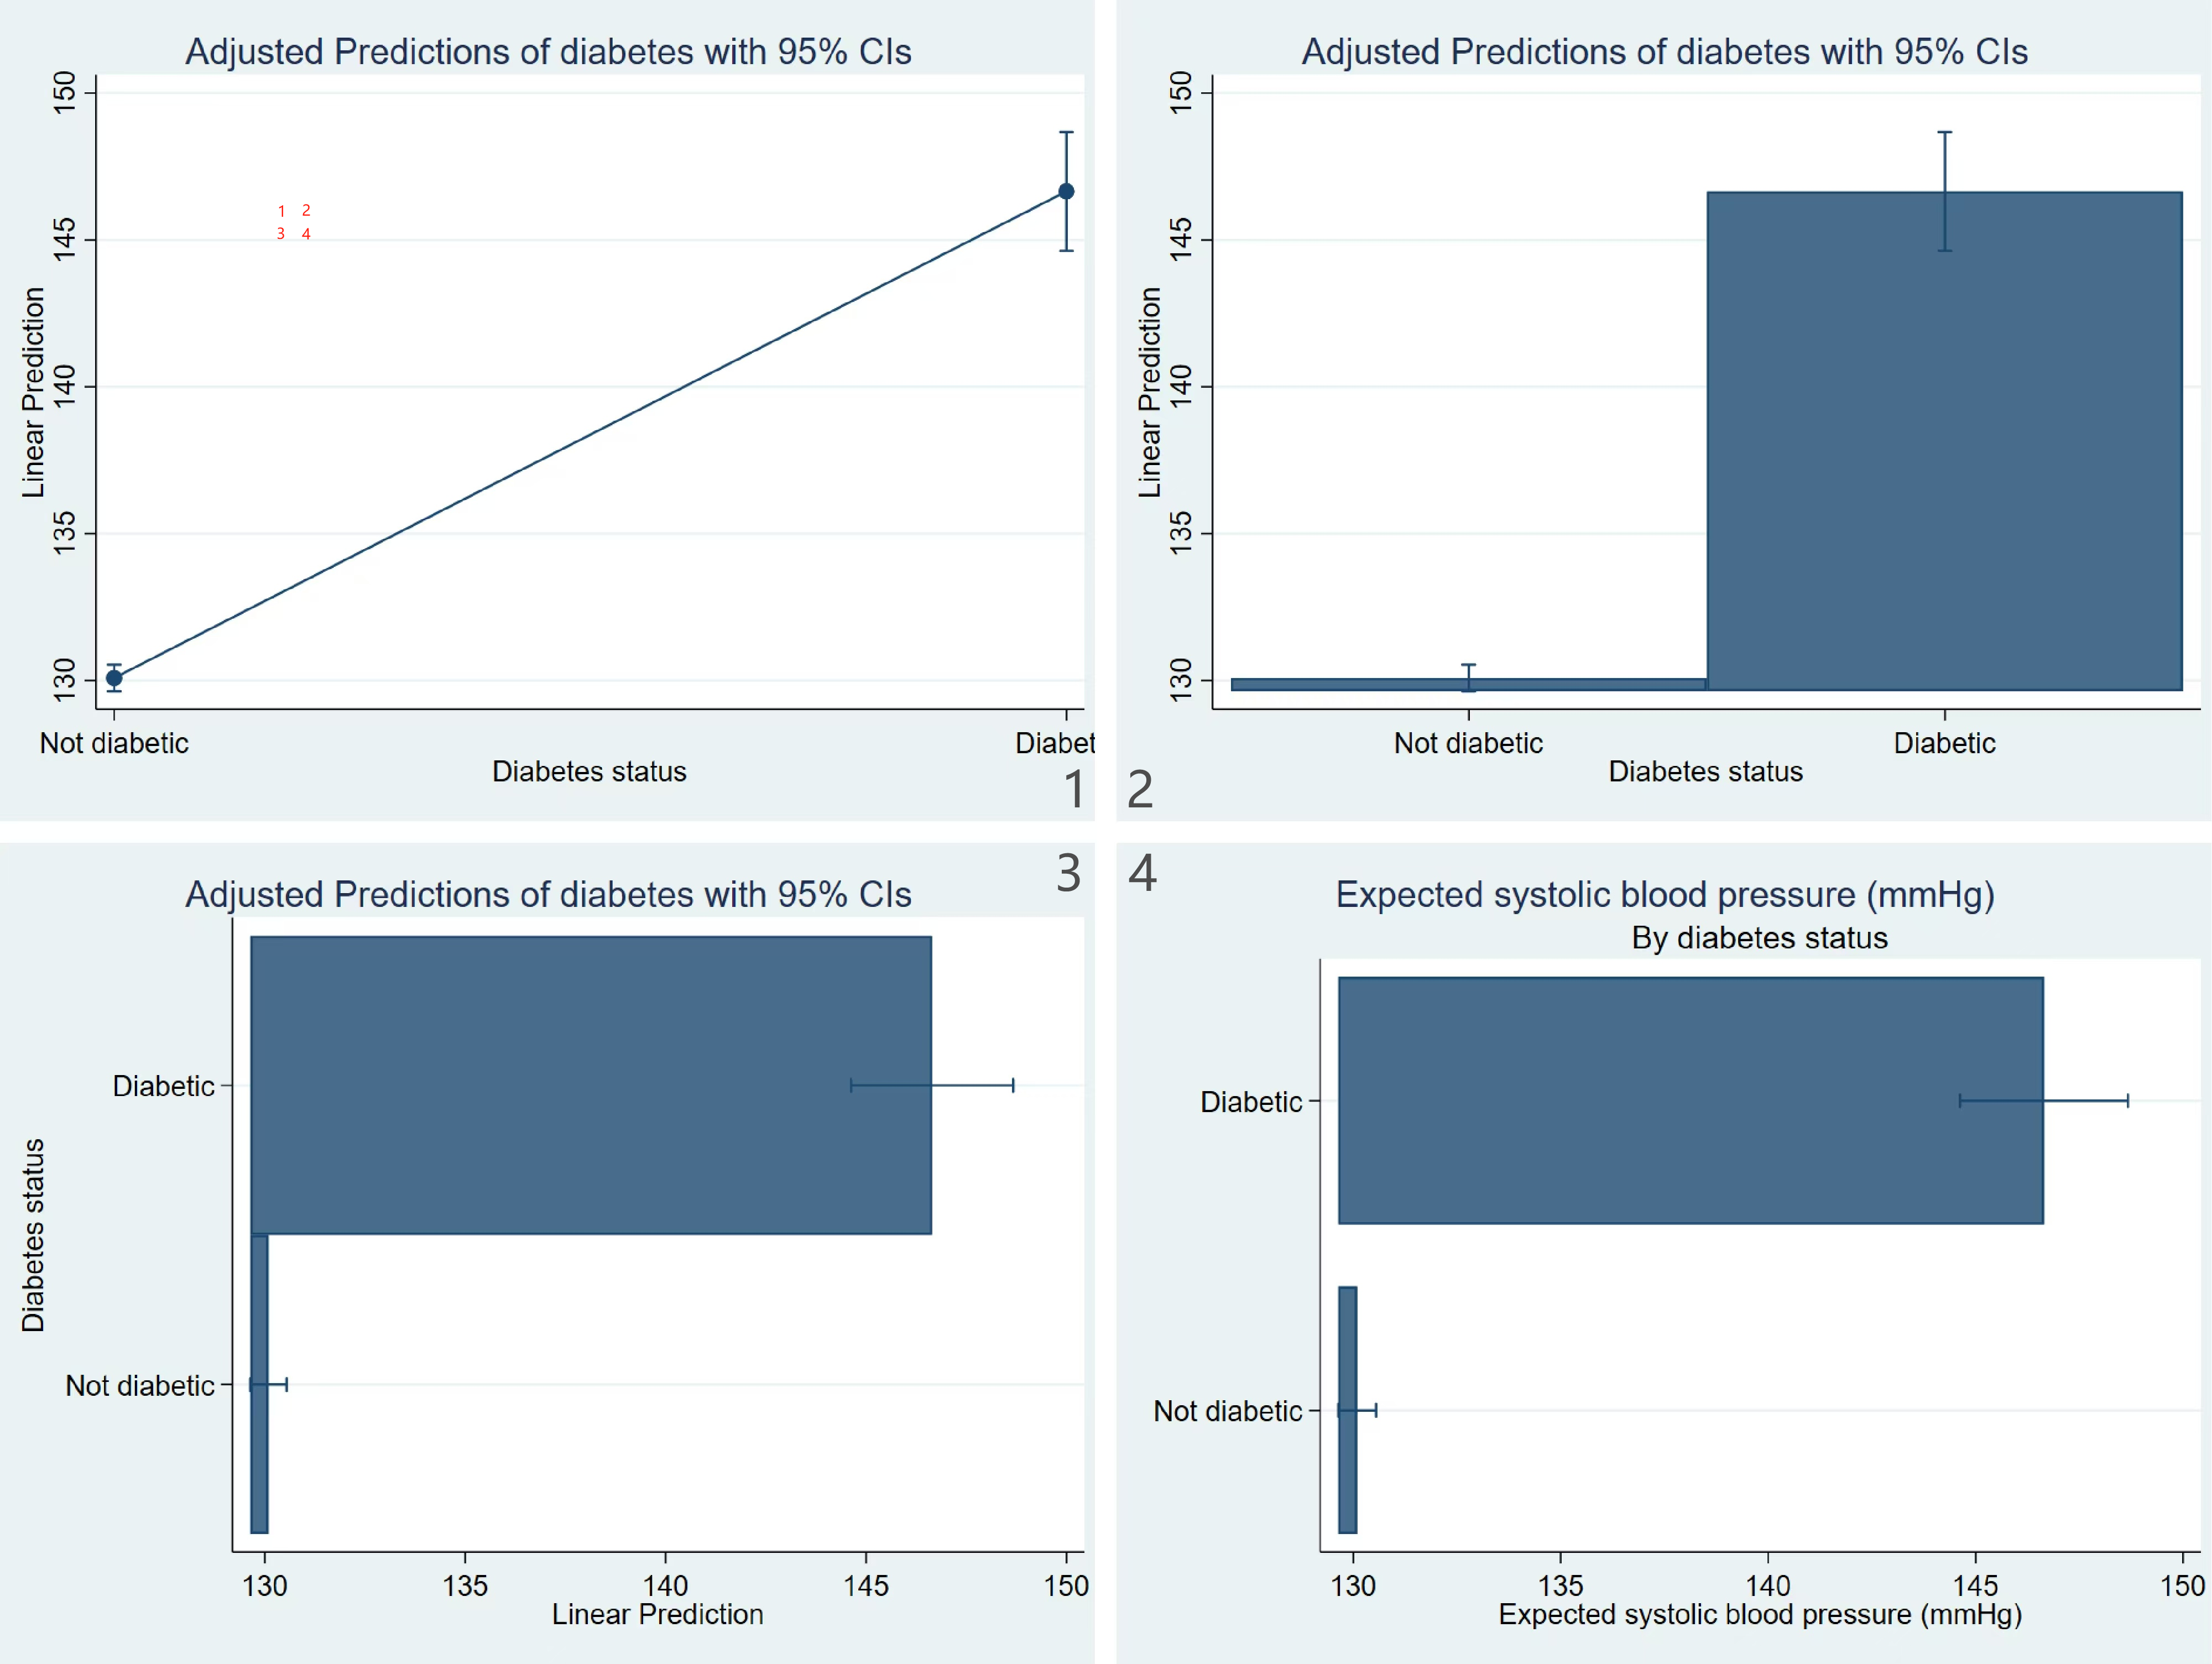
* 使用 marginsplot 命令绘制边际预测和置信区间
marginsplot
/*
   marginsplot 默认绘制边际预测的折线图。该图显示了不同糖尿病状态下的收缩压预测值。
*/

* 如果我们想要条形图(dynamite plunger plot),可以使用 recast(bar) 选项
marginsplot, recast(bar)
/*
   recast(bar) 将图表类型改为条形图,适合展示每个类别的边际预测值。
*/

* 如果需要横向条形图,可以添加 horizontal 选项
marginsplot, recast(bar) horizontal
/*
   使用 horizontal 选项创建横向条形图。
*/

* 进一步美化图表,添加间距和标题
marginsplot, recast(bar) horizontal plotopts(barwidth(0.8))  /// 设置条形宽度
    title("Expected systolic blood pressure (mmHg)")  /// 图表标题
    subtitle("By diabetes status")  /// 副标题
    xtitle("Expected systolic blood pressure (mmHg)")  /// X轴标题
    ytitle("")
/*
   使用 plotopts(barwidth(0.8)) 设置条形的宽度,title()、subtitle() 和 xtitle()、ytitle() 选项添加标题和轴标签。
*/
两个分类预测变量相互作用的边距和边距图
* 加载数据集并查看变量描述
use nhanes2l, clear  // 加载示例数据集
describe bpsystol hlthstat diabetes age bmi  // 查看变量描述

* 查看变量的摘要统计
summarize bpsystol hlthstat diabetes age bmi  // 查看 systolic blood pressure (bpsystol) 和其他变量的摘要统计

* 拟合一个线性回归模型,使用二元预测变量 diabetes 和分类变量 hlthstat 预测 bpsystol
regress bpsystol i.hlthstat##i.diabetes  // 使用 i.hlthstat 和 i.diabetes 表示分类变量并拟合回归模型
/*
   输出包括 hlthstat 和 diabetes 的主效应以及它们的交互效应。
   对于每种健康状况和糖尿病状态的组合,Stata 会计算期望的收缩压(SBP)。
*/

* 使用 margins 命令估计 hlthstat 和 diabetes 组合的边际预测
margins diabetes#hlthstat  // 计算糖尿病状态和健康状况的每个组合的边际预测
/*
   输出包括每个组合的期望 SBP 值,例如“没有糖尿病且健康状态为 Excellent”时的预测 SBP。
*/

* 使用 marginsplot 命令绘制边际预测和置信区间
marginsplot  // 默认绘制折线图,显示每种分类组合的边际预测值及其置信区间

* 改变两个变量的顺序
margins hlthstat#diabetes
marginsplot
* 如果我们想要条形图,可以使用 recast(bar) 选项
marginsplot, recast(bar) xdimension(hlthstat diabetes)
* 添加横向条形图
marginsplot, recast(bar) horizontal xdimension(hlthstat diabetes)

* 进一步美化图表,设置条形宽度、标题和轴标签
marginsplot, recast(bar) xdimension(hlthstat diabetes) ///
             horizontal plotopts(barwidth(0.8)) ///
             ytitle("") xtitle("Expected systolic blood pressure") ///
             title("Expected systolic blood pressure (mmHg)") ///
             subtitle("By health status and diabetes status")
/*
   使用 plotopts 设置条形宽度,使用 title() 和 xtitle() 设置标题和轴标签。
   ytitle("") 移除 Y 轴标题。
*/
margins diabetes#hlthstat:计算糖尿病状态和健康状况的每个组合的边际效应(即不同组合下的 SBP 预测值)。
marginsplot:使用图形化工具显示边际效应的结果。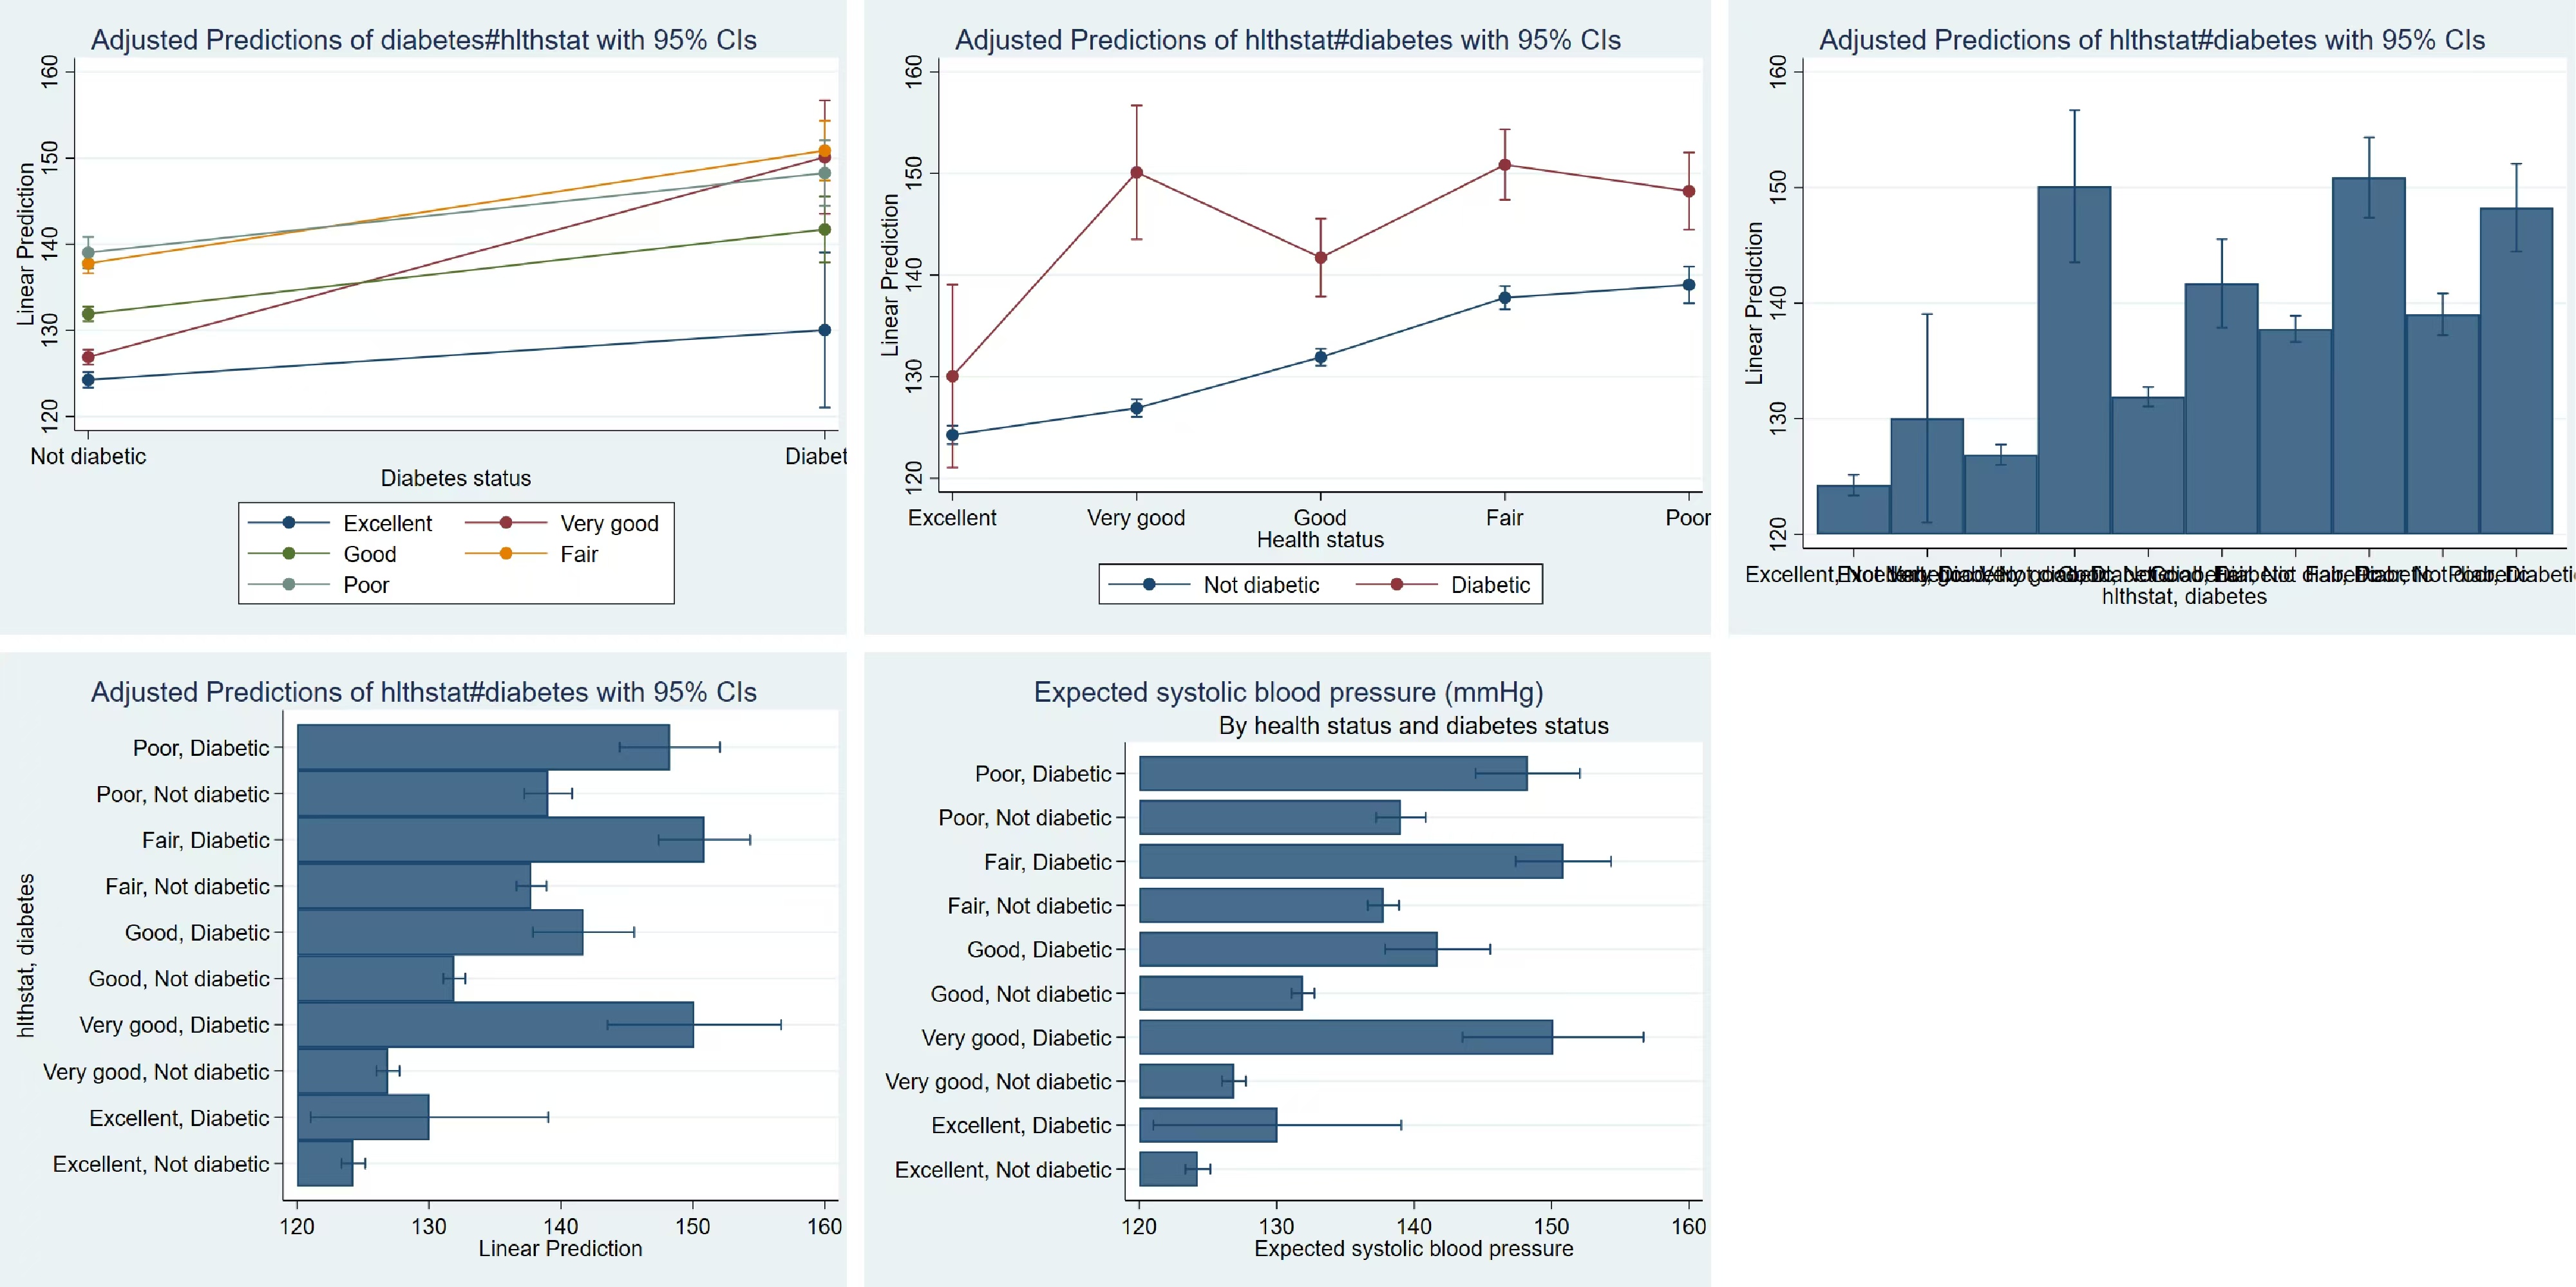

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 65
 0
- 0


 已为社区贡献1条内容

所有评论(0)