数据残差可视化分析
残差分析在数据分析是一种非常重要的工具。通过分析模型的残差(即实际值与预测值之间的差异),我们可以判断模型的性能、发现潜在问题,并进行相应的改进。
残差是观测值与模型预测值之间的差异。具体来说,对于每一个数据点,其残差可以定义为:
e =y_实际 − y_预测
其中,y_实际是实际观测值,y_预测是预测值,e是残差。残差表示模型未能捕捉的误差部分,它包含了可能由于数据噪声或模型不完善导致的偏差。
【残差分析作用】
残差分析的核心作用在于评估和诊断模型的适应性。他帮助我们验证模型假设、检测数据中的异常值以及了解模型的预测能力。残差分析可以帮助我们判断以下问题↓
1.模型假设是否成立:通过分析残差的分布特性(如正态性、独立性、同方差性),可以验证回归模型的基本假设;
2.是否存在异常值:通过残差图,我们可以识别数据中的异常点,这些点可能极大地影响模型的拟合效果;
3.模型的拟合程度如何:残差图可以显示模型的拟合是否充分,是否存在系统性偏差;
4.如何改进模型:识别模型的不足之处,帮助确定是否需要使用非线性模型、引入交互项或其他特征。
残差分析包含多种方法,每种方法都有其独特的用途和解释方式。以下是最常用的残差分析方法↓
【残差图】
残差图是最常见的残差分析工具,通过绘制残差与预测值或自变量的散点图来评估模型的拟合效果。理想情况下,残差应当随机分布在零附近,且无明显的结构性模式。这表明模型捕捉到了数据的所有信息,残差只包含随机噪声↓
1.用于检测线性关系假设:残差应随机分布,如果发现残差图呈现某种趋势或模式,说明模型可能漏掉了某些非线性特征;
2.用于检测同方差性假设:残差的散点应该均匀分布,若随预测值或自变量的变化,残差的分散程度不一致,则表明存在异方差性。
下面分别模拟两组数据,来演示正常的残差图和非正常的残差图↓
import numpy as np``import pandas as pd``import matplotlib.pyplot as plt``import seaborn as sns``from sklearn.linear_model import LinearRegression``from sklearn.model_selection import train_test_split``X = 2 * np.random.rand(1000, 1)``y = 3 * X + 5 + np.random.randn(1000, 1)``X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)``model = LinearRegression()``model.fit(X_train, y_train)``y_pred = model.predict(X_test)``residuals = y_test - y_pred``plt.figure(figsize=(10, 6))``sns.residplot(x=y_pred.flatten(), y=residuals.flatten(), lowess=True, line_kws={'color': 'red', 'lw': 2})``plt.xlabel('预测值', fontsize=14)``plt.ylabel('残差', fontsize=14)``plt.title('正常残差图:预测值 vs 残差', fontsize=16)``plt.axhline(0, color='black', linestyle='--', lw=1.5)``plt.show()
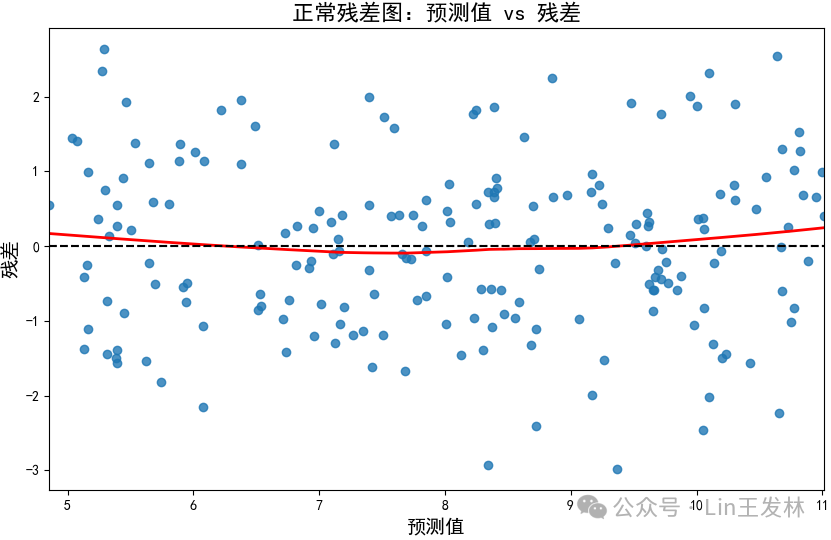
正常残差图:残差随机分布在零线附近,没有明显的模式或趋势,表明线性模型拟合良好。
# 模拟不正常残差:引入非线性关系``y_non_linear = 3 * X**2 + 5 + np.random.randn(1000, 1)``X_train_nl, X_test_nl, y_train_nl, y_test_nl = train_test_split(X, y_non_linear, test_size=0.2)``model_nl = LinearRegression()``model_nl.fit(X_train_nl, y_train_nl)``y_pred_nl = model_nl.predict(X_test_nl)``residuals_nl = y_test_nl - y_pred_nl``# 绘制不正常的残差图``plt.figure(figsize=(10, 6))``sns.residplot(x=y_pred_nl.flatten(), y=residuals_nl.flatten(), lowess=True, line_kws={'color': 'red', 'lw': 2})``plt.xlabel('预测值', fontsize=14)``plt.ylabel('残差', fontsize=14)``plt.title('不正常残差图:非线性模式', fontsize=16)``plt.axhline(0, color='black', linestyle='--', lw=1.5)``plt.show()
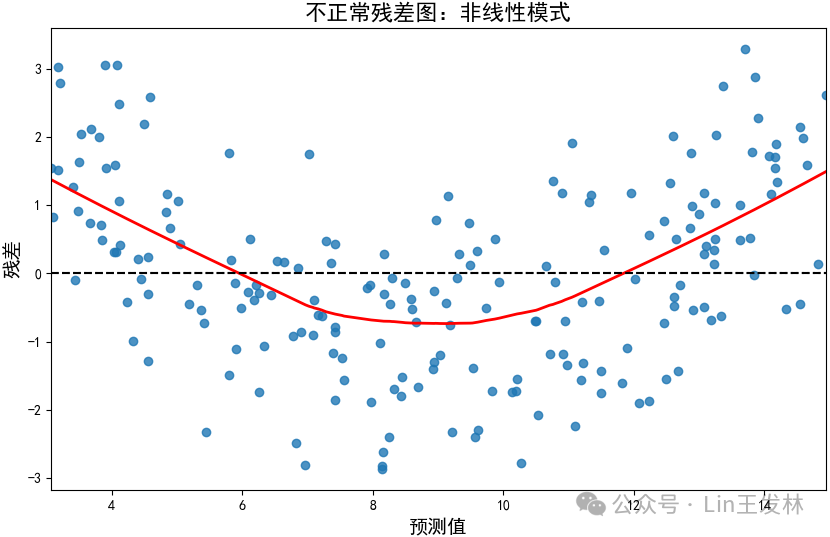
因为我们假如和非线性关系,但是还是用的线性回归模型进行拟合的,所有就出现了不正常残差图:残差呈现曲线模式,表明数据中存在未被捕捉的非线性关系,需要改进模型(如引入多项式项)。
【Q-Q 图】
Q-Q(Quantile-Quantile)图用于检查残差是否符合正态分布的假设。正态性是许多统计检验(如t检验、F检验)的前提条件。Q-Q 图通过将样本分位数与理论正态分位数进行比较,如果残差符合正态分布,数据点将沿对角线排列。
-
验证正态性假设:检查残差是否符合正态分布。
-
识别异常点和重尾现象:点偏离直线表明残差分布有重尾或异常点。
下面继续使用上面的数据,来演示正常残差和非正常残差图形↓
import scipy.stats as stats``# 正常残差:使用线性回归的残差``plt.figure(figsize=(10, 6))``stats.probplot(residuals.flatten(), dist="norm", plot=plt)``plt.title('正常 Q-Q 图:检查残差正态性', fontsize=16)``plt.xlabel('理论分位数', fontsize=14)``plt.ylabel('样本分位数', fontsize=14)``plt.grid(True)``plt.show()
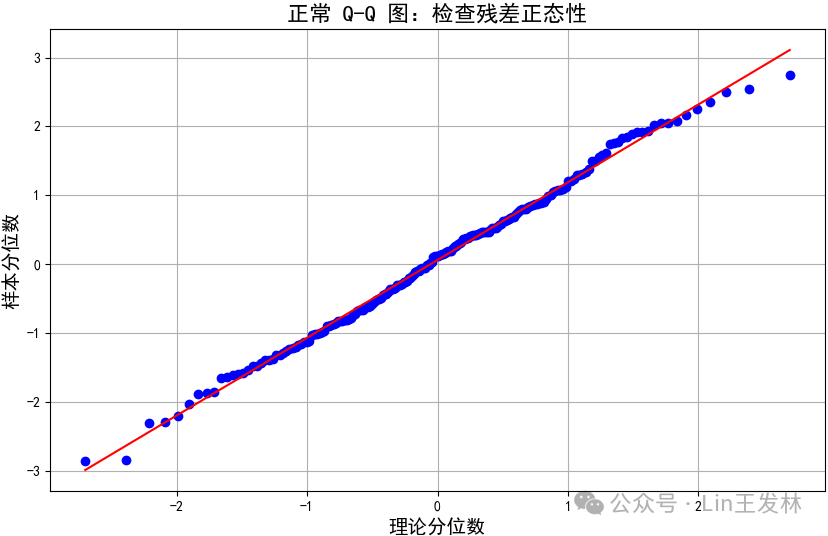
正常 Q-Q 图:数据点沿对角线排列,说明残差接近正态分布,符合正态性假设。
# 不正常残差:引入非正态残差``y_skewed = 3 * X + 5 + np.random.chisquare(2, size=(1000, 1)) # 使用卡方分布引入偏斜``X_train_sk, X_test_sk, y_train_sk, y_test_sk = train_test_split(X, y_skewed, test_size=0.2)``model_sk = LinearRegression()``model_sk.fit(X_train_sk, y_train_sk)``y_pred_sk = model_sk.predict(X_test_sk)``residuals_sk = y_test_sk - y_pred_sk``plt.figure(figsize=(10, 6))``stats.probplot(residuals_sk.flatten(), dist="norm", plot=plt)``plt.title('不正常 Q-Q 图:偏斜分布的残差', fontsize=16)``plt.xlabel('理论分位数', fontsize=14)``plt.ylabel('样本分位数', fontsize=14)``plt.grid(True)``plt.show()
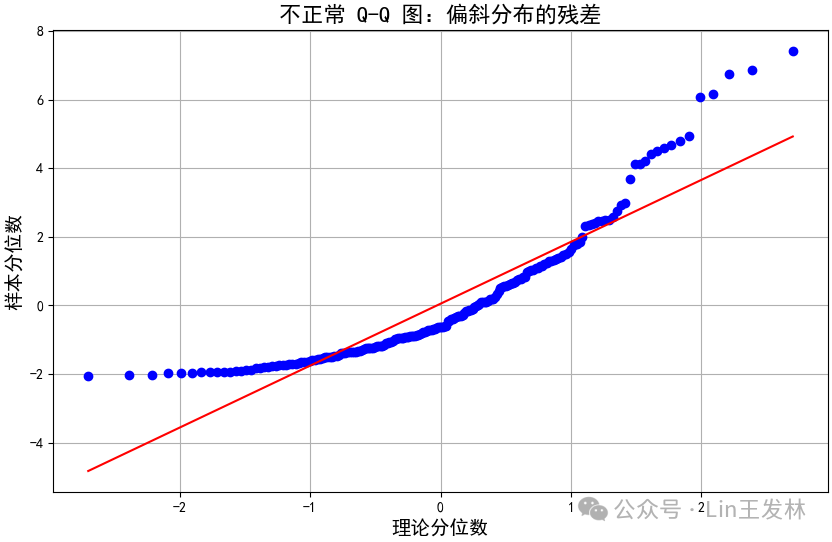
不正常 Q-Q 图:数据点明显偏离对角线,表明残差偏斜(非正态),可能需要数据变换或更复杂的模型。
【残差直方图】
残差直方图用于直接查看残差的分布形状。理想情况下,残差应呈现对称的钟形曲线,接近于正态分布。这有助于验证模型的正态性假设。
检查正态性:验证残差的正态分布假设。
识别偏斜和峰度:查看是否存在残差的偏斜或重尾现象。
# 正常残差直方图``plt.figure(figsize=(10, 6))``sns.histplot(residuals.flatten(), bins=30, kde=True, color='blue')``plt.title('正常残差的直方图', fontsize=16)``plt.xlabel('残差', fontsize=14)``plt.ylabel('频率', fontsize=14)``plt.grid(True)``plt.show()
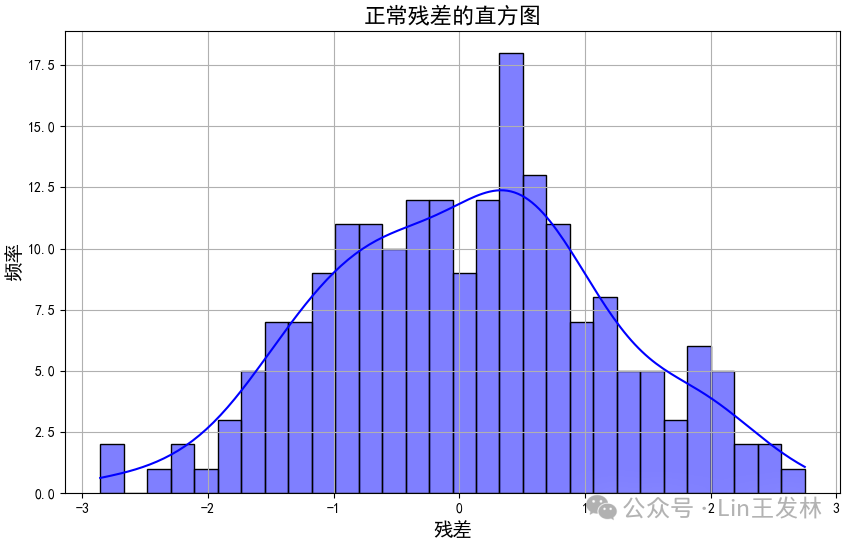
正常残差直方图:呈现对称的钟形曲线,表明残差分布接近正态。
# 不正常残差直方图:引入偏斜``plt.figure(figsize=(10, 6))``sns.histplot(residuals_sk.flatten(), bins=30, kde=True, color='orange')``plt.title('不正常残差的直方图:偏斜分布', fontsize=16)``plt.xlabel('残差', fontsize=14)``plt.ylabel('频率', fontsize=14)``plt.grid(True)``plt.show()
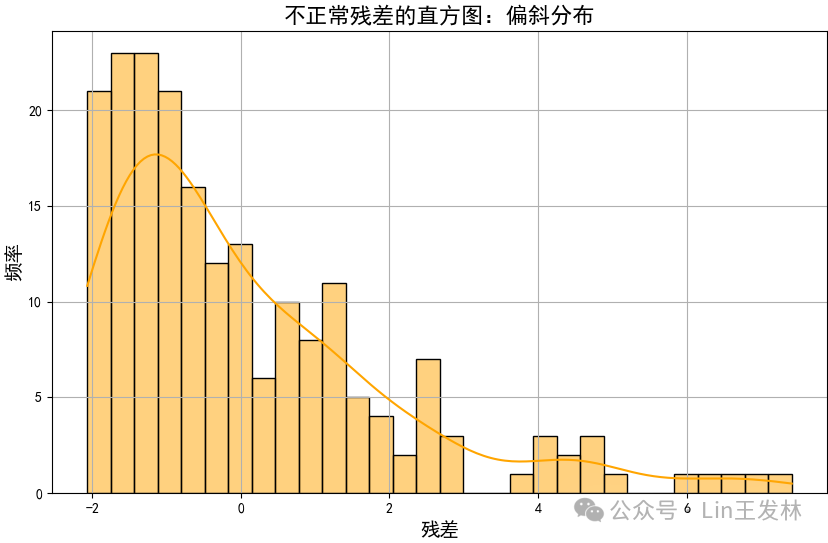
不正常残差直方图:分布偏斜,峰值不对称,表明残差偏离正态分布。
【标准化残差图】
标准化残差图通过标准化残差使得不同残差具有相同的单位,方便识别异常值。标准化残差是残差除以其标准差后的结果。标准化残差的绝大多数值应在 [-2, 2] 之间,超出此范围的点可能是异常值。
异常值检测:识别标准化残差大于2或小于-2的点。
验证残差分布一致性:检查标准化后残差是否符合模型假设。
# 标准化残差计算``std_residuals = residuals / np.std(residuals)``plt.figure(figsize=(10, 6))``plt.scatter(y_pred.flatten(), std_residuals.flatten(), alpha=0.6, edgecolors='k', linewidths=0.5)``plt.axhline(2, color='red', linestyle='--', lw=1.5)``plt.axhline(-2, color='red', linestyle='--', lw=1.5)``plt.xlabel('预测值', fontsize=14)``plt.ylabel('标准化残差', fontsize=14)``plt.title('正常标准化残差图', fontsize=16)``plt.show()
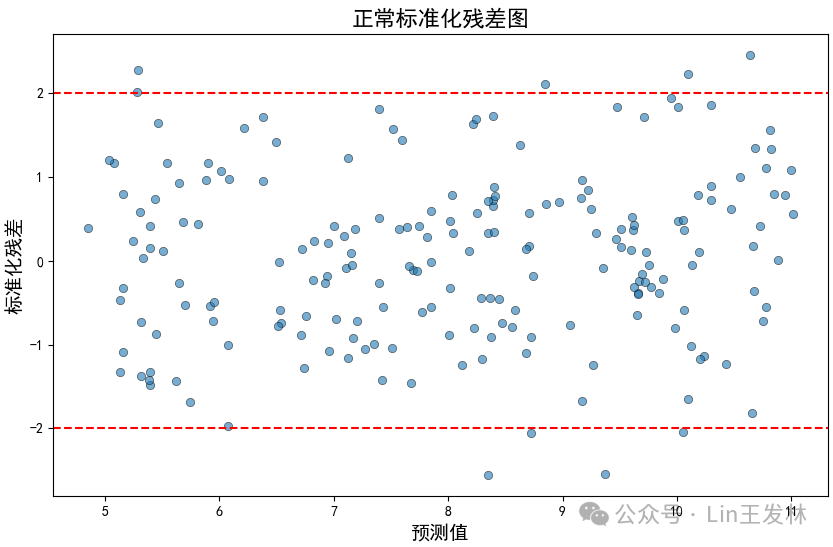
正常标准化残差图:大多数点在 [-2, 2] 范围内,没有显著的异常值。
# 不正常标准化残差图``std_residuals_sk = residuals_sk / np.std(residuals_sk)``plt.figure(figsize=(10, 6))``plt.scatter(y_pred_sk.flatten(), std_residuals_sk.flatten(), alpha=0.6, edgecolors='k', linewidths=0.5, color='orange')``plt.axhline(2, color='red', linestyle='--', lw=1.5)``plt.axhline(-2, color='red', linestyle='--', lw=1.5)``plt.xlabel('预测值', fontsize=14)``plt.ylabel('标准化残差', fontsize=14)``plt.title('不正常标准化残差图', fontsize=16)``plt.show()
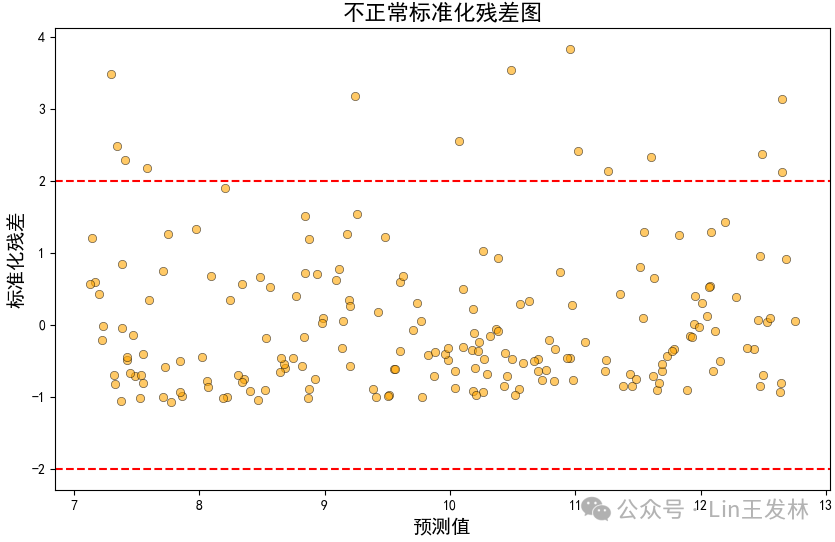
不正常标准化残差图:有更多点超出 [-2, 2] 范围,可能存在异常值或数据分布问题。
【残差自相关图】
残差自相关图用于检测残差之间是否存在自相关性。理想情况下,不应存在显著的自相关性(除零滞后外)。如果残差有自相关性,表明模型未能捕捉到数据中的某些模式。
检测自相关性:识别残差之间的依赖性,检查模型是否有效。
模型改进提示:残差自相关可能暗示模型中未捕获的时间序列模式。
import numpy as np``import pandas as pd``import matplotlib.pyplot as plt``import seaborn as sns``from sklearn.linear_model import LinearRegression``from sklearn.model_selection import train_test_split``from statsmodels.graphics.tsaplots import plot_acf``X_normal = np.random.rand(1000, 1)``y_normal = 3 * X_normal + 5 + np.random.randn(1000, 1) * 0.5``# 拆分数据集并拟合模型``X_train_norm, X_test_norm, y_train_norm, y_test_norm = train_test_split(X_normal, y_normal, test_size=0.2, random_state=42)``model_norm = LinearRegression()``model_norm.fit(X_train_norm, y_train_norm)``y_pred_norm = model_norm.predict(X_test_norm)``# 计算残差``residuals_norm = y_test_norm - y_pred_norm``# 绘制正常残差自相关图``plot_acf(residuals_norm.flatten(), lags=20)``plt.title('正常残差自相关图:无明显自相关性', fontsize=16)``plt.xlabel('滞后', fontsize=14)``plt.ylabel('自相关', fontsize=14)``plt.grid(True)``plt.show()
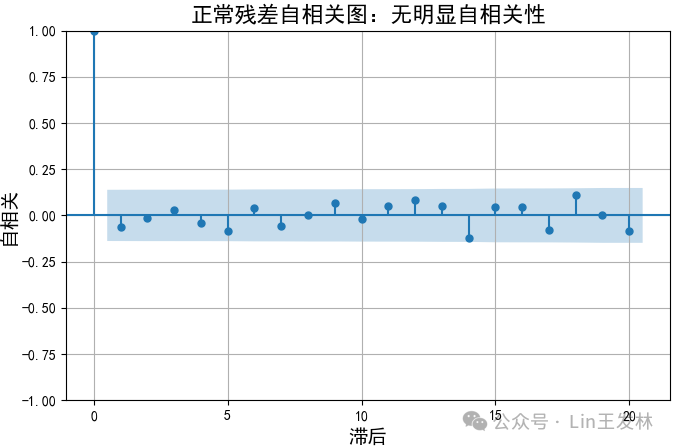
正常残差自相关图:除零滞后外,其余滞后的自相关值接近于零,表明残差独立。
# 模拟数据生成:不正常情况(有显著自相关)``X_autocorrelated = np.random.rand(1000, 1)``y_autocorrelated = 3 * X_autocorrelated + 5 + np.random.randn(1000, 1) * 0.5``# 引入显著自相关性``for i in range(1, len(y_autocorrelated)):` `y_autocorrelated[i] += 0.95 * y_autocorrelated[i - 1]``# 拆分数据集并拟合模型``X_train_ac, X_test_ac, y_train_ac, y_test_ac = train_test_split(X_autocorrelated, y_autocorrelated, test_size=0.2, random_state=42)``model_ac = LinearRegression()``model_ac.fit(X_train_ac, y_train_ac)``y_pred_ac = model_ac.predict(X_test_ac)``# 计算残差``residuals_ac = y_test_ac - y_pred_ac``# 绘制不正常残差自相关图``plot_acf(residuals_ac.flatten(), lags=20)``plt.title('不正常残差自相关图:存在显著自相关性', fontsize=16)``plt.xlabel('滞后', fontsize=14)``plt.ylabel('自相关', fontsize=14)``plt.grid(True)``plt.show()
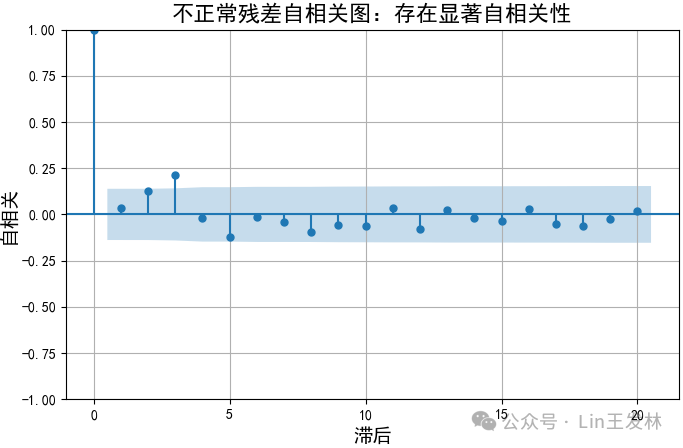
在不正常情况下,我们引入了一个显著的自相关项(0.95的滞后自相关)。这导致残差在多个滞后期上表现出明显的自相关性。在自相关图中,滞后项的自相关值远离零并且在多个滞后期上显著,这表明数据中存在时间序列特性或未被捕捉的模式。这样的自相关性违反了线性回归模型的独立性假设,提示我们需要考虑使用时间序列模型或更复杂的回归模型来捕捉这些模式。
通过这些残差分析方法,我们可以更深入地理解模型的适用性和准确性。每种方法都有助于识别不同类型的模型问题。对于不同的残差模式,可以采取适当的措施来改进模型,如引入多项式项、数据变换、异常值处理或使用更复杂的时间序列模型。这些步骤确保了模型的可靠性和预测的准确性。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
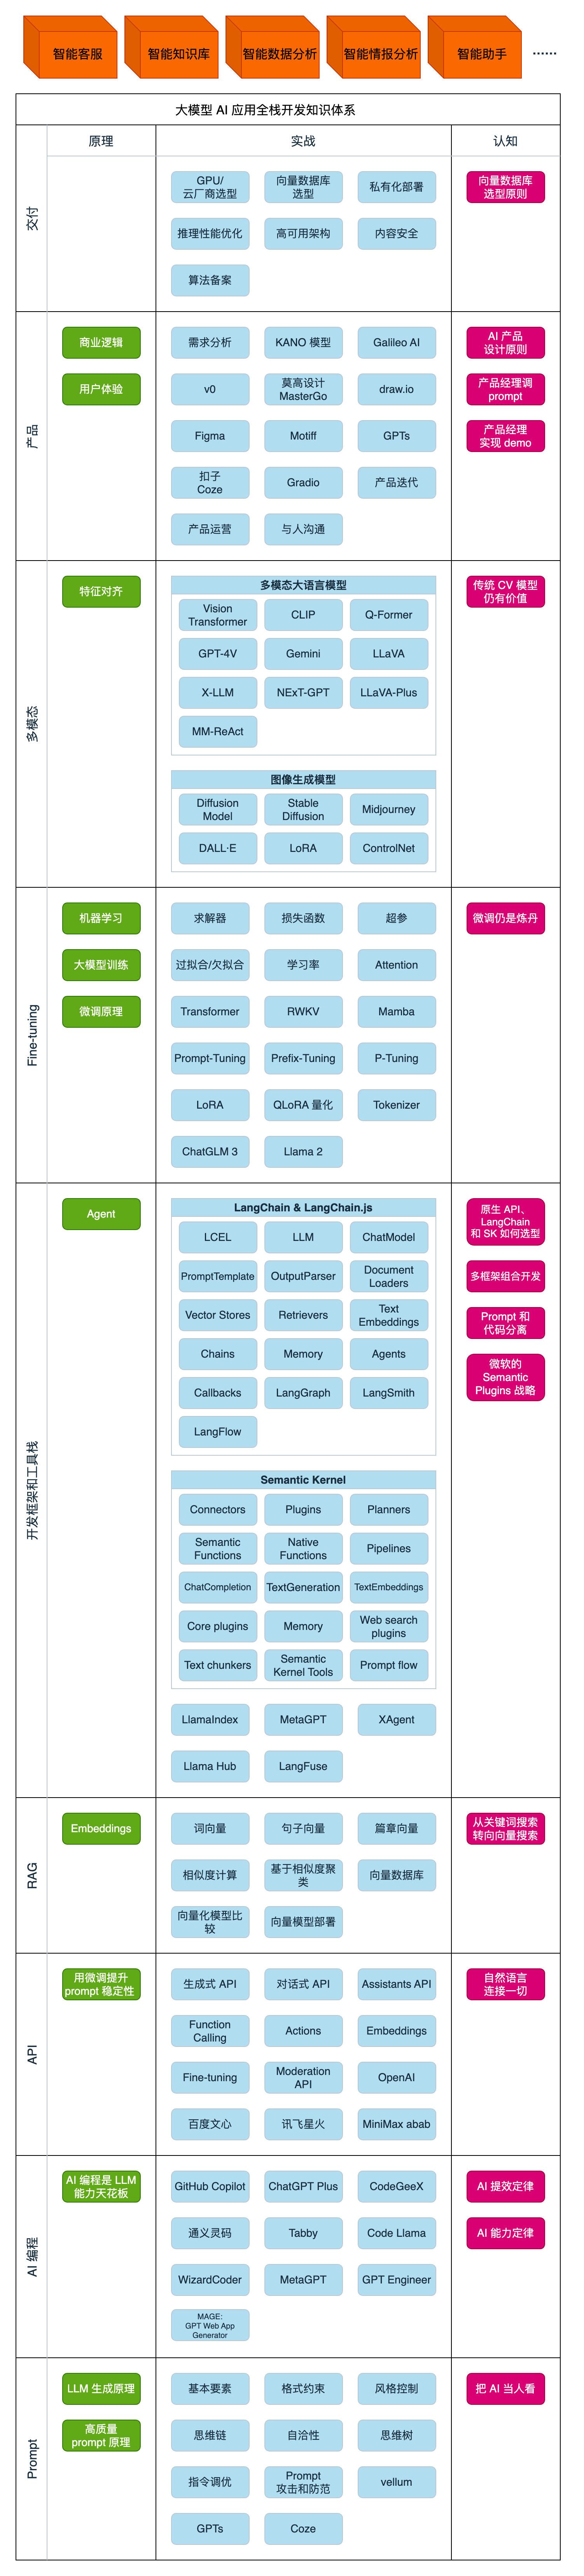
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 24
 0
- 0


 已为社区贡献226条内容

所有评论(0)