LangChain 可以落地的教程
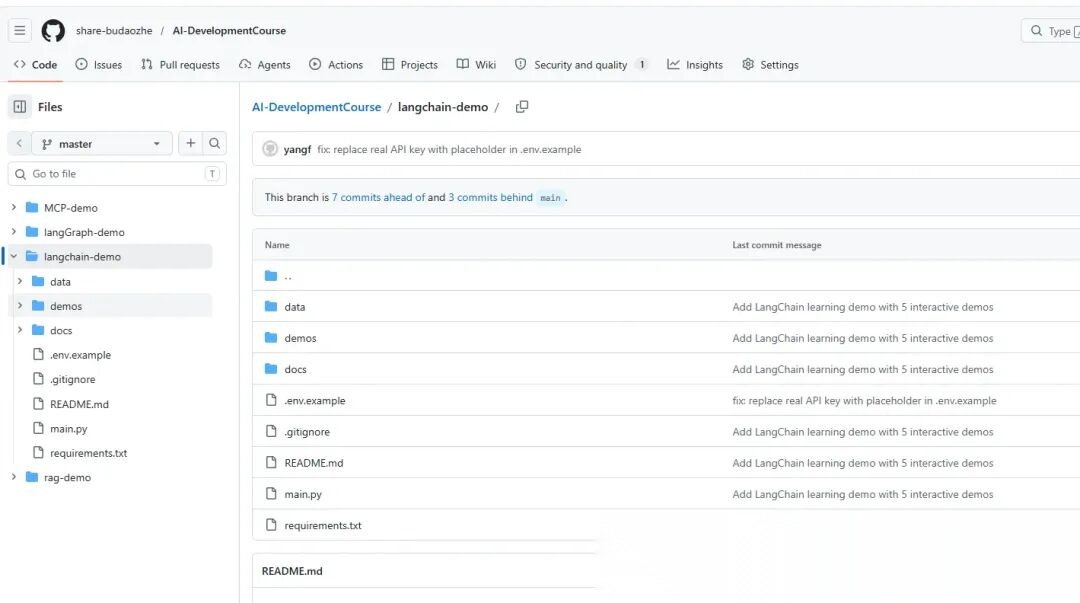
github地址:https://github.com/share-budaozhe/AI-DevelopmentCourse/tree/master/langchain-demo
- 项目目标
本项目通过 5 个递进的 Demo,覆盖 LangChain 框架的核心应用场景。
每个 Demo 都是可独立运行的 Python 脚本,配有详细的知识点说明、启发性问题和参考答案。
- 架构总览
用户输入
|
v
+---------+    +-----------+    +-----------+
| Prompt   | -> | LLM       | -> | Output    |
| Template |    | (OpenAI/  |    | Parser    |
|          |    | DeepSeek) |    |           |
+---------+    +-----------+    +-----------+
|                |
v                v
+---------+    +-----------+
| Memory  |    | Tools     |
|         |    | (Agent)   |
+---------+    +-----------+
|                |
v                v
+-----------------------------+
| Retrieval (Vector Store)    |
| Document -> Split -> Embed  |
+-----------------------------+
- 学习路径
| 阶段 | Demo | 核心知识 | 前置要求 |
| 入门 | 01 基础 | Model I/O, Prompt, Parser | 无 |
| 进阶 | 02 Chains | LCEL, Runnable 组合 | Demo 01 |
| 进阶 | 03 RAG | 文档检索、向量存储 | Demo 01 |
| 高级 | 04 Agents | Tools, ReAct, 自主决策 | Demo 01, 02 |
| 高级 | 05 Memory | 对话历史、会话管理 | Demo 01, 02 |
- 技术栈
框架
: LangChain 1.x + LangGraph
LLM 后端
: OpenAI (GPT-4o-mini) / DeepSeek (deepseek-chat)
向量数据库
: ChromaDB
Embedding
: OpenAI text-embedding-3-small
配置管理
: python-dotenv
如何切换 LLM 后端
编辑
.env
文件:
# 使用 DeepSeek
LLM_PROVIDER=deepseek
DEEPSEEK_API_KEY=sk-你的key
# 或使用 OpenAI (默认)
LLM_PROVIDER=openai
OPENAI_API_KEY=sk-你的key
注意: DeepSeek 目前不提供 Embedding API,因此 Demo 03 (RAG) 中的向量化仍需 OpenAI API。
- LangChain 学习 Demo
一套覆盖 LangChain 核心应用场景的演示代码,配有详细的知识点文档、启发性问题和参考答案。
每个 Demo 都支持 演示模式 (自动运行) 和 交互模式 (动手实验)。
项目结构
langchain-demo/
├── main.py                        # 总入口,支持 --guided / --interactive
├── requirements.txt
├── .env.example                   # 支持 OpenAI + DeepSeek
├── README.md
├── demos/
│   ├── config.py                  # 统一 LLM 配置模块
│   ├── demo_01_basics.py          # 基础 + 交互式自由提问/角色扮演/翻译
│   ├── demo_02_chains.py          # Chains + 交互式链实验台
│   ├── demo_03_rag.py             # RAG + 交互式知识库问答
│   ├── demo_04_agents.py          # Agents + 交互式智能助手
│   └── demo_05_memory.py          # Memory + 交互式多轮对话/会话切换
├── data/                          # RAG 知识文档
└── docs/                          # 学习文档
├── overview.md
├── 01_basics.md ~ 05_memory.md
├── questions/                 # 启发性问题 (40+ 题)
└── answers/                   # 参考答案
- 快速开始
pip install -r requirements.txt
copy .env.example .env   # 编辑填入 API Key
python main.py           # 菜单选择模式
- 使用方式
主入口 main.py
| 命令 | 说明 |
python main.py | 菜单选择 (可输入 g/i/数字) |
python main.py --guided | 演示模式: 运行全部 |
python main.py --guided 1 3 | 演示模式: 运行 Demo 01, 03 |
python main.py --interactive 1 | 交互模式: Demo 01 自由提问 |
python main.py --interactive 3 | 交互模式: Demo 03 RAG 问答 |
单独运行 Demo
python demos/demo_01_basics.py   # 启动后选择 [1]演示 或 [2]交互
python demos/demo_03_rag.py      # 交互模式可自由提问知识库
每个 Demo 的交互功能
| Demo | 交互模式功能 | 命令 |
| 01 基础 | 自由提问 / 角色扮演 / 翻译 | /qa``/role``/trans |
| 02 Chains | 翻译链 / 笑话+冷知识 / 摘要 / 词汇解释 / 字数统计 | /trans``/joke``/summary``/explain``/count |
| 03 RAG | 基于知识库的问答,显示检索来源 | /sources |
| 04 Agents | 自由向 Agent 提问,观察工具调用过程 | /trace``/tools |
| 05 Memory | 多轮对话,会话切换/查看历史/清除 | /switch``/history``/clear``/sessions |
统一退出命令: /quit
- Demo 说明
| Demo | 主题 | 涉及概念 | |
code-snippet__js 01 基础 | ChatOpenAI, ChatPromptTemplate, StrOutputParser, CommaSeparatedListOutputParser, LCEL | ||
| 02 | Chains | RunnableParallel, RunnablePassthrough, RunnableLambda, itemgetter, 管道 ` | ` |
| 03 | RAG | TextLoader, RecursiveCharacterTextSplitter, Embeddings, Chroma, 检索链 | |
| 04 | Agents | @tool 装饰器, create_react_agent, ReAct 循环, 多工具协同 | |
| 05 | Memory | RunnableWithMessageHistory, InMemoryChatMessageHistory, 多会话隔离 |
-
学习路径
先阅读 docs/overview.md 了解整体架构 运行每个 Demo 的演示模式,观察输出 进入交互模式,动手实验 阅读对应的 docs/0X_xxx.md 理解知识点 思考 docs/questions/ 中的启发性问题 对照 docs/answers/ 中的参考答案检查理解 -
知识点
1. Chat Model (模型调用)
from
config
import
get_llm
llm = get_llm(temperature=
0.7
)
response = llm.invoke(
"用一句话介绍 Python"
)
LangChain 的 ChatOpenAI 封装了 OpenAI 兼容的 Chat Completion API。invoke() 是 LangChain 的标准调用接口,所有 Runnable 对象都支持。temperature 控制输出的随机性: 0=确定性, 1=高随机性。
2. ChatPromptTemplate (提示词模板)
template = ChatPromptTemplate.from_messages([
(
"system"
,
"你是一位{role},请用{style}的风格回答问题。"
),
(
"human"
,
"{question}"
)
])
prompt_value = template.invoke({
"role"
:
"专家"
,
"style"
:
"简洁"
,
"question"
:
"..."
})
Prompt 模板将变量与模板分离,使得同一结构可复用。消息列表支持 system / human / ai 三种角色。
3. OutputParser (输出解析器)
from
langchain_core.output_parsers
import
StrOutputParser, CommaSeparatedListOutputParser
parser = CommaSeparatedListOutputParser()
chain = template | llm | parser
result = chain.invoke({...})
# 返回 list 而非 str
OutputParser 将模型的原始文本输出转换为结构化数据。常用的还有: JsonOutputParser, PydanticOutputParser, StructuredOutputParser。
4. LCEL 管道 (|)
chain = prompt | llm | parser
| 是 LangChain Expression Language 的管道操作符,将 Runnable 串联为一个 DAG (有向无环图)。
设计要点
- get_llm() 自动根据 LLM_PROVIDER 环境变量选择 OpenAI 或 DeepSeek
- 所有 Demo 在 __main__ 开头调用 check_api_key() 进行前置校验
- print_config() 打印当前使用的后端和模型名称
- Demo 02 – Chains: LCEL 链式编排
目标
掌握 LCEL 的核心 Runnable 类型及其组合方式。
涉及文件
- demo_02_chains.py
知识点
1. RunnableParallel – 并行执行
python
parallel_chain = RunnableParallel(joke=joke_chain, fact=fact_chain)
result = parallel_chain.invoke({"topic": "编程"})
# result: {"joke": "...", "fact": "..."}
多个子链共享同一输入,并行执行 (实际并行度取决于后端)。
输出是一个字典,key 为分支名。
2. RunnablePassthrough – 透传增强
python
chain = RunnablePassthrough.assign(
summary=prompt | llm | StrOutputParser()
)
result = chain.invoke({"text": "...", "style": "一句话"})
# result: {"text": "...", "style": "一句话", "summary": "新生成的字段"}
.assign() 在原字典基础上追加新字段,不修改原有字段。
非常适合 “输入 + LLM处理结果” 的模式。
3. itemgetter – 字段提取
python
chain = (
{"word": itemgetter("word"), "target_lang": itemgetter("target_lang")}
| prompt | llm | StrOutputParser()
)
result = chain.invoke({"word": "ML", "target_lang": "中文", "extra": "ignored"})
itemgetter 从输入字典中提取指定字段,忽略多余的键。
等价于 RunnableLambda(lambda d: {“word”: d[“word”]})。来自 Python 标准库 operator。
4. RunnableLambda – 自定义逻辑
python
chain = RunnableLambda(word_count) | RunnableLambda(format_output)
将任意 Python 函数包装为 Runnable,融入 LCEL 管道中。
适合处理数据转换、格式化等轻量逻辑。
设计要点
- LCEL 的核心理念是 “一切皆 Runnable”,通过 | 自由组合
- 数据在管道中流动的形式始终是 dict
- RunnablePassthrough.assign() 是构建复杂链最常用的模式之一
- Demo 03 – RAG: 检索增强生成
目标
完整走通 RAG 的全流程,理解每个环节的作用与实现。
涉及文件
- demo_03_rag.py
- data/langchain_intro.txt
- data/python_tips.txt
知识点
RAG 全流程
文档 (txt)
-> [TextLoader] 加载
-> [RecursiveCharacterTextSplitter] 切分为 chunk
-> [OpenAIEmbeddings] 向量化
-> [Chroma] 存储到向量数据库
-> [Retriever] 查询时检索 Top-K
-> [Prompt + LLM] 增强生成
1. Document Loader – 文档加载
python
from langchain_community.document_loaders import DirectoryLoader, TextLoader
loader = DirectoryLoader("./data", glob="*.txt", loader_cls=TextLoader)
docs = loader.load() # 返回 List[Document]
LangChain 内置 100+ 种 Loader,支持 PDF、网页、数据库等。这里用最简单的 TextLoader。
2. Text Splitter – 文本切分
-
python
from langchain_text_splitters import RecursiveCharacterTextSplitter
splitter = RecursiveCharacterTextSplitter(
chunk_size=300, chunk_overlap=50,
separators=["\n\n", "\n", "。", " ", ""]
)
splits = splitter.split_documents(docs)
chunk_size=300: 每个文本块最多 300 字符
-
chunk_overlap=50: 相邻块重叠 50 字符,避免语义断裂
-
separators: 按优先级尝试分割符
3. Embeddings – 向量化
python
embeddings = get_embeddings() # text-embedding-3-small
将文本转换为固定维度的浮点向量 (1536 维),
语义相近的文本在向量空间中距离更近。
4. Vector Store – 向量存储
python
from langchain_chroma import Chroma
vectorstore = Chroma.from_documents(
documents=splits, embedding=embeddings,
persist_directory="./chroma_rag_demo"
)
Chroma 是轻量级的开源向量数据库,支持本地持久化。
首次运行时创建向量库,后续可从磁盘加载。
5. Retrieval Chain – 检索链
python
retriever = vectorstore.as_retriever(search_kwargs={"k": 3})
rag_chain = (
{"context": retriever | format_docs, "question": RunnablePassthrough()}
| prompt | llm | StrOutputParser()
)
retriever 根据查询返回最相关的 k 个文档片段,
作为上下文注入 Prompt,让 LLM 基于真实内容回答。
设计要点
- build_vectorstore() 封装了 Load -> Split -> Embed -> Store 全流程
- format_docs() 将检索到的文档片段拼接为 LLM 可读的文本格式
- 向量存储支持持久化,避免每次运行都重新向量化
- Demo 04 – Agents: 智能体与工具调用
目标
理解 Agent 的工作原理: LLM 如何自主决策、调用工具、完成复杂任务。
涉及文件
- demo_04_agents.py
知识点
1. Tool 的定义
python
from langchain_core.tools import tool
@tool
def calculator(expression: str) -> str:
# 执行数学计算。输入如 '2 + 3 * 4'。
...
@tool
def word_length(word: str) -> str:
# 返回一个词的字符数。
...
@tool 装饰器将普通函数注册为 LangChain Tool。
函数的 docstring 非常重要 – Agent 靠它来判断何时使用哪个工具。
2. ReAct Agent
python
from langgraph.prebuilt import create_react_agent
agent = create_react_agent(model=llm, tools=tools)
result = agent.invoke({"messages": [("user", "计算 (3+5)*7")]})
LangGraph 的 create_react_agent 实现了 ReAct (Reasoning + Acting) 模式:
用户提问 -> LLM 推理 -> 决定调用工具 -> 工具执行 -> 观察结果 -> LLM 再推理 -> ... -> 最终回答
3. result[“messages”] 的结构
python
result = agent.invoke({"messages": [("user", q)]})
# result["messages"] 包含完整轨迹:
# [HumanMessage, AIMessage(tool_calls=[...]), ToolMessage(...), AIMessage(content="最终回答")]
最后一条 AIMessage 的 content 是最终答案。
中间的 ToolMessage 记录了每次工具调用的输入和输出。
4. 多工具协同
Agent 可以连续调用多个工具来完成一个任务:
Q: "把 'Hello World' 反转,然后告诉我反转后的字符串有多长"
-> Agent 调用 reverse_string("Hello World") -> "dlroW olleH"
-> Agent 调用 word_length("dlroW olleH") -> 11
-> 最终回答: "反转后是 dlroW olleH,共 11 个字符"
设计要点
- Tool 的 docstring 决定了 Agent 能否正确选择工具,必须描述清楚功能和参数
- Agent 不保证一定调用工具 – 如果 LLM 认为可以直接回答,会跳过工具调用
- 使用安全的 eval 命名空间 (空 __builtins__) 防止代码注入
- Demo 05 – Memory: 对话记忆管理
目标
理解如何在多轮对话中保持上下文,以及多会话隔离的实现方式。
涉及文件
-
demo_05_memory.py
知识点
1. RunnableWithMessageHistory
python
from langchain_core.runnables.history import RunnableWithMessageHistory
chain_with_history = RunnableWithMessageHistory(
chain,
get_session_history, # 历史记录获取函数
input_messages_key="input", # 新输入的 key
history_messages_key="history", # 历史消息的 key
)
RunnableWithMessageHistory 是一个包装器,它:
- 调用前: 从 get_session_history(session_id) 加载历史
- 注入 Prompt: 将历史消息填入 MessagesPlaceholder
- 调用后: 将本次对话追加到历史中
2. ChatMessageHistory
python
from langchain_core.chat_history import InMemoryChatMessageHistory
store = {}
def get_session_history(session_id: str):
if session_id not in store:
store[session_id] = InMemoryChatMessageHistory()
return store[session_id]
InMemoryChatMessageHistory 在内存中存储消息列表。
生产环境可替换为 RedisChatMessageHistory 或数据库持久化。
3. MessagesPlaceholder
python
from langchain_core.prompts import MessagesPlaceholder
prompt = ChatPromptTemplate.from_messages([
("system", "你是一个友好的助手。"),
MessagesPlaceholder(variable_name="history"), # 历史消息插入点
("human", "{input}"),
])
MessagesPlaceholder 在 Prompt 中预留一个位置,运行时由 RunnableWithMessageHistory
自动填入历史消息列表。
4. 多会话隔离
python
# 会话 A
chain.invoke({"input": "我叫 Alice"}, config={"configurable": {"session_id": "session_a"}})
# 会话 B (完全独立的上下文)
chain.invoke({"input": "我叫 Bob"}, config={"configurable": {"session_id": "session_b"}})
# 回到会话 A -- 记得 Alice
chain.invoke({"input": "还记得我叫什么吗?"}, config={"configurable": {"session_id": "session_a"}})
通过 session_id 区分不同用户的对话,历史互不干扰。
configurable 字典是 LangChain 传递运行时配置的标准方式。
设计要点
- get_session_history 使用惰性创建,首次访问时才创建历史对象
- store 字典在模块级别,生产环境应使用 Redis/数据库
- HumanMessage vs AIMessage 可用于区分对话角色
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
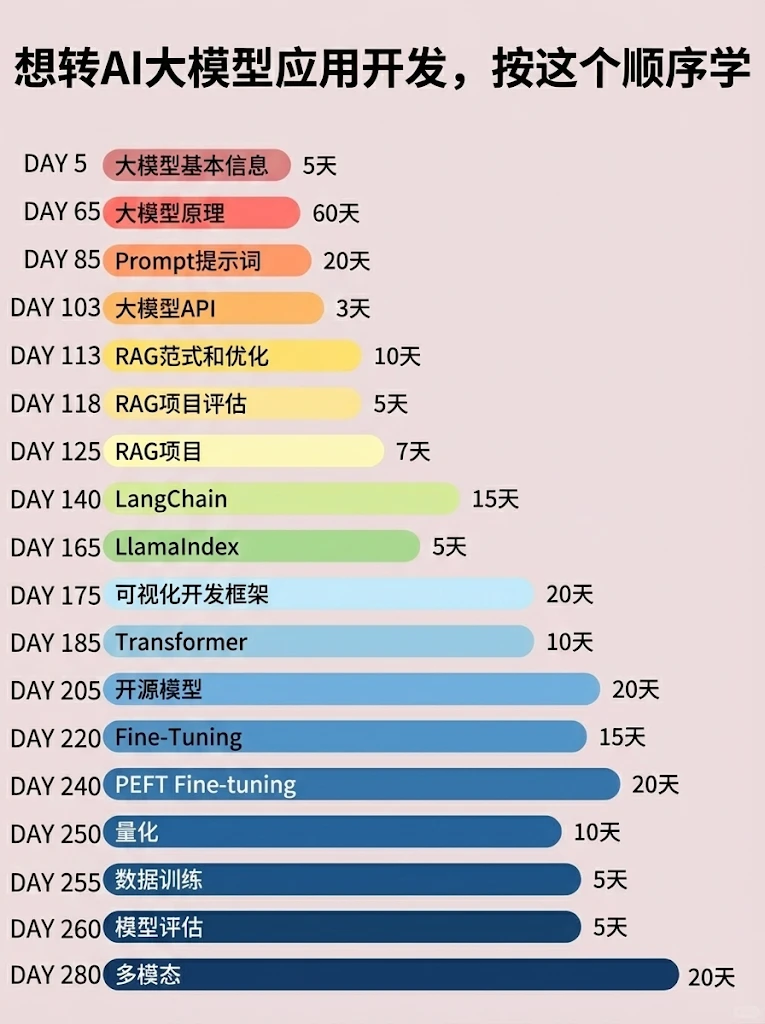
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 3
 0
- 0


 已为社区贡献236条内容

所有评论(0)