从通用图灵机视角解析基于Transformer的大模型
概述
近年来,基于Transformer架构的大语言模型(Large Language Model,LLM)在自然语言处理及通用人工智能领域取得了突破性进展,各类模型迭代更新、性能持续提升,但现有研究大多聚焦于模型结构改良、训练数据优化、参数规模扩增等应用层面,较少从底层基础理论视角对LLM的运行逻辑进行解析。基于此,个人想能不能从从图灵机第一性原理出发,重新解析Transformer大模型核心机制,从通用计算的底层逻辑出发,形成对LLM全新的认知与理解。同时,复盘现有LLM的架构短板与计算局限,探索可能的模型结构,状态更新优化方向与思路。于是便写了这篇文章,也方便以后查阅。
通用图灵机
形式化地,一台通用图灵机可由元组 M = ( Q , Σ , b , q 0 , T , f ) M = (Q, \Sigma, b, q_0, T, f) M=(Q,Σ,b,q0,T,f) 构成:其中 Q Q Q 为有限状态集, Σ \Sigma Σ 为有限纸带符号集, b ∈ Σ b \in \Sigma b∈Σ 为空白符号, q 0 ∈ Q q_0 \in Q q0∈Q 为初始状态; T ⊆ Q × Σ T \subseteq Q\times\Sigma T⊆Q×Σ 为停机(状态–符号)元组集合;转移映射 f : Q × Σ → Σ × { − 1 , + 1 } × Q f : Q\times\Sigma \to \Sigma\times\{-1, +1\}\times Q f:Q×Σ→Σ×{−1,+1}×Q 为有限转移规则集,用于规定机器在每个计算周期的执行操作。
这里假定纸带为双向无界,存储单元可由整数 i ∈ Z i\in\mathbb{Z} i∈Z 索引;记 i 0 ∈ Z i_0\in\mathbb{Z} i0∈Z 为纸带读写头的初始位置。
图灵机的运行过程定义如下:纸带存储空间初始仅存放有限个非空白符号,其余单元均为空白;机器从初始状态 q 0 q_0 q0 启动,读写头置于初始位置 i 0 i_0 i0。在每个计算周期开始时,读写头位于某位置 i ∈ Z i\in\mathbb{Z} i∈Z,机器处于状态 q ∈ Q q\in Q q∈Q,读写头下方读取符号 σ ∈ Σ \sigma\in\Sigma σ∈Σ。由当前状态 q q q 和读取的符号 σ \sigma σ确定转移更新规则: f ( q , σ ) ↦ ( σ ′ , m , q ′ ) f (q, \sigma) \mapsto (\sigma', m, q') f(q,σ)↦(σ′,m,q′),即在当前单元 i i i 写入符号 σ ′ \sigma' σ′,机器状态更新为 q ′ q' q′;若 m = − 1 m=-1 m=−1,读写头左移一格至 i ′ = i − 1 i'=i-1 i′=i−1;若 m = + 1 m=+1 m=+1,则右移一格至 i ′ = i + 1 i'=i+1 i′=i+1。
重复上述计算周期,图灵机可能进入两种计算情形:1. 进入停机集合 ( q , σ ) ∈ T (q,\sigma)\in T (q,σ)∈T 时停机 2. 永不停机。直接使用通用图灵机比较抽象,下面我们以 U 15 , 2 U_{15,2} U15,2 一个具体的图灵机更近一步说明通用图灵机的原理。
精简通用图灵机( U 15 , 2 U_{15,2} U15,2)
香农(Shannon, 1956)率先开展了一项研究:从状态数量与纸带符号数量两个维度,探寻规模最小的通用图灵机。目前,通用图灵机在状态数、符号数的已知上界与下界之间仍存在理论空隙(仍未收紧闭合),但学界已陆续构造出结构愈发精简的通用图灵机。
本文使用的也是这类极简机器之一: U 15 , 2 U_{15,2} U15,2,它仅使用15 个状态、2 个纸带符号(出自 Neary 与 Woods 2009 年研究成果[3])。 U 15 , 2 U_{15,2} U15,2是一台 15 状态、2 符号的标准通用图灵机(standard UTM),属于 “状态–符号权衡” 下的一个极小通用机器。该图灵机在目前已知的最小通用图灵机中,具备帕累托(Pareto)最优特性 [2]。图灵机 U 15 , 2 U_{15,2} U15,2 可由五元组 ( Q , Σ , b , q 0 , T , f ) (Q,\Sigma,b,q_0,T,f) (Q,Σ,b,q0,T,f) 形式化的定义:
– 状态集:
Q
=
{
A
,
B
,
C
,
D
,
E
,
F
,
G
,
H
,
I
,
J
,
K
,
L
,
M
,
N
,
O
}
Q=\{A,B,C,D,E,F,G,H,I,J,K,L,M,N,O\}
Q={A,B,C,D,E,F,G,H,I,J,K,L,M,N,O}
– 纸带符号集:
Σ
=
{
0
,
1
}
\Sigma=\{0,1\}
Σ={0,1}
– 空白符:
b
=
0
b=0
b=0
– 初始状态:
q
0
=
A
q_0=A
q0=A
– 停机终止集:
T
=
{
(
J
,
1
)
}
T=\{(J,1)\}
T={(J,1)}
– 状态转移函数:
f
(
q
,
σ
)
f(q, \sigma)
f(q,σ) (由下表定义)
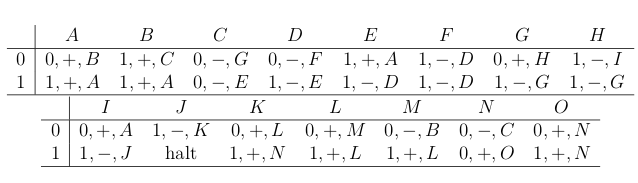
通用图灵机 U 15 , 2 U_{15,2} U15,2 的状态转移表:最左列(即只有0,1)为从纸带当前格子上读入符号;表中每一项 ( σ ′ , m , q ′ ) (\sigma',m,q') (σ′,m,q′) 分别为:在纸带当前格子上写入符号 σ ′ \sigma' σ′、读写头移动方向 m m m 与 下一状态 q ′ q' q′ 。其中 m ∈ { − 1 , + 1 } m \in \{−1,+1\} m∈{−1,+1},即左移与右移; 写入符号 σ ′ ∈ Σ = { 0 , 1 } \sigma' \in \Sigma=\{0,1\} σ′∈Σ={0,1};状态 q ′ ∈ Q q'\in Q q′∈Q
解释1:如上图,状态 A A A 对应的列,
如果读入符号为
0
0
0,则
(
σ
′
,
m
,
q
′
)
=
{
0
,
+
,
B
}
(\sigma',m,q') = \{0,+,B\}
(σ′,m,q′)={0,+,B},即在纸带当前格上写入 0,向右移动一格,状态转移到 B
如果读入符号为
1
1
1,则
(
σ
′
,
m
,
q
′
)
=
{
1
,
+
,
A
}
(\sigma',m,q') = \{1,+,A\}
(σ′,m,q′)={1,+,A},即在纸带当前格上写入 1,向右移动一格,状态转移到 A
解释2:这里的输入符号序列(先写在纸带格子上),如 1010111 1010111 1010111 可理解为程序,该图灵机运行时会按照程序输入与状态转移规则不断产生输出,除非达到停机状态。
解释3:需要注意的是这里的状态集是指机器的内部状态集,而非外部环境状态(如:纸带的状态、格子的符号等)和强化学习(RL)中的状态是不同的。
基于Transformer的大模型
基于Transformer的大模型LLM也可由五元组 ( Q , Σ , b , q 0 , T , f ) (Q,\Sigma,b,q_0,T,f) (Q,Σ,b,q0,T,f) 形式化的定义。其中
– 状态集:
Q
=
{
s
0
,
s
1
,
s
2
,
.
.
.
,
s
k
}
Q=\{s_0,s_1,s_2,...,s_k\}
Q={s0,s1,s2,...,sk},其中
s
0
s_0
s0为模型在无任何输入token时的初始内部状态
– 符号集:
Σ
=
{
τ
0
,
τ
1
,
τ
2
,
.
.
,
τ
n
}
∪
{
τ
b
,
τ
e
o
s
}
\Sigma=\{\tau_0,\tau_1,\tau_2,..,\tau_n\} \cup \{\tau_{b},\tau_{eos}\}
Σ={τ0,τ1,τ2,..,τn}∪{τb,τeos},其中任意的
τ
i
\tau_i
τi为 token(或token对应的符号),
τ
b
\tau_{b}
τb为空白符,
τ
e
o
s
\tau_{eos}
τeos 为停止 token
– 空白符:
b
=
τ
b
b=\tau_b
b=τb
– 初始状态:
q
0
=
s
0
q_0=s_0
q0=s0
– 停机终止集:
T
=
{
(
s
i
,
τ
e
o
s
)
∣
1
≤
i
≤
k
}
T=\{(s_i,\tau_{eos}) | 1 \le i \le k\}
T={(si,τeos)∣1≤i≤k},即在任意状态如果模型输出为
τ
e
o
s
\tau_{eos}
τeos则停止
– 状态转移函数:
f
:
Q
×
Σ
→
Σ
×
{
+
1
}
×
Q
f: Q\times\Sigma \to \Sigma\times\{+1\}\times Q
f:Q×Σ→Σ×{+1}×Q , 由神经网络函数
f
f
f 作为状态转移函数,由于下一个词元预测(Next Token Prediction,NTP)的机制,(为了方便我们也给LLM配置了一个无限长的纸带)读写头只向右移动。
整体的定义与解释都比较清楚了,这里重点阐述一下如何在LLM中表示状态转移。通常来说,这里的状态是指神经网络内部暂存或隐藏的状态,而一般网络权重测试时是固定不变的,不会在参数层面影响状态(不涉及在线学习问题)。
基于 Transformer 的 LLM 若不留存中间隐藏状态,采用一次性输入、一次性输出的生成逻辑,便属于无状态 LLM。这类无状态LLM有一个问题,即是,当模型将输入转换为输出时,模型内部状态直接回到初始状态 s 0 s_0 s0,也就不能表达状态转移关系。
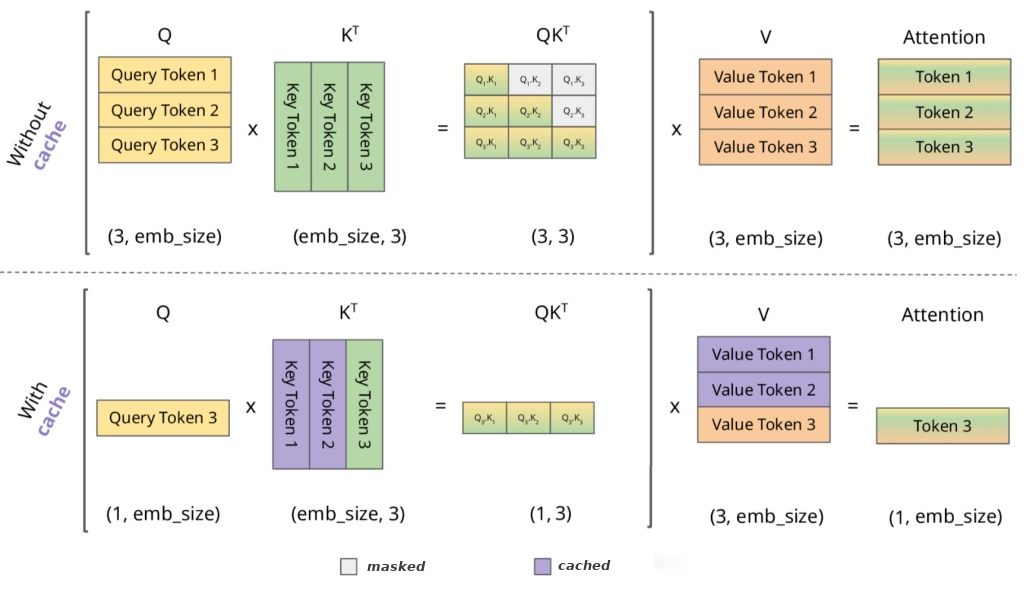
所以为了表示状态转移,需要使用KV cache这个机制作为状态,那么 s 0 s_0 s0则表示没有任何缓存的初始状态,这时任意的下一状态 s i s_i si,由上一状态 s i − 1 s_{i-1} si−1、当前输入token τ i \tau_i τi及解码算法(如:贪心搜索[Greedy Search],集束搜索[Beam Search]…)所决定,而解码算法主要以影响下一个输入token来影响状态 s i s_i si。
这里得出一个结论:基于 KV cache 机制的 LLM 是有状态 LLM。
有限状态机与状态集扩展
为什么说基于KV cache与有限上下文窗口的LLM是有限状态机?
假设:不同顺序与长度的token会产生不同的KV cache状态,即输入序列 { τ 0 , τ 1 } \{\tau_0,\tau_1\} {τ0,τ1}, { τ 1 , τ 0 } \{\tau_1,\tau_0\} {τ1,τ0}, { τ 0 , τ 1 , τ 2 } \{\tau_0,\tau_1,\tau_2\} {τ0,τ1,τ2}会产生不同的状态 s i s_i si,相同的输入序列产生相同的状态,而输入符号集的符号数量为 C ( τ ) C(\tau) C(τ),上下文窗口的长度为 L L L。
那么LLM的KV cache状态数量 C ( s ) = C ( τ ) L C(s)=C(\tau)^L C(s)=C(τ)L,即有限状态数量,因为其读写头只向右移动,所以其输出函数等价于Mealy 输出函数: λ : Q × Σ → Λ \lambda:Q×\Sigma \to \Lambda λ:Q×Σ→Λ 这里 Λ \Lambda Λ为输出符号集,可以定义 Λ ⊂ Σ \Lambda \subset \Sigma Λ⊂Σ,所以基于KV cache与有限上下文窗口的LLM是一个有限状态机,或更具体的是米利型有限状态机(Mealy 机[5-6])。更进一步,如果 L = ∞ L = \infty L=∞ 它就变为了无限状态Mealy机,但是物理硬件层面不存在无限状态Mealy机,它需要的内存是无穷大的。
假设模型单次状态转移的可计算的函数复杂度上限(Upper Bound)为 C f C_f Cf,且KV cache状态不影响 C f C_f Cf,理论上LLM随着上下文窗口长度 L L L的增长,状态集被扩展,能力的上限越高,即可计算的函数复杂度上限为 C f L C_fL CfL。但是有限状态机、即便无限状态Mealy机仍然不是图灵机,无法模拟任意递归算法。
基于KV cache的状态更新
由上图,原始Transformer或Attention的KV cache状态是增量更新(不断合并新token带来的状态):
s
t
=
s
0
∪
s
τ
0
∪
s
τ
1
.
.
.
∪
s
τ
t
s_t = s_0 \cup s_{\tau^0} \cup s_{\tau^1} ... \cup s_{\tau^{t}}
st=s0∪sτ0∪sτ1...∪sτt可以写为递归的形式
s
t
=
s
t
−
1
∪
s
τ
t
s_t = s_{t-1} \cup s_{\tau^{t}}
st=st−1∪sτt其中
s
τ
t
s_{\tau^{t}}
sτt指在
t
t
t 时刻由单个token
τ
\tau
τ带来的KV状态。增量状态更新的优势很明显,它可以在任意时刻无损的访问以前的任意状态,这对于文本定位、远距查询等是非常重要的。同时也存在缺陷,可以想象当
t
⟶
∞
t \longrightarrow \infty
t⟶∞时,
s
t
s_t
st的维度为无穷大,这时在attention中
s
o
f
t
m
a
x
softmax
softmax的作用下,新增的 token
τ
\tau
τ 必然会分走注意力分数,最后导致注意力发散。另一个问题是,训练时在设计好的状态集
Q
Q
Q下,但是当测试上下文长度超过训练时的长度时,这个状态
s
t
∉
Q
s_t\notin Q
st∈/Q,
s
t
s_t
st也不满足
Q
Q
Q集合内状态的内插(interpolation),那么在该状态下模型的状态转移行为是随机的,泛化能力变差,这也是长度泛化问题(Length Generalization)[7-8]的来源之一。
一般直接使用 s t s_t st的所有状态都存在巨大问题(如:上述提到的问题及平方增长的计算复杂度与存储等),现在的解决方法之一是稀疏注意力(Sparse Attention)[9],如:MSA 中的Memory Sparse Attention,利用TopK获得稀疏注意力;或者DeepSeekV4中的CSA(Compressed Sparse Attention),利用局部窗口KV tokens + 全局压缩KV tokens的TopK获得稀疏注意力[13-14]。
离散时间状态方程
我们也可以把上述更新方式,连同参数表示为离散时间状态方程(也可以是连续时间方程),即是控制理论中经典的,状态更新 + 系统输出,状态空间标准形式
{
s
t
+
1
=
A
⋅
s
t
+
B
⋅
x
t
y
t
=
C
⋅
s
t
+
D
⋅
x
t
\left\{\begin{matrix} s_{t+1} = A\cdot s_{t} + B\cdot x_{t} \\ y_{t} = C\cdot s_{t} + D\cdot x_{t} \end{matrix}\right.
{st+1=A⋅st+B⋅xtyt=C⋅st+D⋅xt 这里的参数或函数
A
,
B
,
C
,
D
A,B,C,D
A,B,C,D 都是可以通过Transformer中的结构与参数带来,公式中的加号可以是求并集或矩阵、标量的加法,可以将
B
⋅
x
t
B\cdot x_{t}
B⋅xt理解为
s
τ
t
s_{\tau^{t}}
sτt,即新的token带来的状态变化。这个也是RNN,尤其是Mamba等状态空间模型(SSM,State Space Model)的基础状态更新骨架。总的来说涉及到序列及状态更新基本逃不掉这套控制论的公式,所以这几类模型都是紧密联系的。在模型中如何更好的状态更新是一个重要的工作,实际上MSA、CSA都隐式的做了这部分工作。
将Mealy有限状态机扩展为图灵机
通过Transformer的LLM五元组 ( Q , Σ , b , q 0 , T , f ) (Q,\Sigma,b,q_0,T,f) (Q,Σ,b,q0,T,f) 形式化定义,可以得出该LLM唯一的缺陷是没有任意纸带内存位置的修改能力,因为它读写头只向右移动,它只能写入字符到某个启始内存开始的连续内存。
这个问题可以通过基于驾驭工程(Harness Engineering),来对任意位置纸带内存作修改,一个简单的示例如下:
# 定义无限纸带(内存)
class Tape:
    def __init__(self):
        self.tape = {}
        self.head = 0
    def left(self):  self.head -= 1
    def right(self): self.head += 1
    def read(self):  return self.tape.get(self.head, 0)
    def write(self,v): self.tape[self.head]=v
# 定义Harness 驾驭层
class Harness:
    def __init__(self): self.tape = Tape()
    def run(self, cmd, v=None):
        if   cmd=="left":  self.tape.left()
        elif cmd=="right": self.tape.right()
        elif cmd=="read":  return self.tape.read()
        elif cmd=="write": self.tape.write(v)
        return f"head={self.tape.head}, val={self.tape.read()}"
# LLM 通过Harness工程操作内存
h = Harness()
print(h.run("right"))
print(h.run("write", 10))
print(h.run("left"))
print(h.run("read"))
LLM提示词示例
你拥有4个纸带工具,只能逐指令操控纸带内存:
1. right:读写头向右移动一格
2. left:读写头向左移动一格
3. read:读取当前指针位置存储值
4. write(value):在当前指针写入数据
需要操作内存时,输出JSON工具调用格式:{"cmd":"指令名","val":"写入参数(write专用)"}
通过该harness的工具调用,使得LLM可以修改内存或存储中任意位置的符号(增、删、查、改的功能),这样我们就将 LLM 从有限状态机扩展为图灵机,也即这时的LLM是图灵完备的[1]。
这种方式其实是比较理想的模型,实际应用中我们针对的还是文件,主要还是使用文件结构化编辑协议,可以增、删、查、改任意文件任意位置的符号,该协议流程为:
1. 读取原文内容,建立文本上下文
2. LLM 生成需要修改的原文中的片段与局部唯一上下文
3. LLM 生成新片段
4. 输出 :
   <<<<< SEARCH
   生成原文片段(必须和原文完全一致)
   =====
   生成新片段
   >>>>> REPLACE
5. 通过固定程序替换,并写入原文
实际使用还有很多harness工具,总的来说通过harness,LLM是可以扩展为图灵机的(前提是LLM必须有处理这样提示词的能力),或者说我们现在使用的如: Open Code、Claude Code、Codex + LLM API的形式,已经是理论图灵完备的了。但是话说回来,图灵完备也只是AGI的必要条件之一,其实状态转移函数 f f f的学习问题才是最让人头疼的。
上下文窗口长度限制?
理论上在测试阶段是不存在上下文窗口长度限制的,因为它只需要下一个token的输入,前面的token都可以扔掉,只是在运行内存中还缓存了以前token的状态,导致内存使用扩张的问题、计算量不断增加及状态过多带来的泛化问题。
外部输入程序与内化函数集
应用克林闭包(Kleene Closure)可以通过任意的符号集合,产生任意有限长度的组合符号串(任意有限长度的程序,注:产生无限长度的符号串是图灵机不停机问题),其可以被形式化的简写为
S
=
{
a
1
a
2
⋯
a
n
∣
n
∈
N
+
,
∀
1
≤
i
≤
n
,
a
i
∈
Σ
}
S=\{a_1a_2⋯a_n \mid n\in N^+,\forall 1\le i \le n,a_i\in \Sigma\}
S={a1a2⋯an∣n∈N+,∀1≤i≤n,ai∈Σ}
假设,有一个图灵机可计算函数集合 Y X = { f ∣ f : X → Y } Y^X = \{ f \mid f: X \to Y \} YX={f∣f:X→Y},即在集合中所有的函数都是图灵机可计算函数,对于任意的函数我们都可以实现一个程序来计算它,该程序为有限长度的组合符号串 S i S_i Si,而要实现所有这样的函数集合,这样的程序 { S i ∣ i > 0 } \{S_i|i \gt 0\} {Si∣i>0} 是无限的。
还有一大类函数(尤其是连续函数)都不是图灵机可计算函数,如最简单的初等连续函数 s i n ( x ) , e x , l n ( x ) sin(x) , e^x, ln(x) sin(x),ex,ln(x)等(超越函数,由无穷级数表达),但是可以用图灵机以任意精度逼近,这类函数的集合我们可以将其定义为,图灵机可逼近函数集合 A X = { f ∣ f : X → Y } A^X = \{ f \mid f: X \to Y \} AX={f∣f:X→Y}。同理要逼近这样的所有这样的函数的集合,这样的程序 { S i ∣ i > 0 } \{S_i|i \gt 0\} {Si∣i>0} 也是无限的。
但是,对于 U 15 , 2 U_{15,2} U15,2或其他图灵机模型而言,它的状态、状态转移函数表是有限的,大量的函数计算都依赖于手工或半自动生成的外部的程序。如果我们将自然语言也理解为程序,那么 LLM 的外部输入程序或人工输入程序非常有限,即有限的提示词(Prompts)。但是它的状态集、状态转移表是非常庞大的,即它通过这样的状态集与状态转移表直接学习内化了一个的庞大的函数集。
需要补充说明:外部提示输入与模型内置函数是拓展 LLM 表征能力的两条路径,不存在孰优孰劣。多数场景下,尤其在模型初始化阶段,外部提示输入是引导模型激活目标内置函数的必要手段。但面向通用人工智能(AGI)的研发目标时,我们期望模型全部功能均源自自身内化函数,且内置函数能够自主生成等效于外部提示的输入指令。
而外部函数集合总是存在AGI暂时不能计算和逼近的函数,因此 “通用性” 并不指代 AGI 可以解决全部问题,而是模型具备通过持续迭代学习逐步攻克未知问题的能力,自主学习正是通用智能的底层元能力。
符号集扩展
如果将多模态,如:图像,音频,或其他传感器数据整合到五元组 ( Q , Σ , b , q 0 , T , f ) (Q,\Sigma,b,q_0,T,f) (Q,Σ,b,q0,T,f) 形式化定义中,这时可以将多模态的输入离散化编码为tokens便得到了扩展的符号集 Σ ′ \Sigma' Σ′,而其他四部分的形式都无需改变,同理输出离散动作(Actions)或连续动作离散化为tokens也可以直接合并到符号集合 Σ \Sigma Σ中,这个模式之一就是现在比较火的VLA(Vision‑Language‑Action 模型,是一类端到端机器人智能体模型,直接从图像 + 语言指令输出可执行动作[9-10])。
参考文献
- Memory Augmented Large Language Models are Computationally Universal
- Small universal Turing machines
- Four Small Universal Turing Machine
- Kleene Closure
- moore and mealy machines
- Mealy and Moore Machines in TOC
- Length Generalization of Causal Transformers without Position Encoding
- What Algorithms can Transformers Learn? A Study in Length Generalization
- The Role of Sparsity for Length Generalization in Transformers
- Universal Length Generalization with Turing Programs
- OpenVLA: An Open-Source Vision-Language-Action Model
- A Survey on Vision-Language-Action Models: An Action Tokenization Perspective
- MSA: Memory Sparse Attention for Efficient End-to-End Memory Model Scaling to 100M Tokens
- DeepSeek-V4:Towards Highly Efficient Million-Token Context Intelligence

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)