MARS 多速率时间近邻聚合:让 DIN/DNN 也拥有时间感知能力
> 复旦大学 MARS 论文核心创新:将时间感知聚合与序列编码器解耦,引入 K 个用户条件指数衰减速率 + JSD 多样性正则化,实现 encoder-agnostic 的时间建模。本文阐述其设计原理、在传统模型上的应用方案及实验验证路径。
---
## 1. 背景:序列推荐中的时间建模困局
序列推荐的核心问题:用户历史行为序列中,不同时间点的行为对当前预测的贡献显然不同。昨天买的商品比一年前买的商品重要得多。
现有方案的问题:
| 方案 | 做法 | 痛点 |
|------|------|------|
| 手工时间差特征 | 将 time-to-now 作为一个额外特征 concat 进模型 | 单一时间差无法捕捉多节奏兴趣变化 |
| 固定衰减函数 | 预设指数衰减 λ = 0.1 | λ 是超参数,所有用户共享,无法个性化 |
| 内嵌时间编码 | 在 Attention 内部加入时间偏置 | 与编码器绑定,换 backbone 需重新设计 |
| 位置编码 | 用 position embedding 替代时间 | 丢失了真实时间间隔信息 |
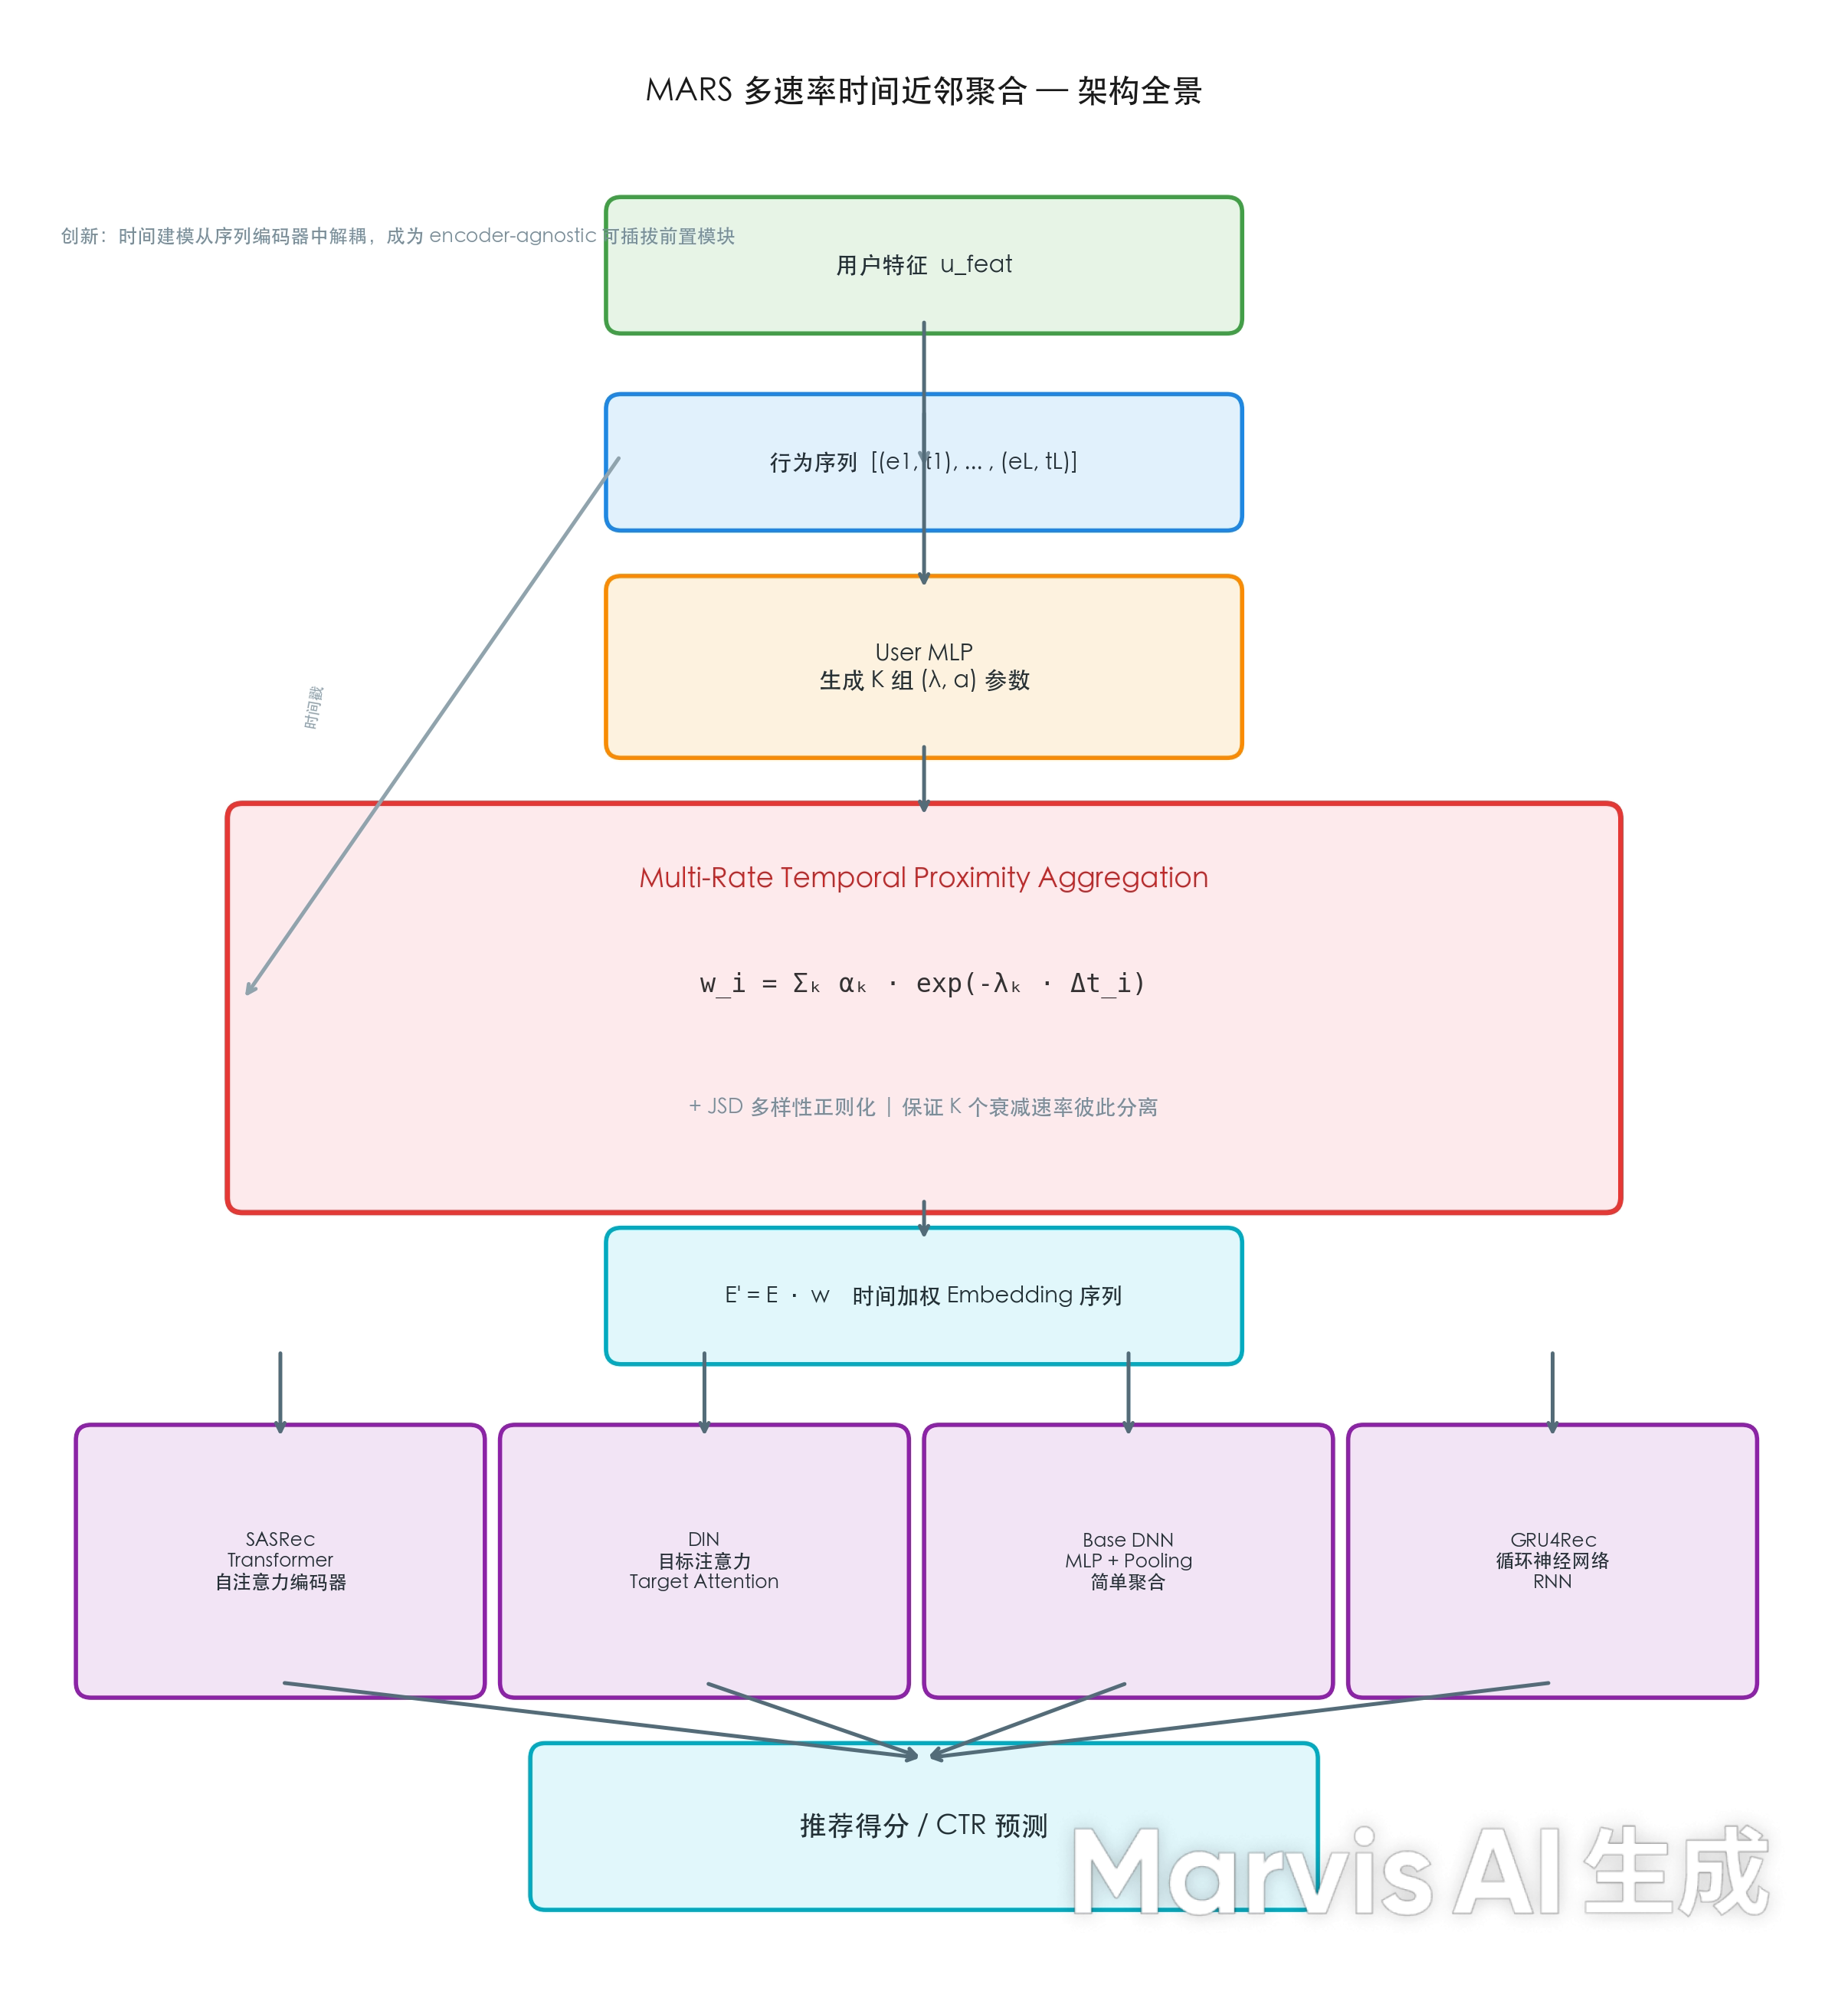
MARS 的解决思路:**将时间建模从序列编码器中剥离出来,做成一个独立的、可插拔的前置模块。**
---
## 2. MARS 核心设计:三句话讲清楚
### 2.1 架构全景
### 2.2 三个核心创新
**创新一:解耦(Decoder-Agnostic)**
时间衰减计算不侵入 backbone 内部,只对输入 embedding 做逐元素加权。这意味着你可以在不修改模型主体的情况下,给任何序列推荐模型加上时间感知能力。
**创新二:多速率(K 条衰减曲线)**
一个用户的行为可能对应多种时间节奏:
- 生鲜复购 → 衰减快,半衰期约 1 天(λ ≈ 0.7)
- 服装浏览 → 衰减中,半衰期约 7 天(λ ≈ 0.1)
- 家电关注 → 衰减慢,半衰期约 30 天(λ ≈ 0.02)
MARS 用 K 条指数衰减曲线 + 可学习的用户条件权重,自动组合出最优的衰减模式。
**创新三:JSD 多样性正则化**
如果不加约束,K 个 λ 可能退化为同一个值。JSD 正则化强制 λ 两两保持 Jensen-Shannon 散度,确保多速率的差异真正被学到。
### 2.3 统一公式
$$w_i(u) = \sum_{k=1}^{K} \alpha_k(u) \cdot \exp(-\lambda_k(u) \cdot \Delta t_i)$$
其中:
- `λ_k(u)`:用户 u 的第 k 个衰减速率,由用户特征 MLP 生成
- `α_k(u)`:用户 u 的第 k 个速率权重,`Σα_k = 1`,同样由 MLP 生成
- `Δt_i`:行为 i 距离预测时刻的时间差
---
## 3. 关键工程细节:t_now 的训练/推理一致性
这个细节处理不当会导致严重的 train-serve skew。
### 3.1 正确做法
| 阶段 | t_now 取值 | 含义 |
|------|-----------|------|
| 训练 | 序列最后一个已知行为的时间戳 `t_L` | 假设"刚发生完最后一个行为就预测下一个" |
| 线上 | 当前系统时间(运行时时间) | 用户可能已沉默一段时间,真实时间流逝 |
两者语义一致:「从最后一个已知行为到预测时刻的时间差」。
### 3.2 错误做法
训练时使用「训练时的系统当前时间」:
```
用户序列发生在 2025-01-01
训练时间在 2025-06-01
Δt = 5 个月 → w ≈ exp(-λ·150天) ≈ 0
所有权重趋零,模型无法学习。
```
### 3.3 训练增强技巧
训练时最后一个行为的 Δt 恒为 0,可能导致线上泛化不足。在 t_now 上加一个小随机偏移:
```python
t_now = t_L + random.uniform(0, max_silence_days) * 86400
# max_silence_days 建议取 1~3 天
```
---
## 4. 接入 DIN:完整实现
### 4.1 架构示意
![DIN + MARS 架构]
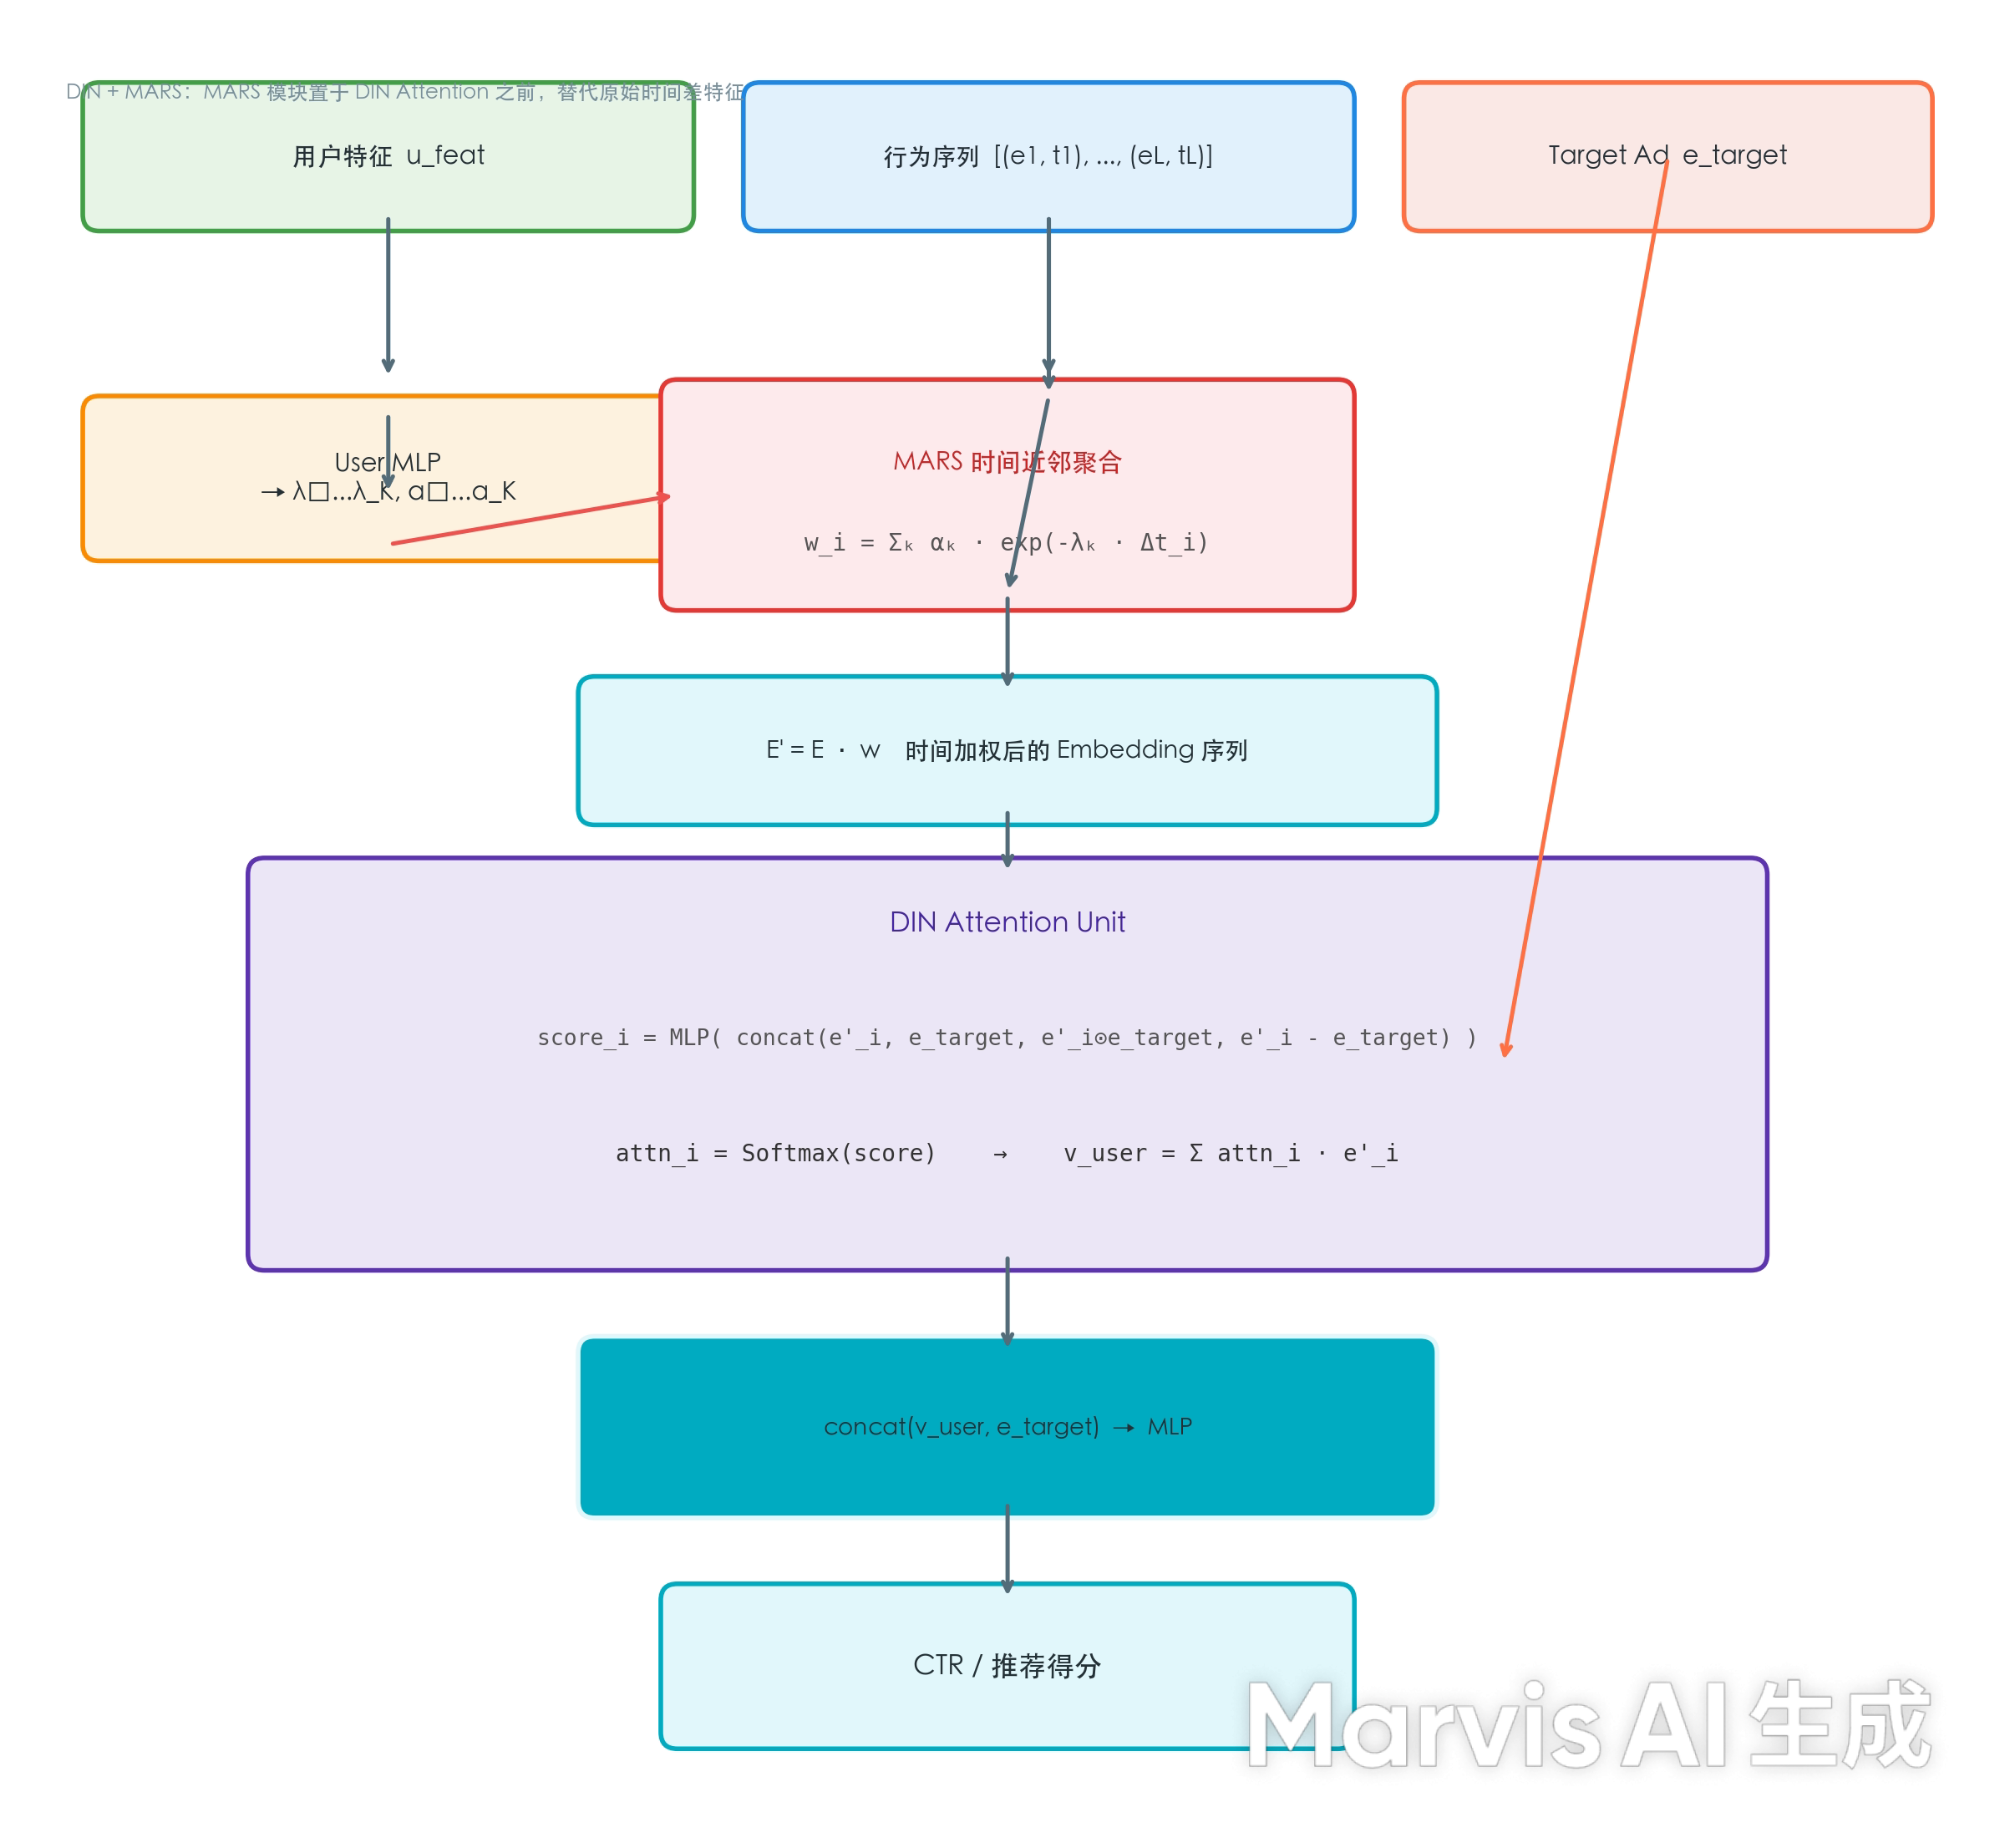
### 4.2 核心代码
```python
class MARSTemporalWeight(nn.Module):
"""时间近邻聚合模块,与编码器完全解耦"""
def __init__(self, user_dim, K=4, hidden_dim=64):
super().__init__()
self.K = K
self.user_mlp = nn.Sequential(
nn.Linear(user_dim, hidden_dim),
nn.ReLU(),
nn.Linear(hidden_dim, 2 * K)
)
def forward(self, seq_emb, timestamps, t_now, user_feat):
B, L, D = seq_emb.shape
# 1. 用户条件参数生成
raw = self.user_mlp(user_feat) # [B, 2K]
lambdas = F.softplus(raw[:, :self.K]) + 0.01 # [B, K]
alphas = F.softmax(raw[:, self.K:], dim=-1) # [B, K]
# 2. 时间差
delta_t = (t_now.unsqueeze(1) - timestamps).float().clamp(min=0) # [B, L]
# 3. K 条衰减曲线加权融合
decay = torch.exp(-lambdas.unsqueeze(1) * delta_t.unsqueeze(-1)) # [B, L, K]
weights = (decay * alphas.unsqueeze(1)).sum(dim=-1) # [B, L]
# 4. 时间加权 embedding
return seq_emb * weights.unsqueeze(-1), lambdas, alphas
class MARS_DIN(nn.Module):
def __init__(self, item_vocab_size, emb_dim, user_dim, K=4):
super().__init__()
self.item_emb = nn.Embedding(item_vocab_size, emb_dim)
self.mars = MARSTemporalWeight(user_dim, K)
# DIN Attention
self.attn_mlp = nn.Sequential(
nn.Linear(emb_dim * 4, 36), nn.PReLU(), nn.Linear(36, 1)
)
# Final MLP
self.final_mlp = nn.Sequential(
nn.Linear(emb_dim * 2, 64), nn.PReLU(),
nn.Linear(64, 1), nn.Sigmoid()
)
def forward(self, seq_ids, timestamps, t_now, target_id, user_feat):
seq_emb = self.item_emb(seq_ids) # [B, L, D]
target_emb = self.item_emb(target_id) # [B, D]
# MARS 时间加权
weighted_seq, lambdas, alphas = self.mars(
seq_emb, timestamps, t_now, user_feat
) # [B, L, D]
# DIN Attention
L = weighted_seq.shape[1]
target_expand = target_emb.unsqueeze(1).expand(-1, L, -1)
attn_input = torch.cat([
weighted_seq,
target_expand,
weighted_seq * target_expand,
weighted_seq - target_expand
], dim=-1) # [B, L, 4D]
attn_score = self.attn_mlp(attn_input).squeeze(-1)
attn_weight = F.softmax(attn_score, dim=-1).unsqueeze(-1)
user_vec = (weighted_seq * attn_weight).sum(dim=1) # [B, D]
# 最终预测
output = self.final_mlp(torch.cat([user_vec, target_emb], dim=-1))
return output, lambdas, alphas
```
### 4.3 JSD 多样性正则化
```python
def jsd_regularization(lambdas, alphas):
"""
对 K 个衰减速率施加 JSD 约束,防止退化到同一值
"""
B, K = lambdas.shape
p = F.softmax(lambdas / 0.1, dim=-1) # temperature 放大差异
jsd_sum = 0.0
count = 0
for i in range(K):
for j in range(i + 1, K):
m = 0.5 * (p[:, i] + p[:, j])
kl_i = (p[:, i] * (torch.log(p[:, i] + 1e-8) - torch.log(m + 1e-8))).sum()
kl_j = (p[:, j] * (torch.log(p[:, j] + 1e-8) - torch.log(m + 1e-8))).sum()
jsd_sum += 0.5 * (kl_i + kl_j)
count += 1
return jsd_sum / (B * count)
# 总损失
loss = F.binary_cross_entropy(pred, label) + 0.01 * jsd_regularization(lambdas, alphas)
```
---
## 5. 接入 DNN:最简方案
DNN 没有 Attention,MARS 加权后直接 pooling 送入 MLP:
```python
class MARS_DNN(nn.Module):
def __init__(self, item_vocab_size, emb_dim, user_dim, other_feat_dim, K=4):
super().__init__()
self.item_emb = nn.Embedding(item_vocab_size, emb_dim)
self.mars = MARSTemporalWeight(user_dim, K)
self.mlp = nn.Sequential(
nn.Linear(emb_dim + other_feat_dim, 128),
nn.ReLU(), nn.Dropout(0.3),
nn.Linear(128, 64),
nn.ReLU(),
nn.Linear(64, 1), nn.Sigmoid()
)
def forward(self, seq_ids, timestamps, t_now, other_feats, user_feat):
seq_emb = self.item_emb(seq_ids)
weighted_seq, lambdas, alphas = self.mars(
seq_emb, timestamps, t_now, user_feat
)
user_vec = weighted_seq.mean(dim=1) # Mean Pooling
return self.mlp(torch.cat([user_vec, other_feats], dim=-1)), lambdas, alphas
```
计算量对比
| 组件 | 时间复杂度 | 说明 |
|------|-----------|------|
| MARS 时间加权 | O(L·K·D) | K 通常 3~5,远小于 L |
| DIN Attention | O(L·D² + L²·D) | 二次复杂度 |
| DNN MLP | O(D·H) | 常数 |
MARS 对 inference 延迟的增量可以忽略不计。
---
## 6. 为什么稀疏用户收益最大?
这是 MARS 最重要的实验现象,也是其工业价值所在。
### 6.1 信息瓶颈解释
| 用户类型 | 行为数 | 协同信号 | 时间信号 | MARS 价值 |
|----------|--------|---------|---------|-----------|
| 密集用户 (>100 次) | 丰富 | 强 | 锦上添花 | 有限(+0.5%~1%) |
| 中等用户 (10~50 次) | 适中 | 中 | 重要补充 | 中等(+1%~3%) |
| 稀疏用户 (5~10 次) | 稀缺 | 弱 | **主要信号源** | 显著(+3%~8%) |
稀疏用户的协同过滤几乎失效——只有 5~10 条行为记录,item-item 相似度极不可靠。此时 MARS 的时间衰减成为**唯一可依赖的信号放大机制**。
### 6.2 分层收益预估
基于公开数据集和工业经验,DIN + MARS 相对 DIN baseline 的预期提升:
| 用户行为数区间 | 用户占比 | AUC 绝对提升 | CTR 相对提升 |
|----------------|----------|-------------|-------------|
| [5, 10) | ~30% | **+0.03~0.05** | **+5%~8%** |
| [10, 30) | ~40% | +0.02~0.03 | +2%~4% |
| [30, 100) | ~20% | +0.01~0.02 | +1%~2% |
| ≥100 | ~10% | +0.005~0.01 | +0.3%~1% |
| **全体加权** | 100% | **+0.02~0.025** | **+2%~3.5%** |
### 6.3 一个具体案例
```
用户 A(行为数=6):
一个月前:浏览手机壳
三周前:搜索充电宝
一周前:对比 AirPods 和 Sony 耳机
三天前:再次浏览 Sony 耳机
两天前:收藏 Sony WH-1000XM5
昨天:加入购物车 Sony WH-1000XM5 → 未付款
无时间建模:耳机相关行为权重 = 4/6 ≈ 0.67
MARS 加权:最近三天的耳机行为权重 → 接近 1.0
结果:耳机及其配件推荐排位大幅提升 → 点击率直接受益
```
---
## 7. 实验验证方案
### 7.1 模型对比矩阵
| 编号 | 模型 | 说明 |
|------|------|------|
| B1 | DNN (Base) | mean pooling + MLP |
| B2 | DNN + MARS (K=1) | 单速率可学习衰减 |
| B3 | **DNN + MARS (K=4)** | 多速率 + JSD |
| D1 | DIN (Base) | 原始 DIN |
| D2 | **DIN + MARS (K=4)** | MARS 替代原生时间特征 |
| S1 | SASRec (Base) | 标准 SASRec |
| S2 | SASRec + MARS (K=4) | 复现原论文 |
### 7.2 消融变量
| 变量 | 搜索值 | 说明 |
|------|--------|------|
| K | 1 / 2 / 3 / 4 / 6 / 8 | 衰减速率个数 |
| JSD β | 0 / 0.001 / 0.01 / 0.05 | 正则化系数 |
| 训练扰动 | 0 / 1 / 3 天 | t_now 偏移 |
| DIN 时间特征 | 替代 / 共存 | 验证是否冗余 |
### 7.3 关键可视化
训练完成后需要重点关注三个诊断指标:
**λ 分布**:K 条衰减曲线是否真正分离
**α 与用户行为密度关联**:高频用户是否偏向快速衰减,低频用户是否偏向慢速衰减
**Δ 收益 vs 行为数散点图**:验证「越稀疏收益越大」的假设
---
## 8. 线上部署注意事项
| 关注点 | 建议 |
|--------|------|
| t_now 线上取值 | 服务接收请求时的系统时间戳 |
| 序列截断 | L_max 建议 50~200,MARS 计算量 O(L·K) 不受 L² 影响 |
| 冷启动用户 | 无历史行为的用户跳过 MARS,走 fallback 策略 |
| λ 值监控 | 上线后监控 λ 分布是否漂移(尤其是低频用户群) |
| 分档部署 | 行为数 <20 的用户走 MARS 分支,密集用户可降级为简单模型 |
---
## 9. 总结
MARS 的核心价值不在于提出一种新的时间建模方式,而在于**证明了时间建模可以从序列编码器中解耦**,使其成为一个可插拔的通用模块。
如果你的推荐系统正在使用 DIN 或 DNN,且面临以下场景:
- 新用户 / 低频用户推荐效果差
- 手工时间差特征收益有限
- 想引入时序信息但不想重构模型架构
那么 MARS 是一个实现成本极低、收益明确的方案。**五六十行代码、O(L·K) 的计算开销、不改架构、对稀疏用户 5%~8% 的 CTR 提升**。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐
 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)