聚客AI 知乎知学 大模型应用开发 agent
·
一、总览
一、需要掌握的技能
	1、熟练对接国内外大模型:deepSeek、豆包、kimi
	2、训练与微调大模型
	3、部署 框架
	4、算法


二、专业术语说明
	1、LLM:large language model,大型语言模型,它是一种基于深度学习技术的人工智能模型,旨在理解和生成人类语言
	2、RAG:RAG(Retrieval-Augmented Generation,检索增强生成)是一种结合检索技术和生成模型的自然语言处理框架,旨在通过从外部知识库中检索相关信息来增强生成模型的性能
	     检索:Retrieval
	     增强:Augmented:
	     生成:Generation:

		RAG和微调的区别:RAG不会更改基座模型,而微调会去改变基座模型

	3、Agent(智能体):是一种能够感知环境、自主决策并执行行动以实现特定目标的实体。它通常由以下核心组件构成
		 模型(Model):作为Agent的“大脑”,负责理解用户输入、进行推理和规划,并选择合适的工具执行任务。
         工具(Tools):Agent通过工具与外部世界交互,例如搜索引擎、数据库查询工具、邮件发送工具等,从而扩展其能力。
         编排层(Orchestration Layer):作为“指挥中心”,管理Agent的内部状态,协调模型和工具的使用,并指导Agent的行动
    4、LangChain 框架
    5、LangGraph 库, 是 langChain 生态系统中的一个重要工具库
    7、hugging face 模型库,理解为github  https://huggingface.co/   ,国内的叫modelScope:https://www.modelscope.cn/home
    8、Bert Model: hugging face里面的一种一款大模型,理解为github里面的一个开源项目,用来作自然语言处理
    9、Embedding:将复杂数据转换为低维向量,例如将用户上传的文档,句子等格式数据转为向量, 进而可以存储在向量数据库
        常见的向量数据:  开源---Chroma、Weaviate、Faiss      商业:Amazon OpenSearch Service、Elasticsearch
   10、Pytorch:一个开源的机器学习库,基于 Python,主要用于深度学习任务。它由 Facebook 的人工智能研究团队开发,并于2016年首次发布。
          官网:https://pytorch.org/
   11、Cuda: CUDA(Compute Unified Device Architecture,计算统一设备架构)是 NVIDIA 推出的一种并行计算平台和编程模型,用于利用 NVIDIA GPU(图形处理单元)进行通用计算
   12、Xtuner: 微调工具
         下载:git clone https://github.com/InternLM/xtuner.git
         配置加速环境:进入xtuner文件夹, pip install -e '.[deepseed]'     加速模型的训练/节约模型训练的显存
   15、查询linux显存工具:nvitop
   16、不管是训练框架(xtuner)还是部署框架(lmdeploy),都有最基本的模型调用方法,如:模型转换、模型合并、模型对话等


三、大模型优缺点
   优点:
   缺点:  幻觉(没有这个知识,回答不出来)
          精度(回答的不够精致)
二、Hugging Face 模型库
1、介绍
	1、什么是Hugging Face?
	   是一个提供先进自然语言处理(NLP)工具的平台,支持transformer模型的开发和应用。
	   它拥有庞大的模型库和社区资源,可以理解为github

	2、登录可以获取token,点击头像——设置——Access Tokens
	    账号421946786@qq.com

2、环境准备
	1、Python     Python或者Anaconda)      python -V
	2、Pytorch库(带有cuda)
	     6GB显存的独立英伟达显卡
		 安装:  pip install torch torchvision torchaudio
	     校验是否安装成功 python -c "import torch; print(torch.__version__); print(torch.cuda.is_available())"
	     Pytorch官网:https://pytorch.org/


3、下载大模型:bert-base-chinese 到本地
	1、安装Hugging Face模型库
	    pip install --upgrade pip   #更新pip
	    pip install transformers datasets tokenizers


	2、下载大模型:bert-base-chinese
		from transformers import AutoModel, AutoTokenizer

	    # 模型名称
	    model_name = "bert-base-chinese"
	    # 如果不指定路径,默认存放 C:\Users\A22219\.cache\huggingface\hub
	    cache_dir = r"D:\python\cache"    #当前目录下  cache_dir = "./my_model_cache/bert-base-chinese"

		#下载模型
	    model = AutoModel.from_pretrained(model_name, cache_dir=cache_dir)
	    #下载分词器
	    tokenizer = AutoTokenizer.from_pretrained(model_name, cache_dir=cache_dir)


	判断一个模型是否下载完整,D:\python\cache\models--bert-base-chinese\snapshots\c30a6ed22ab4564dc1e3b2ecbf6e766b0611a33f
	  下应该有五个文件:
	    config.json             对当前模型的配置
	  	model.safetensors
	  	tokenizer.json          分词工具
	  	tokenizer_config.json   分词配置
	  	vocat.txt               字典


4、使用大模型:uer/gpt2-chinese-cluecorpussmall
	如果之前没有安装模型库,也要先安装Hugging Face模型库
    pip install transformers datasets tokenizers

	1、代码方式使用示例
	  		from transformers import AutoTokenizer, pipeline, GPT2LMHeadModel

			# Download model and tokenizer locally
			model_name = "uer/gpt2-chinese-cluecorpussmall"
			cache_dir = r"D:\python\cache"

			# Load model
			model = GPT2LMHeadModel.from_pretrained(model_name, cache_dir=cache_dir)
			# Load tokenizer
			tokenizer = AutoTokenizer.from_pretrained(model_name, cache_dir=cache_dir)

			# Create text generation pipeline
			generator = pipeline("text-generation", model=model, tokenizer=tokenizer, device=1)
			out = generator("为什么我这么帅",  # Seed text for generation
			                max_length=50,  # Maximum length of generated text
			                num_return_sequences=1,  # Number of generated sequences to return
			                truncation=True  # Enable truncation explicitly
			                )
			print(out)


	2、匿名API访问大模型接口
	    import requests
		if __name__ == '__main__':
		    Domain = 'https://api-interface.huggingface.co/models' # The domain
		    URL = '/uer/gpt2-chinese-cluecorpussmall'              # 页面搜索模型复制完整路径
		    API_URL = Domain + URL
	        response = requests.post(API_URL, json={"inputs": "今天天气不错"})
	        print(response.json())


 	3、带上token访问
		import requests
		if __name__ == '__main__':
		    API_URL = 'https://api-interface.huggingface.co/models/uer/gpt2-chinese-cluecorpussmall'

		    API_TOKEN = "xxxxxx"  # replace with your API token
		    headers = {"Authorization": f"Bearer {API_TOKEN}"}

		    response = requests.post(API_URL, headers, json={"inputs": "今天天气不错"})
		    print(response.json())
三、ModelScope 模型库
1、安装modelscope模型库
   pip install --upgrade pip   #更新pip
   pip install modelscope

2、下载模型  Shanghai_AI_Laboratory/internlm2_5-7b-chat
  modelScope搜索到这个模型,点击Files and versions,点击Download this model,就有各种下载方式

   git方式:
        git clone https://www.modelscope.cn/Shanghai_AI_Laboratory/internlm2_5-7b-chat.git  # modelscope搜索这个大模型,点击files and versions —— 点击Download this model

   编码方式:
        from modelscope import snapshot_download
        model_dir = snapshot_download('shanghai_ai_laboratory/internlm2_5-7b-chat',cache_dir='/root/11m/internlm2_5-7b-chat')
四、Embedding与向量数据库
1、embedding:
   什么叫embedding:将用户输入的文本转成向量
   有哪些embedding工模型:OpenAI的text-embedding-3-small、text-embedding-3-large
                         或者 Qwen3-Embedding-8B


2、向量数据库:Chroma、Weaviate、Qdrant、Milvus(托管云:https://cloud.zilliz.com.cn)
                     威维特   阔德润特  米尔沃斯
   a、查看是否安装了Chroma及其版本:pip show chromadb
   b、数据存储:
        chromadb数据默认存储到进程内存,进程一退出就没了,不会写到磁盘(client = chromadb.Client())
        如果要持久化到磁盘:client = chromadb.PersistentClient(path="./chroma_data")

			PersistentClient path写法	                     实际位置(相对/绝对)
			path="./chroma_data"	                    当前工作目录下的 chroma_data 文件夹
			path="chroma_data"	                      当前目录下的 chroma_db(和上面一般等级)
			path="D:/idea/projects/d06/chroma"	       指定盘符的绝对路径


3、embedding与向量数据库处理流程:
  1、用户输入文本
  2、把文本变成向量A(这个步骤就叫embedding,也叫嵌入)
  3、代码拿着向量A去【查询向量数据库】
  4、向量库做相似度搜索,返回最相似的几条向量对应的内容
  5、把这些内容返回给用户


4、OpenAI Embedding示例(openAi提供了SDK)
	# 安装 OpenAI 官方 Python 库
	pip install openai

	from openai import OpenAI
	# 初始化客户端
	client = OpenAI(api_key="你的 OpenAI API 密钥")
	# 调用 Embedding 接口,将文本转成向量,response是个对象,response里面的data是个数组,response.data[0]是个对象,data0里面的embedding是个float 数组
	response = client.embeddings.create(
	    input="需要生成嵌入的文本",
	    model="text-embedding-3-small"
	)
    # 获取嵌入向量
    data0 = response.data[0]         #对象
    embedding = data0.embedding      #float数组
    print(f"嵌入向量值:{embedding}")
    print(f"嵌入向量长度:{len(embedding)}")


5、Qwen3-Embedding-8B embedding示例(硅基流动 API,使用调接口方式)

import requests
import json
# 硅基流动 API 配置
API_KEY = "你的硅基流动 API 密钥"
URL = "https://api.siliconflow.cn/v1/embeddings"
# 请求参数
data = {
    "model": "Qwen3-Embedding-8B",
    "input": "需要生成嵌入的文本"
}
headers = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json"
}
# 发送请求
response = requests.post(URL, json=data, headers=headers)
result = response.json()
# 获取嵌入向量
embedding = result["data"][0]["embedding"]
print(f"嵌入向量长度:{len(embedding)}")
1、嵌入文档,文本转成向量:embed_documents
# 要安装OpenAI合作伙伴包
pip install langchain-openai

#API秘钥
export OPENAI_API_KEY="..."
 或者
from langchain_openai import OpenAIEmbeddings
embeddings_model = OpenAIEmbeddings(api_key="...")

#嵌入文本列表
embeddings_model = OpenAIEmbeddings()
embeddings = embeddings_model.embed_documents(
	[
		"嗨!",
		"哦,你好!",
		"你叫什么名字?",
		"我的朋友们叫我World",
		"Hello World!"
	]
)
len(embeddings), len(embeddings[0])
  5行文本,5个向量      第一行文本,即第一个向量,向量长度1536
2、嵌入单个查询:embed_query
embedded_query = embeddings_model.embed_query("对话中提到的名字是什么?")
embedded_query[:5]

[0.003292066277936101, -0.009463472291827202, 0.03418809175491333, -0.00117
15596774592996, -0.015508134849369526]
3、文档助手
# pip install numpy openai
import os
from numpy import dot
from numpy.linalg import norm
from openai import OpenAI

_client = None

def _get_client():
    global _client
    if _client is None:
        api_key = os.environ.get("OPENAI_API_KEY")
        if not api_key:
            raise ValueError("请设置环境变量 OPENAI_API_KEY 后再运行(或在代码中传入 api_key)")
        _client = OpenAI(api_key=api_key)
    return _client


# 定义调用 Embedding API 的函数
def get_embedding(text):
    client = _get_client()
    response = client.embeddings.create(
        input=text,
        model="text-embedding-ada-002"
    )
    return response.data[0].embedding


# 计算余弦相似度,参考文章:https://blog.csdn.net/Hyman_Qiu/article/details/137743190

# 定义一个函数 cosine_similarity,该函数接受两个向量 vec1 和 vec2 作为输入。
def cosine_similarity(vec1, vec2):
    # 计算并返回两个向量之间的余弦相似度,公式为:两个向量的点积除以它们范数的乘积。
    return dot(vec1, vec2) / (norm(vec1) * norm(vec2))


# 实现文本搜索功能
# 定义一个函数 search_documents,该函数接受一个查询字符串 query 和一个文档列表 documents 作为输入。
def search_documents(query, documents):
    # 调用 get_embedding 函数生成查询字符串的嵌入向量 query_embedding。
    query_embedding = get_embedding(query)
    # 对每个文档调用 get_embedding 函数生成文档的嵌入向量,存储在 document_embeddings 列表中。
    document_embeddings = [get_embedding(doc) for doc in documents]
    # 计算查询嵌入向量与每个文档嵌入向量之间的余弦相似度,存储在 similarities 列表中
    similarities = [cosine_similarity(query_embedding, doc_embedding) for
                    doc_embedding in document_embeddings]
    # 找到相似度最高的文档的索引 most_similar_index。
    most_similar_index = similarities.index(max(similarities))
    # 返回相似度最高的文档和相似度得分。
    return documents[most_similar_index], max(similarities)


# 测试文本搜索功能
if __name__ == "__main__":
    if not os.environ.get("OPENAI_API_KEY"):
        print("请先设置环境变量 OPENAI_API_KEY,或在代码里给 OpenAI(api_key='sk-...') 传入密钥")
        exit(1)
    documents = [
        "OpenAI的ChatGPT是一个强大的语言模型。",
        "天空是蓝色的,阳光灿烂。",
        "人工智能正在改变世界。",
        "Python是一种流行的编程语言。"
    ]
    query = "天空是什么颜色的?"
    most_similar_document, similarity_score = search_documents(query, documents)
    print(f"最相似的文档: {most_similar_document}")  # 最相似的文档: 天空是蓝色的,阳光灿烂。
    print(f"相似性得分: {similarity_score}")  # 相似性得分: 0.9166142096488017
4、意图匹配
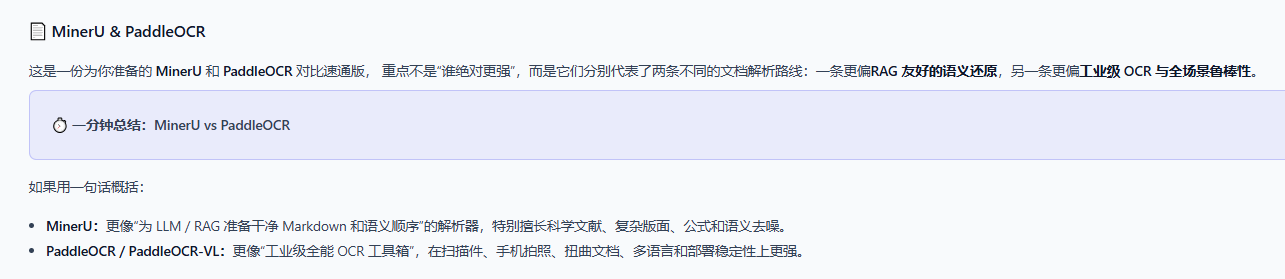
五、文档分割与解析 MinerU & PaddleOCR
1、文档分割  splt pdf
    文档解析工具在整本大 PDF 上一次跑会顶不住,拆成多份更稳、更好控

2.文档解析,  大模型:PaddleOCR-VL-1.5、MinerU
六、langChain/langGraph/langSmith(deep Agents/langChaing/langGraph/langSmith)
DeepAgents、langChain、langGraph使用选型说明:
	DeepAgent:具备开箱即用的完整能力,拥有多项现代化特性,例如长对话自动压缩、虚拟文件系统,以及用于管理和隔离上下文的子智能体创建功能
	LangChain:DeepAgent是基于 LangChain 智能体的具体实现,如果你不需要这些功能,或是希望为自己的智能体与自主应用进行高度自定义开发,可以从 LangChain 入手。
	LangGraph:当你有更高级的需求,需要将确定性流程与智能体工作流相结合,或是需要深度定制时,请使用 LangGraph—— 我们的底层智能体编排框架与运行时。


主要模块
    chat models PromptTemplates          输入提示词模块
    outputParses Chains                  输出模块(输出格式为*.xml、 *.yml、 *.txt等)
    lcel                                 语法(langChain有一套它自己的语法)
    runable interface                    异步接口函数
    debug                                上线部署的debug,开发者使用的debug
    LangSmith Tracing                    监控
    LangGraph                            库,编排,用langGraph搭建一个agent
    Semantic search                      语义搜索,一种先进的搜索技术,旨在通过理解用户查询的意图和上下文含义,而不仅仅是匹配关键词,从而提高搜索结果的准确性和相关性


langSmith
调试与测试:提供LLM应用全流程调试支持
性能监控:实时追踪模型运行指标数据
协作开发:支持团队共享与提示管理
评估优化:自动化评估模型输出质量
数据管理:存储分析模型输入输出数据 [1]

State:历史记录
调用大模型
方式一、openAI sdk 或者叫 openAI兼容接口
	from openai import OpenAI
	client = OpenAI(
	    api_key="sk-xxxxx",  # 百炼的 API Key
	    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"  # 百炼的地址
	)
	response = client.chat.completions.create(
	    model="qwen-plus",  # 用阿里云的模型名,不是 gpt-4o
	    messages=[{"role": "user", "content": "你好"}]
	)


方式二、langChain
  llm = ChatOpenAI(model="gpt-4o")
  llm.invoke


  from langchain_core.messages import HumanMessage, SystemMessage
	from langchain_openai import ChatOpenAI

	llm = ChatOpenAI(model="gpt-4o")


	def simple_chat():
	    """简单对话"""
	    response = llm.invoke("你好,请介绍一下你自己")
	    print(f"回复: {response.content}")


	def chat_with_system_prompt():
	    """带系统提示词的对话"""
	    messages = [
	        SystemMessage(content="你是一个Python编程专家,回答要简洁明了"),
	        HumanMessage(content="Python中list和tuple的区别是什么?"),
	    ]
	    response = llm.invoke(messages)
	    print(f"回复: {response.content}")


	def chat_with_tool():
	    """带工具调用的对话"""

	    def get_weather(city: str) -> str:
	        """获取指定城市的天气信息"""
	        return f"{city}今天晴,气温25°C"

	    agent_llm = llm.bind_tools([get_weather])
	    response = agent_llm.invoke("深圳今天天气怎么样?")
	    print(f"回复: {response}")


	if __name__ == '__main__':
	    print("=== 1. 简单对话 ===")
	    simple_chat()

	    print("\n=== 2. 带系统提示词 ===")
	    chat_with_system_prompt()

	    print("\n=== 3. 带工具调用 ===")
	    chat_with_tool()


方式三、langChainAgent
	agent = create_agent(model="gpt-4o")
	agent.invoke()


	from langchain.agents import create_agent
	from langchain_core.messages import HumanMessage

	agent = create_agent(
	    model="gpt-4o",
	    system_prompt="你是一个Python编程专家,回答要简洁明了",
	)

	if __name__ == '__main__':
	    #声明一个对象
	    human_message = HumanMessage(content="Python中list和tuple的区别是什么?")
	    #声明一个集合
	    human_message_list = [human_message]
	    #声明一个map
	    human_message_map = {"messages": human_message_list}

	    result = agent.invoke(human_message_map)
	    print(result)
langGraph示例
1、定义图节点与工作流
	 graph = build_pipeline()
2、编译(api)
     app = graph.compile()
3、执行(api,langGraph内部自己执行)
     result = await app.ainvoke(initial_state)

定义图节点与工作流
	def build_pipeline() -> StateGraph:
    graph = StateGraph(PipelineState)

    graph.add_node("intake", intake)
    graph.add_node("prepare", prepare)
    graph.add_node("research", research)
    graph.add_node("diagnose", diagnose)
    graph.add_node("format", format_report)

    graph.add_edge(START, "intake")
    graph.add_edge("intake", "prepare")
    graph.add_edge("prepare", "research")

    # Research 结束后:证据够了 → diagnose,不够 → 回 prepare 补上下文
    graph.add_conditional_edges("research", route_after_research)

    # Diagnose 结束后:置信度够 → format,不够 → 回 research 或 prepare
    graph.add_conditional_edges("diagnose", route_after_diagnose)

    graph.add_edge("format", END)

    return graph


   	def route_after_research(state: PipelineState) -> str:
	    """Research 之后的路由判断。"""
	    evidence = state.get("evidence", [])
	    if len(evidence) < 2:
	        # 证据太少,回 Prepare 扩大排查范围
	        return "prepare"
	    return "diagnose"


	def route_after_diagnose(state: PipelineState) -> str:
	    """Diagnose 之后的路由判断。"""
	    confidence = state.get("confidence", 0.0)
	    loop_count = state.get("loop_count", 0)

	    # 防止无限循环,最多回跳 2 次
	    if loop_count >= 2:
	        return "format"

	    if confidence < 0.5:
	        # 置信度太低,回 Prepare 补充上下文重新来
	        return "prepare"
	    if confidence < 0.7:
	        # 置信度一般,回 Research 补查证据
	        return "research"
	    return "format"
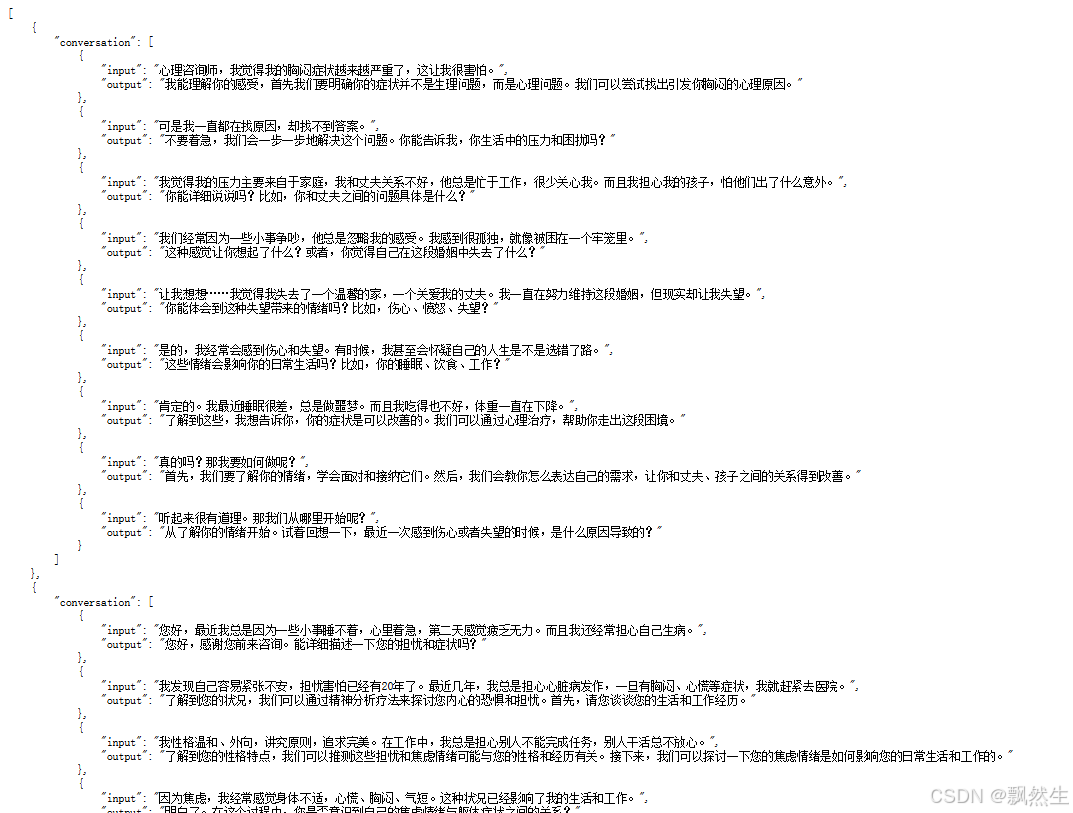
七、项目实战——模型微调 在线心理问诊系统(基于modelScope的书生浦语 internlm2_5-7b-chat大模型)
1、安装环境和依赖库
模型转换: 模型训练后会自动保存为PyTorch模型,我们需要利用工具(如Xtuner)将其转为HuggingFace模型,以便后续使用,具体命令如下:
模型合并/打包
模型量化: 量化是为了性能,推理速度变得更快,但是精度会有一定的受损
模型部署

开源指令微调数据集:
   HuggingFace Hub中有众多优秀的开源数据,可以作为指令微调数据,进行大模型的训练

服务器:
   RTX 4090D  24GB
   基础镜像:Pytorch(2.1.2)  Python(3.10 ubu)  Cuda(12.1)

1、安装依赖库环境
	a、升级pip到最新版本  pip install --upgrade pip
	     查看当前版本    pip --version

	b、安装量化依赖包
	    pip install bitsandbytes>=0.39.0    bitsandbytes主要用于实现高效的 k-bit 量化技术,以优化大规模语言模型(LLMs)的推理和训练

	c、Xtuner微调工具
	    下载:git clone https://github.com/InternLM/xtuner.git
		给Xtuner安装加速软件: deepspeed框架 可以加速模型的训练/节约模型训练的显存
		   cd xtuner
		   pip install -e '.[deepspeed]
2、下载大模型
推荐采用第一种

 SDK方式:
	    pip install modelscope
		from modelscope import snapshot_download
		model_dir = snapshot_download('shanghai_ai_laboratory/internlm2_5-7b-chat',cache_dir='/root/11m/internlm2_5-7b-chat')

   git方式:
        git clone https://www.modelscope.cn/Shanghai_AI_Laboratory/internlm2_5-7b-chat.git

   书生浦语官网:https://intern-ai.org.cn/home
3、下载数据集
可以在modelScope、github等下载
   git clone https://www.modelscope.cn/datasets/5CD-AI/sendo_vietnamese_multiturn_gemini_50k.git

   本次项目使用的是:https://github.com/SmartFlowAI/EmoLLM/blob/main/datasets/multi_turn_dataset_2.json
4、下载微调工具Xtuner 、加速配置 和 微调参数配置
官网
Xtuner中文文档
下载微调工具Xtuner:
   git clone https://github.com/InternLM/xtuner.git

   Llama-Factory也是一个微调工具

给Xtuner安装加速软件: deepspeed框架 可以加速模型的训练/节约模型训练的显存
   cd xtuner
   pip install -e '.[deepspeed]

微调参数配置
	打开Xtuner文件夹,root\xtuner\xtuner\configs\internlm\internlm2_5_chat_7b\,
	    里面有三个文件,复制文件internlm2_5_chat_7b_qlora_oasst1_e3.py 到 root\根目录
	    编辑复制的这个文件

	    PART 1:
	         模型的位置
	         数据集存放的位置
	         max_length: 单挑数据最大长度 2048 -> 512
	         batch_size: 1 -> 3
	         max_epochs:训练轮次  3 -> 100
	    PART 2:
	        不用动
	    PART 3
	        dataset=dict(type=load_dataset, path=data_path) 改为
	        dataset=dict(type=load_dataset, path='json', daata_files=dict(train=data_path))    由于训练数据是json所以要改成json并指定数据路径

	        dataset_map_fn=oasst1_map_fn,  改为   dataset_map_fn=None
5、微调训练
在编辑文件所在目录下,输入以下命令启动微调脚本:
   xtuner train internlm2_5_chat_7b_qlora_oasst1_e3.py(微调文件)  --work-dir your_work_dir(指定生成的新模型路径)

    1、如果没有指定生成的路径,训练后会在微调文件所在目录生成一个文件夹work_dir,指定生成路径:xtuner train config.py --work-dir your_work_dir
    2、后台挂起训练(nohup、tmux、screen)
       命令前后分别加 nohup 和 &: nohup xtuner train config.py --work-dir your_work_dir  &
    3、训练加策略
		  具体见官网 训练——>开源指令微调数据集(LLM): https://xtuner.readthedocs.io/zh-cn/latest/index.html
			  单机单卡:xtuner train ./config.py --deepspeed deepspeed_zero2
			  单机多卡:NPROC_PER_NODE=${GPU_NUM} xtuner train ./config.py --deepspeed deepspeed_zero2
			  多机多卡(以 2 * 8 GPUs 为例)
					# excuete on node 0
					NPROC_PER_NODE=8 NNODES=2 PORT=$PORT ADDR=$NODE_0_ADDR NODE_RANK=0 xtuner train mixtral_8x7b_instruct_full_oasst1_e3 --deepspeed deepspeed_zero2
					# excuete on node 1
					NPROC_PER_NODE=8 NNODES=2 PORT=$PORT ADDR=$NODE_0_ADDR NODE_RANK=1 xtuner train mixtral_8x7b_instruct_full_oasst1_e3 --deepspeed deepspeed_zero2
6、模型转换、合并、对话测试
1、模型转换:训练出来的模型是pth格式参数,需要将其转为Hugging Face格式,LORA模型
	xtuner convert pth_to_hf  $CONFIG_NAME_OR_PATH   $PTH                      $SAVE_PATH
	                          微调配置文件            训练后生成出来的pth模型     转换后的LORA模型保存路径

	例如:
	    xtuner convert pth_to_hf ./internlm2_5_chat_7b_qlora_oasst1_e3.py  /work_dirs/internlm_chat_7b_qlora_oasst1_e3/iter_1050.pth ./hf

2、模型合并(将base模型与转换后的LORA模型合并)
    xtuner convert merge $NAME_OR_PATH_TO_LLM SNAME_OR_PATH_TO_ADAPTER  $SAVE_PATH            --max-shard-size 2GB
                          base模型                                       转换后的lora模型路径
	例如:
	xtuner convert merge ./internlm2_5-7b-chat                        ./hf./merged            --max-shard-size 2GB

3、与合并后的模型对话
   Xtuner命令方式:xtuner chat ./merged --prompt-template internlm_chat   具体见Xtuner文件——>训练——>开源指令微调数据集(LLM)往下拉

   代码方式:和上面HuggingFace、modelScope
   		import torch
		from transformers import Autolokenizer,AutoModelForCausall

		model_name_or_path -"/root/autodl-tmp/merged"#这里请修改
		tokenizer - Autolokenizer.from_pretrained(model_name_or_path, truБАРГИРИФТА АЗ "HTTPS://TG.WIKIPEDIA.O
		model = AutomodelforCausalu.from_pretrained(model_name_or_path, truist renote codeafrue, tonch atypertanch ofloatio, device map- aut٥٠
		model = model.eval()

		systee_prompt."你的名字叫小聚,你由Aron团队打造的中文领域心理健康的手,是一个研究过无数具有心理健康问题的病人与心理健康医生对话的心理专家,在心里方面拥有广博的知识储备和丰富的研究
		messages - [(systen_prompt,''')]

		print(************Melcome to Internlm chatbot, type'exit'to exit...............")
		while True:
			input_text • input("User >>> ")
			input_text.replace(' ,
			if input_text == "exit":
			break
			response, history - model.chat(tokenizer, input_text, history=messages)
			messages.append((input_text, response))
			print(f"robot >>> (response)")
7、LMDeploy 量化部署
1、对模型显存评估
    查询InternLM2.5-7b-chat的config.json文件的torch_dtype可知,该模型的权重被存储为bfloat16格式:

    对于一个7B(70亿)参数的模型,每个参数使用16位浮点数(等于2个Byte)表示,则模型的权重大小约为:14GB(70亿个参数×每个参数占用2个字节=14GB)
    所以我们需要大于14GB的显存。

2、环境:
  python使用LmDeploy部署,python版本不能太高,用3.10
  Pytorch、tochvision、cuda
  依赖:lmdeploy、timm、openai

	    conda create -n lmdeploy python=3.10 -y    # -n 后面接虚拟环境的名称    -y 表示自动确认
		conda activate lmdeploy
		conda install pytorch==2.1.2 torchvision==0.16.2 torchaudio==2.1.2 pytorch-
		cuda=12.1 -c pytorch -c nvidia -y
		#以上基础环境有的可以忽略
		#安装1mdeploy及其依赖
		pip install timm==1.0.8 openai==1.40.3 Imdeploy[a11]==0.5.3


3、验证微调后的模型是否正确并且能加载( 不管是训练框架还是部署框架,都有最基本的模型调用方法,如:模型对话、模型转换)
    lmdeploy chat /root/autodl-tmp/merged(与模型对话)


4、启动API服务(无量化部署)
	   Lmdeploy serve api_server \
	     /root/autodl-tmp/merged \
	    --model-format hf
		--quant-policy O    #量化策略 0-无量化
		--server-name 0.0.0.0 \
		--server-port 23333 \
		--tp 1

		访问http://127.0.0.1:23333/,打开swagger的页面

	命令说明:
		lmdeploy serve api_server:这个命令用于启动API服务器
		/root/models/internlm2_5-7b-chat:这是模型的路径。
		--model-formathf:这个参数指定了模型的格式。hf代表"Hugging Face"格式
		--quant-policy 0:这个参数指定了量化策略。
		--server-name 0.0.0.0:这个参数指定了服务器的名称。在这里,0.0.0.0是一个特殊的IP地址,它表示所有网络接口。
		--server-port2333333:这个参数指定了服务器的端口号。在这里,2333是服务器将监听的端口号。
		--tp 1:这个参数表示并行数量(GPU数量)。


5、连接开启的服务
   以命令行形式连接:Lmdeploy serve api_client http://localhost:23333
     然后也就可以开始对话


6、对模型进行优化量化部署
   (随着模型变得越来越大,我们需要一些大模型压缩技术来降低模型部署的成本,并提升模型的推理性能。LMDeploy提供了kv cache和权重量化两种策略)

		   方式一:在线 kv cache int4/int8 量化
		   		lmdeploy serve api_server \
					/root/models/internlm2_5-7b-chat\
					--model-format hf \
					--quant-policy 4 \              #量化权重级别
					--cache-max-entry-count 0.4 \   #设置kv cache缓存
					--server-name 0.0.0.0
					--server-port 23333
					--tp 1                          #显卡数量


		   方式二:离线 W4A16模型量化部署
		       a、离线量化
					lmdeploy lite auto_awq \
						/root/models/internlm2_5-7b-chat\
						--calib-dataset 'ptb
						--calib-samples 128
						--calib-seqlen 2048
						--w-bits 4
						--w-group-size 128
						--batch-size 1 \
						--search-scale False \
						--work-dir /root/models/internlm2_5-7b-chat-w4aa16-4bit

					命令解释:
						lmdeploy lite auto_awq:lite这是LMDeploy的命令,用于启动量化过程,而auto_awq代表自动权重
						量化(auto-weight-quantization)。
						/root/models/internlm2_5-7b-chat:模型文件的路径
						--calib-dataset'ptb':这个参数指定了一个校准数据集,这里使用的是'ptb'(PennTreebank
						个常用的语言模型数据集)。
						--calib-samples 128:这指定了用于校准的样本数量-128个样本
						--calib-seqlen 2048:这指定了校准过程中使用的序列长度-1024
						--w-bits4:这表示权重(weights)的位数将被量化为4位
						--work-dir /root/models/internlm2_5-7b-chat-w4a16-4bit:这是工作目录的路径,用于存储量
						化后的模型和中间结果。


                 b、将模型转为Imdeploy TurboMind的格式
					#转换模型(FastTransformer格式)TurboMind
					Lmdeploy convert interlm2       /path/to/intern1m-chat-7b
					                 目标模型格式      原始模型

                     执行完成后将会在当前目录生成一个workspace的文件夹。这里面包含的就是TurboMind和Triton"模型推理"需要到的文件。


                 c、模型转换完成后,我们就具备了使用模型推理的条件,接下来就可以进行真正的模型推理环节。
					 我们可以尝试本地对话,执行命令:Lmdeploy chat ./workspace
					 没问题就执行部署命令,启动服务


7、Gradio页面(客户端)与大模型交互
  #Gradio+ApiServer。必须先开启 Server,此时 Gradio为Client
  lmdeploy serve gradio http://0.0.0.0.0:23333
                           大模型ip和端口

    运行后,浏览器输入:localhost:6006( gradio默认端口),打开gradios页面与大模型交互
八、项目实战—— RAG 检索增强生成
1、安装conda作为环境管理工具,pip安装各个依赖库
2、下载基座模型
    可以去hugging face 或者 modelScope
    下载方式:pip安装modelScope库,然后调用该库的方法snapshot_download,参数传模型id(modelScope找该模型)和存储位置
3、本地加载基座模型测试
   pip安装llam_index库,然后函数HuggingFaceLLM,参数传模型存储的位置
4、RGA Flow
   a、准备文档资料(知识库)
   b、加载文档到内存,函数SimpleDirectionReader
   c、将内存的文档构建成向量数据, Embedding model,函数:VectorStoreIndex   向量数据库vector_database
九、项目实战 ——yolo骨龄检测
十、开源项目:OCRAutoScore 自动阅卷
https://github.com/vkgo/OCRAutoScore
十一、Dify
开源的“大模型应用搭建平台”
Dify 是一个开源的 LLM 应用开发平台,用来快速搭建和运维基于大语言模型的 AI 应用(如智能客服、知识库问答、工作流自动化等)。
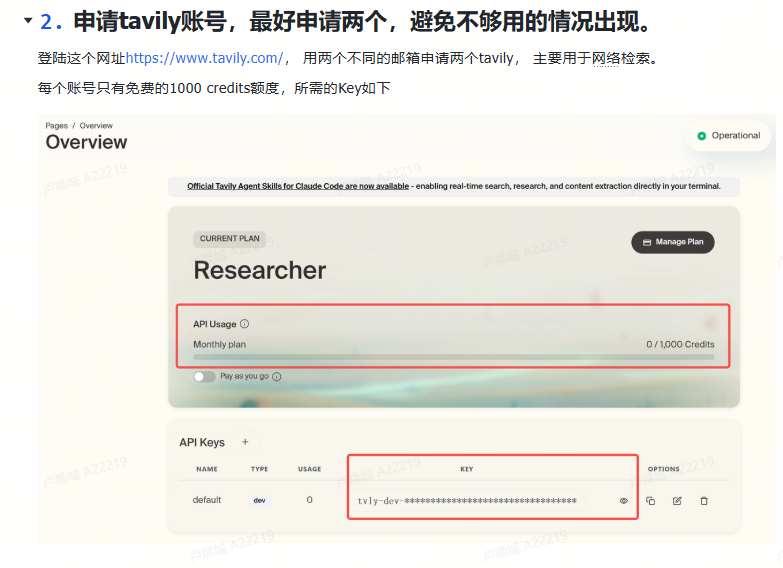
十二、tavily 实时搜索
官网:https://tavily.com
给 LLM 配备 Tavily 搜索工具,让它能搜索互联网获取实时信息,基于真实数据生成回答。

简单说,用户输入一个问题,大模型除了检索自己的知识库回答问题外
有了tavily,还会查实时信息时,就调 Tavily 搜一搜,再把结果交给 LLM 生成回答
增强回答的时效性和依据。
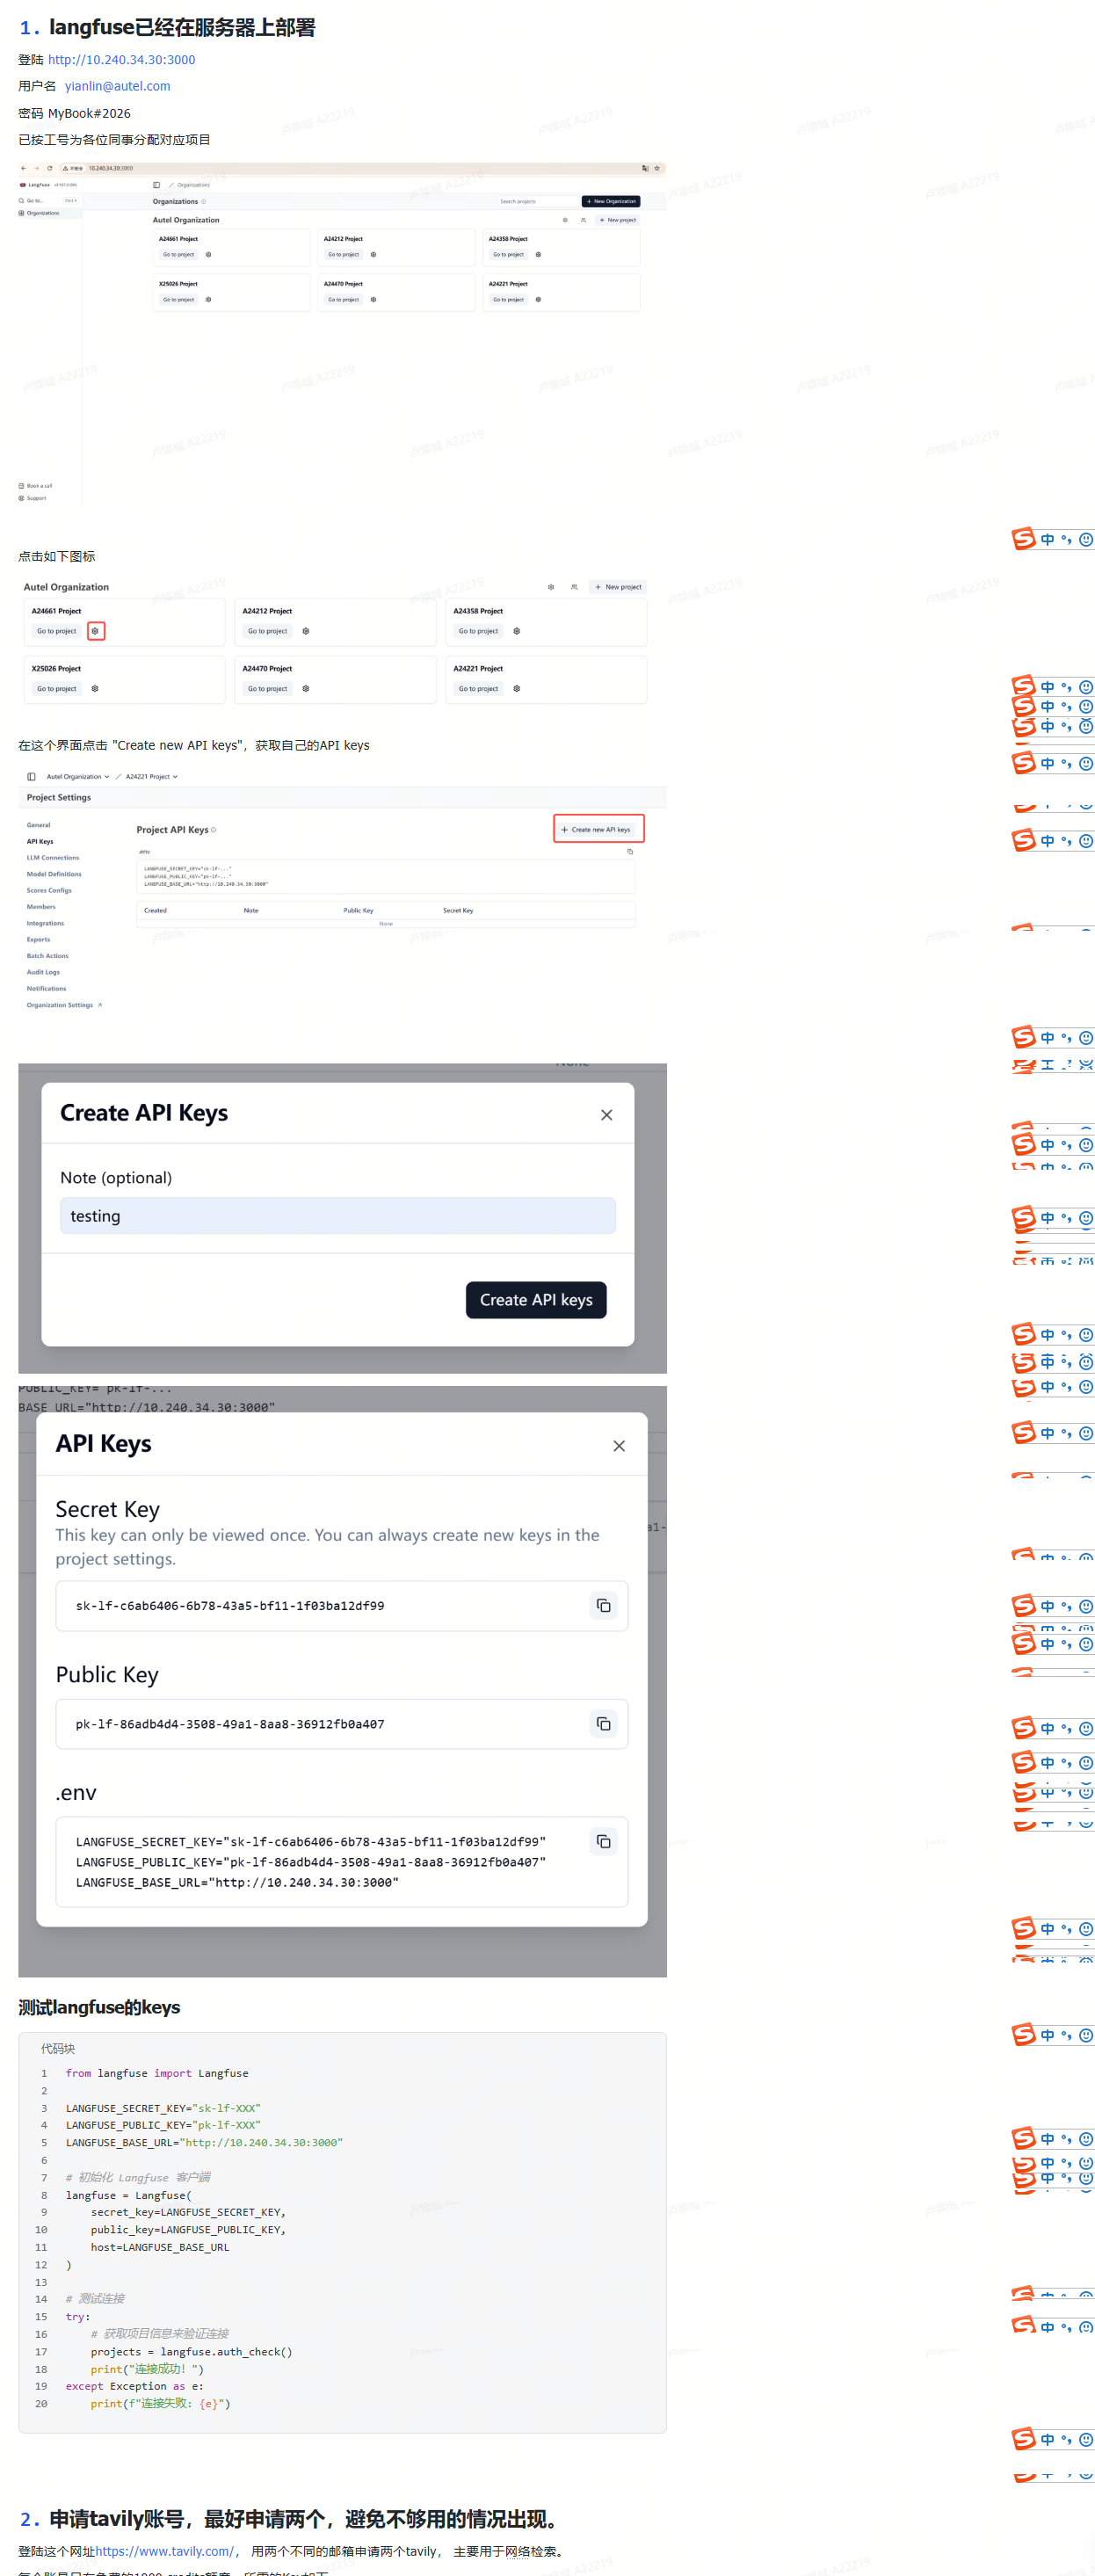
十三、langfuse LLM 可观测性平台,做调用追踪、监控、调试,对标langSmith
Langfuse:
  1、Langfuse部署
  		或者直接使用 Langfuse 官方提供的云托管服务: 欧洲区:https://cloud.langfuse.com/   美国区:https://us.cloud.langfuse.com
  2、部署后进入Langfuse,注册登录账号,创建org和项目获取到langfuse_secret_key和langfuse_public_key

  3、把secret_key和public_key填入agent项目的.env配置文件,就可以观测了
  	    LANGFUSE_ENABLED=true
		LANGFUSE_SECRET_KEY=sk-lf-aa0ae649-b683-4a87-aad0-380cb5f6a4ec
		LANGFUSE_PUBLIC_KEY=pk-lf-fd0c9b46-f331-40c5-9571-355298122165
		LANGFUSE_HOST=https://cloud.langfuse.com  #如果是自己部署的,就填自己的域名
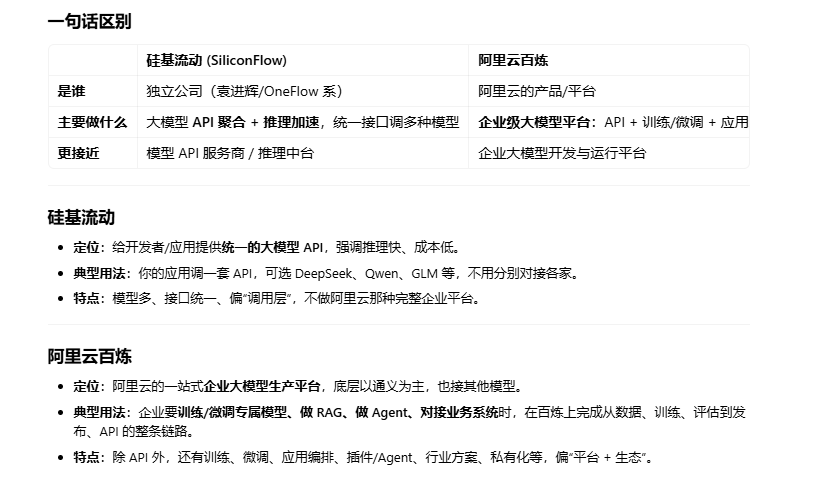
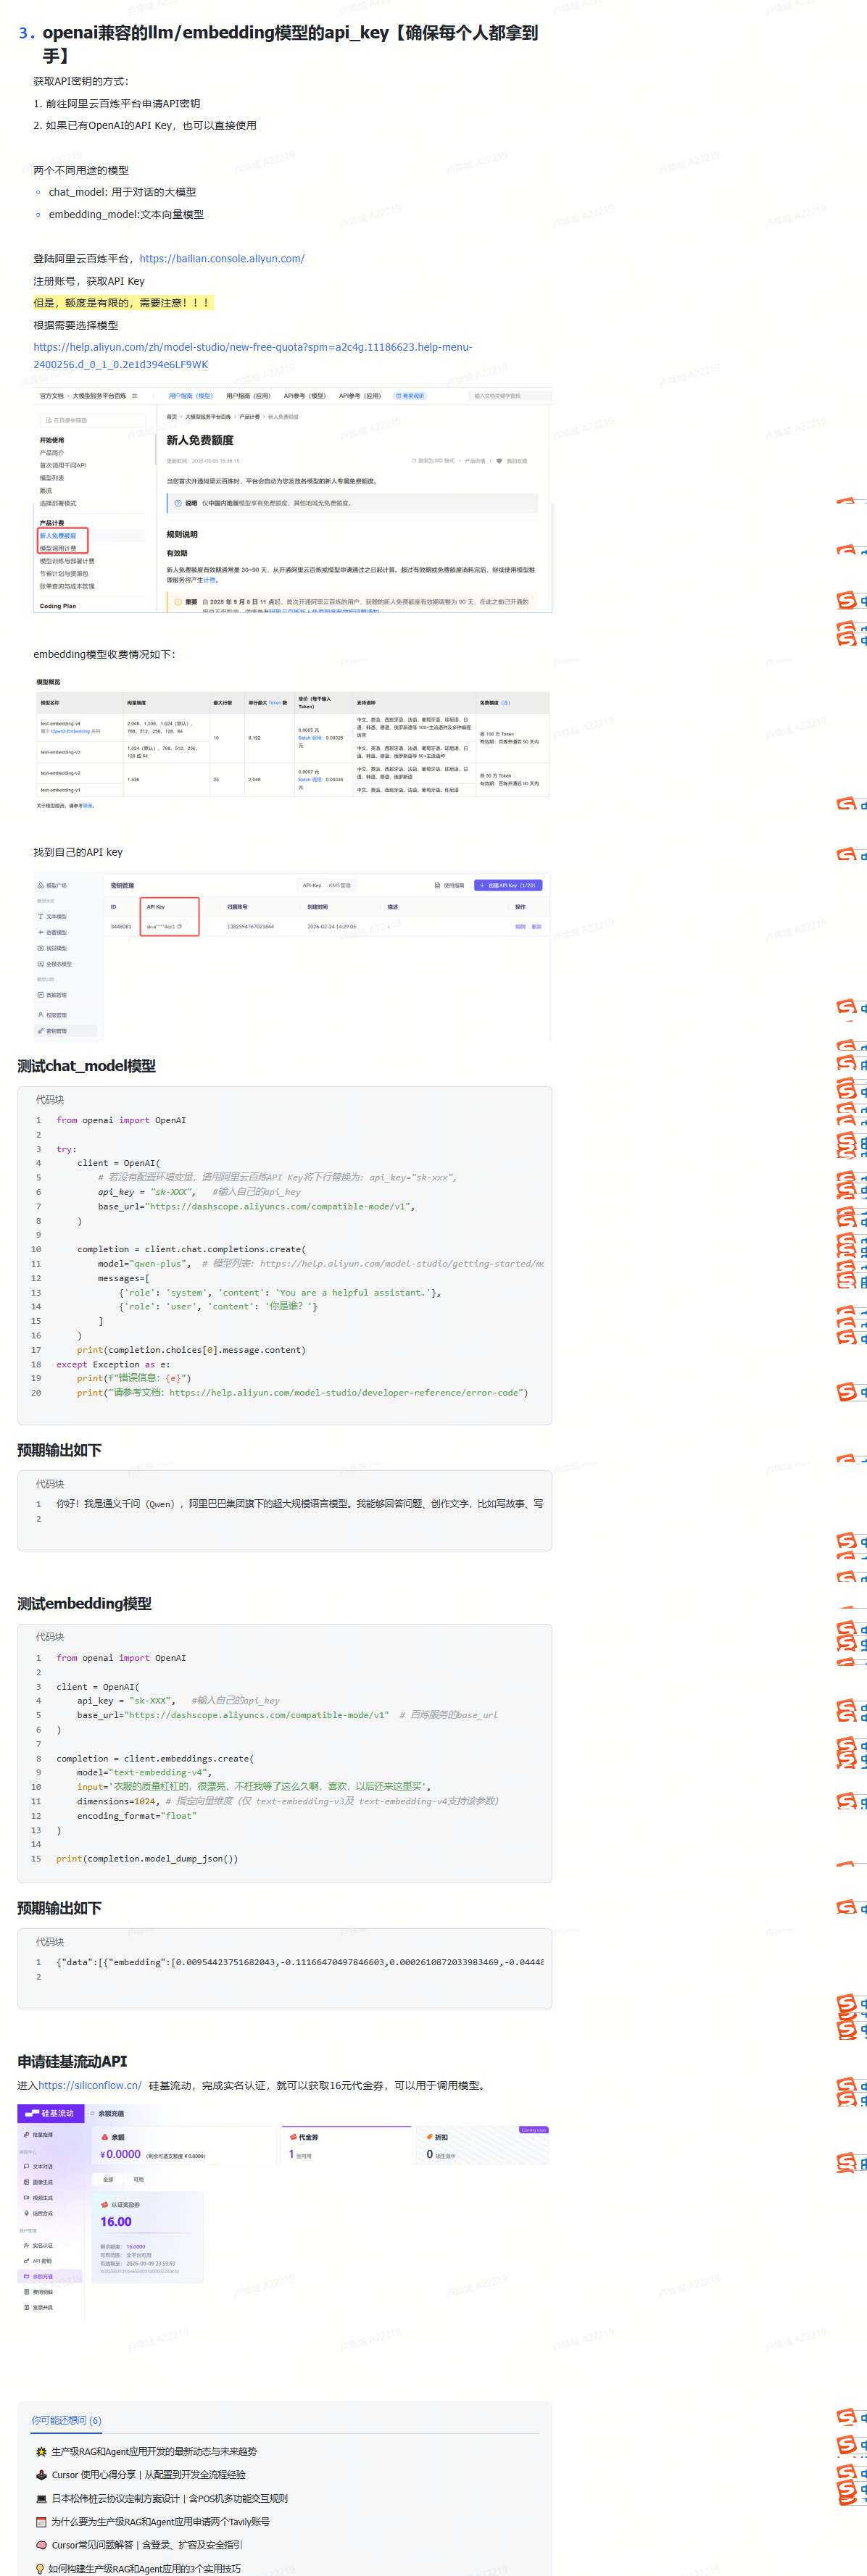
十四、硅基流动和阿里云百炼平台
十五、RAG
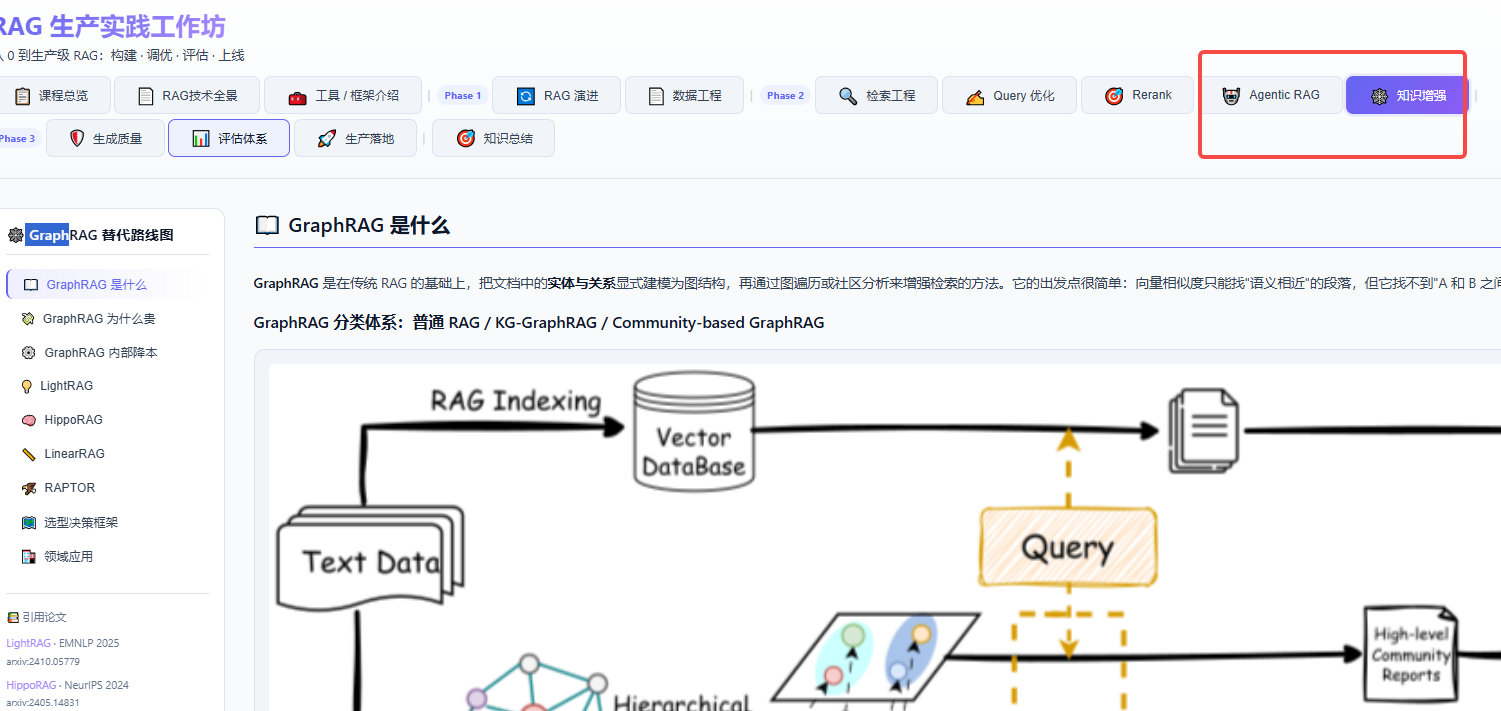
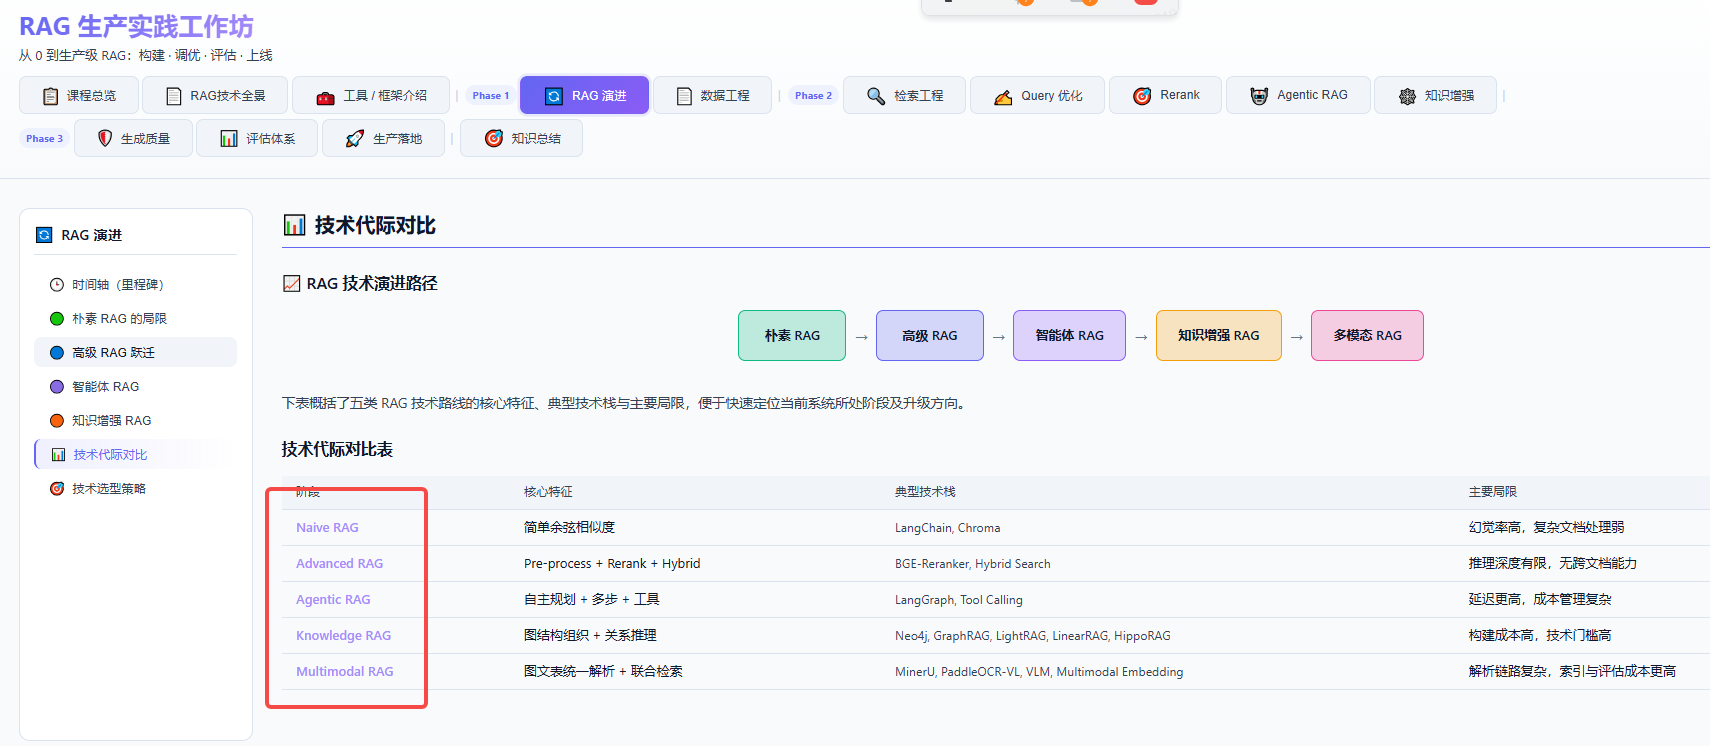
Agentic RAG:普通RAG 是固定流水线,Agentic RAG 是带控制闭环的系统。
	Self-RAG、CRAG、Adaptive-RAG、MemoRAG

GraphRAG:GraphRAG 是在传统 RAG 的基础上,把文档中的实体与关系显式建模为图结构,再通过图遍历或社区分析来增强检索的方法
   LightRAG、HippoRAG、LinearRAG、RAPTOR

rag的r是检索,有两阶段:
   召回 负责从大规模语料里快速拉出候选(Retrieval)
   重排序 负责在这批候选里挑出真正最相关的证据。(Reranke)
   第一阶段追求 recall,第二阶段追求 precision,所以它们天然不是同一个优化目标。
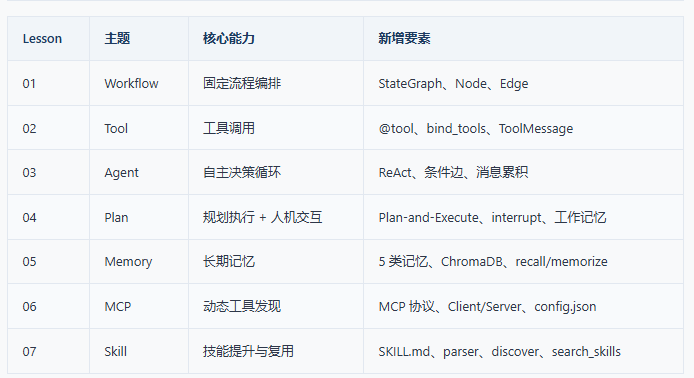
十六、Agent
1、Workflow 工作流编排
	问题:为什么不能直接问 LLM?直接向 LLM 提问"帮我调研 XXX",往往得到一段泛泛而谈的回答——内容不可控、结构不清晰、难以复用。一个 Prompt 承载不了太多职责。
    本课新能力:用 LangGraph StateGraph 构建了三步固定流水线(大纲→撰写→汇总)

2、给 LLM 配备 Tavily 搜索工具
   局限:报告完全依赖 LLM 自身知识,信息可能过时或不准确。LLM 的训练数据有截止日期,无法获取最新信息。
   本课新能力:给 LLM 配备 Tavily 搜索工具,让它能搜索互联网获取实时信息,基于真实数据撰写报告。

3、Agent
	引入 ReAct Agent,让 LLM 自主决定调研策略

4、plan
   给Agent 添加规划层和人工审核
   Lesson 03 的 ReAct Agent 虽然能自主决策,但容易"跑偏"——搜索过多、偏离主题、或者陷入无意义的循环。调研缺乏结构性,用户无法干预调研方向。

5、给 Agent 添加长期记忆系统
   记忆以 Markdown 文件持久化,同时通过 ChromaDB 向量索引支持语义检索。

6.引入 MCP(Model Context Protocol)标准化协议
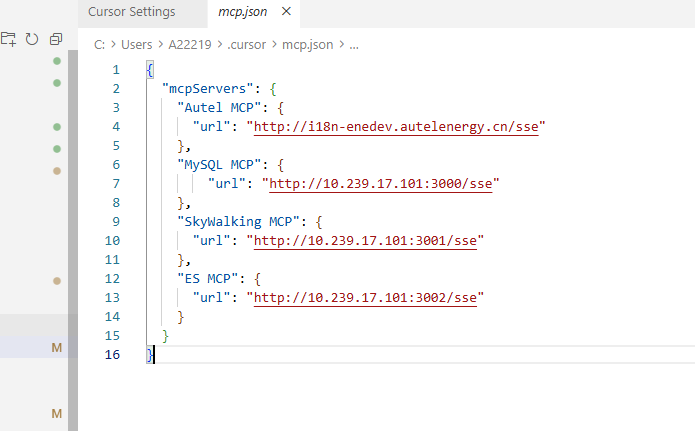
  MCP 协议让工具管理变得即插即用,比如连接tavlily实时搜索工具、mysql、es等

7.Skill 技能


核心概念
	StateGraph — 有状态的图编排,Node + Edge + Reducer
	Tool Calling — @tool 装饰器、bind_tools、ToolMessage
	ReAct 循环 — 条件边实现 think → act → observe 循环
	Plan-and-Execute — 全局规划 + 逐步执行的双层循环
	Human-in-the-Loop — interrupt/resume 机制
	Long-term Memory — 五类记忆 + ChromaDB 向量检索
	MCP 协议 — 标准化工具通信,动态发现
	Skill 系统 — 结构化方法论的自动匹配和复用
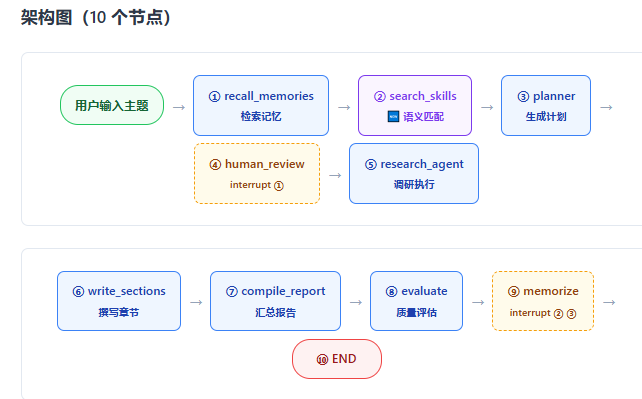
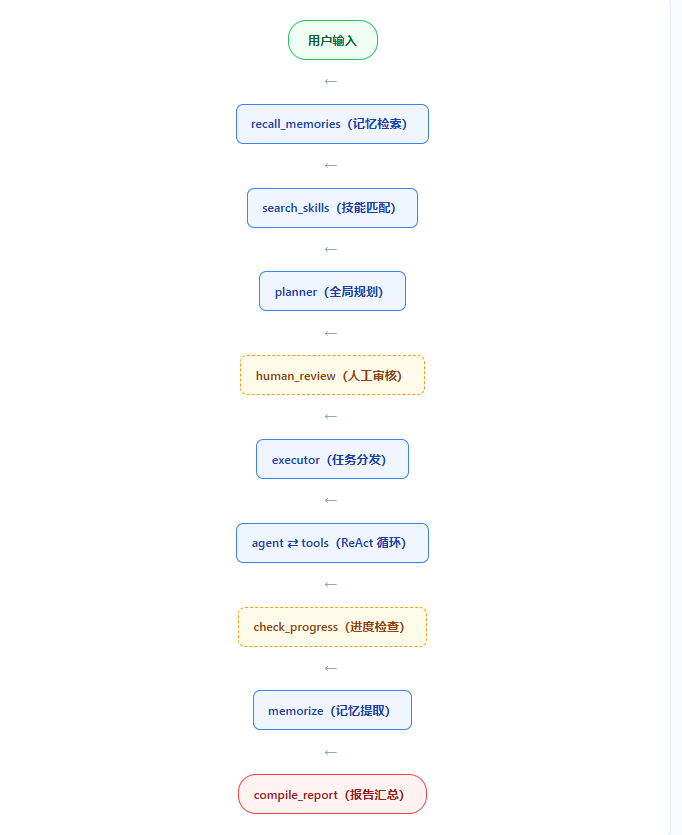
架构回顾
Agent架构
十七、Skill、MCP Tool、Function Calling
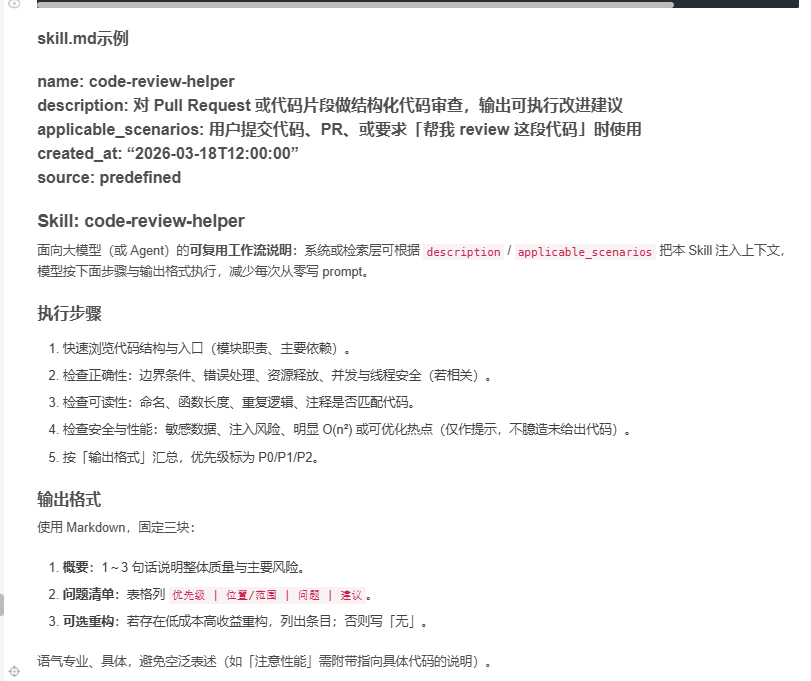
1、Skill
第一次调研 → 生成 Skill,第二次调研 → 自动匹配 Skill 并影响规划


步骤:
	创建 skills/parser.py,实现 parse_skill_md 和 render_skill_md(YAML frontmatter 解析,用 pyyaml)
	创建 skills/manager.py,实现 discover_skills:扫描 workspace/skills/*/SKILL.md
	实现 _build_index:启动时将发现的 Skill 建入 ChromaDB 索引
	实现 promote_to_skill:用 LLM 将程序性记忆 JSON 结构化为 Skill
	实现 register_skill:生成 workspace/skills/<name>/SKILL.md + 更新 ChromaDB
	实现 search_skills 方法:collection.query(query_texts=[...]) 语义匹配
	在 ResearchState 新增 active_skills 字段
	实现 search_skills 节点,插入 recall_memories 和 planner 之间
	修改 memorize 节点:保存程序性记忆后增加第三个 interrupt 确认提升为 Skill
	手动创建预定义 Skill → 运行两次验证
2、Tool & MCP工具
mcp就是tool工具
服务端demo示例:主要三点(1.创建MCP Server实例 2.注册工具 3.启动 mcp.run)
from fastmcp import FastMCP

# ========== 第一步:创建 MCP Server 实例 ==========
mcp  = FastMCP(
    "DemoServer",
    instructions="这是一个演示用的 MCP 服务,提供计算、天气和订单查询工具。",
)


# ========== 第二步:用装饰器注册工具 ==========

@mcp.tool(name="add")
def add(a: float, b: float) -> float:
    """计算两个数字的和。"""
    return a + b


@mcp.tool(name="get_weather")
def get_weather(city: str) -> dict:
    """查询指定城市的天气信息(模拟数据)。"""
    fake_weather = {
        "深圳": {"city": "深圳", "temp": "28°C", "weather": "多云", "humidity": "75%"},
        "北京": {"city": "北京", "temp": "22°C", "weather": "晴", "humidity": "40%"},
        "上海": {"city": "上海", "temp": "25°C", "weather": "阴", "humidity": "65%"},
    }
    return fake_weather.get(city, {"city": city, "temp": "未知", "weather": "暂无数据"})


@mcp.tool()
def query_order(order_id: str) -> dict:
    """根据订单号查询订单详情(模拟数据)。"""
    fake_orders = {
        "ORD001": {"order_id": "ORD001", "status": "已完成", "amount": 150.0, "user": "张三"},
        "ORD002": {"order_id": "ORD002", "status": "充电中", "amount": 0.0, "user": "李四"},
    }
    if order_id in fake_orders:
        return fake_orders[order_id]
    return {"error": f"订单 {order_id} 不存在"}


# ========== 第三步:启动服务 ==========
if __name__ == "__main__":
    mcp.run(transport="streamable-http", host="0.0.0.0", port=8080)
mcp客户端demo示例
获取所有工具:session.list_tools()
调用工具:session.call_tool("get_weather", {"city": "深圳"})


import asyncio

from mcp import ClientSession
from mcp.client.streamable_http import streamable_http_client


async def main():

    # ========== 第一步:建立连接 ==========
    server_url = "http://localhost:8080/mcp"
    async with streamable_http_client(server_url) as (read, write, _):
        async with ClientSession(read, write) as session:

            # ========== 第二步:初始化(握手) ==========
            await session.initialize()


            # ========== 第三步:列出所有工具(实际使用可不用这步骤) ==========
            tools_result = await session.list_tools()
            for tool in tools_result.tools:
                print(f"  工具名: {tool.name}")


            # ========== 第四步:调用工具 ==========

            # 调用 add
            result = await session.call_tool("add", {"a": 10, "b": 20})
            print(f"    结果: {result.content[0].text}\n")

            # 调用 get_weather
            result = await session.call_tool("get_weather", {"city": "深圳"})
            print(f"    结果: {result.content[0].text}\n")

            # 调用 query_order
            result = await session.call_tool("query_order", {"order_id": "ORD001"})
            print(f"    结果: {result.content[0].text}\n")

            # 调用不存在的订单
            result = await session.call_tool("query_order", {"order_id": "ORD999"})
            print(f"    结果: {result.content[0].text}\n")


if __name__ == "__main__":
    asyncio.run(main())
cursor里面的mcp配置(应用开发忽略这个,免得太绕,影响理解)
3、Function Calling
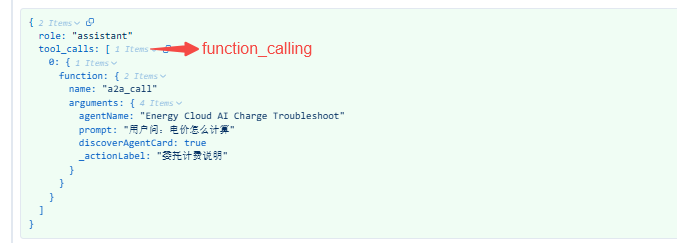
请求参数告诉 LLM "这里有一些工具可以调用",LLM分析用户问题后,决定要不要调用某个工具、传什么参数,然后返回给你,这个过程就叫Function Calling

 function的tools可以外部工具,也可以是内部工具。
 外部工具就是mcp,内部工具工程里面自己写

请求参数
	{
	  "model": "gpt-5.4",
	  "messages": [{"role": "user", "content": "深圳今天天气怎么样"}],
	  "tools": [
	    {
	      "type": "function",
	      "function": {
	        "name": "get_weather",
	        "description": "查询城市天气",
	        "parameters": {
	          "type": "object",
	          "properties": {
	            "city": {"type": "string", "description": "城市名"}
	          }
	        }
	      }
	    }
	  ]
	}

响应:返回get_weather这个函数
	{
	  "choices": [{
	    "message": {
	      "tool_calls": [{
	        "function": {
	          "name": "get_weather",
	          "arguments": "{\"city\": \"深圳\"}"
	        }
	      }]
	    }
	  }]
	}
内部工具定义示例与使用示例
1、定义工具基类,3 个必填属性 + 1 个方法
	class Tool(ABC):
	    @property
	    def name(self) -> str:           # ① 工具名(LLM 用这个名字来调用)
	        ...
	    @property
	    def description(self) -> str:    # ② 描述(LLM 根据这个判断何时调用)
	        ...
	    @property
	    def parameters(self) -> dict:    # ③ 参数定义(JSON Schema,告诉 LLM 传什么参数)
	        ...
	    async def execute(self, **kwargs) -> str:  # ④ 执行逻辑(LLM 决定调用后,你的代码在这里跑)


2、定义webSearch工具类
	class WebSearchTool(Tool):
	    # ① 工具名 —— LLM 调用时用这个名字
	    name = "web_search"
	    # ② 描述 —— LLM 根据这段话判断什么时候该用这个工具
	    description = "Search the web. Returns titles, URLs, and snippets."
	    # ③ 参数定义 —— 告诉 LLM 这个工具接受什么参数
	    parameters = {
	        "type": "object",
	        "properties": {
	            "query": {"type": "string", "description": "Search query"},
	            "count": {"type": "integer", "description": "Results (1-10)"},
	        },
	        "required": ["query"],
	    }
	    # ④ 执行逻辑 —— 真正干活的地方
	    async def execute(self, query: str, count: int | None = None, **kwargs) -> str:
	        # 调用 Brave Search API,返回搜索结果
	        async with httpx.AsyncClient() as client:
	            r = await client.get("https://api.search.brave.com/...", ...)
	        return "\n".join(results)

3、调用大模型时将这个WebSearchTool作为tools参数
		{
		  "type": "function",
		  "function": {
		    "name": "web_search",   # 取工具定义的name属性
		    "description": "Search the web. Returns titles, URLs, and snippets.",
		    "parameters": {
		      "type": "object",
		      "properties": {
		        "query": {"type": "string", "description": "Search query"},
		        "count": {"type": "integer", "description": "Results (1-10)"}
		      },
		      "required": ["query"]
		    }
		  }
		}
4、Skill、MCP Tool、Function Calling 在入参出参中的体现
入参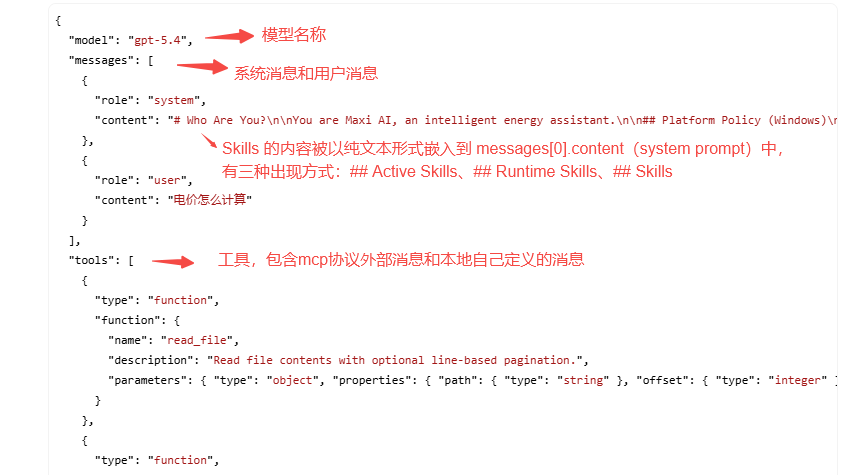
出参
十八、Agent评估
Langfuse
DeepEval:DeepEval是由Confident AI开发的开源Python评估框架
  GEval
  GEPA
十九、会话历史(记忆)
短期记忆: 天然 KV + TTL 过期,按 session_id 存最近 N 轮消息
长期记忆: PostgreSQL/MongoDB
语义记忆(向量检索):把记忆 embedding 后存入,查询时用语义匹配。
      Chroma、Milvus、Qdrant、Weaviate、pgvector
二十、视觉大模型 AIGC视频
传统:yolo
大模型:
	GPT-4V	OpenAI	视觉理解 + GPT-4 推理
	Gemini	Google	原生多模态,视觉能力强大
	Claude 3	Anthropic	支持图像理解
	Qwen-VL	阿里通义	开源,中文友好
	LLaVA	开源社区	轻量级视觉助手


即梦、vigglei、可灵、infiniteTalk、
curl、剪映

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)