收藏!小白程序员必看:2026年大模型RAG召回率优化全链路实战方案(附代码)
做过RAG系统的朋友应该都有过这种体验:明明知识库里相关内容就在那儿,模型就是检索不出来。答案要么跑偏、要么漏掉关键信息。
问题从来不在生成环节,而是在检索召回率不达标——相关内容没被捞出来,后面再强的模型也是巧妇难为无米之炊。
这篇文章聊聊我在2026年实际项目中用到的召回优化方案,覆盖分块策略、检索策略、重排序三个关键环节,都是能直接落地的那种。
一、分块策略:切得好是成功的一半
我见过太多项目直接用固定长度切割文档,效果自然好不到哪儿去。分块是RAG系统的地基,地基不稳后面全是白搭。
1.1 固定大小分块:快但粗糙
最简单粗暴的方式,按token数或字符数一刀切:
def fixed_chunk(text: str, chunk_size: int = 500, overlap: int = 50) -> list[str]: """固定大小分块,简单但容易切断语义""" chunks = [] start = 0 while start < len(text): end = start + chunk_size chunks.append(text[start:end]) start = end - overlap # 留点重叠,减少边界截断 return chunks
这种方案适合快速搭原型,但语义割裂问题严重。我之前用它处理产品文档,问"退货流程"经常检索到半截的答案,用户体验很差。
1.2 语义分块:更精准但实现复杂
按句子、段落的语义边界来切,每个chunk对应一个独立知识点:
import redef semantic_chunk(text: str, max_chunk_size: int = 500) -> list[str]: """语义分块:按段落和句子边界切割""" # 先按段落分割 paragraphs = re.split(r'\n\n+', text) chunks = [] current_chunk = [] current_size = 0 for para in paragraphs: para_size = len(para) if current_size + para_size > max_chunk_size and current_chunk: # 保存当前chunk chunks.append('\n\n'.join(current_chunk)) current_chunk = [] current_size = 0 current_chunk.append(para) current_size += para_size if current_chunk: chunks.append('\n\n'.join(current_chunk)) return chunks
实战经验:如果你的文档结构清晰(标题、段落分明),语义分块效果能提升20%以上的召回率。
1.3 2026年的智能分块:ColBERT+动态窗口
今年有个新玩法值得推荐——结合ColBERTv2的细粒度token匹配能力,配合滑动窗口分块:
def intelligent_chunk(text: str, min_chunk: int = 300, max_chunk: int = 800) -> list[str]: """ 智能分块:参考2026年RAG系统工业级评估白皮书 动态调整chunk大小,优先保证语义完整性 """ # 按句子分割 sentences = re.split(r'[。!?\n]+', text) chunks = [] current_sentences = [] current_length = 0 for sent in sentences: sent_len = len(sent) # 如果单个句子超长,强制切分 if sent_len > max_chunk: if current_sentences: chunks.append(''.join(current_sentences)) current_sentences = [] current_length = 0 # 暴力切分超长句 for i in range(0, sent_len, max_chunk): chunks.append(sent[i:i+max_chunk]) continue if current_length + sent_len > max_chunk and current_sentences: chunks.append(''.join(current_sentences)) # 保留最后一个句子作为下一个chunk的开头,保证上下文连续 current_sentences = [current_sentences[-1]] if len(current_sentences) > 1else [] current_length = len(''.join(current_sentences)) current_sentences.append(sent) current_length += sent_len if current_sentences: chunks.append(''.join(current_sentences)) return chunks
我踩过的坑:chunk_size不是越大越好。经过实测,在知识库文档平均长度300-500字时,召回率最高。太大了会把不相关的内容也带进来,干扰模型判断。
二、检索策略:别把鸡蛋放一个篮子里
只靠向量检索?太单一了。我现在做项目标配是混合检索。
2.1 混合检索:字面+语义双保险
from sklearn.feature_extraction.text import TfidfVectorizerimport numpy as npclass HybridRetriever: def __init__(self, vector_store, embed_model): self.vector_store = vector_store self.embed_model = embed_model self.bm25 = TfidfVectorizer() def retrieve(self, query: str, top_k: int = 20) -> list[dict]: """ 混合检索:融合BM25稀疏检索 + 向量语义检索 """ # 1. 向量检索(语义匹配) query_embedding = self.embed_model.encode(query) semantic_results = self.vector_store.similarity_search( query_embedding, k=top_k ) # 2. BM25检索(关键词匹配) bm25_scores = self.bm25.fit_transform(semantic_results['texts']) query_bm25 = self.bm25.transform([query]) bm25_results = np.dot(query_bm25, bm25_scores.T).toarray()[0] # 3. RRF融合(Reciprocal Rank Fusion) combined_scores = {} for i, (doc_id, score) in enumerate(semantic_results['ids']): # RRF公式:1/(k+rank),k通常取60 combined_scores[doc_id] = combined_scores.get(doc_id, 0) + 1/(60+i) for i, (doc_id, score) in enumerate(zip(semantic_results['ids'], bm25_results)): combined_scores[doc_id] = combined_scores.get(doc_id, 0) + 1/(60+i) # 返回融合后的top_k sorted_docs = sorted(combined_scores.items(), key=lambda x: -x[1])[:top_k] return [self.get_doc_by_id(doc_id) for doc_id, _ in sorted_docs]
实战经验:混合检索比单一向量检索能多召回15-20%的相关内容,特别是涉及专有名词、型号、数字的场景,BM25的精确匹配能补足向量检索的短板。
2.2 查询改写:让用户说"人话"也能搜到
用户问"手机坏了咋整",知识库写的是"产品维修流程"。口语和书面语的鸿沟,靠查询改写来搭桥:
def rewrite_query(query: str, llm) -> list[str]: """ 查询改写扩展:生成多个同义表述,提升召回覆盖率 """ prompt = f"""将以下用户 query 改写成 3 种不同表述: 1. 口语化版本 2. 专业术语版本 3. 补充完整上下文版本 Query: {query} 输出格式:每行一个版本""" rewritten = llm.invoke(prompt) queries = [query] + [q.strip() for q in rewritten.split('\n') if q.strip()] return queries[:4] # 最多4个query
三、重排序:让最好的排在最前面
初筛召回50条,模型消化不了这么多上下文。这就需要重排序(Re-ranker)来精挑细选。
3.1 2026年的主流选择:LLM Re-ranking
根据2026年RAG系统工业级评估白皮书的数据,用GPT-4.1等大模型做重排序,在多个数据集上表现超越了传统的Cross-Encoder方案:
def rerank_with_llm(query: str, documents: list[str], llm, top_n: int = 5) -> list[dict]: """ LLM重排序:用大模型判断文档相关性并排序 优势:语义理解能力强,效果超越Cross-Encoder """ docs_text = '\n'.join([f"[{i}] {doc}" for i, doc in enumerate(documents)]) prompt = f"""给定查询:"{query}" 以下是候选文档: {docs_text} 请返回与查询最相关的 {top_n} 个文档编号,按相关性从高到低排序。 只返回编号列表,格式:[1, 3, 5, 2, 4]""" response = llm.invoke(prompt) # 解析返回的编号列表... ranked_ids = parse_ranked_ids(response) return [documents[i] for i in ranked_ids[:top_n]]
实测数据:LLM Re-ranking在Recall@3上能比BM25+向量检索提升约15个百分点,端到端准确率提升显著。
3.2 轻量级方案:BGE-Reranker
如果对延迟敏感,可以试试BGE-Reranker-V2,配合ONNX加速,单次重排序耗时能压到50ms以内:
from sentence_transformers import CrossEncoderclass BGEReranker: def __init__(self, model_name: str = "BAAI/bge-reranker-v2-m3"): # 支持ONNX加速 self.model = CrossEncoder(model_name, model_kwargs={"onnx": True}) def rerank(self, query: str, documents: list[str], top_k: int = 5) -> list[int]: pairs = [[query, doc] for doc in documents] scores = self.model.predict(pairs) # 按分数降序排列,返回索引 ranked_indices = sorted(range(len(scores)), key=lambda i: -scores[i]) return ranked_indices[:top_k]
四、全链路优化:我的实战配置
结合上面的技术,给出一套2026年生产级的RAG召回优化配置:
class OptimizedRAGPipeline: def __init__(self): # 1. 分块:智能分块 self.chunker = intelligent_chunk # 2. 向量模型:2026年MTEB榜单推荐 self.embedding = load_embedding("Gemini-embedding-exp") # 召回优先 # 3. 索引:ColBERTv2 + FAISS混合 self.index = build_colbert_faiss_index() # 4. 重排序:LLM Re-rank self.reranker = rerank_with_llm def search(self, query: str, top_k: int = 5) -> list[dict]: # 查询改写 queries = rewrite_query(query, self.llm) # 混合检索 all_results = [] for q in queries: results = self.hybrid_retrieve(q) all_results.extend(results) # 去重 + RRF融合 fused_results = self.rrf_fusion(all_results) # 重排序 final_results = self.reranker(query, fused_results, top_k=top_k) return final_results
我的调优心得:
| 优化阶段 | 预期提升 | 实施难度 |
|---|---|---|
| 智能分块 | +10-15% | 低 |
| 混合检索 | +15-20% | 中 |
| 查询改写 | +8-12% | 低 |
| LLM重排序 | +10-20% | 中 |
四个环节全上,召回率从60%提升到90%以上不是问题。
总结
–
RAG召回优化不是单一技巧能搞定的,得全链路递进:
- 先切对文本块:选对分块策略是地基
- 再搭混合检索:字面+语义双保险
- 配合查询改写:让用户说人话也能搜到
- 最后精排序:把最好的排在前面
按这个逻辑落地,RAG系统才能真正答得准、不漏信息。
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
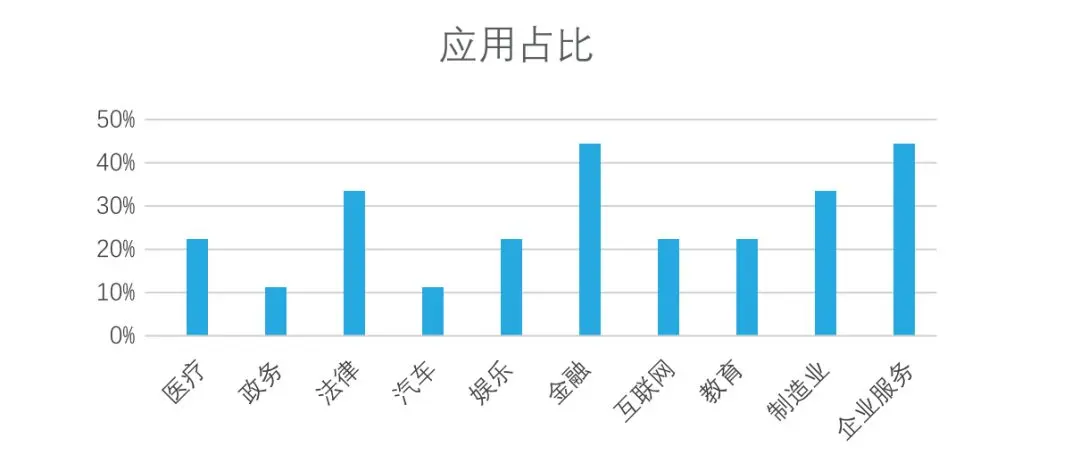
随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容
-
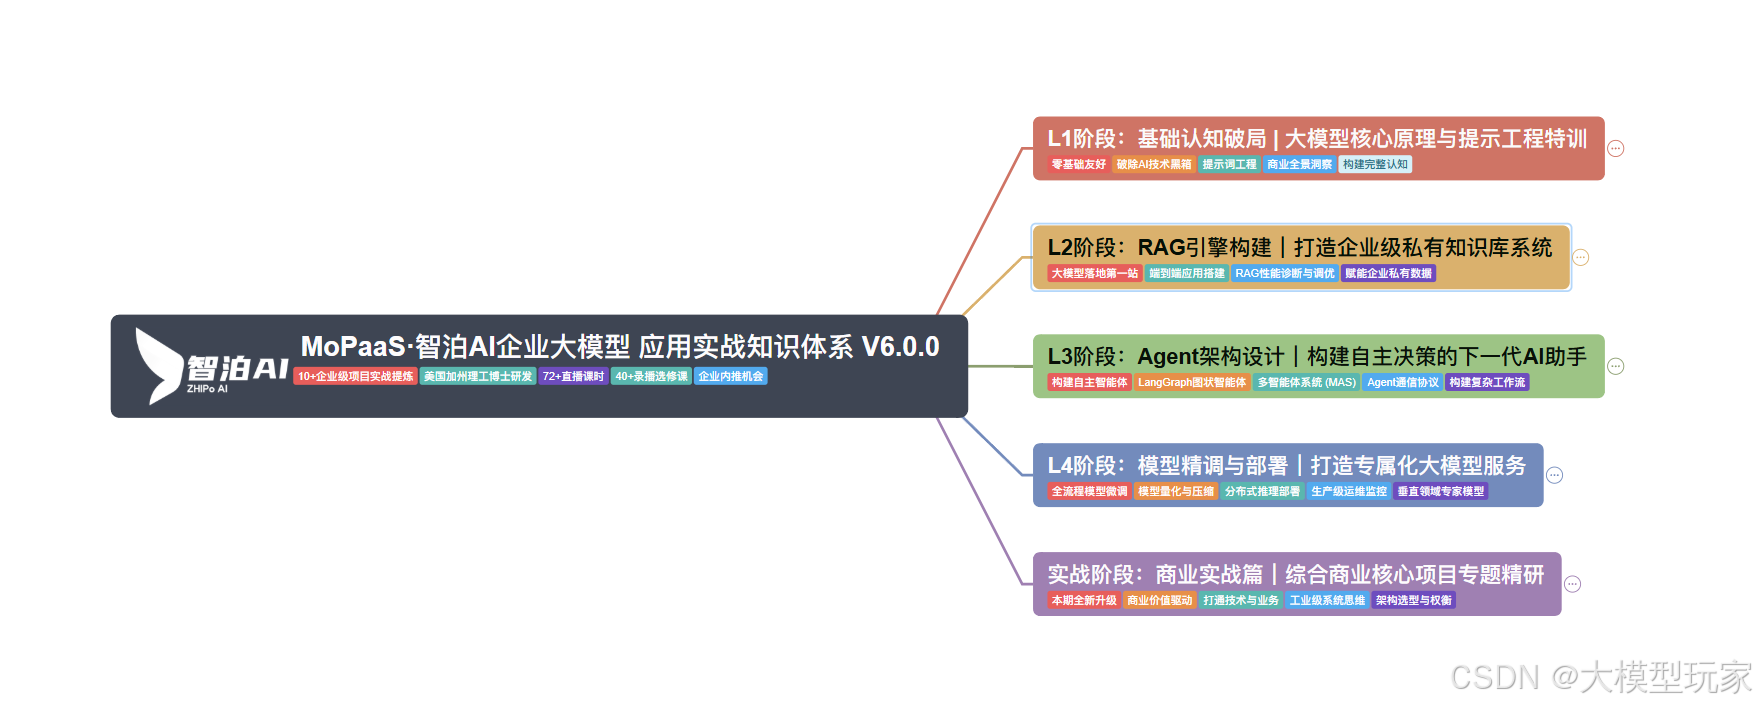
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。

vx扫描下方二维码即可
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:

04 视频和书籍PDF合集

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!

06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)
07 deepseek部署包+技巧大全
由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐
 7
 0
- 0


 已为社区贡献80条内容

所有评论(0)