基于tensorflow的Transformer XL的英-中翻译
前言:
Transformer-XL(Transformer with Extra Long)是由 Zihang Dai 等人提出的,论文标题为:"Transformer-XL: Attentive Language Models Beyond a Fixed-Length Context"
论文摘要:
Transformer-XL 提出了一个改进的 Transformer 模型,解决了标准 Transformer 模型在处理长文本时的限制问题(如固定长度上下文窗口)。通过引入 相对位置编码 和 可扩展的记忆机制,Transformer-XL 能够在不丧失长依赖关系建模能力的情况下处理任意长度的序列。这使得模型能够更好地应对语言建模和序列生成任务中遇到的长文本问题。
主要贡献:
-
可扩展的记忆机制:允许模型保留先前的状态并将其用于当前序列的处理,从而能够建模跨越多个序列的长依赖关系。Transformer的传统版本(如原始的Transformer模型)在处理长序列时会将序列分割成固定长度的片段,并且每个片段的上下文只能看到当前片段内的信息。这种方式导致了模型无法在不同片段之间建立有效的长距离依赖关系。Transformer-XL通过引入可扩展的记忆机制,允许模型在处理新的片段时,保留和复用上一片段的状态(记忆)。这种机制使得模型能够跨越多个片段保持对长期依赖的建模能力。具体来说,Transformer-XL通过引入分段级别的递归机制,每个输入片段不仅依赖当前片段的信息,还可以接收到之前片段的记忆信息。这使得每个片段的上下文能够跨越多个片段,从而使得模型能够处理更长的上下文。
-
相对位置编码:替代了传统的绝对位置编码,使得模型能够更灵活地处理序列中的相对关系。在原始Transformer中,位置编码是基于固定的绝对位置进行的,这导致模型难以处理具有不规则长距离依赖的序列,特别是在处理很长的文本时。Transformer-XL引入了相对位置编码,这种编码方式不再依赖于序列的绝对位置,而是关注元素之间的相对位置。通过这种方式,Transformer-XL能够在序列的不同位置之间有效地建立依赖关系,不受序列长度限制。
-
更长上下文建模:能够处理比原始 Transformer 更长的上下文,突破了固定长度上下文的限制。
Transformer-XL的工作原理
-
递归机制:在处理每个输入片段时,Transformer-XL不仅仅利用当前片段的信息,还会利用上一片段的隐藏状态作为记忆传递到当前片段的输入中。这种递归的机制允许模型处理超过固定上下文长度的依赖关系。
-
记忆缓存:每次训练过程中,模型会将计算出来的隐藏状态保存在缓存中,作为后续片段的记忆。这种记忆机制使得模型可以在长序列上有效地传递信息,而不需要重新计算先前的上下文。
Transformer-XL的优势
-
更长的上下文建模能力:
-
Transformer-XL能够处理比传统Transformer更长的序列,特别适合需要长期依赖的任务,如语言建模和文本生成。
-
-
计算效率提升:
-
由于可扩展的记忆机制和相对位置编码的引入,Transformer-XL减少了计算量,能够有效地处理大规模数据,同时提高了训练效率。
-
-
更强的泛化能力:
-
Transformer-XL通过更灵活的上下文建模,能够在一些NLP任务上提供更好的性能,尤其是在需要长序列依赖的任务上(例如语言模型、文本生成等)。
-
代码实现
1.引入相关库文件
import numpy as np
import pandas as pd
import tensorflow as tf
from tensorflow.keras.layers import Input, Dense, LayerNormalization, Dropout, Concatenate, Embedding
from tensorflow.keras.models import Model
2.处理数据
# 参数定义
N_UNITS = 128
NUM_HEADS = 4
FF_DIM = 512
BATCH_SIZE = 32
EPOCH = 150
NUM_SAMPLES = 10000
INPUT_LENGTH = 30
OUTPUT_LENGTH = 30
data_path = './cmn_zhsim.txt'

# 读取数据
df = pd.read_table(data_path, header=None).iloc[:NUM_SAMPLES, :]
df.columns = ['inputs', 'targets']
df['targets'] = df['targets'].apply(lambda x: '\t' + x + '\n')

input_texts = df.inputs.tolist()
target_texts = df.targets.tolist()

# 构建字符集
input_characters = sorted(list(set(''.join(df.inputs.unique()))))
target_characters = sorted(list(set(''.join(df.targets.unique()))))

# 定义输入/输出维度
INPUT_LENGTH = min(max(map(len, input_texts)), INPUT_LENGTH)
OUTPUT_LENGTH = min(max(map(len, target_texts)), OUTPUT_LENGTH)
INPUT_FEATURE_LENGTH = len(input_characters)
OUTPUT_FEATURE_LENGTH = len(target_characters)

# 字符映射
input_dict = {char: i for i, char in enumerate(input_characters)}
target_dict = {char: i for i, char in enumerate(target_characters)}

# 初始化数据
encoder_input = np.zeros((NUM_SAMPLES, INPUT_LENGTH, INPUT_FEATURE_LENGTH), dtype=np.float32)
decoder_input = np.zeros((NUM_SAMPLES, OUTPUT_LENGTH, OUTPUT_FEATURE_LENGTH), dtype=np.float32)
decoder_output = np.zeros((NUM_SAMPLES, OUTPUT_LENGTH, OUTPUT_FEATURE_LENGTH), dtype=np.float32)

# One-hot 编码
for i, seq in enumerate(input_texts):
    for j, char in enumerate(seq[:INPUT_LENGTH]):
        encoder_input[i, j, input_dict[char]] = 1.0

for i, seq in enumerate(target_texts):
    for j, char in enumerate(seq[:OUTPUT_LENGTH]):
        decoder_input[i, j, target_dict[char]] = 1.0
        if j > 0:
            decoder_output[i, j - 1, target_dict[char]] = 1.0
3.定义模型
# Transformer-XL 中的相对位置编码
class RelativePositionEmbedding(tf.keras.layers.Layer):
    def __init__(self, n_heads, depth, max_len=512):
        super().__init__()
        self.n_heads = n_heads
        self.depth = depth
        self.max_len = max_len
        self.position_embeddings = self.add_weight(
            "position_embeddings", shape=[max_len, depth]
        )

    def call(self, x):
        seq_len = tf.shape(x)[1]
        positions = tf.range(seq_len)
        position_embeds = tf.gather(self.position_embeddings, positions)
        return position_embeds

# Transformer-XL 的多头注意力层
class MultiHeadAttentionXL(tf.keras.layers.Layer):
    def __init__(self, num_heads, key_dim):
        super().__init__()
        self.num_heads = num_heads
        self.key_dim = key_dim
        self.depth = key_dim // num_heads

        self.query_dense = Dense(key_dim)
        self.key_dense = Dense(key_dim)
        self.value_dense = Dense(key_dim)
        self.output_dense = Dense(key_dim)

    def split_heads(self, x, batch_size):
        x = tf.reshape(x, (batch_size, -1, self.num_heads, self.depth))
        return tf.transpose(x, perm=[0, 2, 1, 3])

    def call(self, inputs):
        query, key, value = inputs
        batch_size = tf.shape(query)[0]

        query = self.split_heads(self.query_dense(query), batch_size)
        key = self.split_heads(self.key_dense(key), batch_size)
        value = self.split_heads(self.value_dense(value), batch_size)

        attention_scores = tf.matmul(query, key, transpose_b=True)
        attention_scores /= tf.sqrt(tf.cast(self.depth, dtype=query.dtype))
        attention_weights = tf.nn.softmax(attention_scores, axis=-1)
        output = tf.matmul(attention_weights, value)

        output = tf.transpose(output, perm=[0, 2, 1, 3])
        output = tf.reshape(output, (batch_size, -1, self.num_heads * self.depth))
        output = self.output_dense(output)

        return output

# 构建 Transformer-XL 模型
def create_transformer_xl_model(n_input, n_output, n_units, num_heads, ff_dim):
    encoder_input = Input(shape=(None, n_input))
    encoder_embedding = Dense(n_units)(encoder_input)
    encoder_norm = LayerNormalization()(encoder_embedding)

    attention_output = MultiHeadAttentionXL(num_heads, n_units)([encoder_norm, encoder_norm, encoder_norm])
    attention_output = Dropout(0.1)(attention_output)
    encoder_output = LayerNormalization()(attention_output + encoder_norm)

    ffn_output = Dense(ff_dim, activation='relu')(encoder_output)
    ffn_output = Dense(n_units)(ffn_output)
    encoder_output = LayerNormalization()(ffn_output + encoder_output)

    decoder_input = Input(shape=(None, n_output))
    decoder_embedding = Dense(n_units)(decoder_input)
    decoder_norm = LayerNormalization()(decoder_embedding)

    decoder_attention_output = MultiHeadAttentionXL(num_heads, n_units)([decoder_norm, encoder_output, encoder_output])
    decoder_attention_output = Dropout(0.1)(decoder_attention_output)
    decoder_output = LayerNormalization()(decoder_attention_output + decoder_norm)

    ffn_output = Dense(ff_dim, activation='relu')(decoder_output)
    ffn_output = Dense(n_units)(ffn_output)
    decoder_output = LayerNormalization()(ffn_output + decoder_output)

    output = Dense(n_output, activation='softmax')(decoder_output)
    model = Model([encoder_input, decoder_input], output)
    return model
4.模型初始化,并查看模型
# 创建并编译模型
model_train = create_transformer_xl_model(INPUT_FEATURE_LENGTH, OUTPUT_FEATURE_LENGTH, N_UNITS, NUM_HEADS, FF_DIM)
model_train.compile(optimizer='adam', loss='categorical_crossentropy')

# 显示模型摘要
model_train.summary()
5.模型训练
# 训练模型
model_train.fit(
    [encoder_input, decoder_input], decoder_output,
    batch_size=BATCH_SIZE, epochs=EPOCH, validation_split=0.2,
)
6.测试模型
def predict_chinese(source, transformer, max_encoder_seq_length, max_decoder_seq_length, input_dict, target_dict_reverse):
    # 初始解码器输入是开始符号 '\t'
    decoder_input = np.zeros((1, max_decoder_seq_length, len(target_dict_reverse)), dtype=np.float32)
    decoder_input[0, 0, target_dict['\t']] = 1.0  # 使用target_dict而不是target_dict_reverse

    # 将输入序列转换为one-hot编码
    encoder_input = np.zeros((1, max_encoder_seq_length, len(input_dict)), dtype=np.float32)
    for t, char in enumerate(source[:max_encoder_seq_length]):
        encoder_input[0, t, input_dict[char]] = 1.0

    output = ''
    for i in range(max_decoder_seq_length):
        # 获取解码器预测结果
        decoder_output = transformer.predict([encoder_input, decoder_input])
        sampled_token_index = np.argmax(decoder_output[0, i, :])
        sampled_char = target_dict_reverse[sampled_token_index]

        output += sampled_char

        # 如果预测的是终止符 '\n',则结束预测
        if sampled_char == '\n':
            break

        # 更新decoder_input,输入下一个字符
        if i + 1 < max_decoder_seq_length:
            decoder_input[0, i + 1, sampled_token_index] = 1.0

    return output


# 在target_dict中加入起始符'\t'和终止符'\n'
target_characters = sorted(list(set(''.join(df.targets.unique()))))  # 目标字符集
target_dict = {char: i for i, char in enumerate(target_characters)}

# 反向字典
target_dict_reverse = {i: char for char, i in target_dict.items()}

# 确保'\t'和'\n'在字典中
assert '\t' in target_dict and '\n' in target_dict

# 测试数据
for i in range(200, 300):  # 测试100到200个样本
    test_input = input_texts[i]  # 获取输入句子
    predicted_output = predict_chinese(test_input, model_train, INPUT_LENGTH, OUTPUT_LENGTH, input_dict, target_dict_reverse)  # 使用训练好的模型进行预测

    print(f'Input: {test_input}')
    print(f'Predicted Output: {predicted_output}')
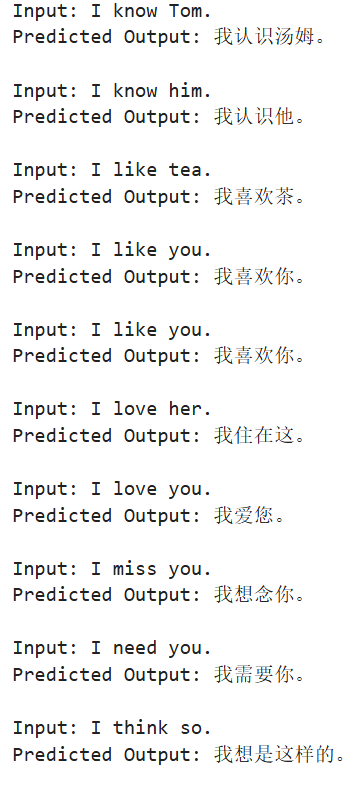
测试结果

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐
 20
 0
- 0


 已为社区贡献2条内容

所有评论(0)