ZooKeeper分布式协调服务详解:从原理到实战部署
摘要:本文系统讲解ZooKeeper分布式协调服务的核心概念、工作原理、数据一致性保障机制,以及完整的集群部署实践。作为Hadoop生态系统的核心组件,掌握ZooKeeper是理解分布式系统架构的关键一步。
关键词:ZooKeeper、分布式协调、Zab协议、Paxos算法、集群部署
第一章 环境规划与准备
一、规划内容
在搭建ZooKeeper集群之前,完整的环境规划是成功的关键。分布式系统的复杂性决定了我们必须从拓扑结构、主机规划、软件版本到数据目录进行全方位设计。
1. 集群拓扑(Master/Slave架构)
ZooKeeper集群采用经典的主从架构:
| 角色 | 数量 | 职责 |
|---|---|---|
| Leader | 1 | 主导写操作,协调事务提交流程 |
| Follower | 多个 | 处理读请求,参与选举与投票决策 |
核心特点:
-
每个Server保存一份完整的数据副本
-
全局数据保持一致性视图
-
写请求必须由Leader处理,读请求可分散到任意节点
2. 主机规划
在/etc/hosts文件中配置IP映射,确保节点间可通过主机名通信:
# 编辑hosts文件
[root@hadoop1 ~]# vi /etc/hosts

# 添加以下配置
172.16.206.16   master
172.16.206.26   masterback
172.16.206.27   slave1
172.16.206.29   slave2
3. 软件规划清单
| 软件 | 版本 | 功能说明 |
|---|---|---|
| CentOS | 7.x | 基础Linux操作系统 |
| JDK | 1.8 | Java运行环境(支撑Hadoop生态) |
| ZooKeeper | 3.4.6 | 分布式系统协调服务 |
| Hadoop | 2.7.2 | 分布式计算框架(依赖ZooKeeper) |
| Hive | 2.2.0 | 大数据仓库工具 |
| HBase | 1.2.6 | 分布式NoSQL数据库 |
4. 数据目录规划
建议提前规划以下目录结构:
-
数据目录:
/opt/zookeeper/data- 存储事务日志和快照 -
日志目录:
/opt/zookeeper/logs- 存储运行日志 -
配置目录:
/opt/zookeeper/conf- 配置文件存放
二、Windows IP映射(开发环境)
在Windows本地开发时,修改C:\Windows\System32\drivers\etc\hosts文件,添加相同的IP映射,方便通过SSH工具或浏览器访问集群节点。
第二章 基础环境配置
一、网络配置
1. 常用网络命令
reset                    # 清屏
ifconfig                 # 查看IP地址(若无效执行:yum install net-tools)
hostname                 # 查看当前主机名
hostnamectl set-hostname hadoop1    # 永久修改主机名
ping www.baidu.com       # 测试外网连通性
dhclient                 # 临时获取IP地址
2. 虚拟机联网模式选择
| 模式 | 适用场景 | 特点 |
|---|---|---|
| 桥接模式 | 与宿主机同网段 | 虚拟机获得独立IP,可被局域网直接访问 |
| NAT模式 | 开发环境推荐 | 共享宿主机IP,通过端口映射实现访问 |
| 仅主机模式 | 生产环境隔离 | 完全隔离外部网络,确保系统安全 |
3. 永久联网配置(NAT模式)
# 进入网络配置目录
cd /etc/sysconfig/network-scripts/

# 编辑网卡配置文件(ens33为常见网卡名,根据实际情况调整)
vi ifcfg-ens33

# 修改以下关键配置
BOOTPROTO=static          # 改为静态IP
ONBOOT=yes               # 开机启动
IPADDR=172.16.206.16     # 设置静态IP
NETMASK=255.255.255.0    # 子网掩码
GATEWAY=172.16.206.1     # 网关地址
DNS1=8.8.8.8            # DNS服务器(Windows中ipconfig/all查看)

# 重启网络服务
systemctl restart network
4. 防火墙管理
systemctl start firewalld.service     # 启动防火墙
systemctl stop firewalld.service      # 关闭防火墙
systemctl disable firewalld           # 禁止开机启动(集群环境建议关闭)
firewall-cmd --state                  # 查看防火墙状态
二、时钟同步(NTP)
分布式系统中,时间同步是数据一致性的前提。ZooKeeper依赖时间戳进行事务排序,节点间时间偏差会导致严重问题。
1. 临时同步验证
# 向时间服务器同步(需安装ntpdate)
yum install ntpdate -y
ntpdate 192.168.1.128

# 看到类似以下输出表示成功:
# 5 Mar 22:26:19 ntpdate[8171]: step time server 192.168.1.128 offset 3045.561204 sec
2. 同步Internet时间
ntpdate time.nuri.net    # 亚洲NTP服务器
# 或
ntpdate cn.pool.ntp.org  # 中国NTP服务器池
4. 搭建集群内部NTP服务器
选一台节点作为时间服务器:
yum install ntp ntpdate -y

# 编辑NTP配置
vi /etc/ntp.conf

# 添加外部时间源
server 0.asia.pool.ntp.org
server 1.asia.pool.ntp.org
server 2.asia.pool.ntp.org
server 3.asia.pool.ntp.org

# 启动服务
systemctl start ntpd
systemctl enable ntpd

# 查看同步状态
ntpq -p
三、SSH免密登录
集群节点间需要频繁通信,配置免密登录是必要步骤。
# 1. 生成密钥对(所有节点执行)
ssh-keygen -t rsa
# 一路回车,密钥将保存在 ~/.ssh/ 目录

# 2. 查看生成的密钥
ls ~/.ssh/
# id_rsa(私钥)  id_rsa.pub(公钥)

# 3. 分发公钥到所有节点(包括自己)
ssh-copy-id hadoop1
ssh-copy-id hadoop2
ssh-copy-id hadoop3

# 4. 测试免密登录
ssh hadoop2
# 无需输入密码即成功
四、JDK安装与配置
# 1. 检查系统自带JDK
java -version
rpm -qa | grep java

# 2. 如有OpenJDK,建议卸载
rpm -e --nodeps java-1.8.0-openjdk*

# 3. 下载Oracle JDK 1.8
# 官网:http://www.oracle.com/technetwork/java/javase/downloads/index.html

# 4. 解压安装
tar -zxvf jdk-8uXXX-linux-x64.tar.gz -C /opt/

# 5. 配置环境变量
vi /etc/profile

# 添加以下内容
export JAVA_HOME=/opt/jdk1.8.0_XXX
export PATH=$JAVA_HOME/bin:$PATH
export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar

# 6. 生效配置
source /etc/profile
java -version
第三章 ZooKeeper核心原理
目录导航
Part 01 ZooKeeper概述
01、ZooKeeper简介
Apache ZooKeeper 是Apache软件基金会的顶级项目,官网描述为:
"致力于开发和维护实现高度可靠的分布式协调的开源服务器"
简单来说,ZooKeeper是一个为分布式应用提供一致性服务的协调工具。它的设计目标是将复杂且容易出错的分布式一致性服务封装起来,提供简单易用的接口。
典型应用场景:
-
Hadoop:NameNode HA(高可用)、YARN资源调度
-
HBase:Master选举、元数据管理
-
Kafka:Broker注册、Topic分区Leader选举
-
SolrCloud:集群状态管理、配置分发
02、ZooKeeper术语体系
| 运行模式 | 节点数量 | 适用场景 | 生产可用性 |
|---|---|---|---|
| 单机模式 | 1个节点 | 本地学习、功能验证 | ❌ 不推荐 |
| 伪分布式模式 | 1节点多进程 | 开发测试环境 | ❌ 不推荐 |
| 全分布式模式 | 3+奇数节点 | 生产环境部署 | ✅ 推荐 |
2. 集群角色详解
• Leader:负责处理所有写请求并协调事务
• Follower:处理读请求并参与投票选举
• Observer(可选):仅处理读请求,不参与投票
核心特性:
-
每个Server保存一份数据副本
-
全局数据保持一致性视图
-
更新请求按顺序执行(来自同一Client)
-
数据更新具有原子性(要么全成功,要么全失败)
3. 事务与一致性
理解事务前,必须先理解一致性:
一致性的核心是"看见"——谁能看见?能否看见?什么时候看见?
一致性级别分类:
| 级别 | 定义 | 示例 |
|---|---|---|
| 强一致性 | 写入成功后,所有读取操作都能立即获取最新数据 | ZooKeeper默认模式 |
| 弱一致性 | 写入成功后,部分读取操作可能无法立即获取最新数据 | 部分缓存系统 |
| 最终一致性 | 写入成功后,经过一定延迟后所有读取操作都能获取最新数据 | DNS、Cassandra |
ZooKeeper采用强一致性,确保分布式环境下的数据可靠性。
4. 原子广播机制(Zab协议)
Zab(ZooKeeper Atomic Broadcast)协议是ZooKeeper的核心,保证各Server间数据同步:
两种工作模式:
-
恢复模式(Recovery):Leader选举 + 数据同步
-
广播模式(Broadcast):正常处理客户端请求
工作流程:
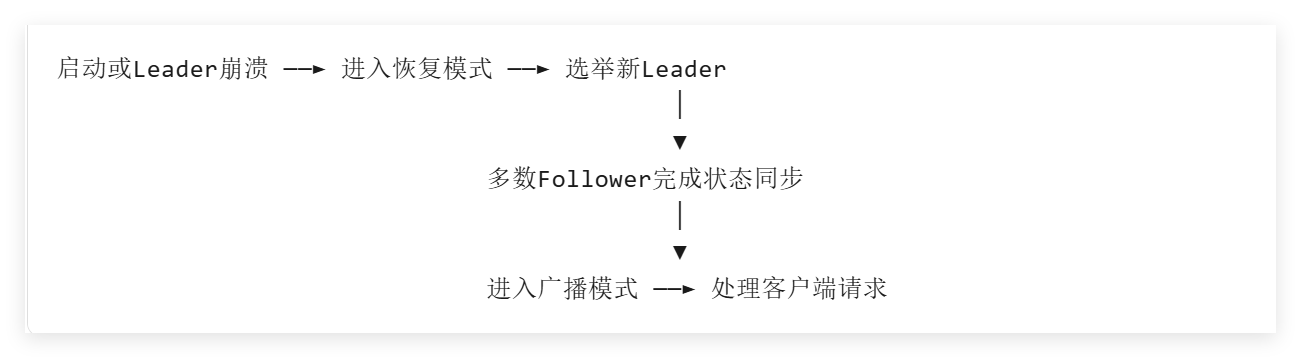
zxid(事务ID):
-
64位数字,高32位是epoch(Leader周期),低32位是递增计数
-
每个事务proposal都携带zxid,保证全局顺序性
5. Znode节点类型
ZooKeeper的数据模型是层次化的命名空间,类似Linux文件系统,但每个节点称为Znode。
Znode类型:
| 类型 | 标识 | 生命周期 | 子节点 |
|---|---|---|---|
| PERSISTENT | 默认 | 永久有效,需手动删除 | ✔️ 允许 |
| EPHEMERAL | -e | 随会话结束自动删除 | ✖️ 不允许 |
| PERSISTENT_SEQUENTIAL | -s | 永久有效且自动编号 | ✔️ 允许 |
| EPHEMERAL_SEQUENTIAL | -e -s | 临时有效且自动编号 | ✖️ 不允许 |
Part 02 ZooKeeper工作原理
01、数据写入流程(写请求处理)
详细步骤:
-
Client向Follower发送写请求
-
Follower将请求转发给Leader
-
Leader接收请求,发起投票(Proposal)
-
所有Follower进行投票(ACK)
-
Leader统计投票,过半数同意则提交(Commit)
-
Leader执行写入,通知Follower同步
-
Follower完成同步后,返回结果给Client
02、Follower核心功能
Follower节点承担四项关键职责:
-
与Leader通信:发送PING心跳、REQUEST请求、ACK确认、REVALIDATE会话验证
-
处理Leader消息:解析并执行Leader指令
-
接收Client请求:读请求直接处理,写请求转发给Leader
-
返回结果:将操作结果返回给Client
Follower处理的消息类型:
| 消息类型 | 功能描述 |
|---|---|
| PING | 心跳检测,保持连接活跃 |
| PROPOSAL | Leader发起的投票提案 |
| COMMIT | 确认事务提交 |
| UPTODATE | 通知同步已完成 |
| REVALIDATE | 返回会话验证结果 |
| SYNC | 触发强制数据同步 |
03、Leader选举流程
当集群启动或Leader崩溃时,Zab协议进入恢复模式,触发Leader选举:
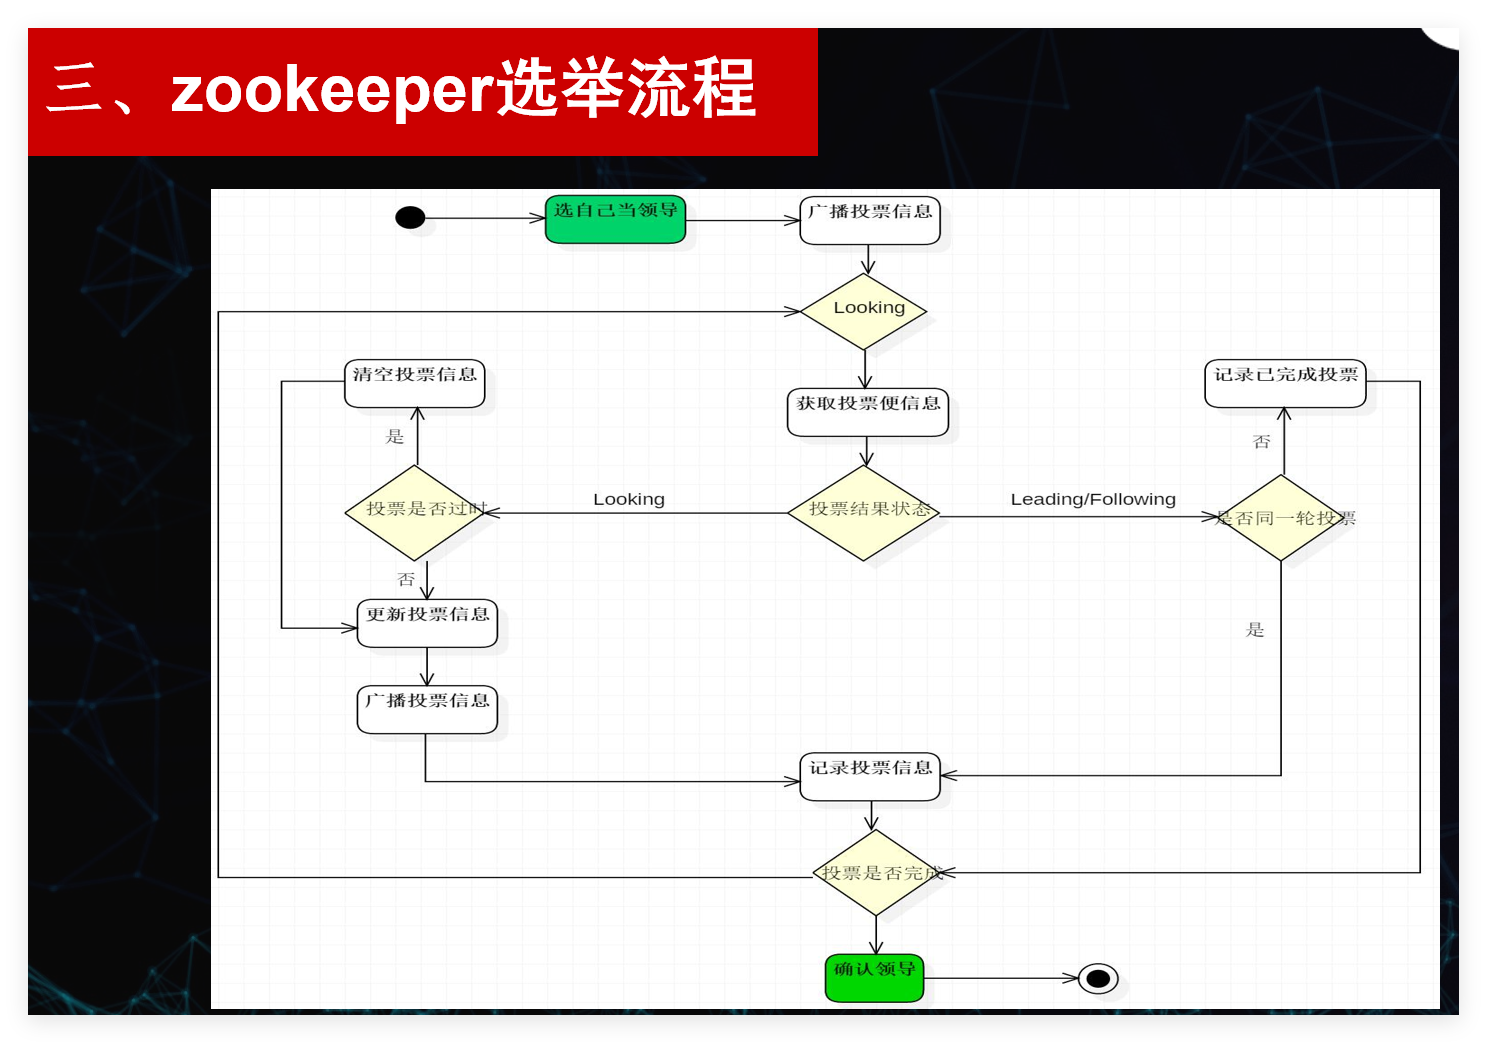
我来先查看您提供的参考文章,了解其内容和风格。
获取网页

1 个网页
我已经查看了参考文章,它是一篇关于ZooKeeper分布式协调的教程文章,结构清晰,内容详实。参考您上传的PPT课件和参考文章的风格,我为您撰写一篇适合发布在CSDN的完整技术文章。
ZooKeeper分布式协调服务详解:从原理到实战部署
摘要:本文系统讲解ZooKeeper分布式协调服务的核心概念、工作原理、数据一致性保障机制,以及完整的集群部署实践。作为Hadoop生态系统的核心组件,掌握ZooKeeper是理解分布式系统架构的关键一步。
关键词:ZooKeeper、分布式协调、Zab协议、Paxos算法、集群部署
第一章 环境规划与准备
一、规划内容
在搭建ZooKeeper集群之前,完整的环境规划是成功的关键。分布式系统的复杂性决定了我们必须从拓扑结构、主机规划、软件版本到数据目录进行全方位设计。
1. 集群拓扑(Master/Slave架构)
ZooKeeper集群采用经典的主从架构:
表格
| 角色 | 数量 | 职责 |
|---|---|---|
| Leader | 1个 | 负责所有写操作,协调事务提交 |
| Follower | 多个 | 处理读请求,参与Leader选举和事务投票 |
核心特点:
-
每个Server保存一份完整的数据副本
-
全局数据保持一致性视图
-
写请求必须由Leader处理,读请求可分散到任意节点
2. 主机规划
在/etc/hosts文件中配置IP映射,确保节点间可通过主机名通信:
bash
复制
# 编辑hosts文件
[root@hadoop1 ~]# vi /etc/hosts

# 添加以下配置
172.16.206.16   master
172.16.206.26   masterback
172.16.206.27   slave1
172.16.206.29   slave2
3. 软件规划清单
表格
| 软件 | 版本 | 说明 |
|---|---|---|
| CentOS | 7.x | Linux操作系统 |
| JDK | 1.8 | 基础运行环境(Hadoop生态基于Java开发) |
| ZooKeeper | 3.4.6 | 分布式协调服务核心 |
| Hadoop | 2.7.2 | 分布式计算框架(依赖ZK) |
| Hive | 2.2.0 | 数据仓库工具 |
| HBase | 1.2.6 | 分布式列式数据库 |
4. 数据目录规划
建议提前规划以下目录结构:
-
数据目录:
/opt/zookeeper/data- 存储事务日志和快照 -
日志目录:
/opt/zookeeper/logs- 存储运行日志 -
配置目录:
/opt/zookeeper/conf- 配置文件存放
二、Windows IP映射(开发环境)
在Windows本地开发时,修改C:\Windows\System32\drivers\etc\hosts文件,添加相同的IP映射,方便通过SSH工具或浏览器访问集群节点。
第二章 基础环境配置
一、网络配置
1. 常用网络命令
bash
复制
reset                    # 清屏
ifconfig                 # 查看IP地址(若无效执行:yum install net-tools)
hostname                 # 查看当前主机名
hostnamectl set-hostname hadoop1    # 永久修改主机名
ping www.baidu.com       # 测试外网连通性
dhclient                 # 临时获取IP地址
2. 虚拟机联网模式选择
表格
| 模式 | 适用场景 | 特点 |
|---|---|---|
| 桥接模式 | 与宿主机同网段 | 虚拟机拥有独立IP,局域网内可直接访问 |
| NAT模式 | 推荐开发环境 | 共享宿主机IP,通过端口映射访问 |
| 仅主机模式 | 生产环境隔离 | 完全隔离外网,保证安全性 |
3. 永久联网配置(NAT模式)
bash
复制
# 进入网络配置目录
cd /etc/sysconfig/network-scripts/

# 编辑网卡配置文件(ens33为常见网卡名,根据实际情况调整)
vi ifcfg-ens33

# 修改以下关键配置
BOOTPROTO=static          # 改为静态IP
ONBOOT=yes               # 开机启动
IPADDR=172.16.206.16     # 设置静态IP
NETMASK=255.255.255.0    # 子网掩码
GATEWAY=172.16.206.1     # 网关地址
DNS1=8.8.8.8            # DNS服务器(Windows中ipconfig/all查看)

# 重启网络服务
systemctl restart network
4. 防火墙管理
bash
复制
systemctl start firewalld.service     # 启动防火墙
systemctl stop firewalld.service      # 关闭防火墙
systemctl disable firewalld           # 禁止开机启动(集群环境建议关闭)
firewall-cmd --state # 查看防火墙状态生产环境建议:集群内部节点建议关闭防火墙,或通过
firewall-cmd开放2181、2888、3888等ZooKeeper端口。
二、时钟同步(NTP)
分布式系统中,时间同步是数据一致性的前提。ZooKeeper依赖时间戳进行事务排序,节点间时间偏差会导致严重问题。
1. 临时同步验证
bash
复制
# 向时间服务器同步(需安装ntpdate)
yum install ntpdate -y
ntpdate 192.168.1.128

# 看到类似以下输出表示成功:
# 5 Mar 22:26:19 ntpdate[8171]: step time server 192.168.1.128 offset 3045.561204 sec
2. 同步Internet时间
bash
复制
ntpdate time.nuri.net    # 亚洲NTP服务器
# 或
ntpdate cn.pool.ntp.org  # 中国NTP服务器池
3. 定时自动同步
bash
复制
crontab -e
# 添加以下行,每分钟同步一次
*/1 * * * * /usr/sbin/ntpdate time.nuri.net
4. 搭建集群内部NTP服务器
选一台节点作为时间服务器:
bash
复制
yum install ntp ntpdate -y

# 编辑NTP配置
vi /etc/ntp.conf

# 添加外部时间源
server 0.asia.pool.ntp.org
server 1.asia.pool.ntp.org
server 2.asia.pool.ntp.org
server 3.asia.pool.ntp.org

# 启动服务
systemctl start ntpd
systemctl enable ntpd

# 查看同步状态
ntpq -p
其他节点指向该服务器同步即可。
三、SSH免密登录
集群节点间需要频繁通信,配置免密登录是必要步骤。
bash
复制
# 1. 生成密钥对(所有节点执行)
ssh-keygen -t rsa
# 一路回车,密钥将保存在 ~/.ssh/ 目录

# 2. 查看生成的密钥
ls ~/.ssh/
# id_rsa(私钥)  id_rsa.pub(公钥)

# 3. 分发公钥到所有节点(包括自己)
ssh-copy-id hadoop1
ssh-copy-id hadoop2
ssh-copy-id hadoop3

# 4. 测试免密登录
ssh hadoop2
# 无需输入密码即成功
四、JDK安装与配置
bash
复制
# 1. 检查系统自带JDK
java -version
rpm -qa | grep java

# 2. 如有OpenJDK,建议卸载
rpm -e --nodeps java-1.8.0-openjdk*

# 3. 下载Oracle JDK 1.8
# 官网:http://www.oracle.com/technetwork/java/javase/downloads/index.html

# 4. 解压安装
tar -zxvf jdk-8uXXX-linux-x64.tar.gz -C /opt/

# 5. 配置环境变量
vi /etc/profile

# 添加以下内容
export JAVA_HOME=/opt/jdk1.8.0_XXX
export PATH=$JAVA_HOME/bin:$PATH
export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar

# 6. 生效配置
source /etc/profile
java -version
第三章 ZooKeeper核心原理
目录导航
Part 01 ZooKeeper概述
01、ZooKeeper简介
Apache ZooKeeper 是Apache软件基金会的顶级项目,官网描述为:
"致力于开发和维护实现高度可靠的分布式协调的开源服务器"
简单来说,ZooKeeper是一个为分布式应用提供一致性服务的协调工具。它的设计目标是将复杂且容易出错的分布式一致性服务封装起来,提供简单易用的接口。
典型应用场景:
-
Hadoop:NameNode HA(高可用)、YARN资源调度
-
HBase:Master选举、元数据管理
-
Kafka:Broker注册、Topic分区Leader选举
-
SolrCloud:集群状态管理、配置分发
02、ZooKeeper术语体系
1. 三种部署模式
表格
| 模式 | 节点数 | 适用场景 | 生产可用性 |
|---|---|---|---|
| 单机模式 | 1台 | 本地学习、功能测试 | ❌ 不可用 |
| 伪分布式模式 | 1台(多进程) | 开发测试 | ❌ 不可用 |
| 全分布式模式 | 3+台(奇数) | 生产环境 | ✅ 推荐 |
2. 集群角色详解
plain
复制
┌─────────────────────────────────────────┐
│           ZooKeeper 集群架构            │
├─────────────────────────────────────────┤
│                                         │
│    ┌─────────┐      ┌─────────┐       │
│    │ Leader  │◄────►│Follower │       │
│    │  (主)   │      │  (从)   │       │
│    └────┬────┘      └────┬────┘       │
│         │                │              │
│         └────────┬───────┘              │
│                  ▼                      │
│           ┌─────────┐                  │
│           │Follower │                  │
│           │  (从)   │                  │
│           └─────────┘                  │
│                                         │
│  • Leader:处理所有写请求,协调事务      │
│  • Follower:处理读请求,参与投票选举    │
│  • Observer:(可选)只读,不参与投票    │
└─────────────────────────────────────────┘核心特性:
-
每个Server保存一份数据副本
-
全局数据保持一致性视图
-
更新请求按顺序执行(来自同一Client)
-
数据更新具有原子性(要么全成功,要么全失败)
3. 事务与一致性
理解事务前,必须先理解一致性:
一致性的核心是"看见"——谁能看见?能否看见?什么时候看见?
一致性级别分类:
表格
| 级别 | 定义 | 示例 |
|---|---|---|
| 强一致性 | 写成功后,所有读操作立即可见 | ZooKeeper默认模式 |
| 弱一致性 | 写成功后,部分读操作可能不可见 | 某些缓存系统 |
| 最终一致性 | 写成功后,经过一段时间所有读操作可见 | DNS、Cassandra |
ZooKeeper采用强一致性,确保分布式环境下的数据可靠性。
4. 原子广播机制(Zab协议)
Zab(ZooKeeper Atomic Broadcast)协议是ZooKeeper的核心,保证各Server间数据同步:
两种工作模式:
-
恢复模式(Recovery):Leader选举 + 数据同步
-
广播模式(Broadcast):正常处理客户端请求
工作流程:
plain
复制
启动或Leader崩溃 ──► 进入恢复模式 ──► 选举新Leader
                                           │
                                           ▼
                              多数Follower完成状态同步
                                           │
                                           ▼
进入广播模式 ──► 处理客户端请求zxid(事务ID):
-
64位数字,高32位是epoch(Leader周期),低32位是递增计数
-
每个事务proposal都携带zxid,保证全局顺序性
5. Znode节点类型
ZooKeeper的数据模型是层次化的命名空间,类似Linux文件系统,但每个节点称为Znode。
Znode类型:
表格
| 类型 | 标识 | 生命周期 | 子节点 |
|---|---|---|---|
| PERSISTENT | 默认 | 永久存在,需手动删除 | 允许 |
| EPHEMERAL | -e | 随Session结束自动删除 | ❌ 不允许 |
| PERSISTENT_SEQUENTIAL | -s | 永久 + 自动编号 | 允许 |
| EPHEMERAL_SEQUENTIAL | -e -s | 临时 + 自动编号 | ❌ 不允许 |
Part 02 ZooKeeper工作原理
01、数据写入流程(写请求处理)
plain
复制
┌─────────┐     1.写请求      ┌─────────┐
│ Client  │ ────────────────► │Follower │
└─────────┘                   └────┬────┘
                                   │
                                   │ 2.转发
                                   ▼
                            ┌─────────┐
                            │ Leader  │
                            └────┬────┘
                                   │
                    ┌──────────────┼──────────────┐
                    │              │              │
                    ▼              ▼              ▼
              3.发起投票     4.Follower投票    5.统计结果
              (Proposal)      (ACK)           (Commit)
                    │              │              │
                    └──────────────┴──────────────┘
                                   │
                                   ▼
                            6.写入数据
                            7.通知Follower同步
                                   │
                                   ▼
                            ┌─────────┐
                            │Follower │──► 8.返回结果给Client
└─────────┘详细步骤:
-
Client向Follower发送写请求
-
Follower将请求转发给Leader
-
Leader接收请求,发起投票(Proposal)
-
所有Follower进行投票(ACK)
-
Leader统计投票,过半数同意则提交(Commit)
-
Leader执行写入,通知Follower同步
-
Follower完成同步后,返回结果给Client
02、Follower核心功能
Follower节点承担四项关键职责:
-
与Leader通信:发送PING心跳、REQUEST请求、ACK确认、REVALIDATE会话验证
-
处理Leader消息:解析并执行Leader指令
-
接收Client请求:读请求直接处理,写请求转发给Leader
-
返回结果:将操作结果返回给Client
Follower处理的消息类型:
表格
| 消息类型 | 作用 |
|---|---|
| PING | 心跳检测,维持连接活性 |
| PROPOSAL | Leader发起的投票提案 |
| COMMIT | 事务提交确认 |
| UPTODATE | 同步完成通知 |
| REVALIDATE | 会话验证结果 |
| SYNC | 强制数据同步 |
03、Leader选举流程
当集群启动或Leader崩溃时,Zab协议进入恢复模式,触发Leader选举:
plain
复制
┌─────────────────────────────────────────────────────────┐
│                    Leader选举流程                        │
├─────────────────────────────────────────────────────────┤
│                                                         │
│  1. 每个Server启动后进入LOOKING状态,推荐自己为Leader    │
│                                                         │
│  2. 交换投票信息:(myid, zxid)                           │
│     • myid:服务器唯一标识                               │
│     • zxid:最新事务ID(越大表示数据越新)                │
│                                                         │
│  3. 比较规则:                                           │
│     • 先比较zxid,zxid大的优先                           │
│     • zxid相同,比较myid,myid大的优先                   │
│                                                         │
│  4. 每轮投票后统计,获得半数以上选票的Server成为Leader     │
│                                                         │
│  5. 新Leader等待Follower连接,进行数据同步                │
│                                                         │
│  6. 同步完成后,集群进入广播模式,开始对外服务             │
│                                                         │
└─────────────────────────────────────────────────────────┘选举示例(5节点集群):
-
节点A(zxid=100, myid=1)、B(zxid=100, myid=2)、C(zxid=101, myid=3)
-
第一轮投票:各投自己
-
第二轮:节点发现C的zxid最大,改投C
-
C获得3票(过半),成为Leader
Part 03 数据一致性与Paxos算法
01、一致性保障原则
分布式系统中,保持数据一致性的核心思路:
如果各节点的初始状态一致,每个节点执行相同的操作序列,那么最终能得到一致的状态。
Master-Slave模式的问题:
-
单点Master存在性能瓶颈
-
Master故障会导致服务中断
-
多Master又面临数据冲突
02、Paxos算法
Paxos算法是解决分布式一致性问题的经典方案,ZooKeeper的选举机制受其启发。
核心思想:
┌────────────────────────────────────────┐
│ Paxos投票机制 │
├────────────────────────────────────────┤
│ │
│ • 同一时刻,只有一个写操作被批准 │
│ • 并发的写操作竞争选票 │
│ • 获得过半数选票(>n/2)的写操作生效 │
│ • 未获胜的写操作进入下一轮投票 │
│ │
│ 优势:任何节点挂掉(≤n/2)不影响一致性 │
│ │
└────────────────────────────────────────┘
为什么ZooKeeper集群通常为奇数?
| 集群规模 | 容错能力 | 最小存活节点 | 资源效率 |
|---|---|---|---|
| 3节点 | 1节点故障 | 2节点 | 高 |
| 4节点 | 1节点故障 | 3节点 | 较低(与3节点相同) |
| 5节点 | 2节点故障 | 3节点 | 高 |
| 6节点 | 2节点故障 | 4节点 | 较低(与5节点相同) |
Part 04 ZooKeeper数据模型
01、数据模型结构
ZooKeeper采用树形层次结构,与Linux文件系统类似
每个Znode包含三部分:
05、Watcher监听机制
ZooKeeper提供事件监听功能,实现发布/订阅模式:
Session(会话):
-
stat:版本、权限、时间戳等元数据
-
data:关联的数据内容(最大1MB)
-
children:子节点列表
# 1. 连接ZooKeeper服务器
bin/zkCli.sh -server 192.168.58.99:2181

# 2. 查看根节点子节点
ls /
ls /zookeeper

# 3. 创建节点(必须携带数据)
create /hello "world"
create /app1 "application1"

# 4. 获取节点数据和状态
get /hello

# 5. 创建临时节点(-e参数)
create -e /temp "temporary_data"

# 6. 创建顺序节点(-s参数)
create -s /seq/item "data"
# 实际创建:/seq/item0000000001

# 7. 删除节点
delete /hello        # 无子节点时
deleteall /app1      # 递归删除(含子节点)

# 8. 设置监听(watch)
ls /hello true       # 监听子节点变化和删除
get /hello true      # 监听数据变化和删除
03、节点状态详解
执行
get /hello返回的完整信息:[zk: localhost:2181(CONNECTED) 1] get /hello world # 节点数据 cZxid = 0x1e00000075 # 创建时的事务ID ctime = Tue Aug 21 23:42:08 PDT 2018 # 创建时间戳 mZxid = 0x1e00000075 # 最后修改的事务ID mtime = Tue Aug 21 23:42:08 PDT 2018 # 最后修改时间戳 pZxid = 0x1e00000075 # 最后子节点修改的zxid cversion = 0 # 子节点版本号(修改次数) dataVersion = 0 # 数据版本号 aclVersion = 0 # ACL版本号 ephemeralOwner = 0x0 # 临时节点所属会话ID(0x0表示持久节点) dataLength = 5 # 数据长度 numChildren = 0 # 子节点数量04、zxid与Session机制
zxid(ZooKeeper Transaction Id):
-
64位整数,全局唯一且递增
-
高32位:epoch(Leader周期号,每次选举+1)
-
低32位:计数器(单调递增)
-
作用:标识事务顺序,保证全局一致性
-
Client与Server间的TCP长连接
-
会话有超时时间(默认tickTime * 2)
-
会话结束会自动删除该Client创建的所有临时节点
-
支持会话恢复(断线重连后恢复)
Watcher事件类型:
NodeCreated:节点创建
NodeDeleted:节点删除
NodeDataChanged:数据修改
NodeChildrenChanged:子节点列表变化
Part 05 其他重要概念
01、Observer角色
为解决集群扩展性问题,ZooKeeper引入Observer:
| 特性 | Leader | Follower | Observer |
|---|---|---|---|
| 处理读请求 | ✅ | ✅ | ✅ |
| 处理写请求 | ✅ | 转发 | 转发 |
| 参与投票 | ✅ | ✅ | ❌ |
| 参与选举 | ✅ | ✅ | ❌ |
优势:
增加Observer可线性扩展读性能
不影响写性能(不参与投票)
02、ZooKeeper核心特性总结
-
-
适合读多写少的场景
-
| 特性 | 说明 |
|---|---|
| 顺序一致性 | 同一Client的请求按发送顺序执行 |
| 原子性 | 事务要么全成功,要么全失败 |
| 单一视图 | 无论连接哪个Server,数据视图一致 |
| 可靠性 | 事务一旦提交,状态变更永久保留 |
| 实时性 | 保证客户端最终能读到最新数据(非即时) |
03、ZooKeeper在Hadoop中的应用
| 组件 | 应用场景 |
|---|---|
| HDFS HA | NameNode主备切换、元数据同步 |
| YARN | ResourceManager HA |
| HBase | Master选举、RegionServer注册、元数据管理 |
| Kafka | Broker注册、Controller选举、Topic配置 |
Part 06 ZooKeeper部署实践
01、安装前准备
Hadoop分布式集群环境搭建是入门者的常见痛点,环境配置问题往往导致集群无法正常启动。因此,正式部署前的规划至关重要。
02、配置文件详解
ZooKeeper配置非常简单,各节点zoo.cfg内容相同,仅myid文件不同。
03、集群操作命令
# 1. 启动ZooKeeper(所有节点执行)
[root@hadoop1 ~]# zkServer.sh start
[root@hadoop2 ~]# zkServer.sh start
[root@hadoop3 ~]# zkServer.sh start

# 2. 查看启动状态
[root@hadoop1 ~]# zkServer.sh status
# 输出示例:
# ZooKeeper JMX enabled by default
# Using config: /opt/zookeeper/bin/../conf/zoo.cfg
# Mode: follower    # 或 Mode: leader

# 3. 停止服务
zkServer.sh stop

# 4. 重启服务
zkServer.sh restart

# 5. 前台启动(调试时使用)
zkServer.sh start-foreground启动成功标志:
-
一个节点显示
Mode: leader -
其他节点显示
Mode: follower
04、客户端连接测试
# 连接集群
zkCli.sh -server hadoop1:2181,hadoop2:2181,hadoop3:2181

# 验证集群状态
[zk: hadoop1:2181(CONNECTED) 0] ls /
[zookeeper]

[zk: hadoop1:2181(CONNECTED) 1] create /test "hello"
Created /test

[zk: hadoop1:2181(CONNECTED) 2] get /test
hello
总结
本文从环境规划、基础配置到核心原理、部署实践,系统性地讲解了ZooKeeper分布式协调服务
掌握ZooKeeper是理解Hadoop生态系统乃至分布式系统架构的重要基础。建议读者在理解原理的基础上,动手搭建3节点集群,通过实际操作加深对分布式协调服务的理解。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)