InfluxDB(一)——一个高效处理数据的时序数据库
目录
一、什么是时序数据库InfluxDB?
先了解一个概念“时序”,顾名思义就是按照时间序列排序的数据,InfluxDB就是专门为高效存储、查询和分析这类带时间戳的海量数据而设计的时序数据库(Time-Series Database),这种数据在物联网、监控系统、金融分析等领域非常常见。
生活中,随处可见“按时间记录”的数据,手机每小时的电量变化,空调的实时温度,小区充电桩的充电时长,服务器的运行状态……这些按照时间顺序排列,持续产生的数据被称为“时序数据”。随着数据越来越多,面对海量时序数据时,普通关系型数据库(MySQL)处理起来会显得力不从心,甚至成为系统瓶颈。存在几个天然劣势:
- 写入性能不足:当时序数据以每秒成千上万条的速度涌入(设备运行数据高频上报),MySQL的索引维护和事务锁机制导入写入速度急剧下降
- 存储效率低:为了支持灵活查询,关系数据库的行存储结构在处理大量重复的时间戳和标签时,占用空间远大于转为时序优化的列式存储
这句话可能不好理解,使用一个例子:空调的温湿度传感器sensor_01,每隔 1s上报一次数据。数据库字段有时间戳、设备SN(sensor_01)、温度值连续 5 秒的数据:
2026-03-25 10:00:01, sensor_01, 25.1
2026-03-25 10:00:02, sensor_01, 25.2
2026-03-25 10:00:03, sensor_01, 25.1
2026-03-25 10:00:04, sensor_01, 25.3
2026-03-25 10:00:05, sensor_01, 25.2
……
关系型数据库(行式存储)是怎么存的?
原理:它把每一行数据当作一个完整的整体(对象)存进去。就像把每份文件单独装进一个信封。
- 第1行:[
2026-03-25 10:00:01,sensor_01,25.1] -> 存入磁盘 - 第2行:[
2026-03-25 10:00:02,sensor_01,25.2] -> 存入磁盘 - 第3行:[
2026-03-25 10:00:03,sensor_01,25.1] -> 存入磁盘 - ...以此类推
问题所在(为什么效率低):
你会发现,sensor_01 这个标签在每一行里都重复存储了一遍。
如果有 100 万个数据点,sensor_01 这个字符串就在磁盘上重复写了 100 万次!
- 时间戳:虽然每秒在变,但前缀(年月日时)也是大量重复的。
- 结果:大量的磁盘空间被用来存储重复的元数据(标签和时间前缀),而不是有价值的数值。这就像写文章时,每一句话前面都强行加一遍作者的名字,非常浪费纸张
时序数据库(列式存储)是怎么存的?
原理:它不按“行”存,而是按“列”存。它把相同类型的数据放在一起。就像把图书馆的书按“作者”、“出版年份”、“书名”分开放在不同的架子上。
它会这样处理上面的数据:
- 时间戳列(time):专门存时间。
[01, 02, 03, 04, 05](它甚至只存差值,比如 +1, +1, +1,极度压缩)
- 标签列(Tag):专门存设备SN。
[sensor_01, sensor_01, sensor_01, sensor_01, sensor_01]- 关键点:因为这一列全是
sensor_01,压缩算法(如游程编码 RLE)会发现:“哦,连续 5 个都是同一个词”,于是它只存一次sensor_01加上一个计数5。 - 存储结果:实际上只占用了极小的空间。
- 数值列(Field):专门存温度。
[25.1, 25.2, 25.1, 25.3, 25.2](使用专门针对浮点数的压缩算法,如 Gorilla 编码,利用相邻数值的相似性进行压缩)
优势所在:
- 去重:重复的标签只存一次(或存一次+计数)。
- 压缩:连续的时间戳和相似的数值可以被压缩到极小(通常能压缩到原始大小的 1/10 甚至 1/20)。
- 时间聚合查询慢:当需要查询“过去一个月的平均问题”或“最近一小时的流量峰值”时,MySQL需要扫描大量行并进行实时计算,响应延迟高;而InfluxDB内置了针对时间串口的预计算和压缩算法,能毫秒级返回结果
- 缺乏生命周期管理:时序数据往往“越久越不值钱”,需要自动过期删除。在MySQL中这需要编写复杂的定时任务,而InfluxDB中只需要一个简单的保留策略(Retention Policy)即可自动完成
从上就可以简单的了解时序数据库InfluxDB
InfluxDB是一种开源的时序数据库,由InfluxData公司开发。它专为高性能地存储、查询和分析时间序列数据而优化,支持高写入和查询负载,适用于实时监控、指标收集等场景。
小记:
有人可能会联想MongoDB这种文档数据库,曾经也使用过将物联网数据存储到MongoDB中,可以先参考一下这篇时序数据库一哥 InfluxDB 的公司 InfluxData,曾在 2018 年发表了一篇关于 InfluxDB vs MongoDB 的博客。文中使用 InfluxDB v1.7.2 和 MongoDB v4.0.4 做对比,得出 InfluxDB 比 MongoDB 快 2.4 倍的结论。当然可信度有待考量
先不赘述,后面再详解MongoDB和时序数据库的区别,可以自行了解
二、InfluxDB的特点
其核心特点可以概括为“高写入、高压缩、快查询、易管理”。以下是其详细的技术特点:
1. 极致的写入性能
- 追加写模型 (Append-Only):针对时序数据“只增不改”的特性,InfluxDB 采用日志结构合并树(LSM-Tree)的变体,数据直接顺序写入磁盘,避免了传统关系型数据库的行锁竞争和随机 I/O 开销。
- 高并发支持:能够轻松应对每秒数百万甚至上千万个数据点的写入压力,非常适合物联网传感器、服务器监控日志等高频数据流场景。
2. 高效的存储压缩
- 列式存储:数据按列(时间戳、标签、字段)分别存储,而非按行存储。这使得相同类型的数据(如连续的温度值)聚集在一起,极大地提高了压缩效率。
- 专用压缩算法:
- 时间戳:使用差分编码(只存时间差),因为时间通常是均匀递增的。
- 标签 (Tags):使用游程编码,因为元数据(如设备ID)在一段时间内是高度重复的。
- 数值 (Fields):使用Gorilla 压缩等算法处理浮点数。
- 效果:通常能将原始数据压缩至 1/10 甚至 1/20 的大小,显著降低存储成本。
3. 独特的数据模型
InfluxDB 将数据分为四类,这种设计是其高性能的关键:
- Measurement (测量):类似关系数据库中的“表”,表示数据的类别(如
air_tem)。 - Tag (标签):被索引的元数据(如
device_sn=sensor_01)。Tag 用于快速过滤和分组查询,是查询速度的核心。 - Field (字段):未被索引的实际数值(如
tempature=0.25.1)。Field 存储具体测量值,支持各种聚合计算。 - Timestamp (时间戳):每条记录的主键,精确到纳秒。
先大概了解一下,后续会仔细讲述
InfluxDB 的数据模型概念和 RDBMS 稍有不同,下面是和 MySQL 的概念对照表
| InfluxDB | MySQL | 解释 |
| Buckets | Database | 数据桶-数据库,即存储数据的命名空间。 |
| Measurement | Table | 度量-表。 |
| Point | Record | 数据点-记录。 |
| Field | Field | 未设置索引的字段。 |
| Tag | Index | 设置了索引的字段。 |
4. 强大的查询与分析能力
- 双语言支持:
- InfluxQL:类 SQL 语法,简单易学,适合常规的时间范围查询和聚合。
- Flux:一种功能更强大的函数式脚本语言(类似 Python/Pandas),支持复杂的数据转换、多源连接(Join)、自定义逻辑和跨时间窗口分析。
- 内置时间函数:原生支持降采样)、插值、移动平均、异常检测等时间序列专用操作,无需在应用层编写复杂代码。
5. 自动化的数据生命周期管理
- 保留策略:可配置数据自动过期时间(例如“只保留最近 7 天的原始数据”),系统后台自动清理,防止磁盘爆满。
- 连续查询 :支持后台自动执行预定义的聚合任务,将高频原始数据实时计算并存储为低频汇总数据(如“每分钟平均值”),实现冷热数据分层存储,兼顾细节与历史趋势
6. 版本特性
先了解一下InfluxDB的版本,有1.x、2.x和3.x
| 特性维度 | InfluxDB 1.x | InfluxDB 2.x | InfluxDB 3.x (Core/Cloud) |
|---|---|---|---|
| 发布时间 | 2016 - 2020 (主流) | 2020 - 2024 (主流) | 2024 - 至今 (最新) |
| 开发语言 | Go | Go | Rust |
| 核心架构 | 单体架构,行式存储 | 单体架构 (集成UI/API/Engine),行式存储 | 云原生架构,列式存储,存算分离 |
| 存储引擎 | TSM (Time Structured Merge Tree) | TSM / TSMB | Apache Arrow (内存), Parquet (磁盘/对象存储) |
| 查询引擎 | 自研引擎 | 自研引擎 | Apache DataFusion (向量化执行) |
| 主要查询语言 | InfluxQL (类SQL) | Flux (函数式脚本,复杂但灵活) | SQL (标准ANSI SQL), InfluxQL (兼容), 不支持 Flux |
| 数据模型 | Measurement, Tag, Field, Time | Bucket, Measurement, Tag, Field, Time | Table, Column (强类型), Time |
| 基数限制 | 有 (高基数易导致 OOM) | 有 (虽优化但仍受限于内存) | 无限制 (支持无限基数/高势数据) |
| 存储后端 | 本地磁盘 | 本地磁盘 | 本地磁盘 或 对象存储 (S3, GCS, Azure Blob) |
| 用户界面 (UI) | 简单,需配合 Grafana | 内置强大 UI (可视化/告警/任务) | 简化 UI (侧重管理),推荐对接外部 BI/Grafana |
| 部署模式 | 二进制/Docker (开源版无集群) | 二进制/Docker (开源版无集群,企业版有集群) | 单节点高性能 (Core), 分布式集群 (Cloud/Enterprise) |
| 扩展性 | 弱 (主要靠垂直扩展) | 中 (垂直扩展为主) | 极强 (水平扩展,PB级数据支持) |
| 生态集成 | Grafana (黄金搭档) | 内置可视化,支持 Grafana | 完美支持 SQL 工具 (DBeaver, Tableau等), Grafana |
| 适用场景 | 传统监控、中小规模时序数据 | 全栈监控、需要内置可视化的场景 | 大规模物联网、金融分析、PB级日志、云原生环境 |
| 当前状态 | 维护模式 (不再新增功能) | 成熟稳定 (主流使用版本) | 快速迭代 (未来方向,Core版免费开源) |
可以了解到常规监控、IoT 等中小规模场景,优先选择稳定成熟、生态完善的 2.x 开源版,新项目、海量时序数据、高基数设备、需要标准 SQL 或低成本对象存储的云原生场景,直接选用架构更先进、性能与成本优势更明显的 3.x 系列
7. 业务场景选型
可以根据业务场景选择关系数据库MySQL或时序数据库InfluxDB等等
| 场景类型 | 推荐方案 | 原因 |
|---|---|---|
| 物联网设备数据上报(智能家居、工业传感器) | InfluxDB | 海量时序点、超高写入吞吐、自动过期策略、高压缩比、按时间聚合极快 |
| 应用 / 服务器监控(CPU、内存、接口耗时、QPS) | InfluxDB + Grafana | 天然时序模型,支持降采样 / 连续查询,与可视化生态无缝对接 |
| 日志时序检索、链路追踪指标 | InfluxDB | 写入量大、按时间筛选为主、标签索引高效,不适合全文检索 |
| 金融行情数据(股票、币价、K 线) | InfluxDB 3.x/ 专业时序库 | 高基数、高并发、列式存储,支持类 SQL 查询,适合时序行情 |
| 金融交易流水、账户余额、核心账务 | MySQL / PostgreSQL | 必须强事务 ACID、对账精确、可回滚、多表关联、数据一致性优先 |
| 用户订单、支付、商品、会员、权限 | MySQL / PostgreSQL | 业务关系复杂,需要事务、联表查询、复杂条件更新 |
| 配置信息、字典表、元数据 | MySQL | 数据量小、结构固定、随机查询 / 修改频繁 |
| 后台管理系统、ERP、CRM、CMS | MySQL | 通用关系型业务,生态完善,开发与运维成本低 |
| 临时测试、小规模数据、个人项目 | 两者皆可 | 数据量小性能差异不明显,按团队技术栈选择 |
总结:为什么选择 InfluxDB?
| 场景需求 | 传统关系型数据库 (MySQL) | InfluxDB |
|---|---|---|
| 写入速度 | 慢(受限于索引更新和事务) | 极快(顺序写,无事务锁) |
| 存储空间 | 大(行存,冗余多) | 极小(列存,高压缩) |
| 时间查询 | 需建立复杂索引,慢 | 原生支持,毫秒级响应 |
| 数据管理 | 需手动删除旧数据 | 自动过期,自动降采样 |
一句话总结:InfluxDB 是通过牺牲通用事务能力(不支持复杂 Join 和强事务),换取了时序数据领域极致的写入性能、存储效率和查询速度
三、安装InfluxDB
influxDB支持MacOS、Windows、Linux、Docker等下载安装,此处使用Docker安装,可以在DcokerHub上查询核实的版本,此处使用InfluxDB 2.x
因为本人从事物联网行业,当选文章选择InfluxDB 2.x,可以根据上述自行选择Influx版本
官方文档: https://docs.influxdata.com/influxdb/v2.7/,建议获取2.0版本以上的,自带监控UI
1. 拉取InfluxDB 2.x 镜像
推荐拉取稳定版(如 2.7.x),也可使用 latest 获取最新版:
# 拉取指定稳定版
docker pull influxdb:2.7.5
# 或拉取最新版
# docker pull influxdb:latest
2. 创建数据持久化目录
启动时自动创建管理员账号、组织、数据桶、Token,无需手动初始化
单机部署时,需要挂载到本地文件夹下,将数据持久化到宿主机,删除容器不丢数据
先在 Mac 本地创建数据 / 配置目录(避免权限问题):
mkdir -p ~/dev/influxdb2/data
mkdir -p ~/dev/influxdb2/config
3. 启动InfluxDB
可自行替换自定义参数:用户名、密码、组织、桶名(相当于Mysql的数据库名)
docker run -d \
  --name influxdb2 \
  --restart always \
  -p 8086:8086 \
  -v ~/dev/influxdb2/data:/var/lib/influxdb2 \
  -v ~/dev/influxdb2/config:/etc/influxdb2 \
  -e DOCKER_INFLUXDB_INIT_MODE=setup \
  -e DOCKER_INFLUXDB_INIT_USERNAME=admin \
  -e DOCKER_INFLUXDB_INIT_PASSWORD=Admin@123456 \
  -e DOCKER_INFLUXDB_INIT_ORG=echola-org \
  -e DOCKER_INFLUXDB_INIT_BUCKET=echola-bucket \
  -e DOCKER_INFLUXDB_INIT_RETENTION=30d \
  influxdb:2.7.5

#简写一行
# docker run -d --name influxdb2 --restart always -p 8086:8086 -v ~/dev/influxdb2/data:/var/lib/influxdb2 -v ~/dev/influxdb2/config:/etc/influxdb2 -e DOCKER_INFLUXDB_INIT_MODE=setup -e DOCKER_INFLUXDB_INIT_USERNAME=admin -e DOCKER_INFLUXDB_INIT_PASSWORD=Admin@123456 -e DOCKER_INFLUXDB_INIT_ORG=echola-org -e DOCKER_INFLUXDB_INIT_BUCKET=echola-bucket -e DOCKER_INFLUXDB_INIT_RETENTION=30d influxdb:2.7.5
参数说明:
--restart always:Docker 重启时自动启动容器。-p 8086:8086:映射宿主机 8086 端口(InfluxDB 默认端口)InfluxData。-v:挂载宿主机目录到容器,实现数据持久化。DOCKER_INFLUXDB_INIT_RETENTION=30d:数据保留 30 天(可自定义,如1w1 周、0永久,海量测试数据不建议长期保留)
4. 验证InfluxDB运行状态
# 查看运行中的容器
docker ps
# 查看容器日志(排查问题)
docker logs influxdb2
容器管理:
# 停止容器
docker stop influxdb2
# 启动容器
docker start influxdb2
# 重启容器
docker restart influxdb2
# 删除容器(先停止)
docker rm influxdb2
5. 访问InfluxDB Web UI
打开浏览器,访问:http://localhost:8086,使用刚才配置的账号密码访问InfluxDB
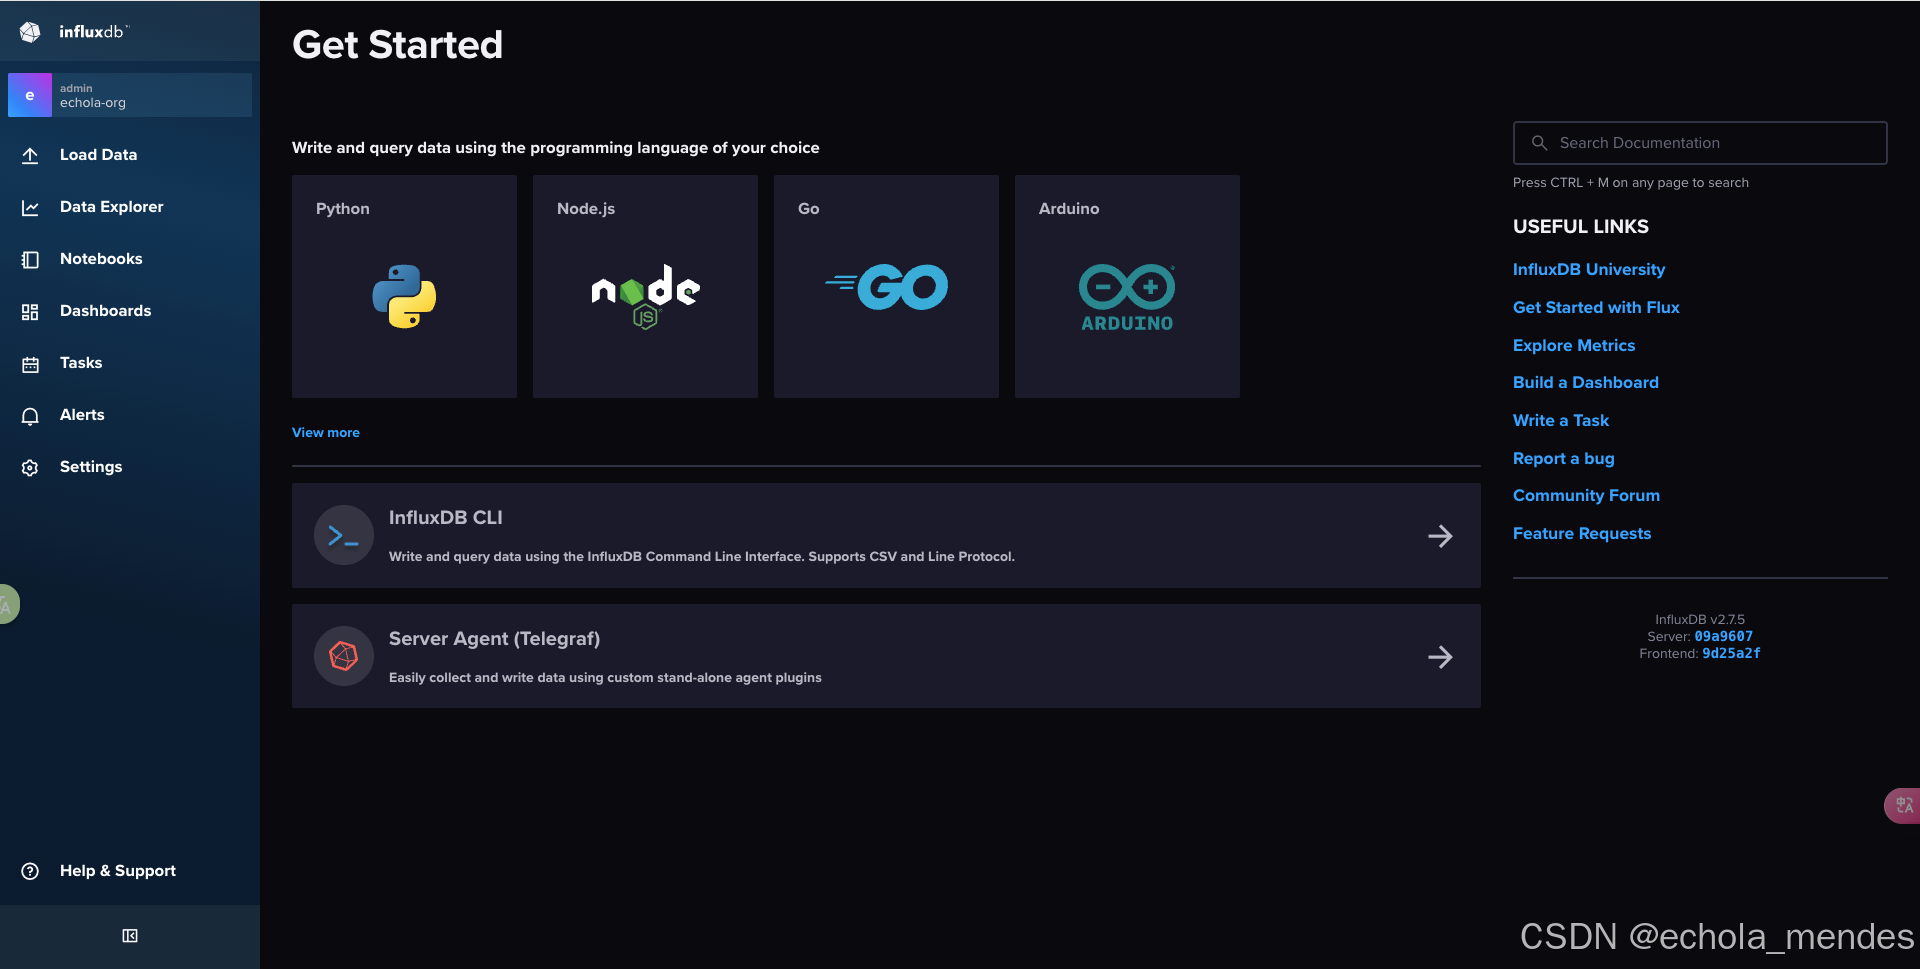
进入之后,就是当前界面,可以进行数据导入
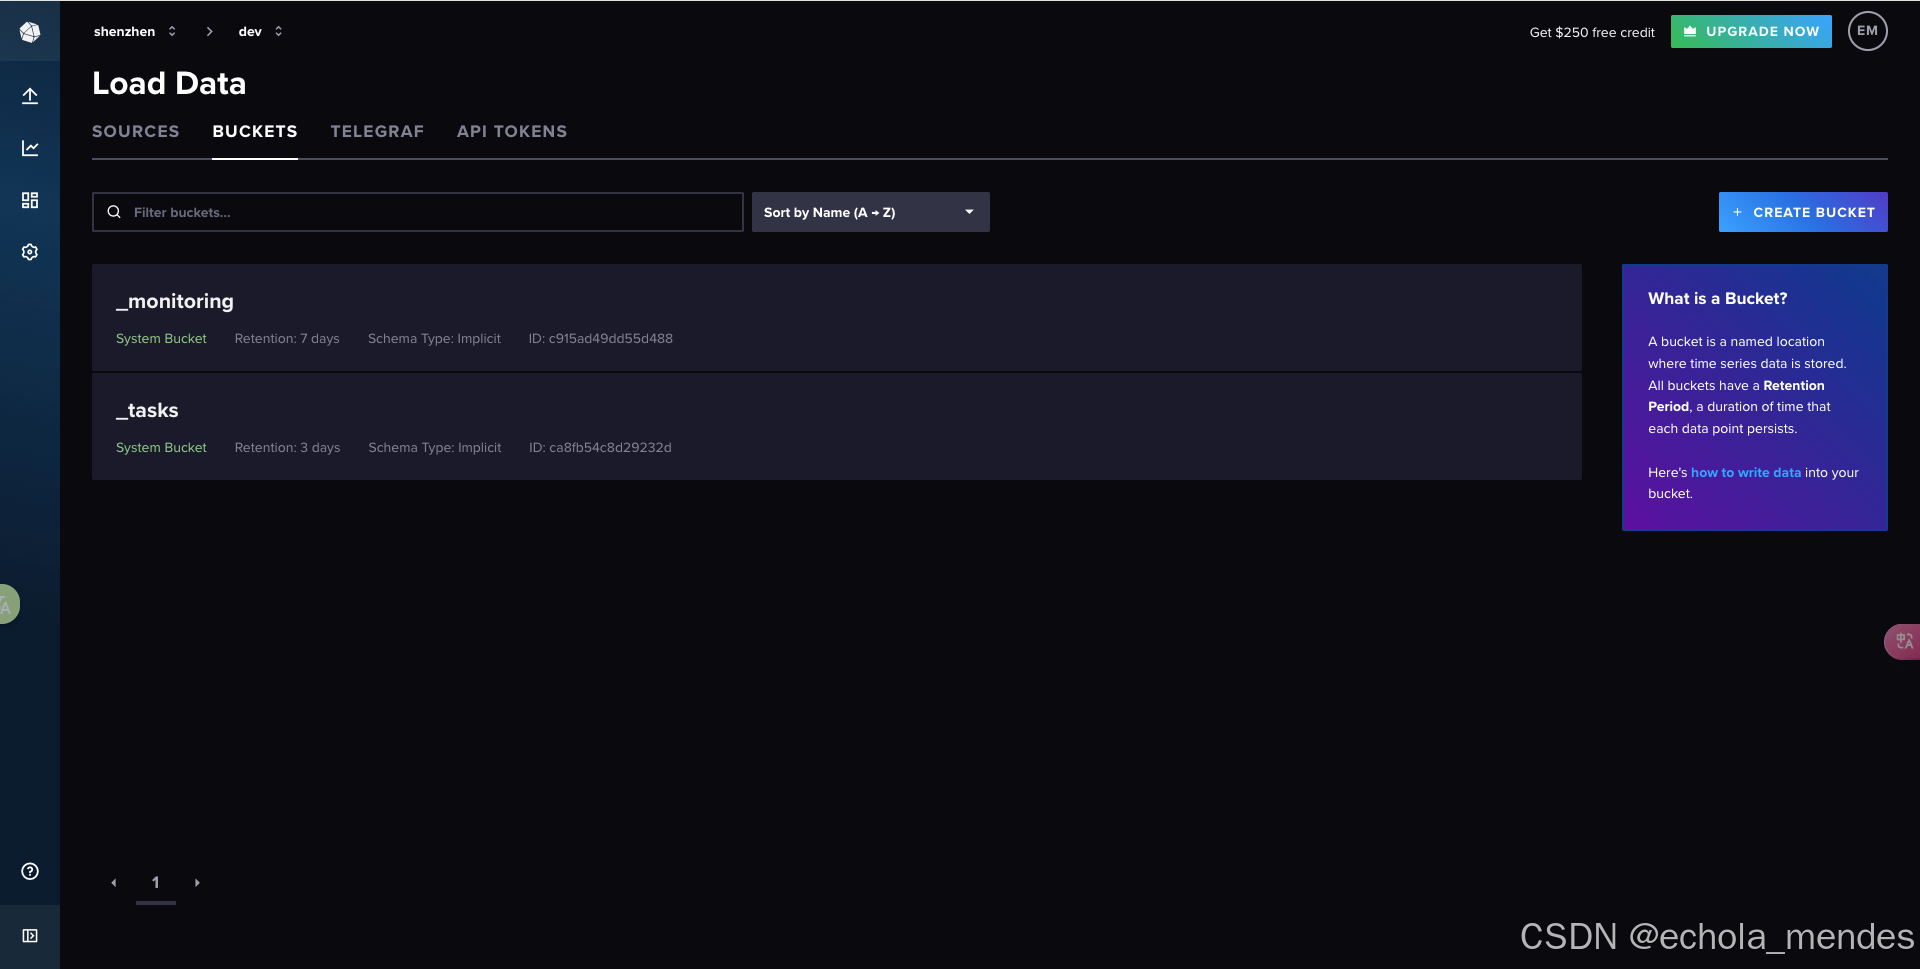
如果你不想进行本地搭建InfluxDB Web UI,可以使用官方提供的需安装,浏览器直接使用,有免费额度限制:https://cloud2.influxdata.com/signup ,登录进入之后
四、InfluxDB的数据结构
数据写入(Load Data)
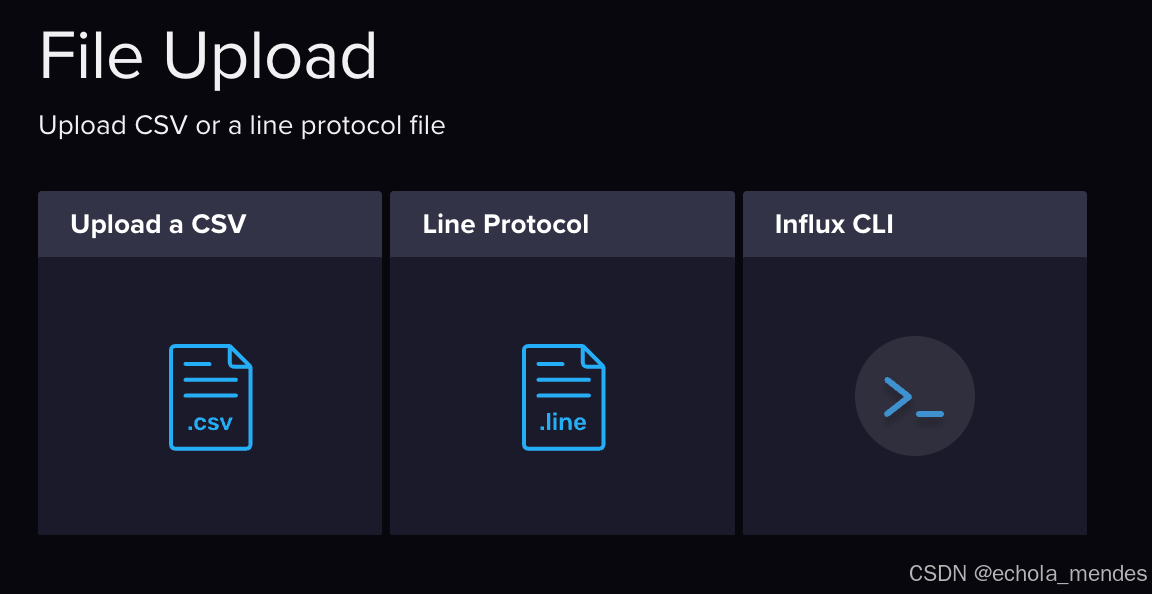
官方提供了三种方式:CSV、Line protocol、Influx CLI。这里CSV不是普通的CSV格式,InfluxDB 默认需要 CSV 包含数据类型注解(包含measurement、tags、fields、timestamp等字段
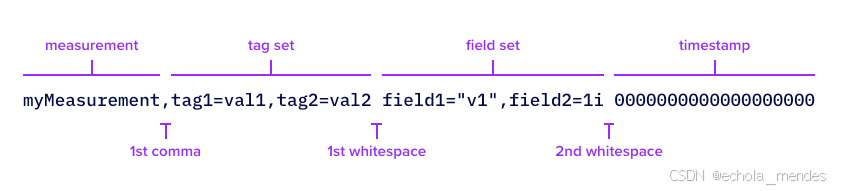
Line protocol的格式:
数据格式为:
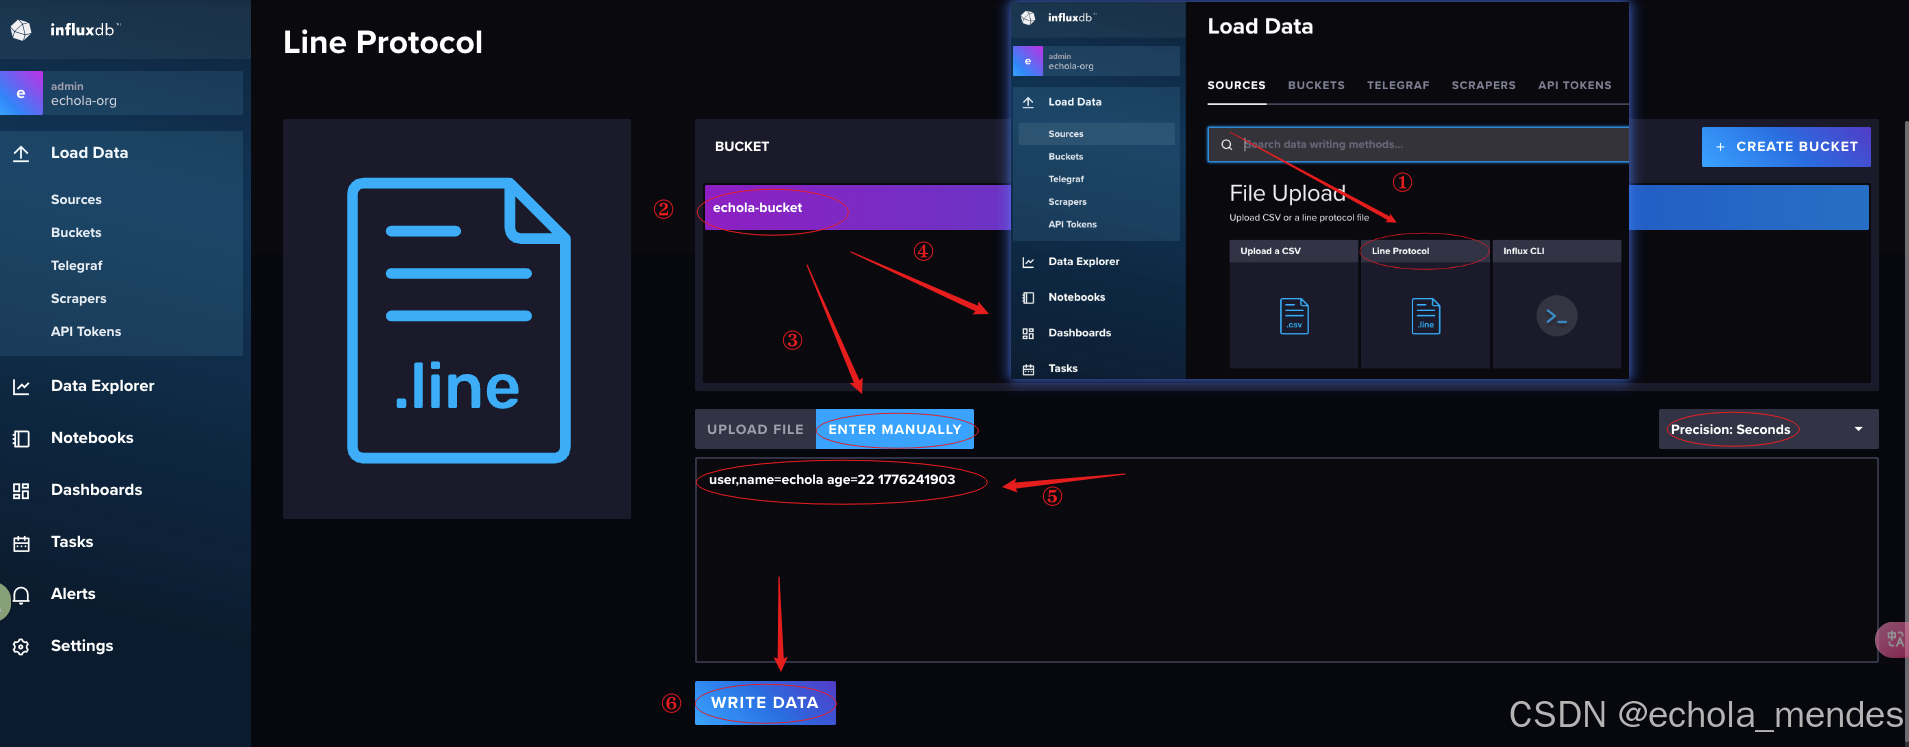
现在写入数据:
注意:时间戳需要在右上角选择时间格式为seconds
user,name=echola age=22 1776241903根据以下步骤写入数据:
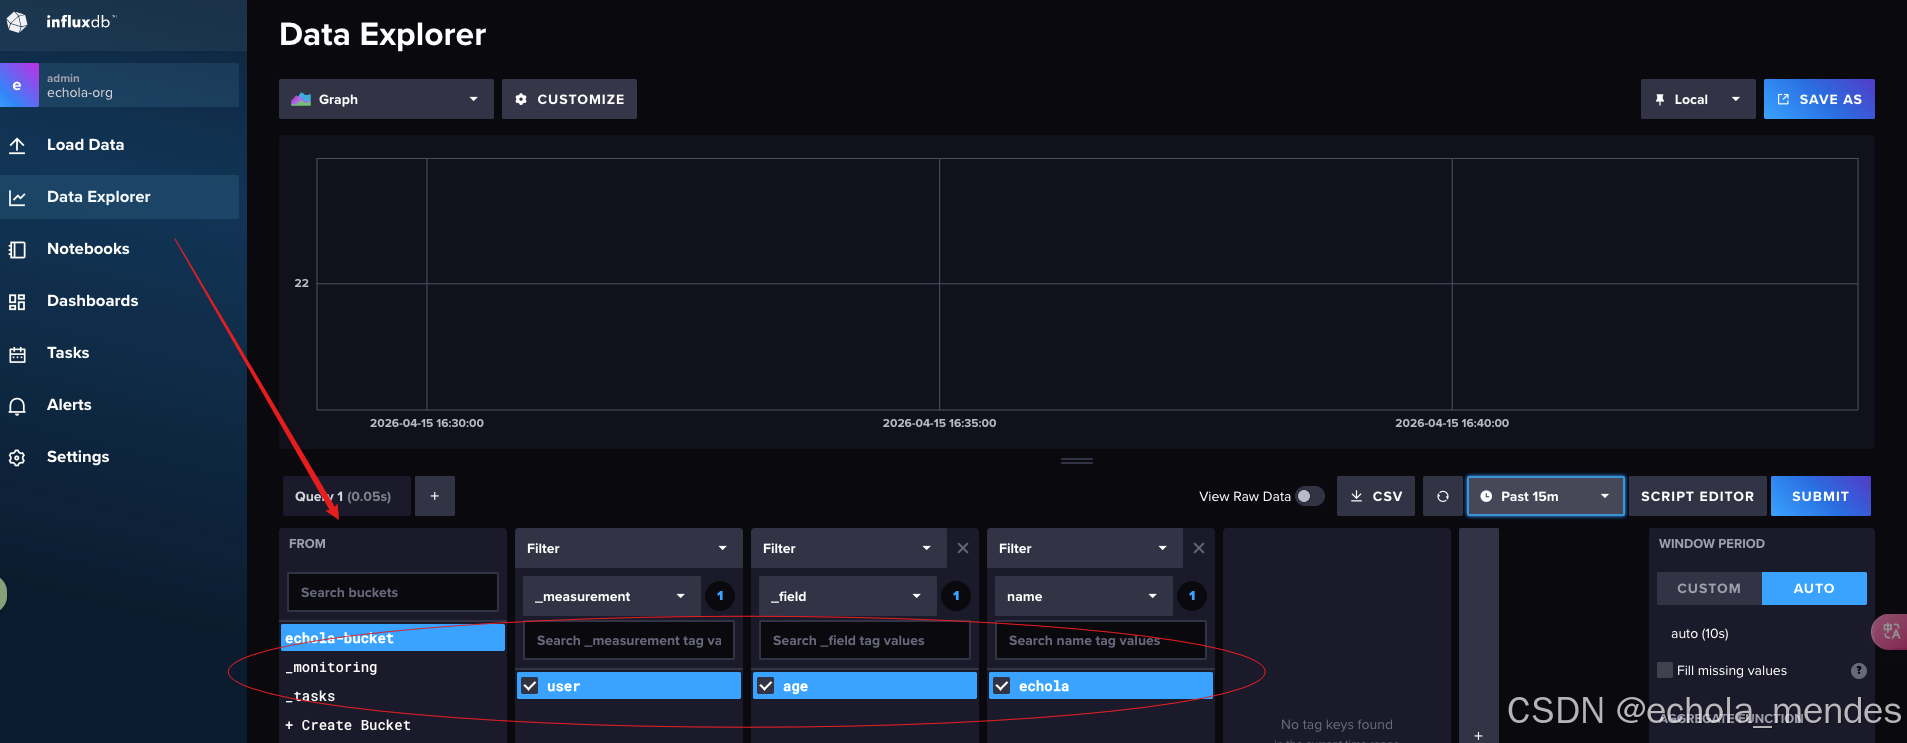
写入成功后就可以在Data Explorer中查看数据
在写入一些其他数据
user,name=tony age=22 1776242815
user,name=leo age=33 1776242829
user,name=jenny age=34  1776242829
user,name=sini age=25 1776155109
user,name=max age=42 1776162309
数据太少了
此处使用Influx CLI导入
五、总结
通过以上对 InfluxDB 从概念、特点到安装实践的逐步剖析,可以清晰地看到:时序数据库并非要取代传统关系型数据库,而是为了解决特定领域(时序数据)的痛点而生。
InfluxDB 的核心价值一句话总结:
InfluxDB 通过“列式存储 + 专用压缩 + 追加写模型 + 标签索引”四大支柱,在时序数据领域实现了:写入快 10 倍、存储省 90%、查询响应从秒级降至毫秒级。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐

 12
 0
- 0


 已为社区贡献2条内容

所有评论(0)